모델 체킹 최적화
모델을 다 작성하고 돌린다. 사흘이 지나도 아직 돌고 있다. 어떻게 하면 더 빠르게 만들 수 있을까?
모델 최적화는 과학이라기보다 예술에 가깝다. 시간을 들여 길러야 하는 기술이고, 모델마다 최적화하는 방법이 다르다. 이 글은 내가 두루 쓸모 있다고 느끼는 기본적인 휴리스틱을 모아 놓은 것일 뿐이다.
시작하기 전에
최적화를 시작하기 전에 확인해야 할 것들이 있다:
1. 모델에 경계가 있는지 확인하라
어쩌면 문제는 “스펙(spec)이 너무 크다”가 아니라 “스펙이 영영 끝나지 않는다”일지도 모른다.
2. 런타임 매개변수를 확인하라
기본적으로 툴박스는 컴퓨터 RAM의 25%를 쓰고, CPU 코어당 워커 스레드를 하나씩 쓴다. 대신 명령줄에서 TLA+를 실행하면 기본값은 RAM 25%에 워커 딱 하나다. 그러니 -workers 플래그를 꼭 넘겨라!
3. 하드웨어를 확인하라
모델 체킹(model checking)은 CPU와 메모리를 모두 많이 쓴다. 때로는 단일 코어 성능까지 많이 타는데, TLC의 라이브니스(liveness) 검사 알고리즘이 단일 스레드이기 때문이다. 더 큰 머신을 구하는 게 할 수 있는 최선일 때도 있다.
개요
스펙
최적화를 논의하기 위해 다음 스펙을 쓰겠다:
---- MODULE optimization ----
EXTENDS Integers, Sequences, TLC
CONSTANTS MaxNum, Workers


(*--algorithm alg
variables
  i = 1;
  to_process = [w \in Workers |-> {}];

process writer = "writer"
begin
  Write:
    while i <= MaxNum do
      with w \in Workers do
        to_process[w] := @ \union {i};
        i := i + 1;
      end with;
    end while;
end process;

process worker \in Workers
variable total = 0;
local = 0;
begin
  Read:
    with x \in to_process[self] do
      local := x;
      to_process[self] := @ \ {local};
    end with;
    Update:
      total := total + local;
      goto Read;
end process;

end algorithm; *)
====
specMaxNum = 7, Workers = {w1, w2, w3}로 두고, 데드락(deadlock) 검사는 끈 채 실행하라. 상태가 28,351,303개(28M) 나와야 한다. 최적화는 이 기본 모델에 가하는 변경으로 하나씩 보여 주고, 다음 최적화를 보여 주기 전에 되돌리겠다.
팁
이 스펙은 내 컴퓨터에서 도는 데 최대 28초가 걸린다. 최적화를 더 빨리 시험해 보려고, 반복 속도를 높이는 요령을 하나 쓰겠다. TLCGet을 쓰면 TLCGet("level")로 모델 체킹의 현재 깊이를 조회할 수 있다. 스펙에 제약 TLCGet("level") < 12를 추가하겠다.
 EXTENDS Integers, Sequences, TLC
 CONSTANTS MaxNum, Workers

+Constraint == TLCGet("level") < 11

 (*--algorithm alg
 variables
spec이렇게 하면 상태 공간(state space)이 97% 줄어서 여러 최적화를 시험해 보기가 쉬워진다. 다 끝나면 제약을 빼고, 최적화가 스펙 전체에 얼마나 도움이 되는지 보겠다.
기본
일반적으로 모델 체킹 시간은 두 가지에 달려 있다:
각 상태를 생성하는 데 걸리는 시간.
생성해야 하는 상태의 수.
내 경험상 (2)가 지배적이고, 가장 신경 써야 할 부분이다. 생성 시간을 5~10% 최적화할 수 있을 때가 가끔 있다. 반면 모델을 만지다가 상태 공간을 10분의 1로 줄이는 개선점을 찾는 일은 꽤 자주 있다.
상태 공간 추정하기
최적화를 시작하기 전에, “복잡도”가 어디에 있는지 감을 잡아 두는 게 좋다. 이런 추정은 대부분 부정확하겠지만, 어디서부터 시작할지 실마리는 준다.
먼저 writer부터 보자. 숫자 7개를 워커 셋 중 하나에 각각 배정하는 방법은 37 = 2187가지다. 워커를 하나 더 추가하면 가능한 배정 수가 8배가 되지만, 숫자를 하나 더 추가하면 3배가 될 뿐이다. 그러니 지금은 워커 수가 MaxNum보다 상태 공간에 더 큰 영향을 미친다. 반대로 워커가 일곱이고 MaxNum = 3이라면, 여덟 번째 워커를 추가하는 것보다 MaxNum을 1 늘리는 쪽이 영향이 더 크다.
간단히 시험 삼아 두 상수(constant)를 모두 줄여 보라. MaxInt를 1 줄이면 상태 공간이 3.2M 상태로 줄고, 워커를 하나 빼면 1.3M으로 떨어진다.
집합 크기
나중에 보겠지만, writer는 사실상 함수 집합(function set) [1..MaxNum -> Worker]에서 함수 하나를 고르는 비효율적인 방법이다. 상태 공간을 추정할 때는 몇몇 컬렉션 타입이 얼마나 커지는지 알아 두면 유용하다. 아래 표에서 |S| = Cardinality(S)이다.
집합 |
원소 수 |
|---|---|
S |
|S| |
SUBSET S |
2|S| |
|
|S| ∗ |T| |
|
|S| ∗ |T| |
|
|T||S| |
|
|S|n |
이것들은 겹쳐 쌓인다. 스펙에 [A \X B -> SUBSET C] 같은 게 있다면, 아마 그게 골칫거리의 근원일 것이다.
동시성
숫자 여섯 개를 워커 셋에 배정하는 방법은 3^6가지이고, 일곱 개를 배정하는 방법은 3^7가지다. 차이는… 3배다. 그런데 왜 MaxNum=7은 상태 공간을 9배로 늘릴까?
동시성(concurrency)도 우리 편이 아니기 때문이다! 처음 숫자 여섯 개를 배정했고 아직 어떤 워커도 실행되지 않았다고 해 보자. 일어날 수 있는 일은 아홉 가지다:
1-3: writer가
7을w1,w2,w3중 하나에 배정한다4-5:
w1이 자기 숫자 두 개 중 어느 쪽이든 하나에 대해 read를 호출한다6-9:
w2나w3가 자기 숫자 두 개에 대해 read를 호출한다.
그다음 w1이 실행되면, 거기서 가능한 다음 스텝은 여덟 가지다. writer와 다른 워커들은 원래 하던 액션을 할 수 있고, 아니면 w1이 Update를 할 수 있다. 동시성은 정말 정말 빠르게 난장판이 된다.
어쨌든 시스템의 동시성이 상수만큼이나 상태 공간에 기여하고 있다는 걸 알 수 있다. 그러니 상태 공간을 개선하려면 둘 다 줄여야 한다.
모델 변경
더 작은 상수를 써라
이미 보았듯이 워커 수를 줄이는 것과 MaxNum을 낮추는 것은 각각 상태 공간을 10분의 1로 줄일 수 있다. 보통 이게 첫 번째 수단이다. 어차피 버그 대부분은 작은 상태 공간에서도 나타나므로, 거대한 상수 입력을 쓰는 이점은 별로 없다. 아주 큰 상수로 모델 체킹을 해야만 한다면, 빠르게 반복하기 위한 작은 상수의 모델 설정을 따로 두고, 작은 모델이 통과할 때만 큰 모델을 검사하라.
이 스펙에서는 상수를 줄이는 것만으로도 모델 체킹을 견딜 만하게 만들 수 있다. 하지만 늘 그런 건 아니므로 다른 기법들도 여전히 중요하다.
대칭 집합을 써라
아주 대략적인 경험칙으로, 원소가 n개인 모델 값(model value) 집합을 대칭 집합(symmetry set)으로 만들면 상태 공간이 약 n!분의 1로 줄어든다. 이 경우 Workers를 대칭 집합으로 만들면 상태 공간이 4.7M 상태로, 약 6분의 1로 줄어든다.
cli를 쓰고 있다면, 다음처럼 모델 안에 대칭 관계를 정의해야 한다는 점에 유의하라:
 CONSTANTS MaxNum, Workers

 Constraint == TLCGet("level") < 11
+Symmetry == Permutations(Workers)

 (*--algorithm alg
 variables
spec그런 다음 설정 파일에 SYMMETRY Symmetry를 넣어라.
안전성과 라이브니스를 분리하라
이 스펙에서는 문제가 되지 않지만, 안전성 속성(safety property), 즉 불변식(invariant)과 액션 속성을 검사하는 모델과, 라이브니스, 즉 그 밖의 전부를 검사하는 모델은 항상 따로 두어야 한다. 라이브니스 검사는 안전성 검사보다 훨씬 느리고, 대칭 집합 최적화도 막는다. 라이브니스 검사에는 더 작은 상수를 써라.
동시성 줄이기
“로더” 프로세스를 없애라
writer는 내가 “로더(loader)” 프로세스라고 부르는 것이다. 하는 일이라고는 to_process를 수동으로 세팅하는 것뿐이다. 워커들과 인터리빙될 수는 있지만, 그 인터리빙이 스펙의 동작을 바꾸지는 않는다. 그러니 to_process가 가질 수 있는 최종 값을 모두 알아낸 뒤, 그 값들 중 하나로 시작하게 하면 writer 전체를 대체할 수 있다.
writer는 각 숫자를 정확히 한 워커에게 배정하므로, 끝에 가면 to_process는 각 워커를 서로소인 숫자 부분집합에 대응시킨다. 이를 두 개의 논리 명제로 분해할 수 있다:
각 숫자마다 그 숫자가 속한 워커가 있고,
그 숫자는 다른 어떤 워커에도 속하지 않는다.
 (*--algorithm alg
 variables
-  i = 1;
-  to_process = [w \in Workers |-> {}];
+  to_process \in {
+    tp \in [Workers -> SUBSET (1..MaxNum)]:
+      \A x \in 1..MaxNum:
+        \E w \in Workers:
+          /\ x \in tp[w]
+          /\ \A w2 \in Workers \ {w}:
+            x \notin tp[w2]
+    }

-process writer = "writer"
-begin
-  Write:
-    while i <= MaxNum do
-      with w \in Workers do
-        to_process[w] := @ \union {i};
-        i := i + 1;
-      end with;
-    end while;
-end process;
+

 process worker \in Workers
 variable total = 0;
spec이 변경으로 상태가 3분의 1로 줄어든다. 그렇긴 하지만, 초기 상태를 만드는 데 필요 이상으로 훨씬 오래 걸리게 되기도 한다. 그 이유는 나중에 다룬다.
액션마다 더 많은 일을 하라
지금은 각 워커가 숫자 하나를 처리하는 데 액션(action) 두 개를 쓴다. 하나는 to_process에서 숫자를 꺼내는 액션이고, 다른 하나는 그 숫자를 total에 더하는 액션이다. 이 때문에 다른 워커(또는 writer)가 끼어들 수 있는 틈이 생긴다.
이게 오버헤드를 얼마나 더하는지 추정하는 요령이 있다. 각 워커의 to_process에 숫자가 정확히 하나씩 있어서, 워커 셋이 각각 정확히 두 스텝을 차례로 수행한다고 가정하자. 각 워커는 두 스텝을 순서대로 해야 하지만, 워커들끼리는 서로 독립적이다. 그러면
(2+2+2)!2! · 2! · 2! = 90
가지의 행동(behavior)이 가능하고, 새 상태는 6 · 90 = 540개가 생긴다.
다음처럼 두 레이블(label)을 하나로 합치면:
 begin
   Read:
     with x \in to_process[self] do
-      local := x;
-      to_process[self] := @ \ {local};
+      total := total + x;
+      to_process[self] := @ \ {x};
     end with;
-    Update:
-      total := total + local;
-      goto Read;
+    goto Read;
 end process;

 end algorithm; *)
spec상태 공간이 고작 240만 상태로 줄어든다!
액션을 합치는 건 무턱대고 할 일이 아니다. 애초에 모델을 쓰는 목적이 동시성에서 비롯되는 시스템 결함을 찾는 것임을 기억하라! 스펙의 원자성의 입도(grain of atomicity), 즉 얼마만큼을 원자적으로 두고 얼마만큼을 중간에 끼어들 수 있게 둘지를 의식적으로 생각해야 한다. 입도를 너무 굵게 잡으면 진짜 에러를 가릴 수 있고, 너무 잘게 잡으면 모델 체킹이 너무 오래 걸릴 수 있다.
의도하지 않은 비결정성을 줄여라
Read에서 워커는 자기 풀에 있는 아무 숫자나 꺼내서 처리할 수 있다. 덕분에 모델은 순서에 대해 견고하다. 항목을 어떤 순서로 처리하든 동작한다. 하지만 우리가 신경 쓰는 건 대개 아무 순서가 아니라 특정한 순서다! 받은 순서대로 처리할 수도 있고, 가장 작은 항목부터 처리할 수도 있고, 뭐 그런 식이다. 그러니 이 스펙은 실제로 필요한 것보다 더 비결정적(nondeterministic)이다.
이 경우 알고리즘은 교환 가능해서 어떤 순서를 쓰든 상관없다. 그러니 CHOOSE로 완전히 임의의 순서를 고르겠다:
 local = 0;
 begin
   Read:
-    with x \in to_process[self] do
+    await to_process[self] # {};
+    with x = CHOOSE x \in to_process[self]: TRUE do
       local := x;
       to_process[self] := @ \ {local};
     end with;
spec경고
이것은 내가 CHOOSE x \in set: TRUE를 마음 편히 쓰는 드문 경우 중 하나다. 다른 경우라면 꺼리는데, 이건 결정적이기 때문이다. 많은 사람이 예상하지 못하는 부분이다!
이렇게 하면 상태 공간이 고작 210만 상태로 줄어든다. 지금까지 중 가장 큰 감소다! 나도 놀랐지만, 돌이켜 보면 말이 된다. writer가 모든 항목을 한 워커에게 배정하면, 그 워커는 항목들을 7! = 5040가지 순서로 꺼낼 수 있다.
시퀀스 대신 백을 써라
writer가 같은 숫자를 두 번 보낼 수 있다면 어떨까? 그러면 to_process에 집합을 쓰는 건 버그가 된다. 중복 원소가 사라질 테니까. 가장 쉬운 해결책은 시퀀스(sequence)로 바꾸는 것이다:
to_process = [w \in Workers |-> <<>>]
시퀀스를 쓸 때의 문제는 중복만 더하는 게 아니라 순서까지 더한다는 것이다. <<a, b, a>>는 <<a, a, b>>와 다른 시퀀스이므로, 서로 다른 상태가 된다!
순서 없이 중복을 원한다면, 대신 백(bag, 다중집합)을 써라:
to_process = [w \in Workers |-> EmptyBag]
그러면 백 [a |-> 2, b |-> 1]은 유일하다.
뷰를 써라
이건 고급 기법이라 조심해서만 써야 한다. 준비 삼아, 마지막으로 실행된 프로세스를 추적하는 보조 변수(auxiliary variable)를 추가한다고 해 보자:
 Constraint == TLCGet("level") < 11
 Symmetry == Permutations(Workers)
-
 (*--algorithm alg
 variables
   i = 1;
   to_process = [w \in Workers |-> {}];
+  aux_last_run = "none";

 process writer = "writer"
 begin
@@ -18,6 +18,7 @@
         to_process[w] := @ \union {i};
         i := i + 1;
       end with;
+      aux_last_run := "writer";
     end while;
 end process;

@@ -30,8 +31,10 @@
       local := x;
       to_process[self] := @ \ {local};
     end with;
+    aux_last_run := self;
     Update:
       total := total + local;
+      aux_last_run := self;
       goto Read;
 end process;
spec이러면 상태 공간이 80M 상태로 부풀어 오른다! 예전에는 같은 상태로 이어지던 행동들이 이제는 서로 다른 상태로 이어진다. 하지만 그 차이는 보조 변수에만 있을 뿐이고, 스펙의 동작에는 영향을 주지 않아야 한다.
두 상태가 서로 다른지 판단하기 위해 TLC는 <<i, pc, to_process, aux_last_run>>의 값을 비교한다. 원한다면 TLC에게 대신 <<i, pc, to_process>>로 비교하고 aux_last_run은 완전히 무시하라고 할 수 있다. 이것을 뷰(view) 설정이라고 한다. 먼저 뷰에 해당하는 연산자(operator)를 추가한다:
   i = 1;
   to_process = [w \in Workers |-> {}];
   aux_last_run = "none";
+
+define
+  view == <<i, to_process, pc, total>>
+end define;

 process writer = "writer"
 begin
spec그런 다음 TLC에게 view를 뷰로 쓰라고 알려 준다. 툴박스에서는 TLC Options > Checking ode > View 아래에 있다. cli에서는 설정에 VIEW view를 추가한다.
새 뷰를 추가하면 상태 공간이 딱 100만 상태로 줄어든다… 기본 스펙보다도 적다. 각 워커에 total과 local 변수도 있다는 걸 깜빡했는데, 이것도 뷰에 들어가야 한다. 이 변수들은 프로세스의 지역 변수라서 define 블록에서는 참조할 수 없으므로, 전체를 변환(translation) 결과 아래에 두어야 한다.
   i = 1;
   to_process = [w \in Workers |-> {}];
   aux_last_run = "none";
-
-define
-  view == <<i, to_process, pc, total>>
-end define;

 process writer = "writer"
 begin
@@ -43,4 +39,7 @@
 end process;

 end algorithm; *)
+\* under the translation
+view == <<i, to_process, pc, total, local>>
+
 ====
spec뷰는 보조 변수를 추가해서 생기는 상태 공간 증가를 무효화할 수 있지만, 유효한 상태까지 없애 버리기도 정말 쉬우므로 쓸 때는 아주 조심하라.
스펙의 세부를 줄여라
마지막으로, 우리가 모델링하지 않는 것들을 모두 눈여겨보라. 워커를 어떻게 발견하는지는 모델링하지 않는다. 연결 프로토콜도 모델링하지 않는다. 어떤 종류의 일시적 에러도, 숫자 하나 말고는 페이로드에 관한 어떤 세부 사항도 모델링하지 않는다.
이것이 상태 공간 최적화에 관한 가장 중요한 휴리스틱이다: 모델이 자세할수록 상태가 많아진다. 초보자들이 load \in [Server -> 0..100] 같은 걸 모델링하는 걸 자주 본다. 더 숙련된 모델러라면 대신 load \in [Server -> 0..3] 같은 걸 쓸 것이다. 아니면, 그래도 괜찮다면 overloaded \in [Server -> BOOLEAN]을 쓸 것이다.
시스템에 중요한 것만 모델링하는 습관을 들이면 훨씬 수월해질 것이다.
팁
자세한 시스템을 꼭 모델링해야 한다면, 먼저 단순한 고수준 명세(specification)를 쓰고 자세한 시스템은 정제(refinement)로 넣는 게 최선인 경우가 많다.
상태를 더 빨리 검사하기
모델 체커가 초당 더 많은 상태를 처리하게 만드는 것보다 상태 공간을 줄이는 게 더 쉽다. 그렇긴 해도 후자를 개선하기 위해 할 수 있는 일이 몇 가지 있다.
프로파일러를 써라
TLA+ 툴박스에는 프로파일러(profiler)가 딸려 있다. “TLC options” 페이지에서 찾을 수 있다:
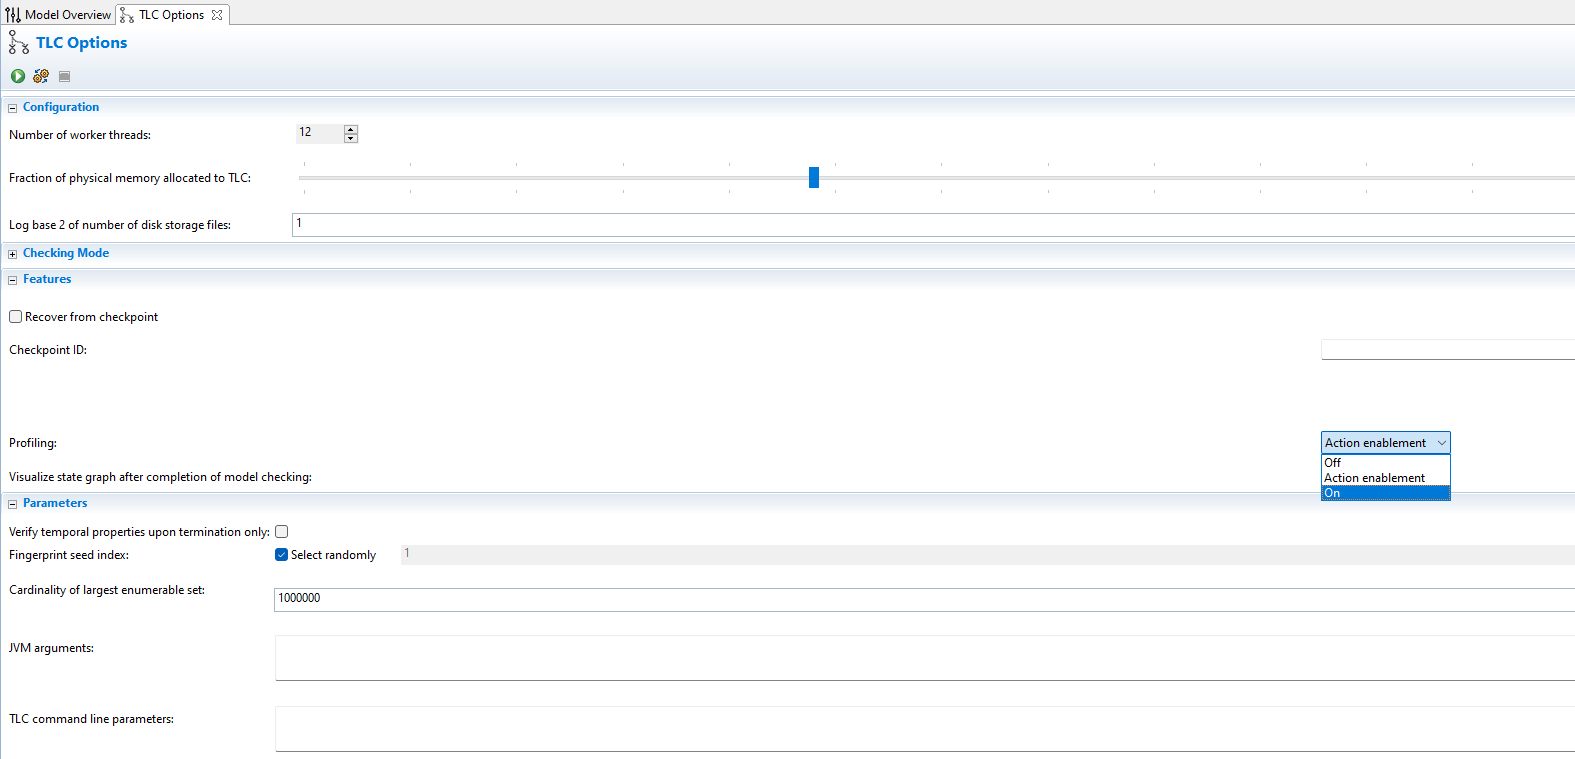
다음은 writer를 함수 집합으로 대체했던 이전 최적화에 프로파일러를 돌린 모습이다:
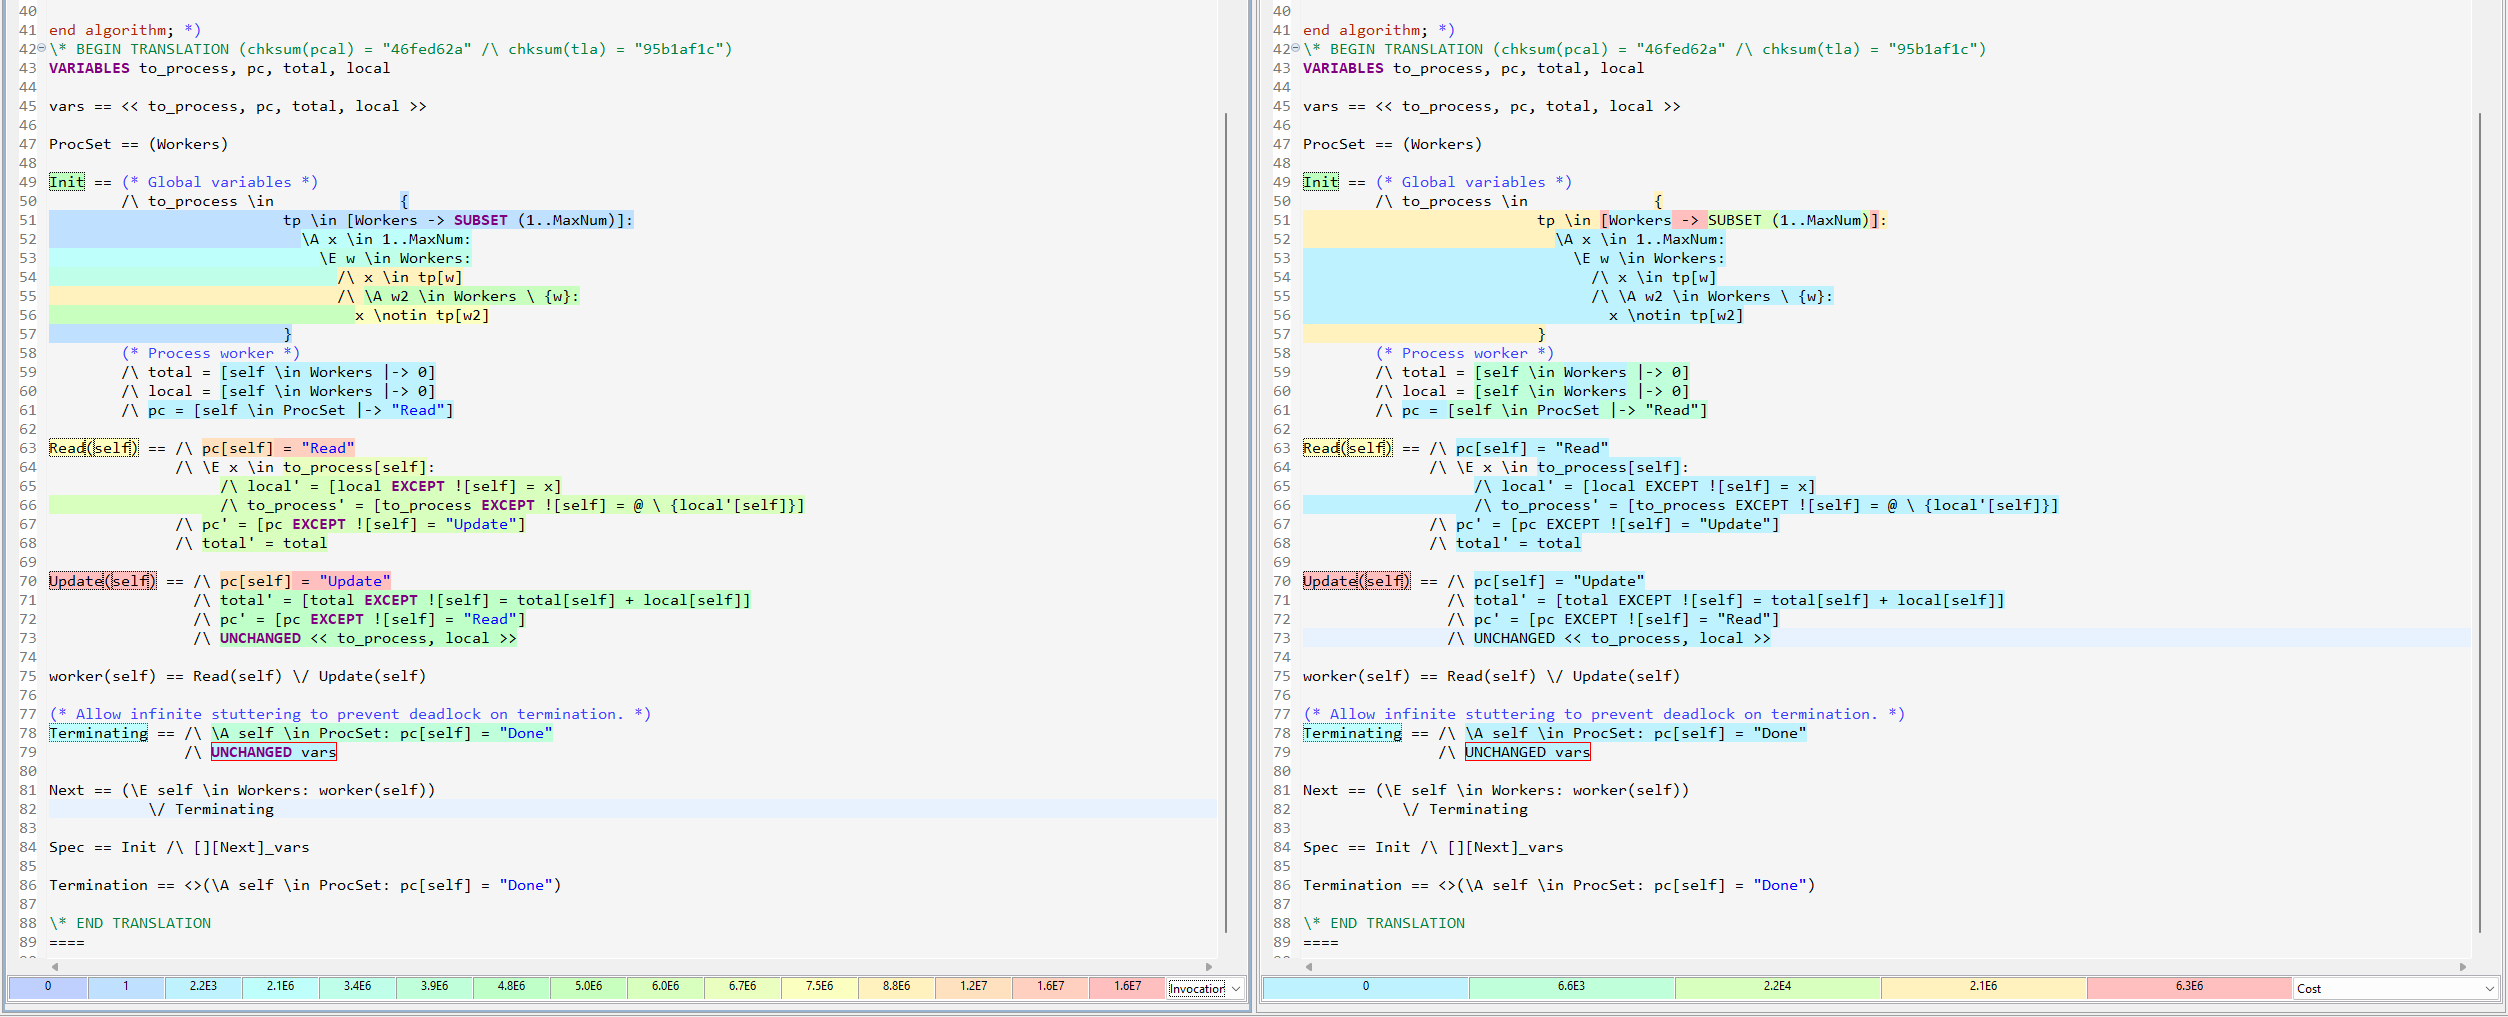
왼쪽에는 식(expression)별 호출 횟수가, 오른쪽에는 식마다 매긴 “비용”이 있다. 비용은 그 식이 모델 체킹 시간에 얼마나 기여했는지를 나타내는 추상적인 척도다. 프로파일러는 각 액션이 새 상태와 고유 상태를 몇 개씩 생성했는지도 보여 줄 수 있다. PlusCal 스펙을 프로파일링하더라도, 지표는 변환된 TLA+에 대해서만 나온다는 점에 유의하라.
여기서 흥미로운 점을 눈치챘는가? 가장 큰 비용 두 개는 Update(self) 액션과 Init 안의 함수 집합이다. 그런데 Update는 수백만 번 호출되는 반면 함수 집합은 딱 한 번 호출된다. 비슷한 일을 액션 안에서 했다면, 모델 체킹이 크게 느려질 거라고 예상할 수 있다.
그렇다면 구체적으로 무엇이 문제일까?
걸러내지 말고 구성하라
to_process는 이렇게 계산했었다:
to_process \in {
 tp \in [Workers -> SUBSET 1..MaxNum]:
   \A x \in 1..MaxNum:
     \E w \in Workers:
       /\ x \in tp[w]
       /\ \A w2 \in Workers \ {w}:
         x \notin tp[w2]
 }
앞서 설명한 대로 함수 집합 [A -> B]의 원소 수는 |B||A|개이고, 멱집합 SUBSET B의 원소 수는 2^|B|개임을 기억하라. 이를 합치면 [Workers -> SUBSET 1..MaxNum]의 원소 수는 (27)3 = 2.1e6개다. 앞에서 유효한 구성은 약 2000개뿐이라는 걸 알았으니, 어차피 집합의 99.98%를 버리는 셈이다.
큰 집합을 생성해서 작은 집합으로 걸러내는 대신, 작은 집합을 직접 생성하려고 시도하는 편이 더 효율적이다. 이 경우 시스템은 워커에서 항목으로의 맵을 저장하지만, 각 숫자가 정확히 한 워커에 대응된다는 걸 보장한다. 다음처럼 구해 보자
to_process \in LET
  i_to_worker == [1..MaxNum -> Workers] \* Map of items to workers
IN
  { [w \in Workers |->  \* Each worker is mapped to
      {x \in 1..MaxNum: \* the set of items which
      itw[x] = w}]:     \* itw maps to that worker
    itw \in i_to_worker}
이렇게 해도 생성되는 상태 수는 바뀌지 않지만, 스펙은 더 빨리 끝난다.
이중 재귀 함수 정의를 쓰지 마라
설명이 필요 없다.
오버라이드를 써라
TLC 모듈의 정의에서 SortSeq와 Permutations는 다음과 같다
Permutations(S) ==
   {f \in [S -> S] : \A w \in S : \E v \in S : f[v]=w}

SortSeq(s, Op(_, _)) ==
    LET Perm == CHOOSE p \in Permutations(1 .. Len(s)) :
      \* etc
그러니 항목 10개짜리 리스트를 정렬하려면, 먼저 원소가 1010개인 함수 집합을 생성하고, 그걸 10!개로 걸러낸 다음에야, 그 3백만여 개 원소를 순회하며 정렬된 시퀀스를 찾게 된다. 말도 안 되는 짓이라서, 모델 체커는 훨씬 합리적으로 Java 수준에서 삽입 정렬을 한다. Java를 안다면 어떤 연산자든 더 빠른 구현으로 오버라이드(override)할 수 있다. 나는 해 본 적이 없지만, 내가 알기로는 오버라이드된 구현 예제를 여기서 볼 수 있다.
리팩터 속성을 써라
여기를 보라. 최적화가 상태 공간을 바꾸지 않는지 확인하기에 좋은 방법이다.
기타
메모리 할당을 줄여라
RAM이 많은 환경에서 작은 모델을 돌리면, JVM이 쓰지도 않을 메모리를 미리 할당하느라 시간을 많이 낭비할 수 있다. 보통은 큰 문제가 아니지만, RAM이 500GB 넘는 아주 큰 머신에서는 20초짜리 스펙인데도 이게 몇 분씩 걸리는 걸 본 적이 있다. 이런 특정한 경우에는 할당하는 RAM을 줄이면 차이가 아주 커질 수 있다.
상태 공간의 일부를 무시하라
이건 PlusCal보다 날것의 TLA+에서 하기가 더 쉽다. Init과 Next에 제약을 추가로 걸면, TLC를 상태 공간 중 가장 관심 있는 부분으로 인위적으로 제한할 수 있다. 다음처럼 별도의 연산자로 하기를 권한다:
Init ==
  x \in 1..10

FastInit ==
  /\ Init
  /\ x = 3

Next ==
  \/ IncX
  \/ DecX

FastNext ==
  /\ Next
  /\ IncX => x' < 5

FastSpec == FastInit /\ [][FastNext]_vars
Apalache를 써 보라
Apalache는 TLA+용 대안 모델 체커다. 아직 언어 전체를 지원하지는 않지만, 어떤 종류의 스펙에서는 더 빠르다고 들었다. 타입 시스템도 있다!
JVM 인수를 만지작거려라
나는 JVM이 어떻게 돌아가는지 전혀 모르니, 모델 체킹이 더 잘 되게 JVM을 조정하는 방법에 대한 제안이라면 뭐든 환영한다.