스펙 매개변수화
모델 상수
지난 장에서 우리는 구현에 속성(property)을 추가해 중복 검사기의 완전한 명세(specification)를 만들었다. 초기 상태(initial state)를 활용하면 한 자리 숫자 4개로 된 리스트를 전부 검사할 수 있다. 더 철저하게 하고 싶다면 S == 1..100처럼 더 넓은 범위의 입력을 검사할 수도 있다. 내 추정으로는 이렇게 하면 발견되는 상태 수가 70,000개에서 500,000,000개 이상으로 치솟는다. 검사하는 데 시간이 훨씬 더 걸릴 것이다! 이걸 “진짜” 스펙으로 작성하는 중이라면, 모델 체커(model checker)에게서 더 빠르게 피드백을 받을 수 있도록 작성 작업 대부분은 1..10 같은 작은 S 값으로 하고 싶을 것이다. 뻔한 문제들을 다 털어낸 뒤에야 1..100 같은 큰 S 값으로 바꾼다.
즉, S가 스펙 안에 하드코딩된 값이어서는 곤란하다. 대신 모델을 실행할 때마다 동적으로 고를 수 있는 것이어야 한다. 프로그래밍 언어에서 인자를 넘기려고 커맨드라인 플래그를 쓰는 것을 생각해 보자. TLA+에서는 모델 실행마다 설정할 수 있는 값을 “상수(Constants)”라고 부른다.1 S를 상수로 만들어 보자:
 ---- MODULE duplicates ----
 EXTENDS Integers, Sequences, TLC
-
-S == 1..10
+CONSTANT S

 (*--algorithm dup
-variable
-  seq \in S \X S \X S \X S;
+  variable seq \in S \X S \X S \X S;
   index = 1;
   seen = {};
   is_unique = TRUE;
@@ -18,7 +16,7 @@

   IsUnique(s) ==
     \A i, j \in 1..Len(s):
-      i # j => s[i] # s[j]
+      i # j => seq[i] # seq[j]

   IsCorrect == pc = "Done" => is_unique = IsUnique(seq)
 end define;
상수 여러 개를 한 줄에 둘 수도 있다. (다음 장에서) 길이를 설정 가능하게 만들 때는 CONSTANT S, Length라고 쓸 것이다. 이제 스펙을 실행해 보면, 툴박스가 상수 S를 정의하지 않았다고 알려 준다:
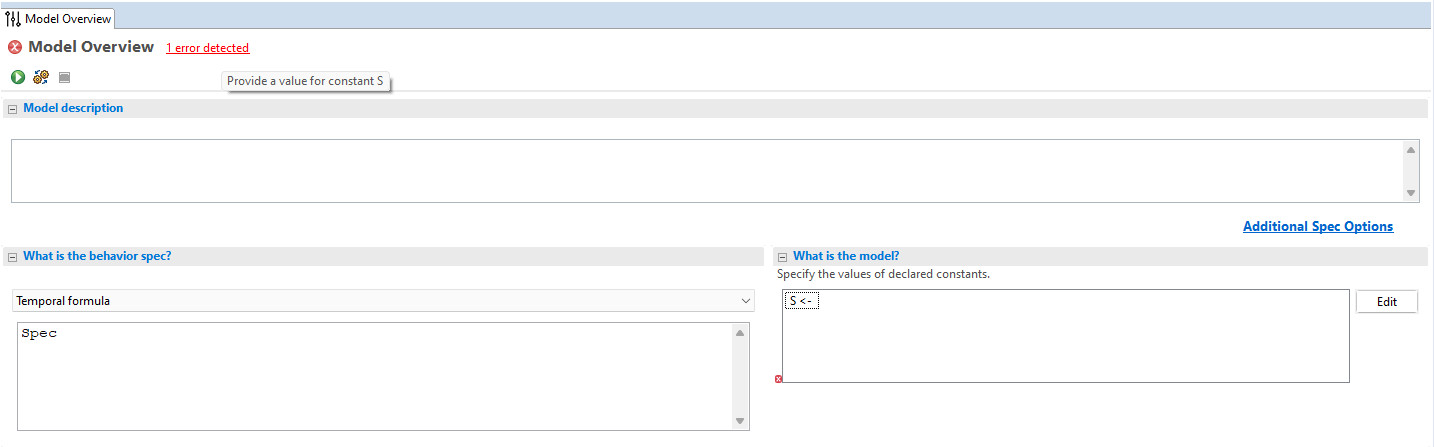
정의는 여기서 한다:
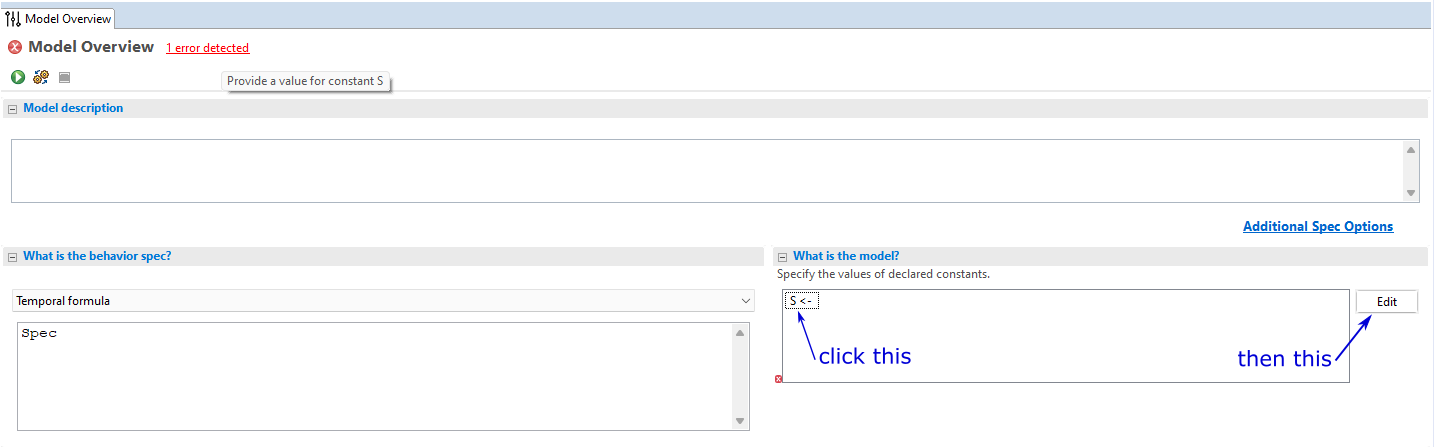
그러면 이런 창이 열린다:
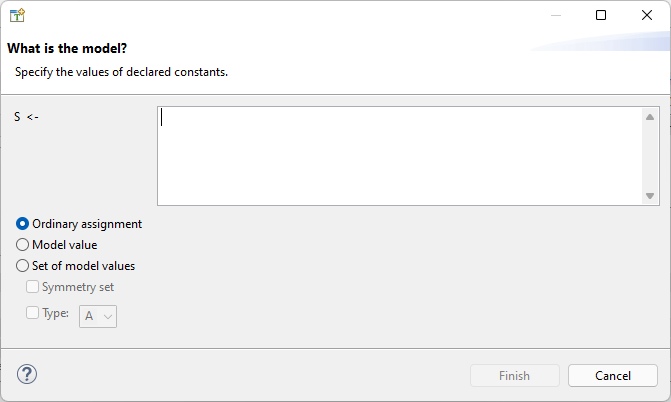
상수에는 세 가지 선택지가 있다. 일반 할당(ordinary assignment), 모델 값(model value), 모델 값의 집합이다. 나머지 둘은 나중에 다루고, 지금은 일반 할당만 살펴보자. 일반 할당을 쓰면 유효한 TLA+ 식(expression)이라면 무엇이든 상수에 할당할 수 있다. 할당할 때마다 일일이 스크린샷을 보여 주는 건 귀찮으니, S <- 1..10이라고 쓰면 “1..10을 S에 일반 할당한다”는 뜻으로 하겠다. 이제 반복 개발용으로 작은 S를 쓰는 모델과 최종 테스트용으로 큰 S를 쓰는 모델을 따로 만들 수 있다.
노트
TLA+ 스펙에서는 상수를 쓰는 것이 좋은 습관이다. 다만 예제를 단순하게 유지하려고, 평소보다 값을 더 많이 하드코딩하겠다.
말이 안 되는 상수 막기
S의 모든 값이 우리 스펙에 의미 있는 것은 아니다. 예를 들어 S <- {}로 하면 어떻게 될까? 그러면 seq가 가질 수 있는 값이 없으니 중복도 있을 수 없고, 모델 전체가 무의미해진다. 아니면 S <- {1, 2}는 어떨까? 이번에는 seq가 가질 수 있는 값이 있긴 하지만, 그 값들은 언제나 중복을 포함하므로 스펙을 돌려 봐야 딱히 흥미롭지 않다.
이런 병적인 값들은 ASSUME 키워드로 걸러 낼 수 있다. ASSUME 식은 올바른 상수를 넣었는지 확인하는 검사다.
 ---- MODULE duplicates ----
-EXTENDS Integers, Sequences, TLC
+EXTENDS Integers, Sequences, TLC, FiniteSets
 CONSTANT S
+ASSUME Cardinality(S) >= 4

 (*--algorithm dup
   variable seq \in S \X S \X S \X S;
ASSUME 안의 식은 연산자(operator)와 상수에는 의존할 수 있지만 변수에는 의존할 수 없다. ASSUME은 모델 실행이 시작되기도 전에 검사된다. S <- {1}로 스펙을 실행해 보면 에러가 난다:
Error: Assumption %line% is false.
상수가 있는 스펙이라면 상수에 제약을 거는 가정(assumption)을 붙여야 한다. 가정은 에러를 막아 줄 뿐 아니라, 스펙을 읽는 사람이 그 상수가 무엇이어야 하는지 이해하는 데도 도움이 된다.
모델 값
일반 할당은 이걸로 해결됐다. 그럼 “모델 값”은 뭘까? 모델 값은 TLA+의 특별한 종류의 값이다. 모델 값에는 아무 연산도 없어서 동등성만 검사할 수 있고, 오직 자기 자신과만 같다. 즉,
\* Given
X <- [model value]
Y <- [model value]

\* Then
X = X
X # Y
X # 1
X # "a"
X # <<1, Y>>
이게 왜 필요할까? TLC에서는 호환되지 않는 타입끼리 비교하면 에러가 나기 때문이다. last_access_time처럼 널(null)이 될 수 있는 값을 표현하고 싶다고 하자. 변수가 현재 널이 아니라면 문자열과 정수를 비교하는 셈이 되고 이는 에러이므로, IF last_access_time = "null"이라고 쓸 수는 없다. IF last_access_time = -1처럼 센티널 값을 쓰면, 실수로 그 값을 다른 수치 맥락에서 사용했을 때 논리 에러가 생길 위험을 떠안게 된다.
대신 NULL이나 NotYetAccessed 같은 새 상수를 정의하고 모델 값으로 설정하면 된다. 그러면 IF last_access_time = NULL이라고 쓸 수 있고, 값이 이미 숫자라면 이 식은 거짓이 된다. 마찬가지로, 모델 값은 이미 원소가 들어 있는 집합에도 추가할 수 있다. 모델 값은 규모가 큰 스펙을 구성할 때 센티널 값이나 자리표시 값으로 엄청나게 유용하다.
노트
일단 모델 값이 생기면 그것을 일반 할당에 사용할 수 있다. 예를 들면:
CONSTANT X, Set

X <- [model value]
Set <- {1, 2, X}
모델 값의 집합
상수에 모델 값의 집합을 할당할 수도 있다. 보통 집합처럼 입력하되, 따옴표 없이 넣으면 된다.
S <- [model value] {s1, s2, s3, s4, s5}
모델 값의 집합이 엄청나게 쓸모 있어지는 건 동시성을 모델링하기 시작하면서부터지만, 지금 당장 써먹을 수 있는 멋진 요령도 하나 있다. S를 그 값으로 두고 모델을 실행하면 총 4,375개의 상태가 나온다 — S <- 1..5로 했을 때와 같은 수다. 그런데 “모델 값의 집합(set of model values)” 막대 아래에 있는 또 다른 옵션에 주목하자:
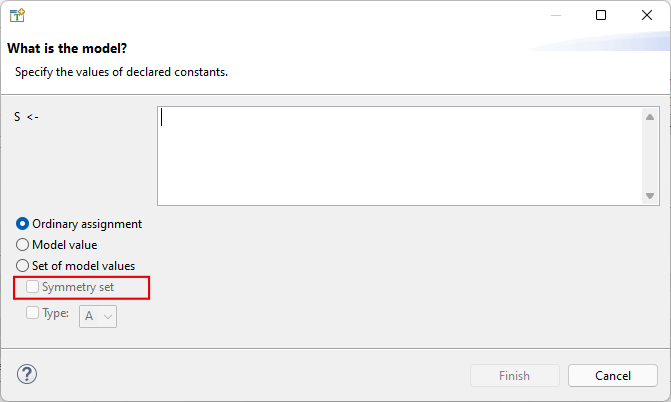
“대칭 집합(Symmetry set)”은 TLC의 특별한 최적화 기능이다. S를 대칭 집합으로 만들면 상태 수가 고작 715개로 줄어든다. 대칭 집합은 아주 강력한 최적화 기법이다!
무슨 일이 일어나는지 보여 주기 위해 seq가 가질 수 있는 값 네 가지를 살펴보자:
(1) <<s1, s2, s3>>
(2) <<s2, s1, s3>>

(3) <<s1, s2, s2>>
(4) <<s2, s3, s3>>
보통은 이것들을 서로 다른 초기 상태 네 개로 생각할 것이다. 하지만 꼭 그래야 할까? (1)과 (2)는 모든 s1을 s2와 맞바꿨다는 점만 다르다. 마찬가지로 (3)과 (4)는 (4)에서 모든 s1을 s2로, 모든 s2를 s3으로 바꿨다는 점만 다르다. 그러니 TLC에게 이런 “대칭적인” 값들을 동일하게 취급하라고 알려 줄 수 있다.
이 방법이 통하는 것은 오직 동등성 검사만 지원하는 모델 값을 다루고 있기 때문이라는 점에 주의하자. 대신 <<1, 2, 2>>와 <<2, 3, 3>>이었다면 결과는 대칭이 아니게 되는데, s[1] + s[2]에 대해 서로 다른 결과를 내기 때문이다.
경고
대칭 집합이 항상 스펙을 더 빨리 돌려 주는 것은 아니다. TLC는 모든 대칭을 파악하는 데 어느 정도 오버헤드가 있어서, 집합이 아주 크면 그 작업이 실제로 모델을 검사하는 것보다 오래 걸릴 수 있다. 내 컴퓨터에서는 원소 8개짜리 대칭 집합으로 duplicates를 검사하면 일반 모델 집합으로 검사할 때보다 2분이 더 걸린다.
상수의 다른 쓰임새
상수로 스펙의 흐름을 제어할 수도 있다. 복잡한 스펙을 작업할 때 나는 가끔 DEBUG 상수를 만들곤 한다:
CONSTANT DEBUG
ASSUME DEBUG \in BOOLEAN

\* ...

macro print_if_debug(str) begin
  if DEBUG then
    print str;
  end if;
또 하나, DEBUG로 여러 시작 상태를 제한할 수도 있다:
Inputs ==
IF DEBUG
THEN {<<1, 2, 3, 4>>}
ELSE S \X S \X S \X S
헬퍼 상수를 만드는 걸 두려워하지 마라!
요약
상수를 쓰면 모델마다 어떤 것에 서로 다른 값을 쓸 수 있다.
상수에는 일반 TLA+ 식, 모델 값, 모델 값의 집합을 할당할 수 있다.
ASSUME은 상수에 의미 있는 값을 할당했는지 검사한다.
모델 값은 자기 자신과만 같고 그 밖의 어떤 것과도 같지 않다. 센티널 값으로 유용하다.
모델 값의 집합은 대칭 집합으로 만들 수 있으며, 그러면 (대개) 모델 체킹(model checking)이 빨라진다.
- 1
이는 프로그래밍 언어는 물론 다른 명세 언어에서 상수라는 말을 쓰는 방식과도 다르다. 내가 아는 한 TLA+만의 특이한 점이다. “절대 변하지 않는 값”이라는 의미의 상수는 그냥 인자가 0개인(0-arity) 연산자일 뿐이다.