스펙 작성하기
개요
지난 장에서는 연산자(operator), 집합(set), 값(value)을 소개하고 이것들로 간단한 계산을 해 보았다. 기초 작업을 마쳤으니, 이제 드디어 명세(specification)에 대해 이야기할 차례다.
TLA+는 액션의 시간 논리(Temporal Logic of Actions)이며, 여기서 “액션(action)”은 시스템의 상태 변화를 기술한 것이다. 변화를 표현하는 강력한 방법이지만 매우 범용적이기도 해서, 더 강력한 시스템을 표현할 수 있도록 상당한 복잡성을 감수한다. 많은 엔지니어가 배우기 시작하는 단계에서부터 애를 먹는다. 그래서 2009년에 Leslie Lamport가 PlusCal이라는 DSL을 만들었다. PlusCal은 TLA+ 액션으로 컴파일되는, 좀 더 프로그래밍 언어 같은 문법이다.
PlusCal은 “날것의” TLA+만큼 강력하지 않으며, PlusCal로는 쓸 수 없는 종류의 스펙도 있다. 하지만 다른 많은 종류의 스펙에서는 모든 것을 TLA+로 하는 것보다 더 단순하고, 배우기도 더 쉽다. 교육자로서 내 경험상, 대부분의 프로그래머는 날것의 TLA+부터 시작할 때보다 PlusCal을 먼저 배우고 나서 날것의 TLA+를 배울 때 더 수월하게 익힌다. 그래서 이 책의 나머지 입문 파트에서는 PlusCal을 사용한다.
노트
수학 쪽 성향이 더 강하거나, 이미 PlusCal을 알고 있어서 더 나아가고 싶다면 TLA+ 배우기 절로 건너뛰어도 된다.
PlusCal
아주 간단한 스펙으로 시작해 보자.
---- MODULE pluscal ----
EXTENDS Integers, TLC

(* --algorithm pluscal
variables
 x = 2;
 y = TRUE;

begin
  A:
    x := x + 1;
  B:
    x := x + 1;
    y := FALSE;
end algorithm; *)
====
주석 블록((* *)) 안에 있는 것이 우리의 PlusCal 알고리즘이다. 이렇게 하는 이유는 이것이 유효한 TLA+ 파일이어야 하기 때문이다. PlusCal 알고리즘은 그 아래쪽에 TLA+로 컴파일된다. 알고리즘은 반드시 --algorithm $name으로 시작해야 하며, 그렇지 않으면 일반 주석으로 취급된다. 모듈 이름과 달리 알고리즘의 $name은 어떤 것과도 대응될 필요가 없으니, 누가 신경 쓰겠냐만 루트 비밀번호로 해도 된다.
다음으로 variables 블록이 있다. 어떤 TLA+ 값이든 변수가 될 수 있다. 알고리즘 본문은 begin으로 열고 end algorithm으로 닫는다. 그 안에는 두 개의 레이블(label) A와 B가 있는데, 이는 다음 절에서 더 자세히 다룬다. 레이블 안에는 :=를 쓰는 갱신문이 있다. :=는 이미 존재하는 변수의 값을 갱신하려 할 때만 쓴다. 그 밖의 경우에는 =를 쓴다.
PlusCal을 변환(translate)하는 방법은 환경 설정에서 다뤘지만, 복습하자면 메뉴 바에서 할 수 있다.
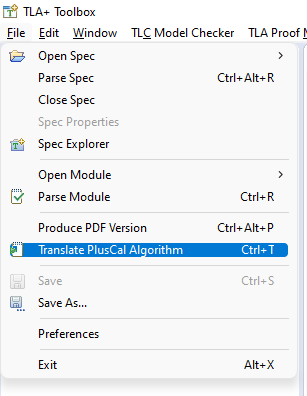
또는 Mac에서는 cmd-T를, Windows와 Linux에서는 ctrl-T를 눌러도 된다. 그러면 주석 블록 아래에 변환 결과가 들어간다.
\* BEGIN TRANSLATION
\* \* A bunch of TLA+ code
\* END TRANSLATION
이 스펙을 모델 체킹(model checking)할 때 실제로 실행되는 것은 바로 이것이다.
팁
스펙 안에서 마우스 오른쪽 버튼을 클릭하면, 컨텍스트 메뉴 맨 아래에 “Translate PlusCal Automatically”(PlusCal 자동 변환) 옵션이 있다. 변환을 자꾸 잊어버린다면 도움이 되지만, 순수 TLA+ 스펙을 작성하는 중이라면 에러가 난다.
레이블
우리가 TLA+를 배우는 것은 복잡한 시스템을 다루기 위해서이니, 레이블이 왜 필요하고 왜 존재하는지도 그 맥락에서 짚어 보자. 우리는 무엇을 향해 나아가고 있는가?
복잡한 시스템에는 동시성(concurrency)이 많아서, 많은 일이 한꺼번에 벌어진다. 이벤트는 즉각적이지 않으며, 완료되기까지 시간이 걸릴 수 있다. 하지만 이벤트마다 시간 척도가 다를 수 있다. 다음 두 스텝(step)을 비교해 보자.
숫자 100개짜리 리스트를 합산하기.
HTTP 요청을 보내고 응답을 받기.
첫 번째 코드 줄은 실행하는 데 수십 나노초가 걸리고, 두 번째는 수십 밀리초가 걸린다. 여섯 자릿수만큼의 시간 차이다. 요청과 응답 사이에 합산이 일어나는 것은 가능할 수도 있지만, 합산을 시작하고 끝내는 사이에 HTTP 요청이 일어나는 것은 사실상 불가능하다. 우리 시스템에서 첫 번째 이벤트는 “즉각적”이지만, 두 번째는 그렇지 않을 것이다.
그래서 레이블이 등장한다. 레이블은 시스템의 한 스텝 안에서 일어날 수 있는 모든 것을 나타낸다. 내가 다음과 같이 쓴다면
Label1:
  x := Sum(seq);
합산이 단일 스텝에서 일어나며, 합산의 시작과 끝 사이에 시간이 전혀 흐르지 않는다고 말하는 것이다. 반면 다음과 같이 쓴다면
SendRequest:
  \* blah blah blah
GetResponse:
  \* blah blah blah
SendRequest와 GetResponse 사이에 시간이 흐른다.
노트
레이블은 액션의 시간 논리라는 이름에 들어 있는 바로 그 “액션”을 나타낸다.
원한다면 합산을 비원자적(nonatomic)으로 만들기로 선택할 수도 있다. PlusCal에서는 이렇게 한다.
Sum:
  while i <= Len(seq) do
    x := x + seq[i];
    i := i + 1;
  end while;
while의 미묘한 부분은 나중에 이야기하겠지만, 기본 아이디어는 이제 합산의 각 반복이 비원자적이라는 것이다. 숫자 두 개를 더하고, HTTP 요청을 시작하고, 두 개를 더 더하고, 응답을 받고, 나머지를 더할 수도 있다. 아니면 HTTP의 두 스텝보다 앞서 전부 더하거나, 두 스텝이 끝난 뒤에 전부 더할 수도 있다. 동시성이란 참 기묘하다.
요점은 이것이다. 레이블을 쓰면 시스템이 정확히 얼마나 동시적인지를 명세할 수 있다. 무언가가 원자적(atomic)이라고 표현하고 싶다면 그렇게 할 수 있다. 중간에 끼어들 수 있게 하고 싶다면 그것도 할 수 있다. 바로 이 유연성 덕분에, 실제로 의미 있는 문제를 찾아내는 방식으로 시스템을 모델링할 수 있다.
레이블 규칙
여기서 우리는 시간을 모델링하고 있으므로, 레이블을 놓을 수 있는 위치에는 제약이 있다. 레이블 규칙은 마지막에 전부 다시 정리한다.
첫째, 모든 문장은 어떤 레이블에 속해야 한다. 이는 무엇보다도 알고리즘을 항상 레이블로 시작해야 한다는 뜻이다.
둘째, 어떤 변수든 레이블 하나당 한 번만 갱신할 수 있다. 기억하자. 각 레이블은 단 하나의 시간적 순간만을 나타낸다. 변수가 두 번 갱신된다면 한 순간에 서로 다른 두 값을 거쳤다는 뜻이고, 그렇다면… 그건 더 이상 한 순간이 아니다.
이는 시퀀스(sequence)를 갱신할 때 문제가 된다. 다음은 유효하지 않다.
Label:
  seq[1] := seq[1] + 1;
  seq[2] := seq[2] - 1;
한 레이블 안에서 seq 변수를 두 번 갱신하고 있기 때문이다. 이 문제를 피하도록 PlusCal에는 “동시 할당(simultaneous assignment)” 연산자 ||가 있다.
Label:

  seq[1] := seq[1] + 1 ||
  seq[2] := seq[2] - 1;
나머지 레이블 규칙은 PlusCal의 특정 구문 요소와 관련되어 있으니, 이제 그 구문 요소들을 살펴보자.
PlusCal 식
갱신 말고도 문장 수준의 구문 요소가 세 가지 더 있다.
skip: 아무것도 하지 않는 연산(noop).assert expr:expr이 거짓이면 TLC가 모델 체킹을 즉시 실패시킨다. (이는 “레이블 안의 모든 것은 한꺼번에 일어난다”는 원칙을 깨뜨린다. TLC는 실패하는assert를 발견하는 즉시 멈추기 때문이다.)assert를 쓰려면TLC를 확장(extend)해야 한다.경고
에러 트레이스(error trace)는 실패한 assert를 촉발한 스텝을 보여 주지 않는다! 그러니 assert보다는 불변식(invariant)을 쓰는 편이 낫다.
goto L: 레이블L로 점프한다. 모든 goto 문 바로 뒤에는 레이블이 와야 한다.
PlusCal의 나머지는 모두 블록 수준의 구문 요소다.
if
if Expr then
  skip;
elsif Expr2 then
  skip;
else
  skip;
end if;
if 블록 안에 레이블을 넣을 수 있다. 로직이 분기하고, 그중 일부 분기가 더 복잡한 동작을 나타낼 때 유용하다. if 블록 안에서 레이블의 균형을 맞출 필요는 없다. 어떤 분기에는 레이블이 있고 다른 분기에는 없어도 된다. 하지만 어느 한 분기라도 레이블을 갖고 있다면, 블록 전체 뒤에 레이블이 와야 한다. 그 이유를 알아보기 위해 다음을 생각해 보자.
A:
  if bool then
    B:
      skip;
  else
    skip;
  end if;
  x := 1;
bool이 참이면 x := 1은 레이블 B의 일부로 일어난다. 하지만 bool이 거짓이면 레이블 A의 일부로 일어난다. 문장은 모호함 없이 단 하나의 레이블에 속해야 하므로, 이것은 유효하지 않은 PlusCal이며, 추가 레이블 C를 넣어야 한다.
경고
초보자에게서 흔히 보는 오해는 B 레이블이 A 레이블 안에 중첩되어 있어서, 두 레이블 안에 동시에 있는 것처럼 생각하는 것이다. 실제로는 그렇게 동작하지 않는다. B 레이블에 들어가는 순간 A 레이블에서는 벗어난다. 더 나은 멘탈 모델은, B:가 A:의 조건문 안에 있으므로 B 레이블은 A에서만 도달할 수 있다고 보는 것이다.
모든 블록에 같은 수의 레이블이 있어야 하는 것은 아니다! 조건문은 서로 다른 동작을 촉발하고, 그 동작들은 걸리는 시간이 서로 다를 수 있다.
macro
매크로(macro)는 반복되는 로직 조각을 정리하는 데 도움이 되도록 만든 단순한 재작성 규칙이다. 매크로는 알고리즘의 begin 블록 위에 두어야 한다. 매크로는 레이블을 포함할 수 없다.
macro inc(var) begin
  if var < 10 then
    var := var + 1;
  end if;
end macro;
매크로는 텍스트 치환으로 취급된다. some_inc(x)를 넘기면 x 변수가 증가한다.
with
with 문을 쓰면 레이블 중간에 임시 할당을 만들 수 있다.
with tmp_x = x, tmp_y = y do
  y := tmp_x;
  x := tmp_y;
end with;
with 정의 안에서는 임시 할당을 :=가 아니라 =로 한다. 규칙을 기억하자. :=는 기존 변수를 갱신할 때만 쓴다.
매크로와 마찬가지로, with 문은 레이블을 가질 수 없다.
while
while은 우리에게 있는 유일한 형태의 루프다. while 루프 앞에는 항상 레이블이 있어야 한다.
Sum:
  while i <= Len(seq) do
    x := x + seq[i];
    Inc:
      i := i + 1;
  end while;
while은 비원자적이다. while 루프를 한 번 반복할 때마다 다시 Sum 레이블로 돌아온다. 다음 반복 전에 다른 프로세스(process)가 실행될 수 있다. 단일 프로세스 알고리즘에서는 달라지는 것이 없지만, 동시성을 추가하기 시작하면 이 점이 아주 중요해진다.
중복 검사기
PlusCal의 기초를 알았으니, 작은 문제에 적용해 보자. 나는 단순한 배열 알고리즘으로 시작하는 것을 좋아하는데, 그것을 명세할 도구를 이미 갖고 있기 때문이다. 먼저 알고리즘의 고수준 목표를 표현하는 연산자를 작성하고, 그다음 알고리즘을 작성하고, 그다음 알고리즘이 연산자와 일치하는지 검증한다.
예를 들어 seq에 중복 원소가 있는지 검사하는 알고리즘을 작성한다면, 연산자는 IsUnique(seq)가 될 수 있고, 알고리즘은 다음과 같이 동작할 수 있다.
빈 집합
seen을 만들고,seq의 원소들을 차례로 훑는다.숫자를 볼 때마다 그 숫자가 이미
seen에 있는지 확인한다.있으면, 리스트에 중복이 있다고 판정한다.
없으면, 그 원소를
seen에 추가하고 계속한다.
끝에 도달할 때까지 중복 원소를 하나도 보지 못했다면, 리스트에 중복이 없다고 판정한다.
우리의 판정은 연산자
IsUnique(seq)와 일치해야 한다.
이 장에서는 스펙을 작성하는 것, 즉 (2)와 (3) 부분에만 집중한다. 다음 장에서는 (1)과 (4) 단계를 다루며 실제로 알고리즘을 검증한다.
나는 이 스펙에 duplicates라는 이름을 붙였지만, 여기서 이름은 그리 중요하지 않다.
---- MODULE duplicates ----
EXTENDS Integers, Sequences, TLC

(*--algorithm dup
  variable seq = <<1, 2, 3, 2>>;
  index = 1;
  seen = {};
  is_unique = TRUE;

begin
  Iterate:
    while index <= Len(seq) do
      if seq[index] \notin seen then
        seen := seen \union {seq[index]};
      else
        is_unique := FALSE;
      end if;
      index := index + 1;
    end while;
end algorithm; *)
====
(따로 설명하지 않아도 이해될 거라고 생각하지만, 이 일을 너무 오래 하다 보니 이제는 무엇이 설명 없이 이해되고 무엇이 아닌지 도무지 모르겠다. 충분히 많은 사람이 아니라고 하면 여기에 더 자세한 설명을 넣겠다.)
실행해 보면 다음과 같은 페이지가 보일 것이다.
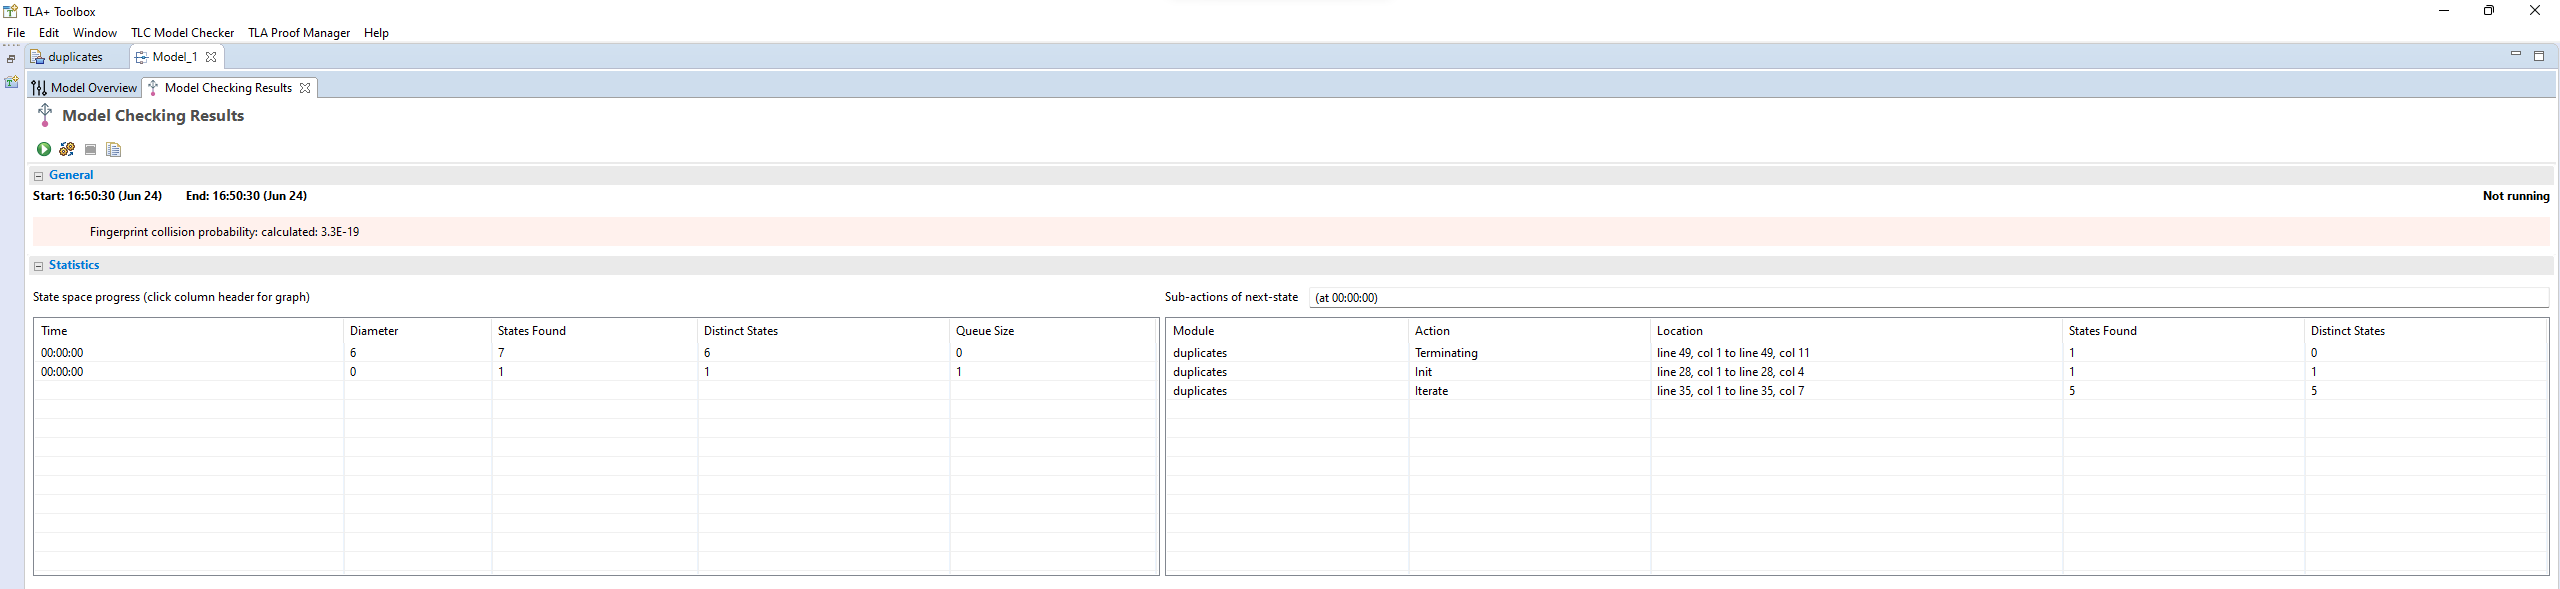
(클릭하면 확대된다)
성공적으로 완료되었다는 것을 알 수 있는 이유는, 그렇지 않았다면 오른쪽에 커다란 에러 바가 나타났을 것이기 때문이다. 이 페이지에 있는 모든 것은 실행을 더 잘 이해하도록 돕는 통계다.
복잡한 모델(model)은 체크하는 데 오랜 시간이 걸릴 수 있으므로, “state space progress”(상태 공간 진행 상황) 탭은 대략 1분에 한 번 갱신된다.
지름(diameter)은 가장 긴 행동(behavior)의 길이다. TLC가 길이 2인 행동을 천 개, 길이 20인 행동을 하나 찾았다면, 지름은 20으로 보고된다.
발견한 상태(states found)는 모델 체커가 탐색한 시스템 상태의 수다. 여기에는 체커가 서로 다른 경로에서 발견한 중복 상태도 포함된다.
발견한 고유한 상태의 수.
TLC가 체크해야 한다는 것을 확실히 아는 상태의 수. 이 상태들 중 일부는 체크할 상태를 더 늘리고, 그 상태들이 또 늘리고, 그런 식으로 계속된다.
TLC는 탐색한 상태를 해시로 저장하는데, 이것은 해시 충돌이 일어날 확률이다. 실제로는 절대 천조분의 1을 넘지 않으므로 무시해도 된다.
각 레이블이 몇 번 실행되었고 그 결과 몇 개의 상태로 이어졌는지. 어떤 레이블의 상태가 0개라면 스펙에 버그가 있을 가능성이 높다.
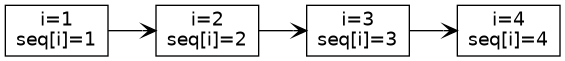
Iterate 루프 네 번에 Initial과 Done 상태를 더하면 서로 다른 상태 6개가 된다.
제대로 따라오고 있는지 확인하려면, 상태 수와 서로 다른 상태(distinct state) 수가 내 결과와 같은지 확인해 보면 된다. 내 경우에는 상태 7개 / 서로 다른 상태 6개가 나왔고, 여러분도 그렇게 나와야 한다. 다른 숫자가 나왔다면 스펙을 옮겨 적다가 실수했을 수 있다. 상태 수와 서로 다른 상태 수는 모델의 부분적인 “지문(fingerprint)”이 된다. 앞으로 스펙을 보여 줄 때마다 코드 블록 아래에 모델 체킹의 상태 수와 서로 다른 상태 수를 적어 두겠다.
노트
스펙이 실패하면 나와 다른 숫자가 나온다. TLC가 실행을 일찍 끝내기 때문이다. 그런 경우에는 코드를 보여 줄 때 모델 체킹이 실패해야 한다고 적어 두겠다.
더 많은 입력 테스트하기
이제 중복 검사기의 기본 구현이 생겼다. 하지만 실행할 때는 중복이 없는 시퀀스와 중복이 있는 시퀀스 모두에서 제대로 동작하는지 확인하고 싶다. 지금은 시퀀스 하나만 하드코딩했으므로 두 경우 중 하나만 체크할 수 있다.
둘 다 체크하려면 시작 상태를 여러 개 쓰면 된다. TLA+에서는 변수에 값을 할당할 수 있을 뿐 아니라, 변수가 어떤 집합의 어떤 원소로 시작한다고 말할 수도 있다. 다음과 같다.
 EXTENDS Integers, Sequences, TLC

 (*--algorithm dup
-  variable seq = <<1, 2, 3, 2>>;
+  variable seq \in {<<1, 2, 3, 2>>, <<1, 2, 3, 4>>};
   index = 1;
   seen = {};
   is_unique = TRUE;
이제 모델 체커는 seq의 값으로 <<1, 2, 3, 2>>와 <1, 2, 3, 4>>를 모두 체크한다. 좀 더 구체적으로는, 가능한 값마다 하나씩 완전한 실행을 두 번 한다. 두 완전한 실행, 즉 행동(behavior) 중 어느 하나라도 에러로 이어진다면 TLC가 알려 준다.
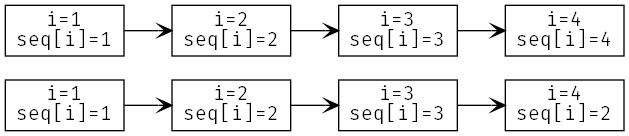
가능한 시작 상태가 두 개 있고, 각각 자신만의 행동을 갖는다.
시작 상태를 여러 개 추가하면 모델의 복잡도가 커진다. 어떤 스펙에서 TLC가 원래 상태 10개를 체크해야 한다면, 초기 상태(initial state) 100개를 추가하면 상태 공간(state space)이 최대 1,000개까지 늘어날 수 있다. 실제로는 이보다 적은 경우가 많은데, 초기 상태들이 한데 수렴할 때가 있기 때문이다.
variables x \in 1..1000;
begin
  A:
    x := 0;
  B:
    x := x+1;
end algorithm;
초기 상태 1000개와 레이블 2개가 있으니 총 3,000개의 상태가 생길 거라고 생각할 수도 있다. 실제로는 첫 번째 레이블이 상태 공간을 “붕괴”시킨다. 그래서 서로 다른 상태의 수는 훨씬 적어진다.
시작 상태 10,000개
이제 입력 두 개를 테스트하고 있다. 입력 하나보다 두 배 좋다. 그보다 더 좋은 것은 입력 10,000개를 테스트하는 것이다. 지난 장에서 값의 집합을 생성하는 이야기를 했던 것을 기억하는가? 여기가 그 기능이 정말 유용한 수많은 곳 중 하나다.
 ---- MODULE duplicates ----
 EXTENDS Integers, Sequences, TLC

+S == 1..10
+
 (*--algorithm dup
-  variable seq = <<1, 2, 3, 2>>;
+  variable seq \in S \X S \X S \X S;
   index = 1;
   seen = {};
   is_unique = TRUE;
spec이제 흥미로운 엣지 케이스를 모두 다룰 가능성이 훨씬 높아졌다. 그렇다고 보장되는 것은 아니다. 어딘가에 -187이 들어 있을 때만 촉발되는 버그가 있을지도 모른다. TLA+는 엔지니어링 판단을 보강할 수 있을 뿐, 대체할 수는 없다. 하지만 내 판단으로는 -187이 엣지 케이스일 가능성은 낮으므로, 이 정도면 좋은 커버리지라고 자신 있게 말하겠다.
노트
좋다, 큰 구멍이 하나 있긴 하다. 여러 가지 원소를 시도하고 있지만, 고정된 길이 하나만 보고 있다. 길이가 1이거나 0인 시퀀스에서 문제가 생길지도 모른다. 함수 집합을 배우고 나면 이 문제를 고칠 수 있다.
이제 상태 공간을 폭넓게 커버하게 되었으니, 속성(property)을 작성할 차례다. 다음 장에서는 검사기가 항상 올바른 결과를 낸다는 것을 명세한다.
요약
명세에는 변수가 있다. 변수는 고정된 값(
=사용)이거나 집합의 원소(\in사용)일 수 있다. 어떤 TLC 값이든 변수가 될 수 있다.집합의 원소라면, TLC는 가능한 모든 시작 상태에서 모델을 테스트한다.
PlusCal은 명세 작성을 더 쉽게 해 주는 언어다.
PlusCal 알고리즘 본문에서 변수는
:=로 갱신한다.=는 비교다.
PlusCal 스펙은 원자적으로 일어나는 계산 단위인 레이블로 나뉜다. 레이블 안의 모든 것은 한꺼번에 일어난다. 레이블을 놓을 수 있는 위치에는 제약이 있다.
매크로는 스펙 중복 제거의 기본 단위다.
PlusCal에는
with,if,while을 비롯한 여러 블록 구문 요소가 있다.with는 블록 안에서 임시 식별자를 만든다.while문은 비원자적이다. 매 루프가 별도의 스텝에서 일어난다.