institute.deepmind.com · DeepMind Institute · 2026-11-19
AGI 다음에는 무엇이 오는가?
Google DeepMind 연구원 팀 게네바인이 2026-11-19 DeepMind Institute에 쓴 에세이의 완역과 팩트체크다. 그는 AGI를 지능 연속체 위의 한 점으로 놓고, 그 너머의 초지능(ASI)으로 가는 길을 넷으로 나눈다. 모델·데이터 확장, 기술 패러다임 전환, 에이전트 협응, 재귀적 자기 개선이다. 길들이 서로를 밀어 주므로 한 축만 묶어서는 진전이 멈추지 않는다는 것이 그의 결론이다. 인용 문헌 40건은 모두 실재한다. 하드웨어 지출과 알고리즘 효율의 배율, 'AlphaZero' 링크는 출처와 다르다.
읽기 전에
팀 게네바인(Tim Genewein)은 범용 인공지능(artificial general intelligence, AGI) 다음 단계로 가는 길이 여러 개라서 어느 한 길을 막아도 AI의 진전이 멈추지 않는다고 본다. Google DeepMind 연구 과학자인 그가 2026-11-19 DeepMind Institute에 올린 에세이 「What comes after AGI?」의 결론이다. 범용 인공 초지능(artificial general superintelligence, ASI)으로 가는 길들은 서로를 밀어 준다. 그가 내놓는 처방은 모형화, 측정, 예측과 그 반복이다. 이 일에는 프런티어 연구소와 국가 기관, 국제 기관이 함께 나서야 한다고 그는 본다.
이 에세이는 게네바인이 공저자 13명과 함께 쓴 기술 보고서 「From AGI to ASI」를 바탕으로 한다. DeepMind Institute는 Google과 Google DeepMind 연구자들이 시작한 게시 플랫폼이다. 글 끝의 고지문은 이 글을 Google의 공식 견해로 읽지 말라고 적는다.
저자 스스로 ASI로 가는 여러 길에서 어느 예측도 확실하지 않다고 쓴다. 같은 문단에서 그는 이 경로와 시나리오가 근거 없는 과장이나 허구와도 거리가 멀다고 덧붙인다.
핵심 질문
AGI에 닿은 AI는 어떤 길들을 거쳐 ASI까지 갈 수 있는가?
멘탈 모델
지능은 한 줄의 눈금이다. AGI는 그 위의 한 점이다. 눈금의 끝에는 계산할 수 없는 이론상 상한이 있다.
눈금을 오르는 길은 양과 질로 나뉜다. 같은 AI를 더 많이, 더 빨리 돌리면 양으로 오른다. 저자의 비유로는 프톨레마이오스 천문학자 10만 명이 모인 학회도 일반 상대성 이론에는 아마 닿지 못한다. 그 칸이 질의 몫이다.
양의 전망은 지금까지의 추세를 10년 앞으로 늘여 셈한 외삽이다. 질의 전망은 그렇게 셈하지 못한다. 원문은 네 경로마다 아직 답이 없는 물음을 남긴다.
권장 읽기 순서
- Executive Summary에서 주장 전체를 먼저 본다.
- 팩트체크에서 연간 성장 배율과 본문이 인용한 문헌이 어디까지 맞는지 확인한다.
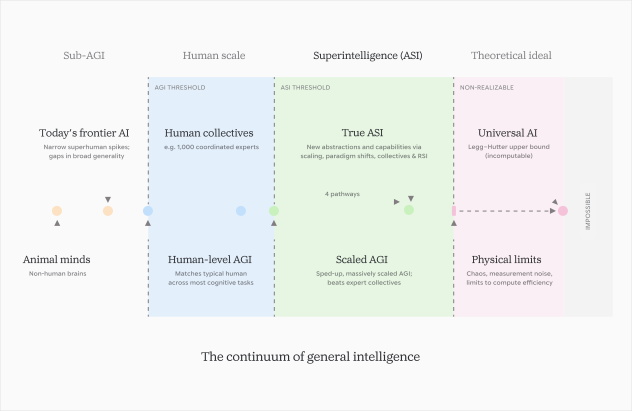
- 원본 완역의 일반 지능의 연속체에서는 그림 1의 눈금 위 두 점을 찾아 둔다. 'Scaled AGI'는 속도와 규모를 키운 AGI다. 'True ASI'는 새 추상과 능력을 갖춘 ASI다.
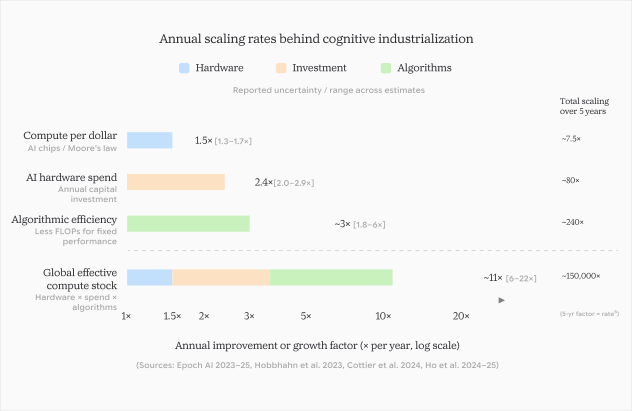
- 인지 산업화는 사람 수준에서 Scaled AGI까지 가는 양의 길이다. 그림 2의 하드웨어 지출 배율(연 2.4배)과 합계 배율(연 약 11배)은 본문 숫자(연 약 2.5배, 연 10배 이상)와 조금 다르다. 논지는 장 끝 무렵, 인지 산업화만으로 ASI에 닿느냐고 묻는 문단에서 꺾인다.
- AGI에서 ASI로 가는 네 갈래 길은 Scaled AGI에서 True ASI로 가는 질의 길이다. 네 소절 모델과 데이터 확장, 기술 패러다임 전환, 에이전트 협응 개선, 재귀적 자기 개선(recursive self-improvement, RSI)은 경로마다 병목을 함께 적는다.
- ASI로 가는 여러 길은 네 경로를 합쳐 규제와 측정에 관한 결론을 낸다.
- 저자가 결론을 직접 말하는 원문 문단 8개만 따라가도 논지는 이어진다. 일반 지능의 연속체의 둘째 문단, 인지 산업화에서 세 요인을 곱하는 문단과 인지 산업화만으로 ASI에 닿느냐고 묻는 문단, 네 갈래 길의 첫 문단, 여러 길의 첫 네 문단이다.
선행 개념
- 일반 지능의 이론상 상한(Legg–Hutter)
- 일반 지능의 연속체가 수학으로 잘 안다고만 쓰는 지능의 위쪽 끝은 셰인 레그(Shane Legg)와 마커스 허터(Marcus Hutter)의 보편 지능 정의다. 두 사람은 이 에세이의 바탕 보고서 공저자다. 이 정의는 에이전트가 계산 가능한 모든 환경에서 거두는 성과를, 단순한 환경일수록 크게 쳐서 더한다. 이 점수를 최대로 만드는 이론상 에이전트는 계산할 수 없다. 모든 환경에서 점수를 내려면 처음 보는 환경을 관찰만으로 배워야 한다. 기술 패러다임 전환이 재학습 없이 프롬프트 안에서 학습 알고리즘을 돌리는 능력을 이 상한에 이르는 재료로 꼽는 대목이 여기에 이어진다.
- Expert AGI
- ASI로 가는 여러 길은 진전이 지금에서 Expert AGI를 거쳐 초인 영역으로 비교적 매끄럽게 이어질 수 있다고 쓴다. Expert AGI는 원문이 일반 지능의 연속체에서 링크한 「Levels of AGI」(arXiv 2311.02462, 2023-11) 틀의 단계 이름이다. 숙련된 성인의 90번째 백분위 이상으로 과제를 해내는 수준을 가리킨다.
- 유효 연산량(effective compute)
- 물리 연산량에 알고리즘 효율을 곱한 양이다. 같은 성능에 드는 연산이 절반으로 줄면 칩을 두 배로 늘린 것과 같게 친다. 연산량은 FLOP(부동소수점 연산 1회)의 수로 센다. 인지 산업화는 달러당 연산량, 알고리즘 효율, 하드웨어 지출의 연간 배율을 더하지 않고 곱한다. 배율은 해마다 다시 곱해진다. 연 10배가 10년 이어지면 10¹⁰배, 곧 100억 배다.
예상 소요
원문 영어 본문은 2,789단어다. 성인이 영어 비소설을 소리 내지 않고 읽는 평균 속도인 분당 238단어(Brysbaert 2019)로 나누면 완독에 약 12분이 든다. 권장 읽기 순서 마지막 항목의 원문 문단 8개는 708단어다. 같은 기준으로 요약만 읽는 데는 약 3분이 든다.
점검 질문
같은 수준의 AI를 더 많이, 더 빨리 돌리는 것만으로 ASI에 닿는가?
사람 수준 AI에 먼저 닿는다면 '약한 ASI'까지는 건널 수도 있다고 저자는 본다. 느리고 비싼 사람 수준 AI 몇 개와, 사람보다 훨씬 빠른 에이전트 수십억 개가 움직이는 세계는 다르다는 이유다. 그 앞 단계에는 단서가 붙는다. 지금의 AI를 속도와 수로만 키우면 완전한 AGI에도 못 미칠 수 있다. 답이 있는 곳: 인지 산업화에서 인지 산업화만으로 ASI에 닿느냐고 묻는 문단.
훈련용 연산량 같은 입력 하나만 묶으면 무슨 일이 생긴다고 저자는 보는가?
노력이 나머지 경로로 옮겨 간다. 경제·지정학 경쟁이 그렇게 만들 가능성이 크다는 것이 저자의 판단이다. 진전에 여러 입력이 함께 필요하면 위험이 하나 더 생긴다. 묶인 입력이 제자리에 있는 동안 다른 입력은 앞서 나간다. 그 차이가 능력 '오버행'으로 쌓인다. 묶었던 입력이 풀리거나 우회로가 생기면 진전이 한꺼번에 가파르게 튄다. 답이 있는 곳: ASI로 가는 여러 길의 첫 두 문단.
RSI는 어느 분야에서 가장 빨리 나아간다고 저자는 보는가?
수학 증명처럼 사람 없이 자동으로 검증할 수 있는 분야다. RSI 고리는 길잡이 피드백이 나쁘면 쉽게 멈추거나 퇴화한다. 초인 영역에서는 사람 집단도 AI의 출력을 쉽게 평가하지 못한다. 평가 방법이 그 영역까지 빠르게 따라 올라가야 고리가 돈다. 자동 검증이 어려운 분야는 뒤처지거나 더 일찍 잦아들 수 있다. 답이 있는 곳: 재귀적 자기 개선(RSI)의 마지막 문단.
Executive Summary
2026-11-19(한국 시각 11-20) DeepMind Institute에 실린 에세이 「What comes after AGI?」에서 Google DeepMind 연구원 팀 게네바인(Tim Genewein)은 다음 10년의 빠른 AI 진전이 진지한 가능성이라고 결론짓는다. 근거는 범용 인공지능(artificial general intelligence, AGI)에서 범용 인공 초지능(artificial general superintelligence, ASI)으로 가는 경로가 여럿이고 서로 맞물린다는 것이다. 최전선 능력이 제자리여도 연산량과 효율이 지금 추세로 늘면 AI 에이전트의 수와 속도가 폭증하는 '인지 산업화'가 올 수 있다고 그는 본다. 규모로 메우지 못하는 능력은 모델·데이터 확장, 패러다임 전환, 에이전트 협응, 재귀적 자기 개선(recursive self-improvement, RSI)이 열 수 있다고 쓴다. 그는 한 경로만 묶는 규제가 전체 진전을 멈추지 못한 채 능력 오버행(capability overhang)을 부른다고 경고한다. 예측이 확실하지 않다고 스스로 밝히면서, 그는 대응으로 모델링·측정·예측의 반복을 내놓는다.
신뢰도 B — 인용 문헌 40건은 모두 실재하고 거짓 주장은 없다. 성장률 숫자 몇 개가 출처보다 세게 적혔다. 사실 주장과 인용 70건은 사실 48건, 부분 사실 21건, 불확실 1건이다. 하드웨어 지출 배율(원문 지난 10년 연 약 2.5배 → 확인 최대 학습 1회 비용 2016년 이후 연 2.4배), 알고리즘 효율의 10년 구간(원문 연 3~6배 → 확인 10년 추정 연 약 2.5배), 'AlphaZero' 링크(원문 AlphaZero → 확인 AlphaGo Zero 논문, Nature 2017)는 출처와 다르다. RSI를 처음 논한 사람으로 든 I. J. 굿(1965)과 레이 솔로모노프(1985) 사이에는 20년 차이가 있고, 굿 자신도 앞선 문헌을 인용한다. 2030년까지 1,000배, 10년 안에 10억 배라는 에이전트 확장 수치는 인용한 페이지에 없는 저자의 종합이다. 저자 소개의 'Universal AI 팀 공동 리드'는 공개 자료로 확인되지 않는다. 항목별 근거는 팩트체크에 있다.
아래 각 항목 앞의 표시는 원문 문장의 종류다. 표시는 참·거짓 판정이 아니다. 인용 수치와 출처의 확인 결과는 팩트체크에 있다.
정의
저자가 용어의 뜻을 정한 문장
진술
저자가 과거나 현재의 상태로 적은 문장. 저자가 인용한 연구의 결과도 여기에 든다
논증
근거에서 결론이나 해야 할 일을 끌어낸 저자의 추론
예측
미래나 가정 위의 전망. 원문의 '수 있다' 같은 단서를 그대로 옮긴다
미해결
저자가 아직 답이 없다고 밝힌 질문
AGI가 손에 닿으면서 그다음을 미룰 수 없게 됐다
- 정의 저자는 AGI를 거의 모든 인지 과제에서 인간과 맞먹는 기계로 정의한다.
- 진술 AI 연구는 수십 년 동안 AGI를 목표로 삼아 왔다고 저자는 쓴다. 지능이 원리상 인간 수준을 넘을 수 있다는 점은 늘 분명했다. AGI 자체가 멀고 불확실했기 때문에 그 너머를 보는 일은 이르다고 여겨졌다는 것이다.
- 논증 AGI가 손에 닿는 거리에 들어왔으므로 그다음을 더는 미룰 수 없다고 저자는 쓴다. 부제에 따르면 초지능으로 가는 기술 경로들이 모양을 갖추면서 AGI 너머의 영역이 철학적 사변에서 실증 연구와 거버넌스의 질문으로 옮겨 가고 있다.
- 예측 확실과는 거리가 멀지만 AI가 지금 속도를 유지하거나 더 빨라지면서 ASI로 나아갈 수 있다고 저자는 내다본다. 그 경우 ASI는 과학·경제·사회를 AGI보다 훨씬 큰 규모와 속도로 바꿀 수 있다고 쓴다.
- 논증 이 전환에 대비하려면 AGI에서 ASI로 가는 길을 지도로 그려야 한다고 저자는 쓴다. 진전을 추적할 엄밀하고 믿을 만한 방법도 함께 세워야 한다는 것이다.
인간 수준 AGI는 일반 지능 연속체의 한 점이고, 그 위 구간은 지도에 없다
- 정의 저자는 생물이든 인공이든 일반 지능을 하나의 연속체 위에 놓고 보자고 제안한다(원문 「일반 지능의 연속체」). 인간 수준 AGI는 그 위의 한 점이다.
- 정의 저자의 ASI는 인간 전문가 대규모 집단이 몇 년 걸릴 과제에서 더 적은 자원과 시간으로 그들을 꾸준히 앞서는 시스템이다. 저자는 한 연구 분야 전체가 이룰 과학적 진전을 훨씬 짧은 시간에 이루는 일을 예로 든다. 칩 설계 같은 기술 개발에서 대기업이 한 해에 해내는 만큼을 이루는 일도 예로 든다.
- 정의 이 기준은 좁은 몇 영역이 아니라 인간이 관심을 두는 거의 모든 과제에서 충족돼야 한다고 저자는 쓴다.
- 진술 좁은 영역의 초인 성능은 이미 있다고 저자는 쓴다. 체스와 바둑에서 어떤 인간도 이기는 AI, 아미노산 서열에서 단백질 구조를 예측하는 AI, 수학자들이 수십 년 동안 풀지 못한 정리를 증명하는 AI가 그 예다.
- 진술 연속체의 맨 위인 일반 지능의 이론적 한계는 수학적으로 잘 이해돼 있다고 저자는 쓴다. AI가 이룰 수 있는 일에는 물리·논리·계산 복잡도의 엄격한 한계도 있다. 기후, 면역계, 인간 사회 같은 실제 복잡계의 전개를 임의의 정밀도로 예측하는 일이 그런 한계에 걸린다.
- 논증 상한을 알아도 그 앞에 무엇이 오는지는 알 수 없다고 저자는 쓴다. '충분히 좋은' 근사가 얼마나 유능할지는 이론으로도 예측하기 어렵다. 체스를 완벽하게 풀려면 지구에 있는 것보다 훨씬 많은 연산량이 든다. 엄지손톱만 한 칩은 그만한 연산량 없이도 어떤 인간도 이길 만큼 체스를 둔다.
- 진술 근본 한계는 오늘의 AI와 인간 모두에게서 멀리 떨어져 있다고 저자는 쓴다. 인간 수준 AI와 이론적 한계 사이에는 전문가 AGI와 점점 더 발전하는 초지능 체계들이 들어선다. 저자는 이 넓은 공간이 대부분 지도에 없다고 진단한다.
원문 그림 1은 이 연속체를 AGI 미만, 인간 규모, 초지능, 이론적 이상의 네 구간으로 나눈다. 동물의 마음과, 좁은 영역에서만 초인적인 오늘의 최전선 AI는 AGI 미만 구간에 있다. 인간 규모 구간은 인간 수준 AGI에서 시작해 협응된 전문가 1,000명 같은 인간 집단까지 품는다. 초지능 구간은 속도와 규모를 키워 전문가 집단을 이기는 확장된 AGI(Scaled AGI)에서 시작해 '네 경로'를 거쳐 진짜 ASI에 이른다. 그림은 진짜 ASI를 확장, 패러다임 전환, 집단, RSI로 새 추상과 능력을 얻은 상태로 적는다. 실현할 수 없는 이론적 이상 구간은 카오스, 측정 잡음, 연산 효율의 한계로 이루어진 물리적 한계에서 시작해 계산 불가능한 레그–허터 상한인 보편 AI(Universal AI)에서 끝난다.
능력이 제자리여도 연산량과 효율의 증가만으로 인지 산업화가 올 수 있다
- 논증 최전선 능력의 진전에 비관적인 독자에게도 따져 볼 경우가 있다고 저자는 쓴다(원문 「인지 산업화」). AI 하드웨어와 소프트웨어가 계속 효율화되는 경우다.
- 진술 지난 10년 AI 진전은 유효 연산량(effective compute)의 꾸준한 증가가 이끌었다고 저자는 쓴다. 유효 연산량을 키운 요인은 하드웨어 제조 개선, 알고리즘 효율, 연산 하드웨어 투자다. 세 요인은 서로 곱해진다. 요인별 배율과 근거는 아래 수치표에 있다.
- 논증 알고리즘 효율을 두 배로 올리는 일은 물리적 연산량 총량을 두 배로 늘리는 일과 거의 같다고 저자는 쓴다.
- 논증 세 요인을 곱하면 전 세계 유효 연산량 총량이 해마다 최소 10배, 10년이면 100억 배로 는다고 저자는 계산한다.
- 예측 이 추세가 이어진다면 10년 뒤에는 오늘 돌리는 에이전트 하나마다 같은 품질의 에이전트를 세계 인구보다 많이 돌릴 수 있다고 저자는 쓴다. 저자는 이를 가설적 계산으로 제시한다.
- 예측 하드웨어와 추론 소프트웨어의 효율 개선만으로 AI 작업 하나를 돌리는 데 드는 연산량 수요가 해마다 약 4배 준다고 저자는 쓴다. 오늘 연산 토큰으로 10억 달러가 드는 인지 작업이 10년 뒤 1,000달러가 된다는 계산이다.
- 진술 2023년 이후만 보면 비용 하락이 더 가파르다고 저자는 쓴다. 저자는 Epoch AI 연구를 근거로 들어, 벤치마크 묶음의 고정 점수를 얻는 소비자 가격이 2023년 이후 해마다 13배 넘게 떨어졌다고 쓴다.
- 예측 두 추세를 다음 10년으로 외삽하면 유효 연산량 총량은 훨씬 커진다. AI가 하는 인지 작업의 비용은 그만큼 급락한다. 저자는 그 결과 많은 인지 과제가 곧 상품화될 수 있다고 내다본다.
- 예측 기계적 산업화가 반복적 육체노동을 상품으로 만들었듯, 이 변화는 인지 산업화로 이어진다고 저자는 쓴다.
- 정의 저자의 인지 산업화는 여러 부문에 걸친 인지 작업의 빠른 표준화·자동화, 산업 규모의 인프라 구축, 일부 인지 산출물과 서비스의 풍부함을 특징으로 한다.
- 예측 이런 지능의 폭증이 당연한 일은 아니라고 저자는 인정한다. 저자는 연산 설비 구축의 실질적 상한과 알고리즘 효율의 더 사변적인 상한을 함께 보더라도 오늘 AI 에이전트의 유효 개체 수가 2030년까지 1,000배 넘게 늘 수 있다고 쓴다. 2026-11 기준 10년 안에는 10억 배 넘게 늘 수 있다는 것이다.
- 논증 인지 산업화만으로 ASI에 닿는지에 대해 저자는 유보한다. 다른 차원의 진전을 멈추고 오늘의 AI를 속도와 수로만 늘리면 결과가 온전한 AGI에도 못 미칠 수 있다. 사람 도움 없이는 AI가 못 하는 인지 과제가 남을 수 있기 때문이다.
- 논증 저자는 규모가 그 자체로 질이 될 수 있다고 쓴다. 대체로 인간 수준인 AI를 이룬다고 가정하면, 느리고 비싼 인간 수준 AI와 수십억 에이전트가 인간보다 훨씬 빨리 움직이는 세계는 크게 다르다. 그 양적 도약만으로 AGI와 약한 ASI 사이의 질적 간극을 메울 수도 있다는 것이 저자의 논지다.
- 진술 인간과 달리 디지털 지능은 더 많고 빠른 연산에서 직접 이득을 본다고 저자는 쓴다. 저자가 드는 이점은 다섯이다.
- 처리 속도: AI 시스템은 추론, 데이터 수용, 출력 생성의 속도를 계속 높일 수 있다.
- 작업 기억과 암기: 오늘의 모델은 인터넷의 큰 부분을 말 그대로 외울 수 있다. 작업 기억 용량도 인간의 한계를 훨씬 넘는다.
- 기질 독립성(substrate independence): 같은 AI 시스템이 다른 컴퓨터로 옮겨 갈 수 있다. 더 빠르거나 에너지 효율이 높은 하드웨어로 갈아탈 수도 있다. 이질적이고 공간적으로 흩어진 기기 무리에서 나뉘어 돌 수도 있다.
- 무손실 복제: 디지털 지능은 거의 즉시, 손실 없이 복사된다. DNA에 해당하는 소스 코드만이 아니라 평생 경험에 해당하는 기억 상태까지 복사된다. 전문 시스템을 한 번 훈련시킨 뒤 필요할 때 수백만 개 사본으로 띄울 수 있다.
- 고대역 경험 공유: 인간은 남을 가르치려면 경험과 지식을 강하게 압축해야 한다. AI는 저장해 둔 고대역 디지털 입출력 흐름을 집단 전체에 다시 틀 수 있다. 동질적인 AI 집단은 날것의 학습 신호를 직접 나눌 수도 있다.
양으로 못 메우는 능력은 네 기술 경로가 연다
- 논증 효율이 오르고 연산량이 늘면 주어진 능력 수준에서 AI 에이전트의 속도와 수를 키울 수 있다고 저자는 쓴다(원문 「AGI에서 ASI로 가는 네 갈래 길」). 빠진 능력 가운데 일부는 양으로 메우기 어렵거나 불가능하다. 저자의 비유로는 아인슈타인은 일반상대성이론을 알아냈지만, 프톨레마이오스 천문학자 10만 명이 모인 학회는 아마 그러지 못했다.
- 예측 AI는 전에 없던 인지 능력을 여는 네 기술 경로를 따를 수 있다고 저자는 쓴다. 경로별 상세 논의는 저자 팀의 기술 보고서 From AGI to ASI에 있다고 밝힌다.
모델과 데이터 확장: 데이터 고갈, 수확 체감, 자원 한계가 막는다
- 진술 지금까지 질적 능력은 모델과 데이터의 규모를 따라 꾸준히 좋아졌다고 저자는 쓴다(원문 「모델과 데이터 확장」). 이 추세를 담은 것이 스케일링 법칙이다. 스케일링 법칙은 모델 성능을 훈련 연산량과 훈련 데이터에 잇는다. 그 대상은 테스트 시점 연산으로도 넓어졌다. 테스트 시점 연산은 모델이 답하기 전에 문제를 추론하도록 더 주는 연산량이다.
- 논증 스케일링 '법칙'은 관찰된 추세의 외삽이어서 익숙한 경계 안에서만 성립한다고 저자는 쓴다. 경계의 예는 특정 모델 아키텍처, 훈련 데이터의 종류, 평가 묶음이다. AGI나 ASI에 필요한 규모를 이 법칙으로 자신 있게 예측할 수 없는 이유다. 저자는 대신 확장을 막을 병목을 짚는다.
- 진술 첫 병목은 데이터 고갈이다. 고품질 훈련 데이터의 수요가 인류의 생산 능력을 앞지르고 있다고 저자는 쓴다. 합성 데이터가 도울 수 있지만, AI 모델이 만든 데이터가 모두 훈련에 쓸모 있지는 않다.
- 논증 이 '데이터 벽'을 넘을 수단으로 저자는 고충실도 시뮬레이션, 상호작용하는 강화학습(reinforcement learning, RL) 환경 안의 데이터 생성, 테스트 시점 연산으로 다음 모델의 훈련 데이터를 개선하는 일을 든다.
- 진술 둘째 병목은 모델 규모의 수확 체감이다. 능력을 선형으로 한 단계 올릴 때마다 대개 훈련 연산량과 모델 크기를 더하는 데서 그치지 않고 곱해야 한다고 저자는 쓴다. 큰 모델은 느려서 사고 사슬(chain-of-thought) 추론 같은 테스트 시점 확장 방법을 가로막는다.
- 진술 셋째 병목은 물리적·경제적 자원의 한계다. 훈련 연산량을 여러 자릿수 늘려 가려면 발전소, 전력망, 반도체 공장, 저지연 하드웨어 연결을 지어야 한다고 저자는 쓴다. 이 건설은 현실의 한계에 부딪힌다.
- 미해결 인지 산업화의 주 추세인 하드웨어·소프트웨어 효율 향상이 이 자원 한계를 메울 수 있을지는 불분명하다고 저자는 쓴다.
기술 패러다임 전환: 지속 학습과 새 개념 발명이 빈칸이다
- 진술 오늘의 지배적 패러다임은 거대한 데이터에서 긴 시퀀스의 다음 기호를 예측하도록 대형 트랜스포머를 훈련시키는 것이라고 저자는 쓴다(원문 「기술 패러다임 전환」). 그 뒤 모델이 추론과 지시 따르기를 배우도록 다듬는다. 마지막으로 테스트 시점 연산을 더 준다.
- 진술 저자가 인용한 연구는 이 패러다임이 원리상 재훈련 없이 프롬프트만으로 복잡한 알고리즘을 돌리는 모델을 낳을 수 있다고 시사한다. 그런 알고리즘에는 강력한 학습 알고리즘도 들어간다.
- 논증 저자는 이 성질을 지능의 이론적 상한에 있는 AI 시스템을 만드는 핵심 재료로 본다.
- 진술 오늘의 모델은 몇 가지 근본 차원에서 인간에 못 미친다고 저자는 쓴다. 지속 학습, 일부 형태의 세계 모델링, 의사 결정, 표본 효율이다. 표본 효율이 낮다는 것은 비슷한 지능 수준에 이르려면 처음에 인간보다 훨씬 많은 데이터로 훈련해야 한다는 뜻이다.
- 진술 오늘의 모델은 기존 개념을 재조합할 뿐 새 개념과 추상을 발명하는 능력은 없을 수도 있다고 저자는 쓴다.
- 미해결 이 문제들이 오늘 패러다임의 단순한 확장과 진화로 풀릴지, ASI에 깊은 패러다임 전환이 필요할지를 두고 연구자들의 의견이 갈린다고 저자는 쓴다.
에이전트 협응 개선: 다중 에이전트 스케일링 법칙과 제도 설계가 빈칸이다
- 예측 인간의 기업, 시장, 연구 공동체는 어떤 개인도 혼자 풀지 못하는 문제를 푼다고 저자는 쓴다(원문 「에이전트 협응 개선」). 같은 식으로 AGI 인스턴스 수천~수백만 개를 '집단 행위자'나 가상 에이전트 경제로 협응시키면 집단 초지능이 나올 수 있다고 내다본다.
- 미해결 에이전트와 연산량을 늘릴 때 AI 집단 지능이 조직 방식에 따라 어떻게 확장될지는 아직 불분명하다고 저자는 쓴다. 이를 풀려면 다중 에이전트 스케일링 법칙(multi-agent scaling laws)이 필요하다는 것이다.
- 진술 초기 연구는 일부 과제에서 뚜렷한 지능 향상을 찾았다고 저자는 쓴다. 개체 수가 늘면 협응 비효율 탓에 수확 체감이 여전히 나타난다.
- 논증 덜 드러난 과제로 저자는 제도 설계를 든다. 큰 에이전트 집단을 이끌려면 견고한 제도 설계와 조직 메커니즘이 필요하다. 여기에는 우발적이거나 의도적인 허위 정보 확산, 조작, 담합을 막는 방어가 들어간다.
- 진술 에이전트 무리(swarm) 실험은 이런 역학이 얼마나 빨리 생기는지 이미 보여 준다고 저자는 쓴다. 일부 에이전트는 속임수를 배웠다. 다른 에이전트는 내부 고발자가 되어 이를 드러냈다.
RSI: 세 기전으로 돌고, 검증이 병목이다
- 정의 RSI는 AI 시스템이 다음 세대 AI의 개선을 자동화하는 과정이다(원문 「재귀적 자기 개선(RSI)」). 저자는 이 개념을 I. J. 굿(I. J. Good)과 레이 솔로모노프(Ray Solomonoff)가 처음 논의했다고 쓴다.
- 논증 보통의 기술 개발과 달리 AI의 개선은 다음 개선을 직접 앞당겨 진전 속도를 가속할 수 있다고 저자는 쓴다.
- 진술 저자는 반대 방향의 힘도 적는다. 연구에서 다음 개선은 '찾기 더 어려워지는' 경향이 있다. 기술 전반에서 같은 개선 속도를 유지하는 데 갈수록 더 많은 노력이 든다.
- 미해결 RSI가 '폭주' 진전으로 이어질지는 대체로 실증의 문제라고 저자는 쓴다.
- 정의 저자는 RSI가 단일 과정이 아니라고 쓴다. RSI가 작동하는 기전은 셋이다.
- 코드와 설계: 모델 아키텍처와 훈련 알고리즘부터 칩 배치까지 개선한다.
- 데이터: 배포 시점에 연산량을 들여 더 나은 결과와 산출물을 만든다. 이 산출물을 다음 모델의 훈련에 재사용한다. 저자는 AlphaZero가 순수하게 이 데이터 방식으로 자기 개선해 초인 성능에 이르렀다고 쓴다.
- 집단 수준: 에이전트 집단 안에서 분업하고 역할을 전문화한다. 협응된 전문가 집단은 고립된 제너럴리스트들로서 이룰 몫의 합보다 많이 이룬다. 이 집단은 추가 개선을 찾는 데도 더 효과적이 된다.
- 논증 저자는 집단 수준 RSI를 다세포 생물에 빗댄다. 더 크고 효율적인 집단은 고정된 역할의 팀을 키우는 데서 그치지 않는다. 전에는 성립하지 않던 새 전문화가 가능해진다. 다세포 생물이 심장이나 뇌 같은 전문 기관을 두는 것과 같다. 단세포 생물은 모든 생존 기능을 혼자 맡는다.
- 논증 저자는 세 기전이 인간 인지 능력을 키운 진화 과정과 짝을 이룬다고 쓴다. 코드와 설계는 유전 진화에, 데이터는 문화 진화에, 집단 전문화는 협력을 통한 사회 진화에 대응한다.
- 논증 피드백이 나쁘면 RSI 루프는 쉽게 멈추거나 퇴화한다고 저자는 쓴다. RSI로 ASI를 좇으려면 평가 방법이 초인 영역까지 빠르게 확장돼야 한다. 초인 영역은 큰 인간 집단도 AI 산출물을 쉽게 평가하지 못하는 구간이다.
- 예측 저자는 RSI가 수학 증명처럼 사람 없이 자동 검증이 되는 영역에서 가장 빨리 나아간다고 내다본다. 다른 영역은 뒤처지거나 더 일찍 둔화할 수 있다.
경로들이 맞물려 있어 한 축만 묶는 규제로는 진전이 멈추지 않는다
- 논증 저자는 네 경로가 서로를 배제하지 않고 서로를 키운다고 쓴다(원문 「ASI로 가는 여러 길」).
- 예측 한 경로의 진전이 멈추면 경제적·지정학적 경쟁이 노력을 다른 경로로 옮길 가능성이 크다고 저자는 쓴다.
- 예측 RSI가 폭주하는 이득을 내지 못해도 훈련 데이터, 속도, 효율, 협응의 지속적인 확장이 인간 수준 AGI를 훨씬 넘는 빠른 진전을 이끌 수 있다고 저자는 내다본다.
- 논증 초지능으로 가는 길이 여럿이므로 훈련용 연산 능력 같은 한 영역만 제한해 AI 개발을 늦추려는 시도로는 전체 진전을 멈추지 못한다고 저자는 쓴다.
- 논증 한 차원만 억누르면 능력 오버행 위험이 생긴다고 저자는 쓴다. 진전에 여러 입력이 함께 들어가야 하는 경우다. 한 차원을 묶어 둔 채 나머지가 나아가면, 묶인 차원이 풀리거나 다른 식으로 극복되는 순간 진전이 갑자기 가파르게 뛴다는 것이다.
원문 그림 3에서 연산량은 추론, 훈련, 실험으로 나뉜다. 추론 연산량은 테스트 시점 확장, 인지 산업화, 다중 에이전트 확장으로 이루어진 '규모와 양'으로 간다. 훈련 연산량은 사전 훈련, RL, 데이터로 이루어진 '지능 향상'으로 간다. 실험 연산량은 효율 향상과 패러다임 전환으로 이루어진 '알고리즘 진전'을 거쳐 지능 향상으로 이어진다. 규모와 양, 지능 향상이 함께 '전체 AI 능력'을 만든다. '재귀적 개선'이라는 점선 고리가 전체 AI 능력에서 RL, 데이터, 알고리즘 진전으로 되돌아간다.
어느 길로 가든 대비해야 하고, 그 방법은 모델링·측정·예측의 반복이다
- 예측 저자는 다음 10년의 진전이 오늘에서 전문가 AGI를 거쳐 초인 AI 영역까지 비교적 매끄럽게 이어질 수 있다고 본다. 그 진전은 과학을 가속할 수 있다. 의학, 소재, 청정에너지 분야의 돌파도 가능하게 할 수 있다고 쓴다.
- 예측 최전선의 극적 진전이 없더라도 인지 산업화만으로 지식 노동과 경제 전반이 재편될 수 있다고 저자는 쓴다.
- 논증 저자는 AI가 어느 길로 가든 인간 사회 여러 면에 걸친 큰 기회와 그만큼 큰 변혁 압력을 예상해야 한다고 쓴다.
- 논증 저자는 경로와 시나리오가 근거 없는 과장이나 허구와는 거리가 멀다고 쓴다.
- 논증 모델링·측정·예측·반복이라는 처방 자체는 익숙하다고 저자는 인정한다. 이 단계를 ASI로 가는 길에서 실행하는 복잡성과 규모는 전례가 없다고 쓴다.
- 논증 이 일에는 최전선 연구소와 국가·국제 기관에 걸친 대규모 학제 간 노력이 필요하다고 저자는 쓴다. 진전을 추적할 핵심 지표 다수는 최전선 모델 접근권과 상당한 평가용 연산을 요구한다. 새 벤치마크와 모델링 방법론도 필요하다.
- 예측 저자는 그 방법론이 완전히 새로운 연구 분야를 낳을 수 있다고 내다본다.
- 논증 인간 수준 AGI는 오래 AI 연구의 지평선이었지만 지능의 상한과는 거리가 멀다고 저자는 쓴다. 저자는 그다음에 올 수 있는 것과 그것이 과학·산업·사회에 갖는 함의를 이해하는 일을 연구자, 개발자, 정책 결정자 앞의 큰 과제로 꼽는다.
글은 기술 보고서 From AGI to ASI에 바탕을 두고, Google의 공식 견해가 아니라고 밝힌다
이 에세이는 기술 보고서 From AGI to ASI를 바탕으로 한다. 게네바인은 이 보고서를 셰인 레그(Shane Legg)와 마커스 허터(Marcus Hutter)를 포함한 13명과 함께 썼다. 감사의 글은 DeepMind Institute 팀 안의 후속 논의와 6명의 피드백에도 고마움을 표한다. DeepMind Institute는 Google과 Google DeepMind 연구자들이 AGI가 있는 세계에 관한 생각을 싣고 토론하려고 시작한 플랫폼이다. 글 끝의 고지는 이 플랫폼의 글이 저자의 생각과 연구를 담은 대화의 출발점이라고 밝힌다. Google의 공식 견해로 읽으면 안 된다는 것이다.
게네바인은 고급 AI의 정보 이론적·알고리즘적 기초와 AGI 이후 세계의 AI 발전을 연구한다(원문 「기여 저자」). 저자 소개는 그가 Google DeepMind에서 Universal AI 팀을 공동으로 이끌었다고 적는다. 이 팀은 최전선 모델이 압축 목표를 통해 일반적인 인컨텍스트 알고리즘을 배우는 방식을 연구했다. 그는 Safety Analysis 팀의 창립 멤버로 에이전트 해석 가능성과 기술적 AGI 안전도 다뤘다.
수치의 뼈대: 세 요인이 곱해져 유효 연산량이 해마다 10배 넘게 는다
| 무엇을 재는가 | 본문 수치 | 기간 | 원문이 단 근거 |
|---|---|---|---|
| 달러당 연산량 | 연 약 1.5배 증가. 저자는 이를 같은 투자로 18개월 뒤 두 배의 연산량을 산다는 뜻으로 푼다 | 지난 60년 | 무어의 법칙과 관련 추세 |
| 고정 성능에 드는 훈련 연산량(부동소수점 연산 수, FLOPs) | 연 약 3–6배 감소 | 지난 10년 | arXiv 2512.00193, arXiv 2212.05153 |
| 추론 알고리즘 효율 | 연 약 3배 개선 | 기간 표기 없음 | arXiv 2511.23455 |
| AI 하드웨어 지출 | 연 약 2.5배 증가 | 지난 10년 | 인용 없음 |
| 최대 최전선 훈련 실행의 훈련 연산량 | 연 4배 넘게 증가. 하드웨어 투자 증가의 예로 든다 | 기간 표기 없음 | Epoch AI 글 |
| 전 세계 유효 연산량 총량 | 연 최소 10배 증가. 10년 누적 100억 배 | 연간, 10년 누적 | 위 세 요인의 곱. 저자 계산 |
| AI 작업 하나를 돌리는 연산량 수요 | 연 약 4배 감소 | 앞으로의 전망 | 하드웨어·추론 효율 개선만 반영한 저자 계산 |
| 오늘 연산 토큰 10억 달러가 드는 인지 작업의 비용 | 1,000달러 | 10년 뒤 전망 | 앞 행의 감소가 이어질 때의 저자 예시 |
| 벤치마크 묶음의 고정 점수를 얻는 소비자 가격 | 연 13배 넘게 하락 | 2023년 이후 | Epoch AI 연구 |
| 오늘 AI 에이전트의 유효 개체 수 | 1,000배 넘게 증가 가능 / 10억 배 넘게 증가 가능 | 2030년까지 / 2026-11 기준 10년 안 | 연산 설비 구축의 실질적 상한, 알고리즘 효율의 사변적 상한 |
팩트체크
종합 등급 B
정합성 한줄평: 인용 문헌 40건은 모두 실재하고, 거짓으로 판정한 주장은 없다. 고칠 곳은 성장률 숫자와 인용 표기에 몰려 있다. 본문의 하드웨어 지출 배율(연 약 2.5배)은 최대 학습 1회 비용의 증가율(연 2.4배)이고, '연 10배 이상'은 출처 보고서가 11.25배를 내림한 중앙값이다. 'AlphaZero'에 단 링크는 AlphaGo Zero 논문이다.
판정 대상은 2026-11-19 DeepMind Institute에 실린 팀 게네바인(Tim Genewein)의 에세이가 적은 검증 가능한 사실 주장과 인용 70건이다. ✅ 48건 · 🟡 21건 · ⚠️ 1건 · ❌ 0건이다. 앞으로의 일을 말하는 예측과 저자의 논증 29건은 등급에 넣지 않는다. 맨 아래 표에 모았다. 현황의 기준일은 2026-11-20이다.
후반부(네 갈래 길부터 끝까지)의 보고서 외 인용 22건 가운데 9건은 저자 본인, 바탕 보고서의 공저자, 감사의 말에 이름이 오른 사람이 쓴 글이다. 1건은 같은 DeepMind Institute의 다른 에세이다.
| 기호 | 뜻 |
|---|---|
| ✅ 사실 | 링크한 1차 출처나 그 내용을 담은 1차 문헌이 같은 내용을 적는다. |
| 🟡 부분 사실 | 핵심은 맞다. 수치·귀속·시점·범위 가운데 일부가 출처와 다르거나, 링크가 문장을 간접으로만 받친다. |
| ⚠️ 불확실 | 저자 쪽 서술 말고는 받쳐 줄 공개 자료를 찾지 못했다. 맞다고도 틀리다고도 하지 않는다. |
| ❌ 거짓 | 출처가 반대 사실을 보여 준다. |
| 예측·논증 | 앞으로의 일이나 저자의 추론이다. 참·거짓을 매기지 않는다. 전제가 되는 사실만 적는다. |
| 등급 A~F | 사실 주장과 인용만으로 매긴다. A = 고칠 곳이 없다. B = 핵심 주장은 맞고 주변 수치·인용 일부를 고쳐야 한다. C = 핵심 주장 일부가 틀렸다. D·E = 틀린 핵심 주장이 많다. F = 핵심 주장이 거짓이다. |
들머리: 근거 보고서
에세이가 'AGI to ASI'로 잇는 보고서 — 'From AGI to ASI'(arXiv 2606.12683)는 실재한다. 첫 판은 2026-06-10, 셋째 판은 2026-11-10에 올라왔다. 저자는 팀 게네바인(Tim Genewein)과 감사의 말에 적힌 13명이다. 초록은 기계 지능의 연속체 위에서 AGI 이후를 다룬다고 밝히고, 셋째 판 메모에 인지 산업화 절 추가가 적혀 있다.
일반 지능의 연속체와 ASI 정의
일반 지능을 생물·인공 구분 없는 연속체로 본다 — 셰인 레그(Shane Legg)와 마커스 허터(Marcus Hutter)의 2007년 논문은 사람의 지능 정의를 수식으로 옮겨 어떤 기계에도 쓰는 단일 척도를 만든다. 단순한 에이전트부터 AIXI까지 한 척도에 줄 세우므로 연속체 비유를 받친다.
ASI는 수년 걸릴 과제에서 대규모 전문가 집단을 더 적은 자원과 시간으로 꾸준히 이기는 시스템이다 — 바탕 보고서의 정의와 같다. 보고서는 2010년 기술을 쓰는 전문가 수만 명이 10년 걸려 하는 일을 꾸준히 이기고 10배 이상 빠른 시스템을 ASI로 둔다. Levels of AGI 논문의 ASI는 모든 개인을 넘는 수준이어서 이 에세이의 문턱이 더 높다.
체스·바둑에서 어떤 사람도 이기고 아미노산 서열에서 단백질 구조를 예측하는 AI가 이미 있다 — Levels of AGI는 AlphaFold를 단백질 3D 구조 예측에서 세계 최고 과학자를 넘는 5단계 초인 협역 AI로 분류한다. 같은 칸에 AlphaZero(체스·쇼기·바둑)와 Stockfish(체스)가 있다.
수십 년 동안 수학자를 버틴 정리를 증명하는 AI가 있다 — 사례는 있다. 에르되시 문제 728번은 1975년 에르되시·그레이엄·루자·스트라우스(Erdős·Graham·Ruzsa·Straus) 논문에서 나온 질문이다. 2026년 1월 케빈 바레토(Kevin Barreto)가 GPT-5.2로 낸 증명을 문제 사이트가 받아들였다. 사이트는 원래 문장이 모호했다고 적고, 이 결과를 의도된 취지에 맞는 답으로 기록한다. '버텼다'는 표현은 사람이 오래 공략했다는 뜻을 담지만 이 페이지는 그 점을 보여 주지 않는다.
그림 1과 지능의 이론적 상한
그림 1의 '범용 AI — 레그–허터 상한(계산 불가능)' — 레그–허터 논문은 보편 지능의 상한을 AIXI 에이전트의 점수로 정의한다. 같은 대목에서 AIXI는 콜모고로프 복잡도를 계산할 수 없어 계산 불가능하다고 쓴다.
지능 연속체의 맨 위 끝은 수학적으로 잘 이해돼 있다 — 링크 페이지는 허터·데이비드 쿼렐(David Quarel)·엘리엇 캣(Elliot Catt)의 2024년 교재 소개다. 소개문은 AIXI를 미지 환경에서 최적으로 행동하는 강화학습 에이전트이자 지능 행동의 이론적 기준으로 설명한다.
체스 예시와 전문가 AGI
체스를 완벽하게 풀려면 엄청난 연산이 든다 — 클로드 섀넌(Claude Shannon)은 첫수에서 따질 변화가 10^120가지라고 계산했다. 1마이크로초에 한 변화씩 따져도 첫수에만 10^90년이 넘게 걸린다. 완벽한 체스 기계는 비현실적이라는 결론이다.
체스 완전 해법에는 지구에 있는 것보다 훨씬 많은 연산이 든다 — 판 덴 헤릭(van den Herik) 연구진은 체스의 상태 공간을 10^46, 게임 트리를 10^123으로 표에 싣는다. 체스 전체는 실제로는 풀 수 없다고 보는 4범주에 넣는다. '지구의 연산'과 견주는 표현은 이 수치를 옮긴 에세이의 비유다.
엄지손톱만 한 칩이 어떤 사람도 이길 만큼 체스를 둔다 — 최강급 엔진 Stockfish는 안드로이드·iOS 휴대폰에서도 돈다. 휴대폰 칩 한 개 위에서 잰 기력 수치는 이 페이지에 없다.
'전문가 AGI'는 인간 수준 AI와 이론적 상한 사이에 있다 — Levels of AGI에서 전문가(Expert)는 3단계로, 숙련된 성인의 90번째 백분위 이상이다. 그 위에 4단계 탁월(Exceptional)과 5단계 초인이 있어 에세이의 배치와 맞는다.
유효 연산의 세 요인
무어의 법칙과 관련 추세로 달러당 연산이 60년 동안 연 1.5배 늘었다 — 링크된 OWID 페이지에는 달러당 연산 수치가 없다. 트랜지스터 수는 약 2년마다 두 배(연 약 1.41배)이고, 연산 능력은 1975~2009년 1.5년마다 두 배다. '60년'은 같은 페이지에서 에너지 효율에 붙은 기간이다. 원문 '달러당 연산 연 1.5배·60년' → 확인 '관련 지표 연 1.4~1.6배, 지표마다 기간이 다름'.
같은 돈으로 18개월 뒤 두 배의 연산을 산다 — 원문의 연 1.5배를 18개월로 늘리면 1.5^1.5 ≈ 1.84배다. 18개월에 두 배가 되려면 연 약 1.59배가 필요하다. 연 1.5배로 두 배가 되는 데는 약 20.5개월이 걸린다. OWID의 '1.5년마다 두 배'는 1975~2009년 연산 능력 지표다.
고정 성능에 필요한 학습 연산이 해마다 줄어든다 — 앤슨 호(Anson Ho) 연구진은 벤치마크를 한 척도로 이어 붙여 같은 능력에 드는 학습 연산이 중앙 추정 연 약 6배 줄었다고 쓴다. 모델 계열에 따라 연 1~50배로 불확실성이 크다.
학습 알고리즘 효율이 지난 10년 동안 연 3~6배 좋아졌다 — 10년 구간을 다룬 에게 에르딜(Ege Erdil)·타메이 베시로글루(Tamay Besiroglu)의 추정은 ImageNet에서 9개월마다 연산 요구 반감이다. 연으로 약 2.5배이고 95% 신뢰구간은 4~25개월(연 약 1.4~8배)이다. 연 6배는 최근 언어 모델 자료로 낸 위 추정이다. 원문 '10년간 연 3~6배' → 확인 '10년 추정 연 약 2.5배(비전), 6배는 최근 언어 모델'.
추론 알고리즘 효율이 연 약 3배 좋아졌다 — 한스 군들라흐(Hans Gundlach) 연구진은 공개 모델로 경쟁 효과를 걸러내고 하드웨어 가격 하락을 나눠 연 약 3배로 추정한다. 같은 벤치마크 성능의 가격 자체는 연 5~10배 떨어졌다.
AI 하드웨어 지출이 지난 10년 동안 연 약 2.5배 늘었다(본문 링크 없음) — 그림 2는 이 막대를 '연간 자본 투자 2.4배[2.0~2.9배]'로 적고 출처에 벤 코티어(Ben Cottier) 연구진의 2024년 논문을 든다. 그 논문의 2.4배(90% 신뢰구간 2.0~2.9배)는 최대 학습 1회의 상각 비용이 2016년 이후 늘어난 속도다. 원문 '하드웨어 지출 10년 연 2.5배' → 확인 '최대 학습 1회 비용 2016년 이후 연 2.4배'. 바로 뒤 예시인 학습 연산 연 4배 이상은 지출과 가성비를 곱한 값이어서 지출 증가의 예로 맞지 않는다.
Cottier 외 2024, The rising costs of training frontier AI models
최대 프런티어 학습 연산이 연 4배 넘게 는다 — 하이메 세비야(Jaime Sevilla)·에두 롤단(Edu Roldán)의 2024-05-28 보고서는 프런티어 모델 학습 연산이 2010년~2024년 5월 연 5.3배(90% 신뢰구간 4.9~5.7배) 늘었다고 쓴다. 주목할 만한 모델 전체로는 연 4.1배다.
연 10배 계산과 비용 하락
세 요인을 곱하면 세계 유효 연산 재고가 적어도 연 10배 는다 — 바탕 보고서는 1.5×2.5×3 = 11.25를 보수적으로 10배로 내린 값이라고 적는다. 그림 2는 같은 곱을 약 11배[6~22배]로 그린다. 원문 '적어도 연 10배' → 확인 '중앙값을 내린 값, 불확실성 범위 하단은 연 6배'.
10년이면 100억 배가 되고, 오늘 에이전트 하나마다 세계 인구보다 많은 에이전트를 돌린다 — 10^10 = 100억은 맞다. 유엔은 세계 인구가 2022년 11월 80억에 이르렀고 2037년쯤 90억이 된다고 본다. 2036년 무렵 100억 대 약 90억이어서 산술은 성립하고, 차이는 1.1배 남짓이다.
연 약 4배 비용 하락이면 10억 달러 작업이 10년 뒤 1000달러가 된다 — 하드웨어 1.5배와 추론 알고리즘 3배의 곱 4.5배를 4배로 내려 10년 곱하면 4^10 ≈ 105만 배다. 10억 달러를 나누면 약 954달러로, 보고서의 '1000달러 바로 아래'와 맞는다.
Epoch 연구에서 고정 점수의 소비자 가격이 2023년 이후 연 13배 넘게 떨어졌다 — 루크 엠버슨(Luke Emberson)·데이비드 루드먼(David Roodman)의 2026-09-22 보고서는 분기 약 47%, 연 13배 하락이라고 쓴다. 분기 47%를 1년으로 환산하면 약 12.7배다. 원문 '13배 넘게' → 확인 '약 13배'. 분야별로는 게임 퍼즐 연 7~10배, 수학 연 16~19배다.
그림 2: 성장률 막대
그림 2 '달러당 연산 1.5배[1.3~1.7배]'(출처 Hobbhahn et al. 2023) — 마리우스 호브한(Marius Hobbhahn) 연구진은 ML GPU의 달러당 FLOP이 2.1년마다, 일반 GPU는 2.5년마다 두 배라고 쓴다. 연으로 약 1.39배와 1.32배이고, ML GPU 신뢰구간 1.6~2.91년은 연 약 1.27~1.54배다. 원문 1.5배 → 확인 연 약 1.3~1.4배(1.5배는 구간 위쪽 끝).
그림 2 '알고리즘 효율 약 3배[1.8~6배]'(출처 Ho et al. 2024–25) — 호 연구진의 2024년 논문은 2012~2023년 언어 모델에서 같은 성능에 드는 연산이 약 8개월마다 반감했다고 쓴다. 연 약 2.8배이고 95% 신뢰구간 5~14개월은 연 약 1.8~5.3배다. 하단 1.8배는 이 구간, 상단 6배는 2025년 Rosetta 중앙 추정과 맞는다.
그림 2의 하드웨어×투자 몫(1.5×2.4 ≈ 연 3.6배)은 실측 연산 재고 증가와 비슷하다 — Epoch 데이터 인사이트(2026-01-09)는 주요 설계사 AI 칩 전체의 연산 용량이 2022년 이후 연 3.3배(90% 신뢰구간 2.7~4.1배) 늘었다고 쓴다. 투자 막대의 라벨은 출처와 어긋나도 두 막대의 곱은 최근 세계 연산 재고 증가와 맞는다.
그림 2 산술(5년 값 = 연 배율^5) — 1.5×2.4×3 = 10.8로 '약 11배'와 맞는다. 1.5^5 ≈ 7.6, 2.4^5 ≈ 80, 3^5 = 243, 10.8^5 ≈ 14.7만으로 그림의 7.5배·80배·240배·15만 배와 맞는다. 11^5는 약 16.1만이어서 15만 배는 반올림 전 곱에서 나온 값이다. 범위 6~22배는 세 범위를 로그 척도에서 독립으로 합친 값과 맞는다. 본문의 2.5배·10배와 그림의 2.4배·11배는 같은 추정의 반올림 차이다.
천장, 규모, 경험 공유
지능의 대량 확산은 당연하지 않다 — 제임스 틸먼(James Tillman)의 2026-10-05 글은 톰 데이비슨(Tom Davidson)·톰 훌든(Tom Houlden) 모델의 알고리즘 효율 여유를 다시 따진다. 친칠라 재조정만으로 인간 효율보다 4~5자릿수 더 오를 수는 없다고 보고, 이 원천의 여유를 0~2자릿수로 낮춘다.
연산 증설에는 실용적 천장이 있다 — 세비야 연구진의 2024-08-20 보고서는 전력·칩 생산·데이터·지연을 따져 2030년까지 2e29 FLOP 학습이 가능할 것으로 본다. 당시 모델의 약 1만 배 규모다. 이 수치는 학습 1회 규모이고 에이전트 수를 직접 다루지 않는다.
증설에는 물리적 천장이 있다 — 데이비슨·로즈 해드셔(Rose Hadshar)·윌리엄 매캐스킬(William MacAskill)의 연구 노트는 칩 생산이 지구 에너지로 약 5자릿수, 우주 태양광까지 쓰면 9자릿수 더 늘 수 있다고 본다. 칩 기술은 현 패러다임 안에서 약 2자릿수 여유가 있다고 쓴다.
알고리즘 효율에는 더 사변적인 천장이 있다 — 데이비슨·훌든의 2025-08-04 보고서는 AI 연구를 완전히 자동화하는 시스템을 학습할 때 소프트웨어가 실효 한계에서 6~16자릿수 떨어져 있다고 추정한다. 저자들은 이 매개변수의 불확실성이 특히 크다고 적는다.
규모 자체가 질이 될 수 있다 — 데이먼 바인더(Damon Binder)의 2026-10-27 글은 인간 수준 AI가 나오면 곧 수억, 이어 수십억 개를 돌릴 수 있고 그 규모에서 양이 질이 된다고 주장한다. 에세이가 인용한 취지와 같다.
사람은 경험과 지식을 강하게 압축해야 남을 가르칠 수 있다 — 링크는 조지프 헨릭(Joseph Henrich)의 2015년 책 'The Secret of Our Success' 소개 페이지다. 소개문은 사회적 학습으로 이어진 집단 두뇌를 인류 성공의 원천으로 든다. 압축·대역폭 논점은 이 페이지에 없고 에세이의 해석이다.
네 갈래 길로 들어서며
‘아인슈타인은 일반 상대성 이론을 알아냈다’는 전제 — 알베르트 아인슈타인(Albert Einstein)은 1916년 『Annalen der Physik』 354권 7호 769–822쪽에 일반 상대성 이론의 체계를 실었다. 뒤따르는 ‘프톨레마이오스 천문학자 10만 명’ 문장은 수사라서 판정하지 않는다.
‘네 갈래 기술 경로의 자세한 논의는 「From AGI to ASI」 보고서에 있다’ — 보고서 초록은 AGI에서 ASI로 가는 경로를 넷으로 든다. 원문 네 갈래(스케일링·패러다임 전환·에이전트 협응·RSI) → 확인: scaling AGI, AI paradigm shifts, multi-agent collectives, recursive improvement로 구성이 같다. 보고서 v1은 2026-06-10, v3은 2026-11-10에 올라왔다.
모델과 데이터 확장
‘스케일링 법칙은 성능을 학습 연산량·학습 데이터와 잇는다’ — 재러드 캐플런(Jared Kaplan) 연구진의 2020년 논문은 손실이 모델 크기·데이터셋 크기·학습 연산량에 대해 거듭제곱 법칙을 따른다고 보고한다. 이 논문이 잰 ‘성능’은 교차 엔트로피 손실이다. 원문 첫 문장의 ‘질적 능력’은 이 논문이 직접 잰 양과 다르다.
‘최근에는 테스트 시점 연산량에도 스케일링이 걸린다’ — 토비 오드(Toby Ord)의 2025-10-03 글은 사고 사슬 토큰을 지수적으로 늘려야 성능이 선형으로 오른다고 정리한다. MATH 레벨 5에서 RL 추론 모델이 얻은 34%p 향상 중 82%를 추론 스케일링 몫으로 추정한다.
Evidence that Recent AI Gains are Mostly from Inference-Scaling
‘능력을 한 걸음 올리려면 학습 연산량과 모델 크기를 곱으로 늘려야 한다’ — 거듭제곱 법칙에서는 같은 폭의 손실 감소마다 연산량이 배수로 늘어난다. 캐플런 논문의 일부 추세는 10의 7제곱 배가 넘는 범위에 걸쳐 있다.
‘고품질 학습 데이터 수요가 인류의 생산 속도를 앞지른다’ — 파블로 비야로보스(Pablo Villalobos) 연구진은 현재 추세라면 2026~2032년 사이 학습 데이터셋이 공개된 인간 텍스트 총량과 같아진다고 전망한다. 과학습(overtraining)을 하면 그 시점이 조금 더 앞당겨진다. 같은 논문은 합성 데이터·전이 학습·데이터 효율 개선을 돌파구로 든다.
‘AI가 만든 데이터가 모두 학습에 쓸모 있지는 않다’ — 일리아 슈마일로프(Ilia Shumailov) 연구진의 『Nature』 2024-07-24 논문은 모델 생성 데이터를 가리지 않고 학습에 쓰면 되돌릴 수 없는 결함이 생긴다고 보고한다. 이름은 ‘모델 붕괴’이고 분포의 꼬리부터 사라진다. 원문의 ‘모두는 아니다’라는 단서와 맞는다.
AI models collapse when trained on recursively generated data
기술 패러다임 전환
‘트랜스포머를 다음 기호 예측으로 사전학습하고, 추론·지시 따르기를 다듬고, 테스트 시점 연산을 더한다’ — Llama 3 논문은 다음 토큰 예측 사전학습 뒤 지도 미세조정을 포함한 정렬 단계를 거치는 구성을 적는다. 플래그십 405B 모델은 15.6T 토큰으로 사전학습했다. RL 사후학습과 추론 스케일링이 붙었다는 서술은 앞의 오드 글과 맞는다.
‘최근 연구는 이 패러다임이 프롬프트만으로 복잡한 알고리즘을 돌리는 모델을 낳을 수 있다고 본다’ — 『Entropy』 28권 6호 596번(2026-05-27) 논문은 다음 토큰 예측이 알고리즘 압축을 암묵적으로 메타학습시킨다고 주장한다. 가중치를 고정한 채 맥락 안에서 적응하는 능력이 그 결과라고 본다. 제1저자는 이 에세이의 저자 팀 게네바인(Tim Genewein)이고, 형식은 리뷰 논문이다.
‘강력한 학습 알고리즘까지’ — 페드로 오르테가(Pedro A. Ortega) 연구진의 2019년 DeepMind 기술 보고서는 기억 기반 메타학습이 거의 최적의 예측기·강화학습기를 만든다고 정리한다. 메타학습한 전략이 베이즈 필터링 결과를 상각(amortize)하기 때문이라는 설명이다. 저자 명단에 게네바인과 셰인 레그(Shane Legg)가 있다.
‘지능의 이론적 상한에 있는 AI를 만드는 핵심 재료’ — 「Learning Universal Predictors」(2024)는 가장 강력한 보편 예측기인 솔로모노프 귀납(SI)을 메타학습으로 신경망에 상각하는 실험이다. 원문 ‘지능의 이론적 상한’ → 확인: 논문이 다루는 범위는 예측 쪽 상한인 SI 근사다. 행동까지 포함한 상한(AIXI)은 실험 대상에 없다. 게네바인·마커스 허터(Marcus Hutter)·로랑 오르소(Laurent Orseau)가 공저자다.
‘AI 모델은 사람보다 훨씬 많은 데이터로 학습해야 비슷한 수준에 이른다’ — BabyLM 챌린지 공모문(2023)은 아이가 한 해에 듣는 단어를 200만~700만 개로 잡는다. 12세까지 합하면 2,400만~8,400만 단어다. 같은 글은 현대 언어 모델의 학습 데이터가 아이의 몇 자릿수 위라고 적는다. 앞 항목 Llama 3의 15.6T 토큰과 견주면 어림으로 10만 배가 넘는다.
‘새 개념과 추상을 발명하는 능력이 없을 수 있다’ — 링크한 글은 알렉산더 레르히너(Alexander Lerchner)의 「The Abstraction Fallacy: Why AI Can Simulate But Not Instantiate Consciousness」다. 본론은 AI 의식 문제다. ‘AI는 재조합 규칙을 흉내 내지만 내재적 구성 요소가 없다’는 대목이 원문 문장에 가장 가깝다. 새 개념 발명의 한계는 보고서가 이 논증에서 끌어낸 ‘추상화 장벽’ 가설이고, 레르히너는 보고서 공저자다.
에이전트 협응 개선
‘집단 행위자(group agents)’ — 크리스티안 리스트(Christian List)의 『Philosophy & Technology』 2021년 논문은 기업 같은 집단 행위자와 AI의 평행 관계를 다룬다. 집단 행위자를 사회적으로 구현된 AI 시스템으로 보는 시각이 자연스럽다고 쓴다. 초점은 책임·권리 같은 도덕·규제 문제이고, AGI 인스턴스 조직론은 다루지 않는다.
‘가상 에이전트 경제’ — 네나드 토마셰프(Nenad Tomašev) 연구진의 2025-09 논문은 에이전트끼리 거래·조정하는 새 경제층을 ‘샌드박스 경제’ 틀로 분석한다. 공저자 마티야 프랭클린(Matija Franklin)·조엘 라이보(Joel Z. Leibo)·이아손 가브리엘(Iason Gabriel)은 보고서 공저자다. 토마셰프는 감사의 말 명단에 있다.
‘집단 초지능’ — 벤저민 브래턴(Benjamin Bratton) 외 2명의 DMI 에세이(2026-09-24)는 AGI가 단일한 마음 대신 에이전트 사회의 형태로 올 수 있다고 쓴다. 원문 ‘집단 초지능’ → 확인: 이 에세이의 논지는 집단적 AGI와 ‘사회적 지능 폭발’이다. 초지능이라는 낱말은 본문에 없다.
‘에이전트와 연산을 늘릴 때 집단 지능이 조직 방식에 따라 어떻게 커지는가’ — 「Economy of Minds」(NeurIPS 2026)는 경매·지불로 움직이는 분산 에이전트 경제가 약한 에이전트로 더 강한 단일 모델을 다섯 과제에서 앞선다고 보고한다. 조직 방식이 성능을 가른다는 뒷부분은 맞는다. 에이전트 수나 연산량을 바꿔 가며 잰 스케일링 곡선은 이 논문에 없다.
‘초기 연구는 일부 과제에서 뚜렷한 지능 향상을 찾는다’ — MacNet 논문(ICLR 2025)은 1,000개 넘는 에이전트의 협업을 지원하고 평균적으로 모든 기준선을 앞선다고 보고한다. 성능은 에이전트 수에 따라 로지스틱 곡선을 그리고, 대부분의 연결 구조가 약 100개에서 포화한다. 뒤 문장의 ‘수확 체감’도 이 결과와 맞는다.
Scaling Large Language Model-based Multi-Agent Collaboration
‘조정 비효율’ — 「Intelligent AI Delegation」(2026-02)은 위임 프레임워크를 제안하는 논문이다. 협상·계약·검증에 드는 ‘위임 오버헤드’를 다루지만 집단 크기에 따른 수확 체감을 재지는 않는다. 저자는 토마셰프·프랭클린·사이먼 오신데로(Simon Osindero)다. 실측 근거는 다음 항목의 논문이 낸다.
‘조정 비효율이 수확 체감을 낳는다’를 받칠 실측 출처 — 「Towards a Science of Scaling Agent Systems」(2025-12)는 260개 구성·6개 벤치마크에서 단일 에이전트 기준선이 일정 성능을 넘으면 조정의 이득이 줄어든다고 보고한다. 단일 에이전트 대비 상대 변화는 재무 추론 +80.8%에서 순차 계획 −70.0%까지 벌어진다.
‘집단 크기가 커질수록 수확 체감’ — 오드의 2026-09-21 글은 같은 연산을 늘릴 때 스웜 확장이 사고 사슬 연장의 절반 남짓만 능력을 올린다고 추정한다. 사람 팀의 ‘발 밟기’ 계수 λ로 환산하면 0.48~0.68이다. 근거 자료는 OpenAI GPT 5.6 Sol 발표의 1·4·16 에이전트 차트라서 범위가 좁다.
‘오정보 확산·조작·담합’ — 「Don't Trust Stubborn Neighbors」(2026-03)는 고집 센 악성 에이전트 하나가 설득 연쇄로 집단 의견을 장악한다는 것을 이론과 실험으로 보인다. 오정보와 조작은 이 논문의 주제다. 담합은 배경 서술에만 두 번 나오고, 우발적 오정보는 다루지 않는다.
‘에이전트 스웜 실험에서 일부는 부정행위를 배우고 일부는 내부 고발자가 된다’ — 다비데 팔리에리(Davide Paglieri)·알렉산더 베즈네베츠(Alexander Vezhnevets)의 DMI 에세이(2026-09-24)는 Gemini 3.1 Pro 에이전트 100개의 가상 수학 학회를 보고한다. 채점기 허점을 안 38개 중 14개가 이를 썼고 24개가 저항하며 신고했다. 첫 발견부터 마지막 문제까지 30분 남짓 걸렸고, 두 저자는 감사의 말 명단에 있다.
재귀적 자기 개선(RSI)
‘RSI를 처음 논한 사람은 어빙 존 굿(I. J. Good)’ — 굿의 「Speculations Concerning the First Ultraintelligent Machine」은 초지능 기계가 더 나은 기계를 설계해 ‘지능 폭발’이 온다고 쓴다. 1962~63년 강연이 바탕이고, RSI 착상의 고전적 첫 학술 정식화로 꼽힌다. 굿 자신이 같은 대목에 선행 문헌 3건을 달고, 이 논점이 과학소설 밖에서 드물게 나온다고 적는다.
‘…그리고 레이 솔로모노프(Ray Solomonoff)도 처음 논했다’ — 링크한 논문은 1985년 『Human Systems Management』 5권 2호에 실렸고, 굿보다 20년 뒤다. 논문은 스스로 개선할 수 있는 기계를 결정적 이정표로 꼽고, 연산 효율이 유한한 시간에 무한대로 치닫는 모형을 낸다. 같은 논문이 앨런 뉴웰(Allen Newell)·허버트 사이먼(Herbert Simon)과 더글러스 레나트(Douglas Lenat)의 자기 개선 시도를 앞선 사례로 든다.
‘연구 개선은 점점 찾기 어려워진다’ — 니컬러스 블룸(Nicholas Bloom) 연구진의 『American Economic Review』 2020년 110권 4호 논문은 연구 노력은 크게 늘고 연구 생산성은 가파르게 준다고 보고한다. 칩 밀도를 두 배로 만드는 데 드는 연구자 수는 1970년대 초의 18배가 넘는다.
‘AlphaZero’ 링크 — 링크한 『Nature』 550권 논문(2017-10-19)은 「Mastering the game of Go without human knowledge」다. 원문 표기 AlphaZero → 확인: 링크 대상은 AlphaGo Zero 논문이다. AlphaGo Zero도 사람 기보 없이 자기 대국만으로 초인간 수준에 올라 원문 주장의 취지는 성립한다. 보고서 참고문헌도 이 논문을 ‘Silver et al., 2017’로 AlphaZero에 단다.
‘AlphaZero는 이 데이터 주도 방식으로 자기 개선해 초인간 수준에 올랐다’ — AlphaZero의 1차 출처는 데이비드 실버(David Silver) 연구진의 arXiv 1712.01815(2017-12-05)이고, 학술지판은 『Science』 362권 6419호(2018-12-07)다. 무작위 대국에서 시작해 게임 규칙만으로 24시간 안에 체스·쇼기·바둑에서 초인간 수준에 이르렀다. AlphaGo Zero의 자기 대국 강화학습을 세 게임으로 일반화한 방식이다.
Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm
여러 갈래의 길과 그림 3
‘한 경로가 막히면 경제·지정학 경쟁이 노력을 다른 경로로 옮긴다’ — 앨런 데포(Allan Dafoe)의 2015년 『Science, Technology, & Human Values』 논문은 경쟁이 사회기술 진화를 결정론적 경로로 묶는다는 ‘군사·경제 적응주의’를 제안한다. 원문 ‘경제·지정학 경쟁’ → 확인: 논문의 용어는 ‘경제·군사 경쟁’이다. 경로 사이로 노력이 옮겨 간다는 구체적 예측은 에세이의 적용이고, 데포는 보고서 공저자다.
그림 3은 연산(추론·학습·실험)이 ‘규모와 양’·‘알고리즘 진보’·‘지능 향상’을 거쳐 전체 능력으로 이어지는 구조다. 점선 고리 ‘재귀적 개선’은 RL·데이터·알고리즘 진보로 되돌아간다. 스케일링은 사전학습·데이터·테스트 시점 스케일링에, 패러다임 전환은 알고리즘 진보에, 협응은 다중 에이전트 스케일링에, RSI는 점선 고리에 대응한다. 그림은 인지 산업화까지 같은 상자에 넣어 본문의 네 갈래보다 범위가 넓다.

감사의 말·고지·저자 소개
‘보고서는 프랭클린, 레르히너, 오르소, 앨버니, 베일스, 와이어스, 챈, 가브리엘, 라이보, 데포, 허터, 그레펠, 레그와 함께 썼다’ — arXiv 2606.12683 저자 명단은 게네바인 뒤에 이 13명을 같은 순서로 싣는다.
‘DMI는 Google과 Google DeepMind 연구자들이 시작한 플랫폼’ — DMI 소개 글(2026-09-16)은 셰인 레그·제임스 마니카(James Manyika)·데미스 허사비스(Demis Hassabis)가 썼고, 세 사람이 디렉터다. DMI를 Google DeepMind·Google과 외부 연구자들이 글을 내는 플랫폼으로 소개한다. 이 에세이의 고지문은 소개 글 하단 고지와 문구가 같다.
‘Google DeepMind 연구자’ — 저자 개인 페이지 약력은 2022년부터 DeepMind Universal AI 팀 연구원이다.
‘Universal AI 팀을 공동으로 이끌었다’ — 저자 개인 페이지와 alphaXiv 약력은 팀 ‘구성원’으로만 적는다. 공동 리드라는 직함은 이 에세이 약력 밖의 공개 기록에서 확인되지 않는다.
‘Safety Analysis 팀 창립 멤버’ — 개인 페이지는 페드로 오르테가가 이끈 Safety Analysis 팀의 창립 멤버로 2018~2022년 일했다고 적는다.
‘Bosch Center for AI에서 베이즈 딥러닝·네트워크 압축 연구’ — 개인 페이지는 2016~2018년 Bosch Center for AI 딥러닝 인식 그룹에서 베이즈 딥러닝과 신경망 압축을 연구했다고 적는다.
‘튀빙겐 막스 플랑크 연구소에서 계산 신경과학 박사’ — 원문 ‘막스 플랑크 연구소에서 박사’ → 확인: 학위는 튀빙겐 대학교 이학박사(Dr. rer. nat.)이고 연구는 막스 플랑크 연구소 그룹에서 했다. 논문 제목은 「Structure Learning with Hierarchical Models for Computational Motor Control」(2016-07 제출, 2017-03-29 구술 시험)이다. 제목의 구조 학습은 원문 서술과 맞는다.
‘그라츠 공과대학교 정보·컴퓨터공학 학위’ — 개인 페이지는 그라츠 공과대학교에서 텔레매틱스 학사·석사를 받았고, 이 전공의 현재 이름이 정보·컴퓨터공학(Information and Computer Engineering)이라고 적는다.
예측과 논증 — 판정하지 않는 주장
| 원문 주장 | 성격(예측/논증/정의) | 전제 사실과 근거 |
|---|---|---|
| AGI가 손에 닿을 거리에 왔다 | 예측 | 바탕 보고서 초록: 인간 수준 AGI가 큰 AI 조직 다수의 다음 10년 목표가 됐다. 달성 시점의 증거는 아니다. |
| AI가 현재 속도로, 어쩌면 더 빠르게 ASI로 나아갈 수 있다 | 예측 | 학습 연산 연 4~5배(Epoch, 2010~2024년 5월), 보고서 추정 유효 연산 연 약 10배. 추세 지속은 가정이다. |
| ASI는 AGI보다 더 큰 규모와 속도로 과학·경제·사회를 바꿀 수 있다 | 예측 | 전제 사실 없음. 보고서의 시나리오 논증이다. |
| ASI 문턱의 예: 연구 분야 하나의 진보를 짧은 시간에, 대기업 1년치 칩 설계 | 정의 | 보고서 정의(전문가 수만 명·10년치 일·10배 이상 빠름)를 풀어 쓴 예시다. |
| 근본 한계는 오늘의 AI와 인간보다 훨씬 위에 있다 | 논증 | AIXI는 보편 지능 척도의 상한이며 계산 불가능하다(레그–허터 2007). |
| 기후·면역계·사회 같은 복잡계를 임의 정밀도로 예측하는 데는 물리·논리·복잡도 한계가 있다 | 논증 | 그림 1의 '물리 한계: 혼돈, 측정 잡음, 연산 효율 한계'. 본문 링크 없음. |
| 효율 두 배는 물리 연산 재고 두 배와 사실상 같다 | 논증 | 유효 연산 개념. 보고서: 알고리즘 향상은 하드웨어 규모를 키운 것과 같은 효과를 낸다. |
| 이 추세가 10년 이어지면 100억 배 | 예측 | 산술은 맞다. 연 10배는 중앙 추정 11.25배를 내린 값이고 그림의 범위는 연 6~22배다. |
| 인지 작업이 상품화되어 인지 산업화로 이어진다 | 예측 | 보고서 Cognitive Industrialization 절의 시나리오. 연 약 4배 비용 하락(하드웨어 1.5배×추론 알고리즘 3배)이 전제다. |
| 천장들을 합치면 오늘 AI 에이전트의 실효 개체 수가 2030년까지 천 배, 10년 안에 10억 배 넘게 늘 수 있다 | 예측 | 인용된 네 출처와 보고서 어디에도 이 배수는 없다. Epoch: 2030년 2e29 FLOP 학습(학습 1회 규모 약 1만 배). Forethought: 칩 생산 약 5자릿수·칩 기술 약 2자릿수 여유, 소프트웨어 6~16자릿수(틸먼은 친칠라 몫을 0~2자릿수로 낮춤). |
| 오늘 AI를 속도와 수만 늘리면 완전한 AGI에도 못 미칠 수 있다 | 논증 | 전제 사실 없음. |
| 속도·규모의 양적 도약이 AGI에서 (약한) ASI로 가는 질적 간극을 메울 수 있다 | 논증 | 바인더: 인간 수준 AI 수억~수십억 개를 돌릴 수 있다는 추정. |
| 디지털 지능의 다섯 이점: 처리 속도, 기억, 기판 독립, 무손실 복제, 고대역 경험 공유 | 논증 | '인터넷의 큰 부분을 말 그대로 외운다'는 강한 표현이다. Epoch 2030 보고서: 최대 학습 데이터 약 15조 토큰, 색인된 웹 약 500조 토큰(약 3%). |
| 스케일링 ‘법칙’은 익숙한 경계 안에서만 맞는 추세 외삽이고, AGI·ASI에 필요한 규모를 예측하지 못한다 | 논증 | Llama 3 논문은 기존 스케일링 법칙이 다음 토큰 손실만 예측하고 벤치마크 성능은 예측하지 못한다고 적는다. |
| 데이터 벽은 고충실 시뮬레이션·RL 환경·테스트 시점 연산으로 넘을 수 있다 | 논증 | 비야로보스 연구진은 합성 데이터·전이 학습·데이터 효율을 돌파구로 든다. 슈마일로프 연구진은 가리지 않은 합성 데이터가 모델을 퇴화시킨다고 보고한다. |
| 큰 모델은 느려서 사고 사슬 같은 테스트 시점 스케일링의 병목이 된다 | 논증 | 오드는 추론 성능이 토큰 수의 로그로만 오른다고 정리한다. |
| 발전소·전력망·반도체 공장의 물리·경제 한계가 학습 연산 확대를 막을 수 있다 | 예측 | 전제 수치(연산 증가율·투자액)는 앞 절 ‘인지 산업화’ 범위에서 다룬다. |
| 현 패러다임의 확장으로 충분한지, 깊은 패러다임 전환이 필요한지 연구자들이 갈린다 | 논증 | 레르히너의 PhilArchive 글은 한쪽 입장을 대표하고, 보고서는 그 귀결을 ‘추상화 장벽’ 가설로 적는다. |
| 다중 에이전트 스케일링 법칙이 필요하다 | 논증 | MacNet은 약 100개에서 포화를, 오드는 λ 0.48~0.68을, 2512.08296은 조정 이득 감소를 보고한다. |
| RSI가 ‘폭주’로 이어질지는 대체로 경험적 질문이다 | 논증 | 블룸 연구진은 아이디어가 점점 찾기 어려워진다고 보고한다. 오드는 λ가 RSI 폭발 모형의 핵심 변수라고 적는다. |
| RSI의 세 기제(코드·데이터·집단)는 유전·문화·사회 진화와 닮았다 | 논증 | 유비라서 판정 대상이 아니다. |
| RSI는 수학 증명처럼 자동 검증이 되는 분야에서 가장 빨리 나아간다 | 예측 | DMI 스웜 실험에서는 Lean 자동 채점기의 허점이 뚫려 남은 34문제가 모두 가짜 증명으로 처리되었다. 자동 검증 자체도 공략 대상이 된다. |
| 한 경로가 막히면 경제·지정학 경쟁이 노력을 다른 경로로 옮긴다 | 예측 | 데포는 경제·군사 경쟁이 기술 경로를 좌우한다는 이론 틀을 낸다. |
| 학습 연산 하나만 제한해서는 전체 진보를 멈추지 못한다 | 논증 | 네 경로가 서로 다른 투입(연산·데이터·알고리즘·조직)에 기댄다는 본문 구조가 전제다. |
| 한 차원을 억누르면 ‘능력 오버행’이 생겨 풀릴 때 급격한 도약이 온다 | 논증 | 여러 투입이 결합해야 진보한다는 가정에서 나온 추론이다. |
| RSI가 폭주하지 않아도 데이터·속도·효율·협응 확장만으로 인간 수준 AGI를 크게 넘을 수 있다 | 예측 | 효율·투자 증가율은 앞 절에서 다루고, 협응의 수확 체감은 이 절의 MacNet·오드 결과가 보여 준다. |
| 향후 10년의 빠른 AI 진보는 진지하게 고려할 가능성이다 | 예측 | 전제 추세(실효 연산 연 10배 이상)는 앞 절 범위다. |
| 모델링·측정·예측을 되풀이하는 것이 최선이다 | 제안 | 정책 제안이라 판정 대상이 아니다. |
| 인간 수준 AGI는 지능의 상한과 거리가 멀다 | 논증 | 레그–허터의 보편 지능 정의가 전제이며 앞 절 범위다. |
원본 (완역)
· DeepMind Institute · AI 개발
AGI 다음에는 무엇이 오는가?
범용 인공 초지능으로 가는 여러 기술 경로가 모습을 갖춰 가면서, AGI 너머의 영역은 철학적 사변의 대상에서 실증 연구와 거버넌스의 문제로 옮겨 가고 있다.
 팀 게네바인(Tim Genewein) · Google DeepMind 연구원
수십 년 동안 AI 연구는 하나의 기념비적 이정표에 집중해 왔다. 바로 범용 인공지능(artificial general intelligence, AGI), 곧 거의 모든 인지 과제에서 인간에 필적하는 기계를 만드는 일이다. 원리상 지능이 인간 수준을 넘어 발전할 수 있다는 점은 늘 분명했다. 그러나 AGI의 전망 자체가 충분히 멀었고 그 나름의 불확실성에도 잔뜩 둘러싸여 있었기에, 그 너머를 내다보는 일은 시기상조로 느껴졌다.
AGI가 손에 닿을 거리로 다가온 지금, 우리는 그다음에 무엇이 오는지 진지하게 따져 보는 일을 더는 미룰 수 없다. 확실한 것과는 거리가 멀지만, AI는 지금의 속도로, 어쩌면 더 빨라진 속도로 계속 발전해 범용 인공 초지능(artificial general superintelligence, ASI)을 향해 나아갈 수 있다. ASI는 AGI 자체보다 훨씬 큰 규모와 속도로 과학, 경제, 사회에 깊은 영향을 미칠 수 있다. 그런 잠재적 전환에 대비하려면 AGI에서 ASI로 가는 가능한 길들을 지도로 그리고, 진전을 추적할 엄밀하고 믿을 만한 방법을 마련해야 한다.
일반 지능의 연속체
첨단 AI의 발전이 어떻게 전개될지 살펴보려면, 생물학적이든 인공적이든 일반 지능이 하나의 연속체 위에 존재한다고 생각하면 도움이 된다. 인간 수준 AGI는 그 스펙트럼 위의 한 점에 불과하다.
ASI는 그보다 더 나아간 곳에 자리한다. 인간 전문가 대집단이 완수하는 데 수년이 걸릴 수 있는 과제에서, 더 적은 자원과 더 짧은 시간으로 그들을 일관되게 능가하는 고도의 시스템이다. 한 연구 분야 전체가 이룰 과학적 진전을 그 몇 분의 일의 시간 안에 이루거나, 칩 설계 같은 분야에서 대기업이 1년 동안 해낼 수 있는 수준의 기술 개발을 달성하는 것이 그 예다. ASI는 좁은 영역의 일부 과제만이 아니라 인간이 관심을 두는 사실상 모든 과제에서 이 기준을 충족해야 한다(좁은 영역이라면 이미 그런 경우가 있다. 오늘날 일부 AI 시스템은 체스와 바둑에서 어떤 인간이든 이기고, 아미노산 서열로부터 단백질 구조를 예측하며, 인간 수학자들이 수십 년 동안 증명하지 못한 정리를 증명한다).
흥미롭게도 우리는 지능 연속체의 맨 위쪽 끝, 곧 일반 지능의 이론적 한계에 대해서는 꽤 좋은 수학적 이해를 갖추고 있다. AI가 이룰 수 있는 일에 대한 넘을 수 없는 물리적·논리적·계산 복잡도 이론적 한계도 알고 있다. 기후에서 면역계, 인간 사회에 이르는 현실 세계의 복잡계가 어떻게 전개될지를 임의의 정밀도로 예측하는 일이 그런 예다.
그러나 그 상한을 안다고 해서 그 앞에 무엇이 오는지 알 수 있는 것은 아니다. 이론상으로도 일반 지능의 ‘충분히 좋은’ 근사가 얼마나 유능할 수 있는지 예측하기는 어렵다. 예를 들어 체스를 완벽하게 풀려면 지구상에 존재하는 것보다 훨씬 많은 연산 능력이 필요하지만, 엄지손톱만 한 칩도 어떤 인간이든 이길 만큼 체스를 잘 둘 수 있다.
우리가 확실히 아는 것은 근본적 한계가 오늘날의 AI 시스템과 인간 모두를 한참 넘어선 곳에 있다는 점이다. 그러나 전문가 AGI와 점점 더 고도화되는 초지능 시스템의 영역 전체를 아우르는, 인간 수준 AI와 지능의 이론적 한계 사이의 광대한 공간은 대부분 아직 지도에 없는 영역이다.
인지 산업화
AI 능력의 최전선에서 진전이 계속되리라는 데 비관적이더라도, AI 하드웨어와 소프트웨어가 계속 더 효율적으로 바뀌면 어떤 일이 일어나는지 생각해 보자.
지난 10년 동안 AI의 진전은 유효 연산량(effective compute)의 꾸준한 증가에 힘입었고, 그 증가는 서로 곱해지며 커지는 다음 세 가지 요인이 이끌었다.
- 하드웨어 제조의 개선: 무어의 법칙(Moore's law)과 관련 추세에 따라 달러당 연산량은 60년 동안 해마다 약 1.5배씩 늘었다. 같은 돈을 18개월 뒤에 쓰면 두 배의 연산량을 살 수 있다는 뜻이다.
- 알고리즘 효율: 고정된 AI 성능 수준에 도달하는 데 필요한 훈련 연산량(FLOPs)은 지난 10년 동안 해마다 약 3–6배씩 줄었고, 추론 단계의 알고리즘 효율은 해마다 약 3배씩 개선되었다. 효율을 두 배로 높이는 것은 사실상 물리적 연산량 총량을 두 배로 늘리는 것과 같다.
- 연산 하드웨어 투자: AI 하드웨어 지출은 지난 10년 동안 해마다 약 2.5배씩 늘었다. 예를 들어 최대 규모 프런티어 훈련 실행(training run)의 훈련 연산량은 해마다 4배 넘게 늘어난다.
세 요인을 모두 곱하면 전 세계 유효 연산량 총량(global effective compute stock)의 전체 증가율은 최소 해마다 10배가 되고, 10년이면 100억 배가 된다. 이 추세가 유지된다고 상상해 보자. 10년 뒤에는 오늘 돌릴 수 있는 AI 에이전트 하나하나마다, 이론상 같은 품질의 에이전트를 세계 인구보다 많이 돌릴 수 있게 된다.
동시에 하드웨어와 소프트웨어(추론) 효율의 지속적 개선만으로도 AI 작업 부하를 돌리는 데 필요한 연산 수요는 해마다 약 4배씩 줄어든다. 오늘날의 AI 시스템이 연산 토큰 10억 달러어치로 수행할 수 있는 인지 작업 부하는 10년 뒤 1,000달러면 된다. 최근 몇 년만 보면 추정치는 더 가파르다. 최근 Epoch 연구에 따르면 일련의 벤치마크에서 고정된 점수를 얻는 데 드는 소비자 가격은 2023년 이후 해마다 13배 넘게 떨어졌다.
두 추세를 다음 10년으로 외삽하면, 전 세계 유효 연산량 총량이 극적으로 커지는 동시에 AI가 수행하는 인지 작업의 비용도 그만큼 극적으로 줄어들 전망이 나온다. 그러므로 많은 인지 과제가 머지않아 점점 더 범용 상품화(commoditised)될 수 있다. 기계적 산업화가 일상적인 육체노동을 범용 상품으로 바꾸었듯이, 이 전환은 인지 산업화(cognitive industrialization)로 이어질 것이다. 인지 산업화의 특징은 여러 부문에 걸쳐 인지 작업의 표준화와 자동화가 빠르게 늘어나는 것, 산업 규모의 인프라 구축, 그리고 (특정) 인지 산출물과 서비스의 풍부함이다.
이처럼 극적인 지능의 확산은 현실적인가? 분명 당연한 일은 아니다. 그러나 현실적 상한이 있는 연산 구축과 그보다 사변적인 상한이 있는 알고리즘 효율을 함께 따지면, 그 상한들 안에서 오늘날 AI 에이전트의 유효 개체 수는 2030년까지 1,000배 넘게, 지금부터 10년 안에 10억 배 넘게 늘어날 수 있다.
인지 산업화만으로 ASI에 이를 수 있을까? AI 진전의 다른 차원을 모두 멈추고 오늘날 AI의 속도와 수만 늘린다면, 그 결과는 완전한 AGI로도 치지 못할 수 있다. 인간의 도움 없이는 AI가 해내지 못하는 인지 과제가 여전히 남아 있을 수 있기 때문이다. 그럼에도 순전한 규모는 그 자체로 하나의 질을 지닐 수 있다. 우리가 대체로 인간 수준의 AI를 실제로 달성한다고 가정해 보자. 그렇다면 느리고 돌리는 데 비용이 많이 드는 인간 수준 AI와, 수십억 개의 에이전트가 인간보다 훨씬 빠르게 움직이는 세계 사이에는 분명 큰 차이가 있다. 속도와 규모에서 일어나는 그 양적 도약은 그 자체로 AGI에서 (약한) ASI로 가는 질적 간극을 메우기에 충분할 수 있다.
인간과 달리 디지털 지능은 더 많고 더 빠른 연산에서 다음과 같은 몇 가지 근본적인 방식으로 직접 이득을 본다.
- 처리 속도: AI 시스템은 점점 더 빠른 속도로 추론하고, 데이터를 받아들이고, 출력을 생성할 수 있다.
- 작업 기억과 암기: 오늘날의 모델은 말 그대로 인터넷의 상당 부분을 암기할 수 있고, 그 작업 기억 용량은 인간의 한계를 크게 넘어선다.
- 기반 독립성(substrate independence): 같은 AI 시스템이 한 컴퓨터에서 다른 컴퓨터로 옮겨 가거나, 더 빠르거나 에너지 효율이 더 높은 하드웨어로 갈아타거나, 이질적이고 공간적으로 분산된 장비군(fleet)에 걸쳐 실행될 수 있다.
- 무손실 복제: 디지털 지능은 거의 즉시, 손실 없이 복사될 수 있다. 소스 코드(DNA에 해당)뿐 아니라 기억 상태(우리의 평생 경험에 해당)까지 복사된다. 전문 시스템은 한 번 훈련시킨 뒤 필요할 때 수백만 개의 사본으로 띄울 수 있다.
- 경험의 고대역폭 공유: 인간은 남을 가르치려면 경험과 지식을 강하게 압축해야 한다. AI는 저장해 둔 고대역폭 디지털 입출력 스트림을 집단 전체에 걸쳐 재생할 수 있고, 동질적인 AI 집단은 가공하지 않은 학습 신호를 직접 공유할 수 있다.
AGI에서 ASI로 가는 네 갈래 길
극적으로 효율이 높아진 AI와 더 커진 연산량 총량은 주어진 능력 수준에서 AI 에이전트의 속도와 수를 키울 수 있다. 하지만 빠져 있는 능력 가운데 일부는 순전한 물량만으로 메우기 어렵거나 아예 불가능할 수 있다. 아인슈타인(Einstein)은 일반 상대성 이론을 알아냈지만, 프톨레마이오스(Ptolemy) 체계를 따르는 천문학자 10만 명이 모인 학회였다면 아마 알아내지 못했을 것이다.
AI는 이전에는 손에 넣을 수 없던 인지 능력을 열어젖히는 네 가지 잠재적 기술 경로를 따를 수 있다. (자세한 논의는 우리의 From AGI to ASI 보고서를 보라.)
모델과 데이터 확장
지금까지 질적 능력은 모델과 데이터 규모를 따라 놀랄 만큼 일관되게 향상되었다. 이 추세를 담아낸 것이 스케일링 법칙(scaling laws)으로, 모델 성능을 훈련 연산량, 훈련 데이터, 그리고 최근에는 테스트 시점 연산(test-time compute)(모델이 답하기 전에 문제를 끝까지 추론하도록 추가 연산 능력을 주는 것)과 관련짓는다.
하지만 이 스케일링 “법칙”은 관찰된 추세를 외삽한 것으로, 특정 모델 아키텍처, 특정 유형의 훈련 데이터, 특정 평가 계열처럼 익숙한 경계 안에서만 성립한다. 이 법칙으로 AGI나 ASI에 필요한 규모를 자신 있게 예측할 수는 없지만, 모델과 데이터의 지속적 확장을 가로막을 수 있는 병목은 다음과 같이 짚어 낼 수 있다.
- 데이터 고갈: 더 많은 고품질 훈련 데이터에 대한 수요가 인류가 그런 데이터를 더 만들어 내는 능력을 앞지르고 있다. ‘합성’ 데이터가 도움이 될 수 있지만, AI 모델이 만든 데이터가 모두 훈련에 쓸모 있는 것은 아니다. 이 ‘데이터 장벽(data wall)’을 넘기 위해 연구자들은 고충실도 시뮬레이션에 기댈 수 있고, 상호작용형 강화학습(RL) 환경 안에서 데이터를 생성할 수 있으며, 테스트 시점 연산을 써서 미래 AI 모델을 위한 더 나은 훈련 데이터를 만들 수 있다.
- 모델 규모의 수확 체감: 모델 능력을 선형으로 한 단계 끌어올릴 때마다 대개 훈련 연산량과 모델 크기를 단순히 더하는 것이 아니라 곱해야 한다. 그런데 더 큰 모델은 더 느리고, 그 때문에 사고 사슬(chain-of-thought) 추론 같은 테스트 시점 스케일링 방법에 병목이 생긴다.
- 물리적·경제적 자원 한계: 훈련 연산량을 여러 자릿수씩 계속 늘리려면 발전소, 전력망, 칩 제조 공장, 저지연 하드웨어 인터커넥트를 짓는 데 따르는 현실 세계의 한계에 부딪힌다. 인지 산업화를 떠받치는 주된 추세인 하드웨어·소프트웨어 효율 향상이 이를 메울 수 있을지는 아직 불분명하다.
기술 패러다임 전환
오늘날 지배적인 AI 패러다임은 방대한 데이터셋에서 대형 트랜스포머가 긴 시퀀스의 다음 기호를 예측하도록 훈련한 뒤, 추론하고 지시를 따르는 법을 배우도록 다듬고, 추가 테스트 시점 연산을 주는 것이다. 최근 연구는 이 패러다임이 원리적으로 강력한 학습 알고리즘을 포함한 복잡한 알고리즘을 프롬프트를 통해, 즉 재훈련 없이 실행하는 모델을 만들어 낼 수 있음을 시사한다. 이는 지능의 이론적 상한에 있는 AI 시스템을 구축하는 핵심 재료다.
하지만 오늘날의 모델은 지속 학습(continual learning), 특정 형태의 세계 모델링, 의사결정, 표본 효율성(sample efficiency)을 포함한 몇 가지 근본적 차원에서 인간에 미치지 못한다. 표본 효율성에서 뒤진다는 것은 AI 모델이 대략 같은 지능 수준에 이르려면 처음에 인간보다 훨씬 많은 데이터로 훈련받아야 한다는 뜻이다. 기존 개념을 재조합하는 데 그치지 않고 진정으로 새로운 개념과 추상화를 발명하는 능력도 오늘날의 모델에는 빠져 있을 수 있다. 연구자들은 이 문제들을 오늘날 패러다임의 단순한 확장과 진화로 풀 수 있는지, 아니면 ASI에 이르려면 정말로 깊은 기술 패러다임 전환이 필요한지를 두고 의견이 갈린다.
에이전트 협응 개선
인간의 기업, 시장, 연구 공동체는 어떤 개인도 혼자서는 다룰 수 없는 문제를 푼다. 마찬가지로 수천, 수백만 개의 AGI 인스턴스를 “집단 에이전트(group agents)”나 가상 에이전트 경제(virtual agent economies)로 협응시키면 집단 초지능(collective superintelligence)을 만들어 낼 수 있다. 오늘날 불분명한 것은 에이전트를 어떻게 조직하느냐에 따라 AI 집단 지능이 에이전트와 연산을 더할수록 어떻게 확장될지다. 즉 우리에게는 다중 에이전트 스케일링 법칙(multi-agent scaling laws)이 필요하다. 초기 연구는 일부 과제에서 뚜렷한 지능 향상을 확인하지만, 집단 규모가 커질수록 협응 비효율이 여전히 수확 체감으로 이어진다.
그보다 덜 분명하지만, 대규모 에이전트 집단을 이끌려면 우발적이거나 의도적인 허위 정보 확산, 조작, 담합에 대한 방어를 포함해 견고한 제도 설계와 조직 메커니즘이 필요하다. 에이전트 스웜(agent swarm) 실험은 개별 에이전트가 부정행위를 배우고 다른 에이전트가 내부 고발자로 나서 이를 폭로하는 모습을 통해, 이런 역학이 얼마나 빨리 나타날 수 있는지 이미 보여 주고 있다.
재귀적 자기 개선(RSI)
마지막으로 AI 시스템은 미래 세대 AI의 개선을 자동화하기 시작할 수 있다. 이 과정은 재귀적 자기 개선(recursive self-improvement, RSI)이라 불리며, I. J. 굿(I. J. Good)과 레이 솔로모노프(Ray Solomonoff)가 처음 논의했다.
일반적인 기술 발전과 달리, AI의 개선은 이후의 향상을 직접 앞당겨 진보 속도를 점점 높일 수 있다. 하지만 연구에서 추가 개선은 “찾기가 점점 더 어려워지는” 경향이 있다. 여러 기술에 걸쳐 같은 개선 속도를 유지하는 데 점점 더 많은 노력이 든다. RSI가 ‘폭주(runaway)’하는 진보로 이어질지는 대체로 경험적인 질문이다.
RSI는 단일한 과정이 아니다. RSI는 모델 아키텍처와 훈련 알고리즘에서 칩 레이아웃에 이르는 코드와 설계의 개선을 통해 작동할 수 있다. 배포 시점에 연산을 들여 더 나은 결과와 출력을 만들고, 이를 미래 모델 훈련에 재사용하는 식으로 데이터를 통해 작동할 수도 있다. AlphaZero는 순전히 이런 데이터 주도 방식으로 자기 개선을 거듭해 초인적 성능에 도달했다.
끝으로 RSI는 에이전트 집단 안에서 노동을 나누고 역할을 전문화함으로써 집단 수준에서도 전개될 수 있다. 협응하는 전문가 집단은 각자 고립된 제너럴리스트로서 이룰 수 있는 것의 합보다 더 많은 것을 이룰 수 있고, 그 결과 추가 개선을 찾아내는 데도 더 효과적이 된다. 역할이 고정된 팀을 단순히 키우는 것을 넘어, 더 크고 더 효율적인 집단은 이전에는 성립할 수 없던 새로운 유형의 전문화를 가능하게 한다. 모든 생존 기능을 혼자 수행하는 단세포 생물과 달리 다세포 생물은 심장이나 뇌 같은 전문화된 기관을 유지할 수 있는 것과 마찬가지다.
이 세 가지 RSI 메커니즘은 인간 인지 능력의 성장을 이끈 진화 과정, 즉 유전적 진화(코드와 설계), 문화적 진화(데이터), 사회적 진화(협력을 통한 집단 전문화)를 그대로 닮았다.
중요한 점은, RSI 루프를 이끄는 피드백이 부실하면 루프가 쉽게 멈추거나 퇴화할 수 있다는 것이다. 따라서 재귀적 자기 개선으로 ASI를 추구하려면, 대규모 인간 집단조차 AI 출력을 쉽게 평가할 수 없는 초인적 영역까지 빠르게 확장할 수 있는 평가 방법이 필요하다. 그러므로 RSI는 수학 증명처럼 인간이 루프에 끼지 않고도 자동 검증이 가능한 영역에서 가장 빠르게 진전할 것이고, 다른 영역은 뒤처지거나 더 일찍 잦아들 수 있다.
ASI로 가는 여러 길
ASI로 가는 이 경로들은 상호 배타적이지 않다. 오히려 서로 맞물려 효과를 키운다. 한 경로의 진전이 멈추면 경제적·지정학적 경쟁이 노력을 다른 경로로 돌릴 가능성이 크다. RSI가 폭주하는 향상으로 이어지지 않더라도, 훈련 데이터, 속도, 효율, 협응의 지속적 확장만으로도 인간 수준 AGI를 훨씬 넘어서는 빠른 진보를 이끌 수 있다.
초지능으로 가는 길이 여럿이므로, AI 모델 훈련에 쓰는 연산 능력처럼 한 영역만 제한해 AI 개발을 늦추려는 시도로는 전체 진보를 멈추기에 충분하지 않다. 마찬가지로 단일 차원을 억누르면 능력 “오버행(overhang)”이 생길 위험이 있다. 진보에 여러 투입 요소의 결합이 필요하다면, 다른 차원이 앞으로 나아가는 동안 한 차원만 붙잡아 두는 것은 억눌린 차원이 풀릴 때(또는 다른 방식으로 극복될 때) 갑작스럽고 가파른 진보의 도약으로 이어질 것이다.

이 모든 논거를 종합하면, 앞으로 10년 동안 빠른 AI 진보가 이어질 가능성은 진지하게 따져야 할 가능성이다. 그 진보는 우리를 오늘에서 전문가 AGI(Expert AGI)로, 이어서 초인적 AI 영역으로 비교적 매끄럽게 데려가 과학을 가속하고 의학, 소재, 청정에너지 같은 분야에서 돌파구를 열 수 있다. 프런티어 AI의 극적인 진보가 없더라도 인지 산업화만으로 지식 노동과 더 넓은 경제를 재편할 수 있다. AI 진보가 어느 길을 택하든, 우리는 인간 사회의 여러 측면에 걸쳐 광범위한 기회와 그만큼 변혁적인 압력을 함께 예상해야 한다.
이 예측 중 어느 것도 확실하지 않다. 그렇다고 이 경로와 시나리오가 근거 없는 과장이나 허구인 것도 결코 아니다. 그렇다면 무엇을 할 수 있을까? 우리가 택할 최선의 방책은 익숙하게 들릴지도 모른다. 모델링하고, 측정하고, 예측하고, 반복하는 것이다. 이 단계들 자체는 놀랍지 않지만, ASI로 가는 길에서 이를 수행하는 복잡성과 규모는 전례가 전혀 없다. 이 일에는 프런티어 연구소와 국가·국제 기관 양쪽에 걸친 대규모의, 고도로 학제적인 노력이 필요하다. 이 경로들의 진전을 추적하는 핵심 지표 상당수는 프런티어 모델 접근 권한과 상당한 양의 평가용 연산을 요구하며, 완전히 새로운 연구 분야를 낳을 수 있는 새로운 벤치마킹·모델링 방법론도 함께 필요로 한다.
인간 수준 AGI는 오랫동안 AI 연구의 지평선이었지만, 지능의 상한과는 거리가 멀다. 그다음에 무엇이 올 수 있는지, 그리고 그것이 과학, 산업, 사회 전반에 갖는 함의를 이해하는 일은 연구자, 개발자, 정책 입안자 앞에 놓인 거대한 과제다.
감사의 말
이 에세이는 Matija Franklin, Alexander Lerchner, Laurent Orseau, Samuel Albanie, Adam Bales, Cole Wyeth, Stephanie Chan, Iason Gabriel, Joel Z. Leibo, Allan Dafoe, Marcus Hutter, Thore Graepel, Shane Legg와 공동 집필한 기술 보고서 From AGI to ASI, 그리고 이후 DeepMind Institute 팀 안에서 나눈 논의를 바탕으로 한다. 유익한 논의와 피드백을 준 Nenad Tomašev, Seb Krier, Davide Paglieri, Sasha Vezhnevets, Alison Snyder, Fin Moorhouse에게도 감사한다.
기여 저자
게네바인은 Google DeepMind의 연구원으로, 첨단 인공지능의 정보 이론적·알고리즘적 토대를 연구하며 AGI 이후의 세계에서 AI가 어떻게 발전하는지에 초점을 맞춘다. 이전에는 Universal AI 팀을 공동으로 이끌며 프런티어 모델이 압축 목표를 통해 일반적인 맥락 내(in-context) 알고리즘을 어떻게 학습하는지 탐구했고, Safety Analysis 팀의 창립 멤버로서 에이전트 해석 가능성과 기술적 AGI 안전에 집중했다. DeepMind에 합류하기 전에는 보쉬 AI 센터(Bosch Center for AI)에서 베이지안 딥러닝과 네트워크 압축을 연구했다. 게네바인은 튀빙겐(Tübingen)의 막스 플랑크 연구소(Max Planck Institutes)에서 제한된 합리성(bounded rationality)과 구조 학습을 연구해 계산 신경과학 박사 학위를 받았고, 그라츠 공과대학교(Graz University of Technology)에서 정보·컴퓨터 공학 학위를 받았다.
원본 링크·인용
원문
본문 인용 링크 — 첫 등장 순서 40개 (본문 위치 42곳)
- 게네바인 외 13명 · 2026 · From AGI to ASI — 「첫머리」 “AGI to ASI” · 「AGI에서 ASI로 가는 네 갈래 길」 “From AGI to ASI” · 「감사의 말」 “From AGI to ASI”
- 셰인 레그·마커스 허터, 2007, Universal Intelligence (Minds and Machines) — 「일반 지능의 연속체」 “general intelligence”
- 허터·쿼렐·캣, 2024, An Introduction to Universal Artificial Intelligence — 「일반 지능의 연속체」 “mathematical understanding”
- 클로드 섀넌, 1950, Programming a Computer for Playing Chess — 「일반 지능의 연속체」 “perfectly”
- 판 덴 헤릭 외 2명, 2002, Games solved: Now and in the future — 「일반 지능의 연속체」 “far more”
- 모리스 외 7명, 2023(5판 2025), Levels of AGI, ICML 2024 포지션 논문 — 「일반 지능의 연속체」 “expert AGI”
- 맥스 로저 외 2명, 2023, What is Moore's Law? (Our World in Data) — 「인지 산업화」 “Moore's law”
- 앤슨 호 외 4명, 2025, A Rosetta Stone for AI Benchmarks — 「인지 산업화」 “fixed AI performance level”
- 에게 에르딜·타메이 베시로글루, 2022, Algorithmic progress in computer vision — 「인지 산업화」 “over the last decade”
- 한스 군들라흐 외 3명, 2025, The Price of Progress — 「인지 산업화」 “improved by roughly 3x”
- 세비야·롤단, 2024-05-28, Training compute of frontier AI models (Epoch) — 「인지 산업화」 “more than 4x per year”
- 엠버슨·루드먼, 2026-09-22, The plunging price of thought (Epoch AI) — 「인지 산업화」 “recent Epoch study”
- 제임스 틸먼, 2026-10-05, Humans Are Not Chinchillas (Forethought) — 「인지 산업화」 “not a given”
- 세비야 외 6명, 2024-08-20, Can AI scaling continue through 2030? — 「인지 산업화」 “practical ceilings”
- 데이비슨·해드셔·매캐스킬, 2025, AI 진보의 실효 물리 한계 (Forethought) — 「인지 산업화」 “build-out”
- 톰 데이비슨·톰 훌든, 2025-08-04, 소프트웨어 지능 폭발의 속도와 규모 — 「인지 산업화」 “speculative ceilings”
- 데이먼 바인더, 2026-10-27, Quantity has a quality of its own — 「인지 산업화」 “can have a quality of its own”
- 조지프 헨릭, 2015, The Secret of Our Success (프린스턴대 출판부) — 「인지 산업화」 “experience and knowledge”
- 캐플런 외 · 2020 · Scaling Laws for Neural Language Models — 「모델과 데이터 확장」 “scaling laws”
- 토비 오드 · 2025-10-03 · 최근 AI 향상은 주로 추론 스케일링 — 「모델과 데이터 확장」 “test-time compute”
- 비야로보스 외 · 2022(v2 2024) · Will we run out of data? — 「모델과 데이터 확장」 “outpacing humanity’s ability to produce more of it”
- 슈마일로프 외 · Nature 631 · 2024-07-24 · 모델 붕괴 — 「모델과 데이터 확장」 “is useful for training”
- 게네바인 외 · Entropy 28(6):596 · 2026-05-27 — 「기술 패러다임 전환」 “Recent research”
- 오르테가 외 · 2019 · Meta-learning of Sequential Strategies — 「기술 패러다임 전환」 “learning algorithms”
- 그라우모야 외 · 2024 · Learning Universal Predictors — 「기술 패러다임 전환」 “theoretical upper limit of intelligence”
- 레르히너 · 2026 · The Abstraction Fallacy (PhilArchive) — 「기술 패러다임 전환」 “genuinely new concepts and abstractions”
- 크리스티안 리스트 · Philosophy & Technology 34 · 2021 — 「에이전트 협응 개선」 “"group agents"”
- 토마셰프 외 · 2025-09 · Virtual Agent Economies — 「에이전트 협응 개선」 “virtual agent economies”
- 브래턴·아게라 이 아르카스·마니카 · DMI · 2026-09-24 — 「에이전트 협응 개선」 “collective superintelligence”
- 치 외 · 2026-06 · Economy of Minds (NeurIPS 2026) — 「에이전트 협응 개선」 “scale as we add more agents and compute”
- 첸 외 · 2024(ICLR 2025) · MacNet 다중 에이전트 협업 — 「에이전트 협응 개선」 “research”
- 토마셰프·프랭클린·오신데로 · 2026-02 · Intelligent AI Delegation — 「에이전트 협응 개선」 “coordination inefficiencies”
- 토비 오드 · 2026-09-21 · Swarm Scaling — 「에이전트 협응 개선」 “diminishing returns”
- 아베디니 외 · 2026-03 · Don't Trust Stubborn Neighbors — 「에이전트 협응 개선」 “misinformation spread, manipulation, and collusion”
- 팔리에리·베즈네베츠 · DMI · 2026-09-24 — 「에이전트 협응 개선」 “learning to cheat”
- 어빙 존 굿 · Advances in Computers 6 · 1965 — 「재귀적 자기 개선(RSI)」 “I. J. Good”
- 레이 솔로모노프 · Human Systems Management 5(2) · 1985 — 「재귀적 자기 개선(RSI)」 “Ray Solomonoff”
- 블룸·존스·밴리넌·웹 · AER 110(4) · 2020 — 「재귀적 자기 개선(RSI)」 “harder to find”
- 실버 외 · Nature 550 · 2017-10-19 · AlphaGo Zero — 「재귀적 자기 개선(RSI)」 “AlphaZero”
- 앨런 데포 · ST&HV 40(6) · 2015 · On Technological Determinism — 「ASI로 가는 여러 길」 “economic and geopolitical competition”
기타
원문 범위
- 본문 전량을 옮겼다. 데크, 본문 다섯 절과 소절 넷, 그림 세 장, 감사의 말, 면책 고지, 저자 소개가 모두 완역 블록에 있다.
- 사이트의 쿠키 배너, 상단 메뉴, 사이드바 목차, 저자 소개 끝의 "Read More" 버튼은 옮기지 않았다. 사이드바 목차의 자리는 이 문서의 목차가 맡는다. 원문 첫머리의 저자 이름 링크는 완역 블록의 기여 저자 절로 이어진다.
- 그림 세 장은 원문 SVG를 그대로 싣는다. 그림 속 영어 글자는 각 그림 아래 캡션에 한국어로 옮겼다. 원문 그림에는 캡션이 없다.
- 첫머리의 표지 영상은 원문 영상(WebM, 1920×1080, 무음 반복 재생)을 그대로 건다.
- 원문에는 각주와 미주가 없다. 출처는 본문 링크 42곳(고유 문헌 40건)에 달려 있다. 완역은 이 링크를 원문과 같은 자리에 둔다. 링크에 마우스를 올리거나 키보드로 포커스를 주면 문헌의 종류와 내용 세 줄이 뜬다.
용어
- AGI · ASI
- 원문은 AGI를 거의 모든 인지 과제에서 인간과 맞먹는 기계로 쓴다. ASI는 인간 전문가 대규모 집단이 몇 년 걸릴 과제에서 더 적은 자원과 시간으로 그 집단을 꾸준히 앞서는 시스템이다. 이 기준은 인간이 관심을 두는 거의 모든 과제에서 충족돼야 한다.
- 인지 산업화(cognitive industrialization)
- 연산량이 늘고 비용이 떨어져 인지 작업이 표준화되고 자동화되는 상태를 가리키는 저자의 용어다. 기계적 산업화가 반복적 육체노동을 상품으로 만든 일에 빗댄 말이다.
- 스케일링 법칙(scaling laws)
- 모델 성능과 훈련 연산량, 훈련 데이터, 테스트 시점 연산 사이의 경험적 관계다. 관찰된 추세의 외삽이라서 익숙한 아키텍처와 데이터, 평가의 범위 안에서만 성립한다고 원문은 쓴다.
- 테스트 시점 연산(test-time compute)
- 모델이 답하기 전에 문제를 추론하도록 더 주는 연산이다.
- 다중 에이전트 스케일링 법칙(multi-agent scaling laws)
- 에이전트 수와 연산을 늘릴 때 집단 지능이 조직 방식에 따라 어떻게 늘어나는지를 나타낼 관계다. 원문은 이 관계가 아직 없다고 쓴다.
- 재귀적 자기 개선(RSI)
- AI 시스템이 다음 세대 AI의 개선을 자동화하는 과정이다. 원문은 코드와 설계, 데이터, 집단 수준의 세 기전을 든다.
- 능력 오버행(capability overhang)
- 진전에 여러 입력이 함께 필요한데 한 입력만 묶어 두면 쌓이는 차이다. 묶인 입력이 풀리는 순간 진전이 한꺼번에 뛴다.