x.com · SSRN · Soumitra Shukla · 2026-10-21
기술 병목: AI가 아직 못 하는 일의 가치를 AI가 어디에서 높일 수 있는지 측정하기
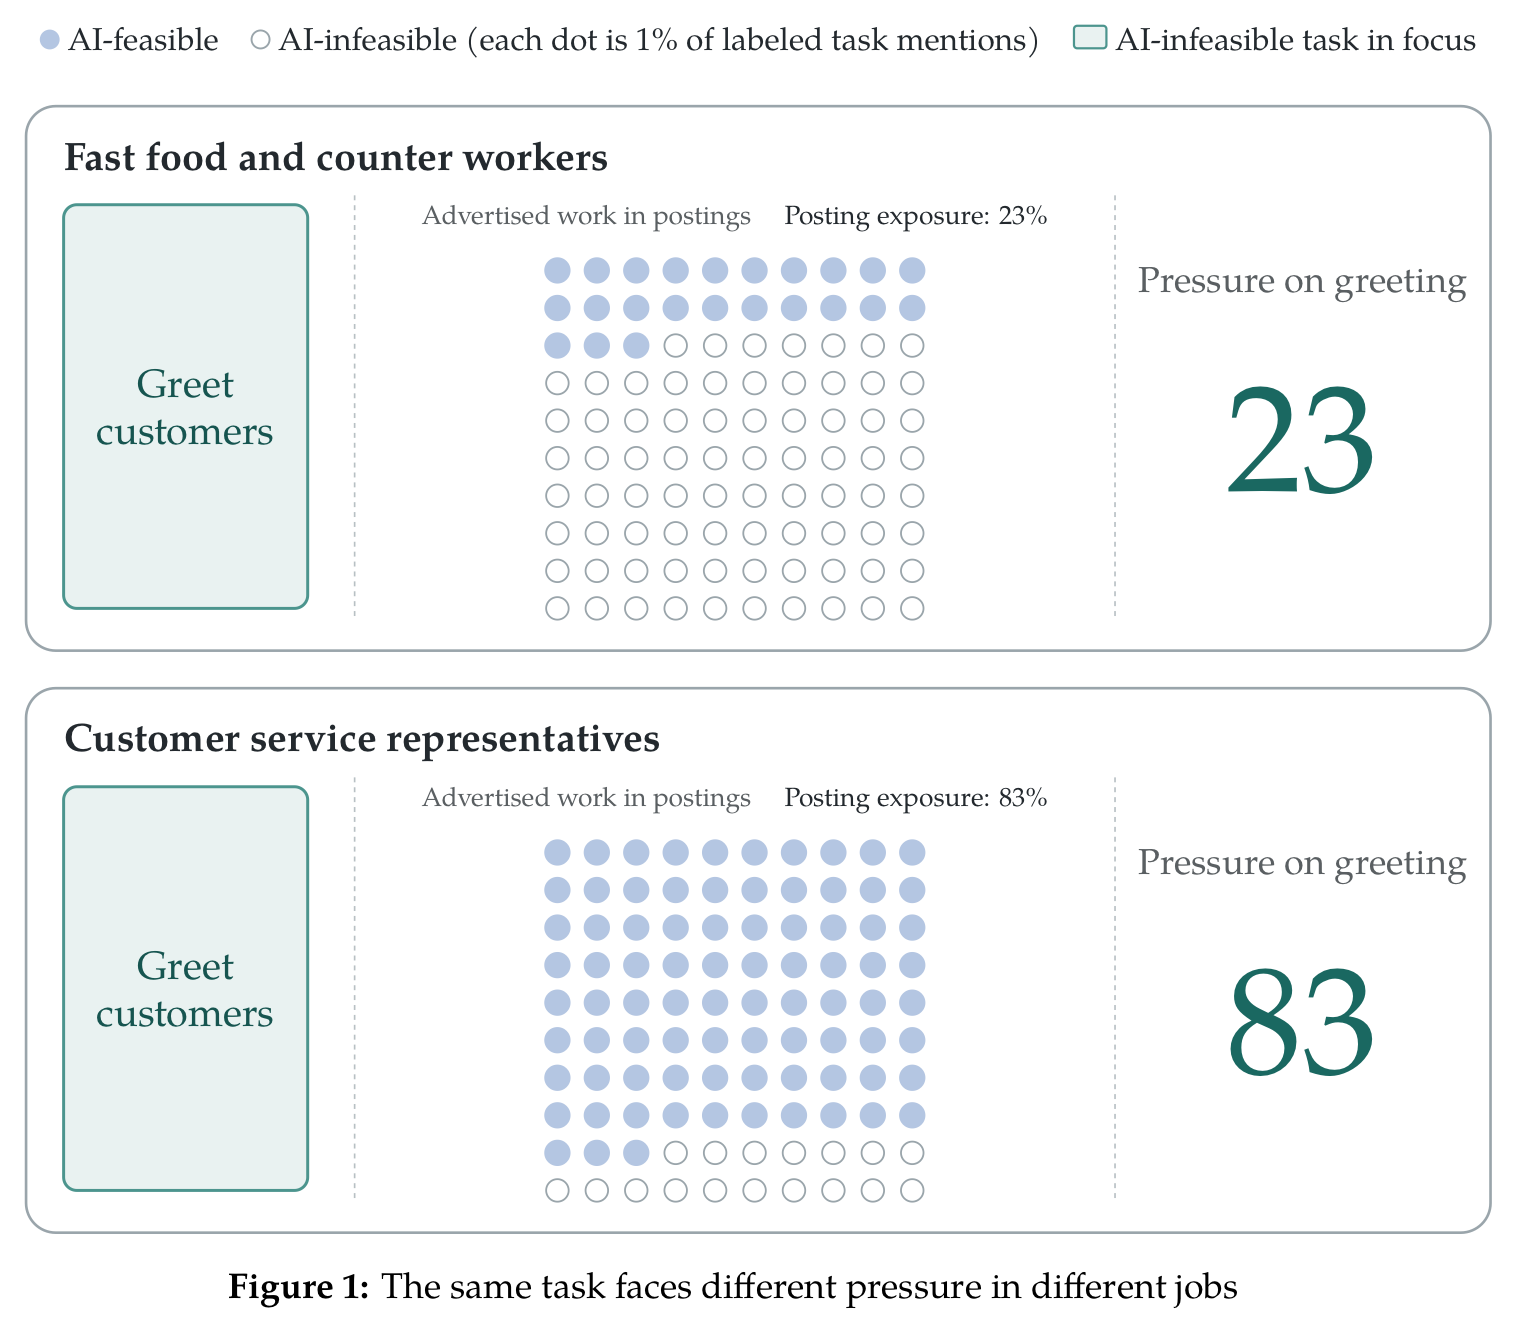
Burning Glass Institute의 경제학자 Soumitra Shukla가 2026-10-21 X 스레드로 공개한 working paper를 옮기고 주장마다 판정했다. 논문은 미국 채용 공고 약 2억 8,800만 건으로, GPT-4 평가에서 AI가 못 한다고 판정된 과업이 직업마다 얼마나 병목이 되는지 쟀다. 같은 과업이라도 공고를 낸 직업의 AI 노출도만큼 압력을 받는다. 「손님을 맞이하고 환영받는 느낌을 준다」는 패스트푸드 직원 공고에서 23, 고객 상담원 공고에서 83이다.
읽기 전에
핵심 질문
질문. AI가 한 직업의 일을 많이 대신할수록, 그 직업에서 AI가 아직 못 하는 일의 값어치도 더 오르는가? 답. 과업 하나로 보면 이 논문의 모형에서는 그렇다. 직업 전체로 보면 노출도 50%까지만 그렇다. 저자가 ‘병목 압력(bottleneck pressure)’이라 부른 지표에서, AI 불가능(AI-infeasible) 과업 하나가 받는 압력은 그 과업을 공고에 올린 직업의 AI 노출도와 같다. 같은 “손님을 맞이하고 환대한다(Greet customers and make them feel welcome)” 과업이 패스트푸드·카운터 직원 공고에서는 23을, 고객 서비스 상담원 공고에서는 83을 받는 이유다(0–100 척도). AI 불가능 과업에 걸린 압력 차이 가운데 53%(언급 가중 분산 기준)가 이렇게 같은 과업 안, 직업 사이에서 나온다.
직업 전체의 압력은 노출도와 AI 불가능 몫의 곱이다. 노출도 90.4%인 회계사·감사인은 8.7을 받는다. 일이 AI 가능과 불가능으로 반씩 갈린 화학 기술자는 최댓값 25 가까이 받는다.
이 숫자는 임금이나 고용의 측정값이 아니다. 미국 채용 공고 2억 8,830만 건(2018-01~2026-06)에 공개된 AI 실행 가능성 평가를 붙여 계산한 순위 지표다. 한계 가치가 실제로 몇 % 오르는지는 지수에 없다. 그 크기는 논문이 추정하지 않은 탄력성과 AI 이득의 크기에 달렸다. 저자도 스레드 둘째 글에서 이것을 잠재 압력이라 불렀다. 실현 여부는 기업이 AI를 업무에 통합하는 방식에 달렸다는 단서다.
출처. The Burning Glass Institute(BGI) 소속 경제학자 수미트라 슈클라(Soumitra Shukla)가 2026-10-21 20:05 UTC(한국 시각 2026-10-22 05:05)에 X에 올린 스레드다. 대상 논문은 같은 날짜로 SSRN에 올라온 104쪽 워킹 페이퍼 「Technology Bottlenecks: Measuring Where AI Could Raise the Value of Work It Cannot Yet Do」다. 동료 심사는 거치지 않았다. 글 1은 논문을 알리면서 초록 캡처를 붙인다. 글 2는 SSRN 링크와 단서를 싣는다. 글 3(2026-10-22 22:19 UTC)은 초고에 의견을 준 경제학자들에게 감사한다.
멘탈 모델
빌드 파이프라인에서 컴파일만 10배 빨라지면, 사람이 하는 코드 리뷰가 전체 시간을 정한다. 리뷰를 빠르게 하는 일의 값어치는 컴파일 비중이 컸던 팀일수록 크게 오른다(과업 압력 = 직업 노출도). 리뷰가 시간의 5%뿐인 팀은 리뷰 값어치가 많이 올라도 그 몫이 작아서, 팀 전체의 압력 총량은 컴파일과 리뷰가 반반인 팀에서 가장 크다(직업 압력 = 노출도 × (1 − 노출도)).
선행 개념
- AI 노출도(AI exposure)
- 한 직업의 일 가운데 AI가 할 수 있다고 평가된 몫이다. 기존 노출도 지표(Webb, 2020; Felten, Raj and Seamans, 2021; Eloundou et al., 2024)는 이 몫으로 직업을 줄 세운다. ‘AI가 무엇을 할 수 있나’를 재는 순위다. 이 논문은 노출도를 두 방식으로 계산한다. 목록 노출도는 미국 직업 정보 네트워크(Occupational Information Network, O*NET)에 실린 그 직업의 핵심 과업 가운데 AI 가능 과업의 비율이다. 과업마다 같은 무게를 준다. 공고 노출도는 그 직업의 채용 공고에서 매칭된 과업 언급 가운데 AI 가능 언급의 비율이다.
- 708개 직업에서 두 값의 평균은 57.2와 57.5, 순위 상관은 0.92다(3.3절, 그림 2, 19–20쪽). 압력 계산에는 공고 노출도만 쓴다.
- O*NET 과업 진술문과 공고 매칭
- O*NET은 직업마다 한 줄짜리 과업 진술문 목록을 둔다. “Greet customers and make them feel welcome”도 그런 진술문 하나다. BGI의 파이프라인은 공고 본문을 줄 단위로 나눈다. 업무 책임을 적은 줄만 매칭에 쓴다. 임베딩 분류기가 그 줄마다 O*NET 전체 진술문 가운데 가장 가까운 것을 고른다. 1순위 매칭이 최고 신뢰 문턱을 넘을 때만 남긴다. 공고 한 건은 평균 4.7개(중앙값 3개) 과업과 이어진다. 공고의 19.9%는 이어진 과업이 없다(3.1절, 17쪽).
- 매칭된 언급의 90.1%는 공고 직업 자신의 O*NET 목록 밖 진술문이다(18쪽). 저자는 이 몫이 새 업무를 뜻하지 않는다고 적는다. 매처의 탐색 범위가 넓은 탓도 섞여 있다. 이 매칭 덕에 같은 진술문을 여러 직업에서 따라갈 수 있다. 1,000번 넘게 언급된 과업은 평균 211개 직업의 공고에 나온다(18쪽). O*NET 목록의 핵심 과업이 전부 AI 가능인 직업은 약 16%다. 목록만 쓰면 이들의 압력은 0이 된다. 공고에서는 이 직업들도 모두 AI 불가능 과업을 올린다(5쪽).
- GPT-4 실행 가능성 평가와 AI 가능·불가능 구분
- Eloundou et al.(2024, 「GPTs are GPTs」, Science)은 O*NET 과업마다 사람 평가자와 GPT-4로 등급을 매겼다. 기준은 같은 품질로 과업 완료 시간을 절반 이상 줄일 수 있느냐다. E1은 언어 모델만으로 그 문턱을 넘는 과업이다. E2는 보완 소프트웨어(complementary software)가 함께 있어야 넘는 과업이다. 이 논문의 기준선은 GPT-4의 넓은 등급이다. E1이나 E2면 AI 가능(Ft = 1), 둘 다 아니면 AI 불가능(Ft = 0)으로 나눈다(4쪽 각주 2, 17쪽). 보완 소프트웨어를 허용해도 문턱 아래에 남는 과업만 불가능으로 치므로, 불가능 쪽 정의가 좁다.
- 모형에서 시간 절반은 생산성 배수 δ ≥ 2에 해당한다(8쪽 각주 5). 문턱 아래라고 AI가 전혀 못 돕는다는 뜻은 아니다. 로봇 같은 다른 기술은 평가 밖이다(37쪽). 라벨을 바꾸면 직업 순위가 뒤집힌다. E1만 세는 α 등급, E2에 절반만 쳐 주는 β 등급, 사람 평가로 바꿀 때 직업 압력 순위와 기준 순위의 상관은 −0.15, −0.22, −0.34다. 같은 교체에서 과업 순위의 상관은 0.81, 0.99, 0.79로 남는다(표 5, 33쪽; 35–36쪽).
- 과업 기반 틀, 보완성, ‘미니 보몰’
- 과업 기반 모형(Autor, Levy and Murnane, 2003; Acemoglu and Autor, 2011; Acemoglu and Restrepo, 2018)에서 직업은 과업의 묶음이다. 경제 전체 산출은 다시 직업들의 묶음이다. 직업 안 과업끼리의 대체 탄력성은 σ, 직업끼리는 ρ다. 이 논문의 가정 1은 σ < ρ다. 한 직업 안의 과업들이 직업끼리보다 서로 더 강하게 보완한다는 뜻이다(9쪽; Becker and Murphy, 1992). 노동을 고정하고 AI가 가능 과업만 빠르게 하면, 불가능 과업의 노동 한계 가치는 모든 과업에 같은 규모 효과와 자기 직업 노출도 Eo에 비례하는 병목 효과로 변한다(식 (2), 9쪽).
- 과업들이 총보완 관계(σ < 1)면 남은 불가능 과업이 직업 안 노동을 점점 더 차지할 수 있다. 저자는 이것을 ‘미니 보몰’ 효과라 부른다. 생산성 증가가 더딘 부문이 경제의 노동을 점점 더 차지한다는 보몰(Baumol, 1967)의 불균형 성장 논리를 직업 안으로 옮긴 이름이다(2쪽, 39–40쪽). 위의 파이프라인 비유가 맞는 구간도 σ < 1이다. 1 ≤ σ < ρ에서는 산출 상한 해석이 사라진다. 노출된 직업의 불가능 과업 값어치가 덜 노출된 직업보다 더 오르는 상대 효과만 남는다. 가정이 뒤집혀 σ > ρ이면 병목 효과가 음수가 되어, 고객 서비스의 손님 맞이는 AI가 나머지 일을 빠르게 한 탓에 값어치를 잃는다(9–10쪽). 지수는 이 탄력성들을 추정하지 않는다.
- 병목 압력: 과업 수준과 직업 수준
- 과업 수준 압력은 Bot = (1 − Ft) × Eo다(식 (3), 10쪽). AI 가능 과업의 압력은 0이다. AI 불가능 과업은 그 과업을 올린 직업의 공고 노출도를 그대로 받는다. 표 1(11쪽)에서 설거지는 식기 세척원 직업(노출도 4.9) 안에서 4.9를 받는다. 마케팅·영업 인력의 채용·교육·평가 지휘는 마케팅 관리자 직업(노출도 90.4) 안에서 90.4를 받는다. 과업끼리 비교할 때는 그 과업이 올라온 직업들의 압력을 공고 수로 가중 평균한 Pt를 쓴다(3.2절, 19쪽).
- 직업 수준 압력은 과업 압력을 그 직업의 언급 비중으로 평균한 값이다. Bo = Eo × So이고, So는 AI 불가능 몫이다(식 (4), 12쪽). 두 몫을 같은 언급에서 재므로 So = 1 − Eo, 곧 Bo = Eo(1 − Eo)다. 이 곡선은 노출도 50%에서 25로 정점을 찍는 언덕이다. 노출도가 같은 두 직업은 압력도 늘 같다(12쪽). 직업 순위는 공고 노출도 하나로 정해진다. 저자가 핵심 실증으로 내세우는 것은 같은 과업이 직업마다 다른 압력을 받는다는 과업 수준 결과다(5쪽).
- 노출도 72.4%인 도매·제조 영업 담당자는 20.0, 92.1%인 컴퓨터 시스템 엔지니어·아키텍트는 7.3을 받는다(표 3 패널 B, 23쪽). 708개 직업의 압력은 4.2~25에 퍼진다. 공고 노출도와의 순위 상관은 −0.43이다(표 2, 16쪽). 31개 직업이 반올림하면 25.0이라서 최상위 순위는 작은 변화에도 바뀐다(32쪽).
- 언급 가중 변동의 ‘과업 내, 직업 간’ 몫(53%)
- AI 불가능 (직업, 과업) 칸마다 압력 Bot가 하나씩 있다. 칸마다 그 과업을 언급한 공고 수만큼 무게를 준다. 그 가중 분산을 둘로 가르면, 한 몫은 과업 평균끼리의 차이다. 다른 몫은 같은 과업이 직업마다 다른 값을 받는 차이다. 뒤쪽 몫이 53.2%다(표 2 A8, 16쪽; 부록 D, 65쪽). 각 직업 자신의 O*NET 목록 과업만 남기면 이 몫은 0.3%로 떨어진다. O*NET 진술문 대부분이 한 직업의 목록에만 실려 있어서다(25쪽).
- 보편 문구 59개를 빼면 49.2%, 중간 신뢰 매칭까지 넣으면 57.7%다(65쪽). 매칭 오류는 이 몫을 부풀릴 수 있다. 매처가 서로 다른 업무 줄을 같은 진술문 하나로 묶으면, 직업 사이의 차이가 같은 과업 안의 변동으로 잡힌다(18쪽, 26쪽). 저자가 공고 줄을 직접 읽어 확인한 진술문은 골라 뽑은 두 개다. 전체 매칭 오류율은 측정되지 않았다(38쪽).
- 능력 병목과 통합 병목
- 능력 병목은 AI가 문턱만큼 빠르게 하지 못하는 과업이다. 통합 병목은 AI가 할 수 있는데 기업이 아직 생산 과정에 붙이지 않은 과업이다. Eloundou et al.의 등급은 배포와 도입이 성공했다는 조건 아래의 능력을 평가한다. 이 지수가 재는 것은 능력 병목에서 나오는 압력이다(4쪽, 38쪽). 지수는 가능 과업이 실제로 빨라졌다고 가정한다. 과업 묶음도 고정한다. 기업이 직무를 다시 짜거나 새 과업이 생기는 변화는 지수 밖이다. 공급망처럼 직업과 직업 사이에 걸린 병목도 정의상 빠진다(38–39쪽).
권장 읽기 순서
- 원본 (완역)부터 읽는다. 글은 3개, 캡처는 2장이다. 글 1에 붙은 초록 캡처가 논문 주장을 한 문단에 담는다. 글 2의 PS가 한계 조건을 단다.
- Executive Summary에서 주장 전체와 종합 신뢰도를 확인한다.
- 팩트체크에서 스레드와 초록의 숫자마다 판정과 근거 위치를 본다.
- 논문(SSRN 7605598)은 서론(2–6쪽)의 손님 맞이 예와 세 직업 비교, 2절의 식 (3)·(4)와 표 1·그림 1(10–13쪽), 4절 표 3(21–23쪽), 5절 그림 5·6과 표 4(25–31쪽), 6절 표 5(32–36쪽), 7절(36–39쪽) 순서로 읽는다. 식 (1)·(2)와 부록 A는 탄력성 조건을 확인할 때 펼친다.
- 원본 링크·인용과 기타는 필요할 때 찾아본다.
SSRN 페이지는 지금 2026-11-09자 130쪽 개정판을 내려준다. 초록도 새로 써서 글 1의 캡처와 문장이 다르다. 새 초록은 시니어·주니어 공고의 압력 차이, 2018년부터 2026년 상반기까지의 추세, 2022년 이후 공고 증가와의 관계, Anthropic Economic Index·OpenAI Signals 사용 데이터로 AI 가능을 더 좁게 센 결과를 더한다.
두 판은 1~5절, 그림 1~6, 표 1~4의 번호가 같다. 개정판은 6절 ‘Usage-adjusted pressure’를 새로 넣어서 강건성·논의·결론이 7·8·9절로 밀렸다. 스레드가 가리킨 2026-10-21판 PDF는 저자 웹사이트 저장소의 2026-10-21 기록에 남아 있다.
| 알고 싶은 것 | 2026-10-21판 위치 |
|---|---|
| 같은 과업이 직업마다 다른 압력을 받는 모습 | 그림 1(13쪽), 그림 5(29쪽) |
| 노출도가 높은데 직업 압력이 낮은 직업 | 표 3 패널 B(23쪽) |
| 압력 구간마다 압력을 지는 일의 종류 | 그림 6(30쪽) |
| 압력 총량 상위 과업과 평균 압력 상위 과업 | 표 4(31쪽) |
| 라벨·매칭 기준을 바꿀 때 순위가 움직이는 정도 | 표 5(33쪽), 6절(32–36쪽) |
| 지수가 재지 않는 것 | 7절(36–39쪽) |
| 탄력성 조건과 식의 유도 | 부록 A(46쪽부터) |
점검 질문
- 고객 서비스 상담원 공고에서 손님 맞이 과업의 압력은 83이다. 고객 서비스 상담원이라는 직업 전체의 압력은 13.9다. 두 숫자는 어떻게 함께 성립하는가? 답이 있는 곳: 논문 4절 첫 문단(21–22쪽), 식 (4)(12쪽)
- GPT-4 넓은 등급을 α 등급이나 사람 평가로 바꾸면 직업 압력 순위가 기준 순위와 음의 상관을 보인다. 과업 압력 순위는 0.79 이상을 유지한다. 언덕 모양 곡선 위에서 어떤 직업이 압력을 잃고 어떤 직업이 얻는가? 답이 있는 곳: 논문 6절 ‘Feasibility labels’(35–36쪽), 표 5(33쪽)
- 글 2의 PS가 말한 통합 병목을 이 지수로 재려면 Ft = 1의 기준을 어떻게 바꿔야 하는가? 그렇게 바꾼 지수에서 0점 과업에는 어떤 두 종류가 섞이는가? 답이 있는 곳: 원본 (완역) 글 2, 논문 7절 ‘Scope’(38–39쪽), 2026-11-09판 6절
Executive Summary
GPT-4 평가에서 AI가 못 한다고 판정된 과업에 걸리는 ‘병목 압력(bottleneck pressure)’은 과업 자체가 아니라 그 과업을 올린 직업의 AI 노출도가 정한다. 미국 구인 공고 2억 8,830만 건에서 같은 과업 “고객을 맞이하고 환영받는 느낌을 준다(Greet customers and make them feel welcome)”는 패스트푸드 직원 공고에서 23, 고객 서비스 상담원 공고에서 83의 압력을 받는다(0–100 척도). AI 불가능 과업에 걸린 압력의 언급 가중 변동 가운데 53.2%가 이처럼 같은 과업 안의 직업 간 차이다. 직업 단위로 모은 압력은 AI 가능 업무와 불가능 업무가 반반인 직업에서 최대 25다. 708개 직업에서 이 직업 압력과 공고 노출도의 순위상관은 −0.43이다.
수미트라 슈클라(Soumitra Shukla)는 버닝 글래스 연구소(Burning Glass Institute, BGI)의 경제학자다. 그는 2026-10-21 20:05 UTC(한국 시간 2026-10-22 05:05)에 X 스레드로 단독 저자 논문 「Technology Bottlenecks: Measuring Where AI Could Raise the Value of Work It Cannot Yet Do」를 알렸다. 스레드가 링크한 판은 사회과학연구네트워크(Social Science Research Network, SSRN) 7605598번 논문의 2026-10-21 판(104쪽)이다.
이 논문은 동료 심사를 거치지 않은 working paper다. 저자는 이 값을 ‘잠재 압력’이라고 부른다. 기업이 AI를 실제 업무에 붙였는지는 재지 않는다. 모든 수치는 엘룬두 외(Eloundou et al., 2024)의 GPT-4 평가가 ‘AI가 할 수 있다’고 본 과업 목록에 조건부다.
신뢰도 B
수치와 식은 논문 원문 그대로다. 'AI가 아직 못 하는 일'이라는 이름은 2023년 초기 GPT-4의 '작업 시간 절반 단축' 판정을 넓게 부른 것이다. 주장 32건을 판정했다. 사실 29건, 부분사실 3건, 불확실 0건, 거짓 0건이다. 판정 근거와 출처는 팩트체크 블록에 있다.
스레드의 주장과 논문 속 근거
스레드는 게시물 세 개와 첨부 이미지 두 장으로 이뤄진다. 게시물 1의 이미지는 논문 표지의 초록이다. 게시물 2의 이미지는 SSRN 초록 페이지 화면이다. 각 주장의 판정은 팩트체크에 있다.
| 게시물 | 주장 | 위치 | 논문 내용과 단서 |
|---|---|---|---|
| 1 | 새 논문 「Technology Bottlenecks」를 낸다. | 표지, 1쪽 | 단독 저자 논문이다. 표지 날짜는 2026-10-21이다. |
| 1 | AI 노출도 지표는 AI가 할 수 있는 일을 묻는다. | §1, 2쪽 | 노출도를 ‘AI가 어느 직업에 닿을지’ 서술하는 표준 도구로 놓는다. 브린욜프슨 외, 엘룬두 외, 펠튼 외, 웹(Webb, 2020)을 든다. |
| 1 | 대신 AI가 아직 못 하는 일의 한계가치가 어디서 오르는지 묻는다. | §2 정의 1·식 (2), 9쪽 | 노동을 고정한 1차 근사에서 AI 불가능 과업의 노동 한계가치생산 상승분으로 정의한다. |
| 1 | 미국 공고 2억 8,800만 건을 줄 단위로 가장 가까운 미국 직업정보망(Occupational Information Network, O*NET) 과업에 연결했다. | §3.1, 15·17쪽 | BGI 공고(2018-01~2026-06)다. 공고 전체의 19.9%는 고신뢰 연결이 하나도 없어서 측정에 들어가지 않는다. |
| 1 | 엘룬두 외(2024)의 GPT-4 실행 가능성 평가를 쓴다. | §1 4쪽, §3.1 17쪽 | 넓은 기준(E1+E2)을 이진값으로 쓴다. 다른 평가 기준으로 바꾸면 직업 순위상관이 음수가 된다(§6). |
| 1 | 단순한 과업 모형에서 유도하면 AI 불가능 과업의 압력은 그 과업을 올린 직업의 노출도다. | §2 식 (2)·(3), 9–10쪽 | 가정 1(σ < ρ)과 공통 탄력성·공통 AI 이득 아래의 1차 순위다. σ > ρ이면 부호가 뒤집힌다. |
| 1 | 같은 과업도 직업마다 압력이 크게 다를 수 있다. | 그림 1(13쪽), 그림 5(29쪽) | 저자는 이 결과가 공고 줄–과업 연결의 정확도에 달렸다고 쓴다(5·26쪽). |
| 1 (초록) | 직업 단위 압력은 노출도와 AI 불가능 비중의 곱이다. | 식 (4), 12쪽 | 두 비중을 같은 공고에서 재므로 Eo(1 − Eo)가 된다. |
| 1 (초록) | 평가가 붙은 과업 언급의 약 90%가 그 직업 자신의 O*NET 목록 밖에 있다. | §3.1, 18쪽 | 저자는 목록 밖 언급이 곧 새 일을 뜻하지는 않는다고 쓴다. |
| 1 (초록) | 언급 가중 변동의 약 53%가 같은 과업 안, 직업 사이에서 나온다. | 표 2 A8(16쪽), §5(25쪽) | AI 불가능 과업 7,485개 전체로 잰 값이다. |
| 1 (초록) | 직업 압력은 반반에서 정점에 이르므로 노출도와 다르게 순위를 매긴다. | 식 (4), 표 2 B3(16쪽), 표 3(23쪽) | 표 3 패널 B의 네 직업에서 노출도가 오를 때 압력이 내린다. |
| 1 (초록) | 과업 압력이 오를수록 AI 불가능 일에서 대인·감독 업무 몫이 커진다. 물리 업무 몫은 준다. | 그림 6(30쪽) | 저자는 감독 업무의 압력이 크다고 그 수요가 는다는 뜻은 아니라고 덧붙인다. 생성형 AI가 조정·모니터링 같은 조직 기술의 공고 수요를 낮췄다는 데비질리 외(Devigili et al., 2026)를 함께 든다(26쪽). |
| 1 | 압력을 노출도와 함께 보고하면 AI가 할 수 있는 범위와, 못 하는 일을 개선할 때 보상이 커질 곳이 함께 보인다. | §2 ‘범위와 해석’ 14쪽, §8 39–40쪽 | 보상은 모형이 1차 근사로 매긴 순위다. 2026-10-21 판은 실제 보상을 재지 않는다. |
| 2 | 논문 링크(SSRN). | SSRN 7605598 | 첨부 화면은 2026-10-13 게시, 2026-10-21 최종 수정이다. |
| 2 (PS) | 이 값은 잠재 압력이다. 실현 여부는 기업이 AI를 업무에 어떻게 통합하느냐에 달렸다. | §1 6쪽, §7 ‘범위’ 38쪽 | 논문도 같은 단서를 단다. 지수는 AI 가능 과업이 실제로 빨라진다고 가정한다. |
| 2 (PS) | 통합 병목을 재려면 연구가 더 필요하다. | §7 ‘범위’, 38–39쪽 | AI 가능 기준을 ‘AI 가능이자 실제로 통합된 과업’으로 바꿔 다시 계산하는 길을 적는다. 둘을 가르려면 능력 정보와 통합 정보가 따로 있어야 한다. 2026-11-09 판 §6은 사용량 데이터로 이 방향의 첫걸음을 뗀다. |
| 3 | 초고를 본 연구자들의 의견이 논문을 낫게 했다. 애쓰모글루, 오터, 스탠스버리, 골드파브, 록, 이마스에게 특히 감사한다. | 표지 각주, 1쪽 | 각주는 20명에게 감사한다. 여섯 명이 모두 들어 있다. 대니얼 록은 평가 출처인 엘룬두 외(2024)의 공저자다. 알렉스 이마스는 슈클라와 2026년 글 두 편을 함께 썼다. 각주는 Claude Opus 5.5와 GPT-6 Astra의 연구 보조, refine.ink의 검토에도 감사한다. 의견을 준 것과 결과에 동의한 것은 다른 일이다. |
모형: 과업 압력과 직업 노출도 (§2)
모형은 애쓰모글루·오터(Acemoglu and Autor, 2011)와 애쓰모글루·레스트레포(Acemoglu and Restrepo, 2018)의 과업 기반 생산 모형을 쓴다(8쪽). 최종 산출은 직업들을 대체탄력성 ρ의 CES(constant elasticity of substitution, 대체탄력성 일정) 결합식으로 묶는다. 각 직업은 과업들을 탄력성 σ의 CES 결합식으로 묶는다. AI는 AI 가능 과업(Ft = 1)의 산출을 δ배로 늘린다. 엘룬두 외의 ‘같은 품질로 시간을 절반 이상 줄인다’ 기준은 δ ≥ 2에 해당한다(8쪽 각주 5). 직업 노출도는 비용 비중 πot로 가중한 AI 가능 과업 비중 Eo = Σt πotFt다.
지수의 방향을 정하는 가정은 가정 1이다. 과업이 직업 사이보다 직업 안에서 더 강한 보완재라고 둔다(σ < ρ). 근거는 베커·머피(Becker and Murphy, 1992)의 분업 논리다. 상대 조건이라 σ < 1을 요구하지 않는다(9쪽). 노동을 고정하면 AI 불가능 과업의 노동 한계가치생산(marginal value product of labor, MVPL)은 1차 근사로 다음처럼 변한다(식 2, 9쪽).
앞 항은 모든 과업에 같은 규모 효과(scale effect)다. 뒤 항이 직업 안에서 작동하는 병목 효과(bottleneck effect)다. 병목 효과는 과업이 속한 직업의 노출도에 비례한다. σ < 1이면 남은 AI 불가능 과업이 직업 산출의 상한이 된다. 1 ≤ σ < ρ이면 상한 해석은 사라진다. 노출된 직업의 AI 불가능 과업 가치가 덜 노출된 직업보다 더 오르는 상대적 파급만 남는다(9–10쪽).
가정 1이 깨진 극단도 논문에 있다. ρ = 1에 직업 안 완전 대체를 더하면 1차 변화는 ln δ (Ē − Eo)다. 이때 AI가 고객 서비스의 나머지 업무를 빠르게 할수록 고객 맞이의 가치는 떨어진다. 저자는 분업 논리와 오터·톰프슨(Autor and Thompson, 2025)의 증거를 들어 이 경우를 배제한다(10쪽). 2026-10-21 판은 σ와 ρ를 추정하지 않는다.
지수
규모 효과는 모든 과업에 같아서 순위를 바꾸지 않는다. 공통 탄력성과 공통 AI 이득 아래 병목 효과는 AI 불가능 과업을 다음 지수로 줄 세운다(식 3, 10쪽).
AI 가능 과업과 노출도 0인 직업의 과업은 지수가 0이다. 노출된 직업에 놓인 AI 불가능 과업만 ‘기술 병목(technology bottleneck)’이다. 순위는 1차 근사에 기대지 않는다. 유한한 이득에서도 정확한 병목 항 (1/σ − 1/ρ) Δ ln Yo는 Eo와 함께 오른다(10쪽). 변화의 크기는 ln δ와 보완성 차이 1/σ − 1/ρ에 달린다. 두 값은 지수에 들어 있지 않다(11쪽). AI 불가능 과업도 공통 배율 δ0 (1 ≤ δ0 < δ)만큼 빨라지면 순위는 그대로다(12쪽).
표 1(11쪽)이 예를 든다. 마케팅 관리자 공고의 ‘가격 전략 수립’은 AI 가능이라 압력이 0이다. 같은 직업의 ‘마케팅·영업 인력의 채용·훈련·평가 지휘’는 AI 불가능이라 직업 노출도 90.4를 그대로 받는다. 설거지와 바닥 청소도 AI 불가능이다. 두 과업은 노출도 4.9인 식기세척원과 8.3인 청소원 공고에 있어서 압력이 4.9와 8.3에 그친다.
그림 1(13쪽)은 고객 맞이 과업 하나로 이 구조를 보여 준다. 두 직업 공고의 과업 언급을 1%당 점 하나로 찍는다. 채운 점이 AI 가능, 빈 점이 AI 불가능이다. 패스트푸드·카운터 직원은 채운 점이 23%라서 고객 맞이의 압력이 23이다. 고객 서비스 상담원은 채운 점이 83%라서 압력이 83이다.
직업 단위 압력
과업 지수를 직업의 일 전체로 평균하면 직업 압력이 나온다(식 4, 12쪽).
So는 직업의 일 가운데 AI 불가능 비중이다. 이 논문은 두 비중을 같은 과업·가중·평가로 재므로 So = 1 − Eo다. 직업 압력은 Eo(1 − Eo)라는 고정된 혹 모양 곡선이 된다. 양 끝에서 0이다. 노출도 0.5에서 최대 0.25, 0–100 척도로 25가 된다. 노출도가 같은 두 직업은 언제나 같은 직업 압력을 받는다(12쪽). 직업 순위는 공고 노출도만으로 정해진다. 논문의 새 측정은 과업 단위에 있다.
지수가 재지 않는 것
부록 A는 노동을 과업별 고정, 직업 안 이동, 과업·직업 간 완전 이동의 세 경우로 푼다(14쪽). 세 경우 모두 지수는 과업의 총소득 비중 변화율을 1차 근사로 같은 순서로 줄 세운다. 그 과업을 빠르게 하는 기술 개발 수익의 변화율도 같은 순서다. 직업 안 이동에서는 σ < 2 − 1/ρ가 추가로 필요하다. 노동이 고정이면 차이는 임금에 나타난다. 노동이 완전히 움직이면 임금이 같아진다. 그때 차이는 고용에 나타난다.
지수는 이 임금·고용 변화를 추정하지 않는다(14쪽). 작업 시간 비중도 아니다. 임금·고용·AI 도입의 예측도 아니다(15쪽).
데이터와 측정 (§3)
표본
공고는 BGI가 정제와 중복 제거를 거친 2018-01~2026-06 미국 구인 공고다(15쪽). 인력 파견업체 공고와 수집 범위가 들쭉날쭉한 대형 구인 게시판 한 곳은 뺀다. O*NET 세부 직업 코드가 고신뢰로 붙은 공고만 남긴다. 기간 전체 공고가 1만 건 이상인 직업만 쓴다. 그 결과 784개 직업에 3억 2,120만 건이 남는다. 이 가운데 O*NET 카탈로그 노출도가 있는 708개 직업의 2억 8,830만 건이 주 분석 표본이다.
공고 줄에서 O*NET 과업으로
BGI 파이프라인은 공고 본문을 줄로 나눈다(17쪽). 줄마다 책임 업무를 서술하는지 표시한다. 책임 업무 줄만 O*NET 과업 문장과 맞춘다. 상투 문구가 과업으로 잘못 연결되는 일을 줄이려는 단계다. 연결은 임베딩 기반 분류기가 맡는다. 알고리즘 세부는 공개하지 않는다. 분류기는 줄마다 가장 비슷한 과업 문장 두 개를 고른다. 주 표본은 1순위 연결 가운데 최고 품질 기준을 넘은 ‘use’ 등급만 쓴다.
한 공고에서 같은 과업이 여러 줄에 나와도 한 번만 센다. 공고–과업 언급은 과업이 있다는 사실만 기록한다. 반복 횟수와 투입 시간은 기록하지 않는다. 공고 한 건은 평균 4.7개, 중앙값 3개 과업에 연결된다. 평균적인 직업은 고유 과업 문장 4,724개를 광고한다(17쪽). 분석 표본의 평가가 붙은 공고–과업 언급은 13억 건이다. 그중 57.1%가 AI 가능이다. 언급 1,000회 이상인 과업은 평균 211개 직업에 나온다(18쪽).
AI 가능 판정 규칙
판정은 엘룬두 외(2024)의 GPT-4 평가 가운데 넓은 기준을 쓴다(4·17쪽). E1은 언어 모델만으로 같은 품질에서 과업 시간을 절반 이상 줄일 수 있는 과업이다. E2는 보완 소프트웨어가 있어야 그 기준을 넘는 과업이다. 둘 중 하나면 Ft = 1, 아니면 0이다. 보완 소프트웨어까지 허용한 뒤에도 기준 아래에 남는 일만 AI 불가능으로 치므로 이 판정은 보수적이다. 좁은 기준 α는 E1만 센다. β는 E1 + ½E2다(4쪽 각주 2).
평가 단위는 O*NET 과업 문장이다. 더 굵은 단위인 세부 업무 활동(detailed work activity, DWA)은 AI 가능 과업과 AI 불가능 과업을 섞는다. 활동에 딸린 모든 과업이 불가능할 때만 불가능으로 치면 AI 불가능 언급의 61%가 버려진다. 고객 관계 개발, 고객 맞이, 감독 같은 과업이 그때 빠진다(17쪽). 분석 표본의 AI 불가능 과업 문장은 7,485개다(18쪽).
목록 밖 언급과 연결 점검
BGI 연결기는 공고 직업의 O*NET 목록이 아니라 O*NET 과업 문장 전체와 맞춘다. 평가가 붙은 언급 가운데 그 직업의 핵심 과업은 8.6%, 보조 과업은 1.2%다. 목록 밖이 90.1%다. 나머지 0.1%는 핵심·보조 여부를 확인하지 못한 목록 안 언급이다. AI 불가능 언급만 보면 목록 밖이 89.4%다(18쪽). 목록 밖 언급 중 18%는 그 직업의 핵심 과업과 세부 업무 활동을 공유한다. 51%는 일반 업무 활동만 공유한다. 31%는 둘 다 공유하지 않는다.
카탈로그만 쓰면 핵심 과업이 모두 AI 가능인 직업은 압력이 0으로 나온다. 그런 직업이 708개 중 약 16%다. 이 직업들도 공고에는 모두 AI 불가능 과업을 올린다(5쪽). 카탈로그 과업 문장은 대개 한 직업 목록에만 있다. 같은 과업을 직업 사이에서 비교하려면 공고 연결이 필요하다.
저자는 연결된 공고 줄을 직접 읽어 두 문장을 점검했다. ‘나무·사다리 오르기’ 문장과 ‘도랑 파기 같은 육체 노동’ 문장이다. 두 문장에 연결된 줄은 대부분 업무가 아닌 체력 조건이나 근무 환경 문구였다(18쪽, 부록 C). 저자는 두 문장을 과업 순위표에서 뺀다. 직업 압력 계산에는 남긴다. 두 문장의 몫은 공고 가중 전체 압력의 1.1%다.
경험적 대응물
cot를 과업 t를 포함한 직업 o의 공고 수라고 하자. AI 불가능 비중은 So = Σt cot(1 − Ft) / Σt cot다(19쪽). 공고 노출도는 Eo = 1 − So다. 과업 평균 압력 Pt는 그 과업을 올린 직업들의 압력을 공고 수로 가중 평균한 값이다. 과업의 전체 압력 기여 NtPt / Σs NsPs는 그 과업이 얼마나 자주 올라오는지까지 반영한다. 모형의 비용 비중 자리에는 공고 언급 비중이 들어간다. 저자는 이를 ‘불완전한 대리 변수’라고 부른다(19쪽).
| 측정값 | 평균 | P10 | P50 | P90 |
|---|---|---|---|---|
| 카탈로그 노출도: 핵심 과업 중 AI 가능 비중, 과업마다 같은 가중 | 57.2 | 7.1 | 63.6 | 100.0 |
| 공고 노출도: 공고 언급 중 AI 가능 비중 | 57.5 | 21.5 | 61.2 | 89.6 |
| AI 불가능 비중 So | 42.5 | 10.4 | 38.8 | 78.5 |
| 병목 압력 Bo | 17.8 | 9.1 | 18.8 | 24.6 |
| 카탈로그만 쓴 기준값 Ecat(1 − Ecat) | 12.1 | 0.0 | 12.2 | 24.3 |
| 혼합 기준값 Ecat × So | 15.9 | 5.0 | 15.5 | 27.5 |
| 과업 압력 Pt (언급 1,000회 이상 AI 불가능 과업 6,309개) | 40.3 | 22.2 | 37.5 | 62.2 |
두 노출도의 순위상관은 0.92다(19쪽, 그림 2). 차이는 양 끝에 있다. 카탈로그에는 핵심 과업이 전부 AI 가능이거나 전부 AI 불가능인 직업이 있다. 공고에서는 거의 모든 직업이 두 종류를 함께 올린다. 저자는 연결 오류가 직업을 흔한 과업 쪽으로 끌어당겨 공고 노출도 분포를 압축했을 가능성도 적는다. 그림만으로는 두 설명을 가를 수 없다고 쓴다(20쪽).
공고 노출도는 엘룬두 외와 펠튼 외의 공개 지표와 순위상관 0.84–0.91이다. 톰린슨 외(Tomlinson et al., 2025)의 AI 적용 점수와는 0.65다(21쪽). 공고 빈도가 과업 중요도를 반영하는지도 본다. 692개 직업에서 공고 빈도와 O*NET 과업 중요도의 직업 안 순위상관 중앙값은 0.38이다. 90%의 직업에서 양수다. 이 비교는 직업 자기 목록에 있는 과업, 곧 언급의 약 10%에만 가능하다. 목록 밖 90% 연결의 정확도는 이 검사로 알 수 없다(21쪽).
직업별 압력 (§4)
직업 압력은 카탈로그 노출도와도 순위상관 −0.37이다(표 2 패널 B). 표 3 패널 B의 네 직업은 공고 노출도가 72.4에서 82.8, 90.4, 92.1로 오른다. 압력은 같은 순서로 20.0, 14.2, 8.7, 7.3으로 내린다. 남은 AI 불가능 과업 하나하나의 압력은 오른다. 그런 과업의 비중이 더 빨리 준다(21쪽). 고객 서비스 상담원은 고객 맞이에 83의 압력이 걸리지만 직업 압력은 13.9다. 광고된 일 가운데 AI 불가능 비중이 작아서다(22쪽).
직업 압력은 4.2에서 25까지 퍼진다(22쪽). 708개 가운데 317개가 20–25 구간에 있다. 15–20이 167개, 10–15가 133개, 5–10이 82개, 0–5가 9개다(23쪽 표 주). 공고가 많은 직업 가운데 화학 기술자, 소매 도난 방지 전문가, 식품과학 기술자가 약 25로 정점 근처에 있다. 저자는 정점 근처의 점수 차가 작아서 유한한 생산성 이득이 최상위 순서를 바꿀 수 있다고 쓴다(22쪽).
압력이 큰 직업은 공고가 적은 직업에 몰려 있지 않다. 공고 수 2위인 소매 판매원(24.3)과 4위인 소매 판매 감독자(24.4)는 압력 분포의 87번째와 89번째 백분위수다. 낮은 압력은 노출도가 아주 낮거나 아주 높은 직업에서 나온다. 식기세척원(4.7)과 청소원(7.6)은 AI 가능 업무가 적다. 회계사·감사(8.7)와 컴퓨터 시스템 엔지니어(7.3)는 AI 불가능 업무가 적다. 간호사(23.7)와 대형 트럭 운전사(21.8)는 노출도가 중간이라 압력이 높다(22쪽).
| 압력 구간 | 직업 | 공고 (백만 건) | 공고 노출도 | AI 불가능 비중 | 압력 | 순위 (708개 중) |
|---|---|---|---|---|---|---|
| 20–25 | 간호사 | 10.65 | 61.6 | 38.4 | 23.7 | 138 |
| 20–25 | 소매 판매원 | 10.29 | 41.6 | 58.4 | 24.3 | 95 |
| 15–20 | 패스트푸드·카운터 직원 | 5.55 | 23.3 | 76.7 | 17.9 | 399 |
| 15–20 | 일반 유지·보수 기사 | 3.48 | 25.3 | 74.7 | 18.9 | 348 |
| 10–15 | 의료 비서·행정 보조 | 4.54 | 82.8 | 17.2 | 14.2 | 502 |
| 10–15 | 객실 청소원 | 2.75 | 12.7 | 87.3 | 11.1 | 594 |
| 5–10 | 회계사·감사 | 3.37 | 90.4 | 9.6 | 8.7 | 644 |
| 5–10 | 청소원 (객실 청소원 제외) | 3.12 | 8.3 | 91.7 | 7.6 | 665 |
| 0–5 | 식기세척원 | 1.40 | 4.9 | 95.1 | 4.7 | 704 |
| 0–5 | 소프트웨어 품질 보증 분석가·테스터 | 0.86 | 94.9 | 5.1 | 4.9 | 702 |
| 패널 B | 도매·제조 영업 담당자 | 2.58 | 72.4 | 27.6 | 20.0 | 319 |
| 패널 B | 컴퓨터 시스템 엔지니어·설계자 | 2.70 | 92.1 | 7.9 | 7.3 | 670 |
패널 A는 공고 10만 건 이상인 366개 직업에서 고른다. 표준직업분류(Standard Occupational Classification, SOC) 대분류로 묶으면(그림 3, 24쪽) 판매직은 광고된 일의 11.2%, 압력의 13.9%를 가진다. 관리직은 11.0%와 10.4%다. 광고된 일보다 압력 몫이 작은 군은 음식 조리·서빙(7.0%, 6.6%), 컴퓨터·수학(5.4%, 2.3%), 경영·재무(5.1%, 3.0%), 사무·행정(11.3%, 9.7%), 건물·조경 관리(3.4%, 2.2%)다(22쪽).
과업별 압력 (§5)
그림 4(28쪽)는 아홉 직업에서 고른 AI 불가능 과업의 압력을 노출도 순으로 놓는다. 맨 위는 마케팅 관리자(노출도 90.4%)의 ‘마케팅 인력 지휘·평가’다. 맨 아래 줄은 청소원과 식기세척원(8.3%, 4.9%)의 ‘바닥 청소’와 ‘설거지’다. 고객 맞이는 고객 서비스 상담원, 소매 판매원, 패스트푸드 직원의 세 줄에 나온다. 저자는 이 그림이 순위가 아닌 예시라고 적는다.
그림 5(29쪽)는 고객 맞이 과업 하나를 따라간다. 이 과업은 708개 중 667개 직업의 공고에 나온다. 패널 A는 이 과업을 가장 자주 올린 24개 직업이다. 이 24개가 이 과업 공고의 84%를 차지한다. 압력은 객실 청소원 13, 패스트푸드 직원 23, 계산원 37, 소매 판매원 42, 접수원 65, 고객 서비스 상담원 83이다(25쪽). 패널 B는 이 과업 공고 전체를 5포인트 압력 구간별로 나눈다. 공고 가중 평균은 41이다. 압력 20 미만 직업과 80 초과 직업에 각각 약 4%가 있다.
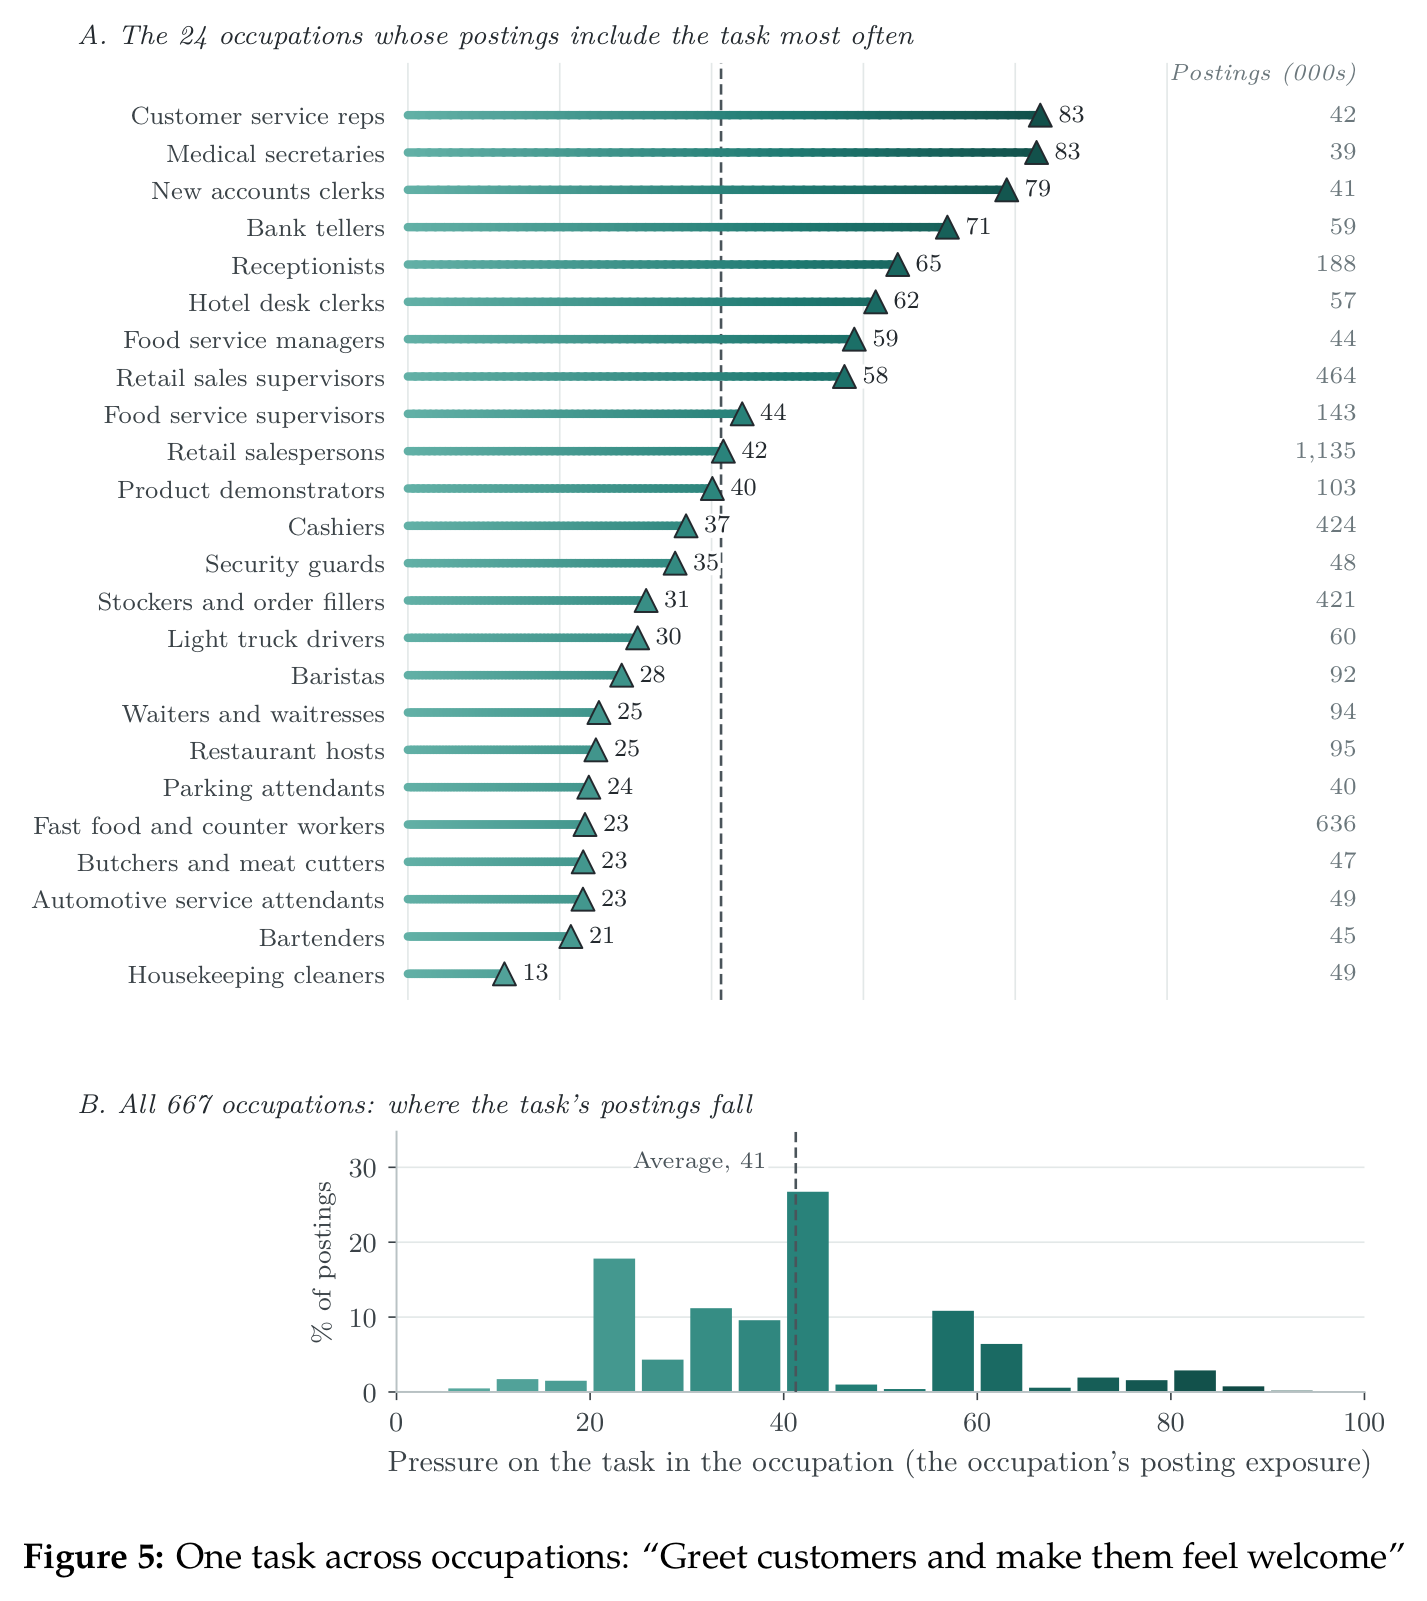
평균 41은 언급 1,000회 이상인 AI 불가능 과업 가운데 약 58번째 백분위수다(25쪽). 고객 맞이는 708개 중 650개 이상 직업의 공고에 나오는 ‘범용 문장’ 59개 가운데 하나다(27쪽). 계산원과 소매 판매원에게는 핵심 업무다. 다른 직업에서는 상투 문구일 수 있다. 저자는 이 이유로 범용 문장을 측정에서 빼지 않는다. 범용 문장 59개가 AI 불가능 압력의 약 18%를 나른다.
같은 과업 안의 변동
모형에서 AI 불가능 과업의 압력은 직업 노출도 그 자체다. 53.2%라는 몫은 같은 과업 문장이 노출도가 다른 여러 직업의 공고에 올라온다는 관측에서 나온다. 범용 문장이나 점검한 두 문장을 빼도 이 몫은 49–53%다. 중간 신뢰 연결을 넣으면 58%다. 열 개 이상 직업에서 각각 1,000회 이상 올라온 과업으로 좁히면 56%다(25쪽). 직업 자기 목록의 과업만 쓰면 이 몫은 0.3%로 떨어진다. 카탈로그 과업 문장은 대개 한 직업에만 속하기 때문이다.
패턴은 소수 과업에 몰려 있지 않다. 열 개 이상 직업이 올린 AI 불가능 과업 가운데 12%는 공고 노출도 하위 25% 직업과 상위 25% 직업 양쪽에서 각각 1,000회 이상 올라온다. 이 과업들이 언급의 58%를 차지한다(26쪽). 저자가 적은 약점도 있다. 연결 파이프라인이 서로 다른 업무를 같은 O*NET 문장에 묶으면 이 몫이 부풀어 오른다. 위 점검들은 그런 오류를 검사하지 않는다(26쪽).
압력을 받는 일의 종류
그림 6(30쪽)은 AI 불가능 과업–직업 쌍을 압력 5분위로 나눈다. 분위마다 AI 불가능 공고 언급의 약 1/5이 들어간다. 일의 종류는 O*NET의 과업 → 세부 업무 활동 → 일반 업무 활동 연결로 정한다.
| 분위 (압력 범위) | 물리·기계 | 대인·감독 | 정보·인지 |
|---|---|---|---|
| Q1 (4.9–23.4) | 75 | 17 | 8 |
| Q2 (23.7–31.7) | 69 | 21 | 10 |
| Q3 (32.1–44.9) | 50 | 35 | 15 |
| Q4 (45.1–61.6) | 39 | 47 | 14 |
| Q5 (61.6–95.6) | 27 | 54 | 19 |
범용 문장 59개를 뺀 뒤 분위를 다시 나눠도 몫은 최대 2.9%포인트 움직인다. 점검한 두 문장을 빼면 최대 1.1%포인트다(26쪽). 광고된 일과 견주면 관계 업무는 광고된 일의 1.5%인데 압력의 4.0%를 가진다. 문서화는 광고된 일의 7.8%인데 압력은 0.5%다(5쪽). 그림 6의 분위는 결국 직업을 노출도 순으로 줄 세운다(30쪽 그림 주). 노출도가 높은 직업일수록 남은 AI 불가능 업무에서 대인·감독 업무의 몫이 크다는 뜻이다.
압력이 가장 큰 과업
표 4(31쪽)는 두 순위를 낸다. 패널 A는 전체 압력 기여 순이다. 650개 미만 직업에 나온 과업만 넣는다. 1위 ‘다른 보건 의료 전문가와 협업’은 372개 직업, 공고 269만 8천 건, 평균 압력 60.1, 전체 압력의 0.682%다. 2위 ‘보관 구역과 카트를 채우고 청결히 유지’는 0.565%다. 판매장 업무, 고객 요구 파악, 상품 진열이 뒤를 잇는다. 상위 과업은 수백 개 직업에서 수백만 번 올라온다. 평균 압력은 39–61이다(27쪽).
패널 B는 공고 5만 건 이상 과업의 평균 압력 순이다. 1위 ‘고객과 데이터 표현 요구 논의’가 89.9다. ‘설계 해법 구현·시험’(87.9)과 ‘법률 보조원 감독’(84.3)이 이어진다. 상위 10개의 평균 압력은 83.4–89.9다. 각 과업은 공고가 적어서 전체 압력 몫이 0.18%를 넘지 않는다. 대부분 고노출 전문직 안의 감독·조정·고객 업무다. 두 목록은 겹치지 않는다. 순위에 오른 고유 과업 192개 중 163개(85%)는 그 과업을 가장 많이 올린 직업의 O*NET 목록에 없다(27쪽).
강건성 점검 (§6)
과업 순위는 대부분의 점검에서 버틴다. 직업 상위 20개 목록과 직업 순위의 방향은 AI 가능 판정 기준과 연결 규칙에 따라 흔들린다.
| 대안 | 직업 | 과업 |
|---|---|---|
| 중간 신뢰 연결 추가 | 0.987 | 0.973 |
| 2018–2021 대 2022–2026-06 (두 기간끼리 비교) | 0.984 | 0.978 |
| 인력 파견업체 공고 포함 | 1.000 | 0.999 |
| 공고를 고정 해시로 반분 (두 절반끼리 비교) | 1.000 | 1.000 |
| 엄격 불가능: GPT-4와 사람 평가가 일치 | 0.905 | 0.994 |
| 엄격 불가능: 세부 업무 활동의 모든 과업이 불가능 | 0.423 | 0.943 |
| 범용 문장 59개 제외 | 0.971 | 0.999 |
| 판정 기준 GPT-4 α (직접 노출만) | −0.146 | 0.806 |
| 판정 기준 GPT-4 β | −0.220 | 0.993 |
| 판정 기준 사람 평가자 | −0.335 | 0.790 |
상위권은 쉽게 바뀐다. 중간 신뢰 연결을 넣으면 상위 20개 중 9개가 남는다(32쪽). 사람 평가 일치 규칙은 AI 불가능 언급의 87%를 남기는데도 상위 20개 중 1개만 남는다. 범용 문장을 빼도 1개만 남는다(34쪽). 기준선에서 압력이 25.0으로 반올림되는 직업이 31개다. 더 넓은 상위 71개는 버틴다. 중간 신뢰 연결에서 64개, 범용 문장 제외에서 55개가 남는다. 기준선 상위 20개는 두 경우 모두 압력 24를 넘는다(32·34쪽).
세부 업무 활동 규칙은 AI 불가능 언급의 39%만 남긴다. 고객 관계 개발과 고객 맞이가 이때 빠진다. 저자는 이 규칙을 과업 평가에 반하는 증거로 읽지 않는다. 불가능 과업 집합을 얼마나 좁힐 수 있는지 보는 시험으로 읽는다(34쪽). 공고 반분 점검은 같은 고용주나 같은 양식의 공고가 양쪽 절반에 들어갈 수 있다. 이 점검은 고용주 구성 변화에 대한 강건성을 보이지 못한다(32쪽).
연결 오류 시험은 조건부다(35쪽). 오류가 AI 가능 판정을 얼마나 바꾸는지 추정한 값은 아직 없다. 저자는 직업 언급의 일정 몫이 전체 언급 풀(AI 불가능 42.9%)에서 섞여 들어왔다고 가정한다. 무작위 오류라면 오류율이 기준 오류율의 3배를 넘어도 직업 순위상관이 0.99다. 저자도 이 안정성의 상당 부분이 구조상 정해져 있다고 쓴다. 모든 오류가 AI 불가능 과업에만 몰리는 극단에서 오류율 20%면 순위상관은 0.80이다. 수준값은 더 약하다. 무작위 오류율 20%에서 평균 압력은 17.8에서 14.3으로 떨어진다(부록 표 D.5).
판정 기준을 바꾸면 직업 순위의 방향이 뒤집힌다. 좁은 기준은 직업 노출도를 낮추거나 그대로 둔다. 직업은 혹의 꼭대기에 가까워지거나 멀어진다. 이 이동이 압력 순서를 바꾼다(35–36쪽). 과업 순위는 상대적으로 버틴다. 넓은 기준에서 불가능한 과업은 α·β에서도 불가능하다. 바뀌는 것은 주변 직업의 노출도뿐이다. 저자는 지수가 기술 평가에 상대적인 값이므로 다른 평가로 다시 계산할 수 있다고 쓴다(36쪽). ‘같은 과업, 다른 압력’ 패턴은 점검을 대부분 통과한다. ‘어느 직업이 압력 1위인가’는 판정 기준에 따라 바뀐다.
논문이 밝힌 한계 (§7)
공고는 고용주가 지원자에게 보내는 신호다(36쪽). 노동자의 시간 배분, 가장 많이 하는 과업, 쓰는 기술을 기록하지 않는다. 고용주는 너무 당연한 업무를 적지 않을 수 있다. 특이하거나 매력적인 업무를 강조할 수도 있다. AI 불가능 비중은 근무 시간의 비중으로 읽을 수 없다. 광고된 일의 비중이다(37쪽).
AI 불가능 언급의 82%는 AI 가능 과업도 적힌 공고에 있다(37쪽). 두 업무가 한 공고에 있어도 한 사람이 둘 다 한다는 증거는 되지 못한다. 시간 배분과 생산 보완성도 공고로는 알 수 없다. 판정 기준은 기술 하나를 한 시점에 한 번 평가한 이진값이다. 기준 아래라는 판정이 AI가 전혀 돕지 못한다는 뜻은 아니다. 로봇처럼 이 평가가 다루지 않는 기술은 여기서 AI 불가능인 일도 자동화할 수 있다(37쪽).
등급 평가를 써도 지수가 (1 − βt)Eo로 단순해지지 않는다. 그때 순위는 σ와 ρ에 기대게 된다(37쪽). 연결 점검은 고른 두 문장만 봤다. 무작위 표본이 아니라서 전체 연결 오류율을 정할 수 없다. 비슷한 오류가 다른 곳에 남아 있을 수 있다(38쪽). 연결은 과업 문장을 비교한다. 밑에 깔린 업무가 직업 사이에서 같다는 증명은 되지 못한다. 공고를 엉뚱한 직업에 배정하는 오류는 별도 경로다.
측정은 한 직업 안 과업 사이의 보완성에서 오는 병목만 잡는다(38쪽). 공급망을 따라 생기는 병목은 정의상 놓친다. 다른 직업에 놓인 보완 역할 사이의 병목도 놓친다. 기업이 과업을 다시 나누거나 직무를 다시 그리면 압력은 팀 구성과 전문화로 나타날 수 있다. 모형에서 통합 정도는 AI 이득의 크기로 들어간다. 직업마다 통합 정도가 다르면 순위가 바뀔 수 있다.
통합이 성공하면 남은 일의 압력은 오른다. 압력 상승은 통합 실패보다 통합 성공의 신호일 수 있다(38쪽). 과업 묶음은 고정이다. 사라지는 과업은 지수 밖에 있다. AI가 새로 만드는 과업도 지수 밖에 있다(애쓰모글루·레스트레포 2019, 오터 외 2024). 저자는 새 과업의 출현을 다음 연구 과제로 남긴다(39쪽).
결론과 미니 보몰 효과 (§8)
결론은 고객 맞이의 23 대 83을 다시 든다. 83은 23의 3.5배를 넘는다(39쪽). 저자는 직무 안 과업들이 총보완재(gross complements)라면 AI가 할 수 있는 과업이 빨라질수록 못 하는 과업이 직무 안 노동의 더 큰 몫을 흡수할 수 있다고 쓴다. 보몰(Baumol, 1967)과 아기옹·존스·존스(Aghion, Jones and Jones, 2019)를 따라 이를 ‘미니 보몰’ 효과라고 부른다. 직무가 새 과업을 떠맡을 가능성도 함께 둔다. 저자는 둘 다 열린 실증 문제라고 쓴다. 마지막 제안은 병목 압력을 노출도와 함께 보고하자는 것이다(40쪽).
2026-11-09 개정판의 추가 결과
스레드가 올라온 지 19일 뒤인 2026-11-09에 SSRN의 논문은 130쪽 개정판으로 바뀌었다. 기존 절의 주요 수치는 그대로다. 새 §6 ‘사용량 보정 압력’이 들어간다. 강건성·논의·결론은 §7–§9로 밀린다. 부록 F ‘시간에 따른 변화’와 부록 G ‘사용량 보정 압력’이 붙는다.
| 결과 | 값 | 위치 | 개정판이 단 단서 |
|---|---|---|---|
| 직업 자기 목록의 과업만 쓸 때 같은 과업 안 변동 몫 | 0.3% | 초록, §5 | 2026-10-21 판 본문(5·25쪽)에 이미 있던 값이 초록으로 올라왔다. |
| 같은 직업에서 시니어 공고(경력 7년 이상)와 주니어 공고(0–3년)의 같은 AI 불가능 과업 압력 차 | 2026 상반기 약 4포인트, 6.5% (95% 구간 2.5–5.6포인트) | §5 ‘직업 안 연차’, 그림 7, 부록 그림 F.1 | 4포인트 중 2.5포인트(62%)는 주니어 공고에 많은 손으로 하는 물리 업무에서 온다. 신용 분석·회계·재무 상담에서는 방향이 반대다. 2022년 1.6에서 2026 상반기 4.0으로 오른 폭은 대형 고용주를 빼면 절반쯤이다. 같은 258개 직업에서 계속 공고를 낸 고용주만 보면 상승 폭은 0.2포인트다. 같은 직업의 전체 고용주로는 0.4포인트다. |
| 직업 평균 압력의 변화 | 2018년 17.6 → 2026 상반기 18.7 (약 6%) | §8 ‘시간에 따른 변화’, 부록 그림 F.3 | 상승의 약 3/4은 언급이 저압력 직업에서 빠져나간 구성 변화다. 2021년 직업 가중을 고정하면 17.9에서 18.1로 거의 그대로다. |
| 2022년 이후 공고 증가 | 압력이 높은 직업이 최저 사분위보다 약 11로그포인트 더 늘었다. 2021년 압력 1표준편차당 5.11로그포인트 (표준오차 1.25) | §8, 부록 표 F.2·F.3 | 2022년 이전에도 차별 추세가 있었다. 저자는 AI 효과가 아닌 예측으로 제시한다. 직업 단위 AI 불가능 비중 검정은 노출도 쪽을 지지한다. |
| 관측된 AI 사용을 함께 넣은 공고 증가 회귀 | 압력 계수: Claude 사용 포함 4.95 (1.24), ChatGPT 사용 포함 4.70 (1.26) | §8 ‘압력과 관측된 AI 사용’ | 사용 지표의 계수는 음수다. 세다이(Sedai, 2026)의 결과와 같은 방향이다. |
| 사용량 보정 압력의 같은 과업 안 변동 몫 | Claude 기준 61%, ChatGPT 기준 56% | §6, 부록 G | Anthropic Economic Index(2026년 4–5월, 과업 단위)와 OpenAI Signals(2026년 2분기, 활동 단위)를 쓴다. Claude 기준으로 AI 가능 업무의 81%가 사용 기준에 못 미친다. 직업 순위는 기준선과 순위상관 −0.34(Claude)로 바뀐다. 저자는 사용이 곧 통합은 아니라고 쓴다. |
개정판은 2026-10-21 판에 없던 직접 검정 하나를 더한다. 직무 안 총보완성 아래 모형은 같은 AI 불가능 과업이 노출도 높은 직업에서 공고 몫을 늘린다고 예측한다. 개정판은 이 예측을 공고로 검정한다. 결과는 ‘부정확한 영(imprecise nulls)’이다. 저자는 기제를 확인하거나 기각하려면 연구가 더 필요하다고 쓴다(개정판 §8, 부록 표 F.1).
개정판 초록에서는 세 문장이 빠졌다. ‘AI 노출도 지표는 AI가 할 수 있는 일을 묻는다’로 여는 대비 문장이 빠졌다. 직업 압력이 반반에서 정점이라 노출도와 다르게 순위를 매긴다는 문장도 빠졌다. 압력이 오를수록 대인·감독 업무 몫이 커진다는 문장도 빠졌다. 마지막 문장에서는 ‘AI가 일을 할 수 있는 범위’를 보여 준다는 부분이 빠졌다. 빠진 두 결과는 개정판 본문과 결론(§9)에 그대로 있다.
댓글의 질문과 논문의 답
댓글 가운데 측정 밖을 겨눈 반론은 임금 문제다. 계정 @relativityofai는 2026-10-22 10:12 UTC에 프랑스어로 이렇게 썼다. “더 값진 과업이 반드시 더 많이 받는 노동자를 뜻하지는 않는다. 이 압력을 노동자의 대체 가능성과 협상력에 교차시키면 가치 창출과 그 몫을 가져가는 능력을 가를 수 있다.” 논문은 비용 비중을 노동 비중으로 읽으려고 경쟁 가격과 직업 안 공통 임금을 가정한다(9쪽). 지수가 줄 세우는 것은 한계가치의 변화율이다. 그 변화가 임금으로 갈지 고용으로 갈지는 노동 이동성에 달렸다(14쪽). 두 판 모두 협상력이나 실제 임금을 재지 않는다. 이 반론은 측정 밖에 남는다.
계정 @pratduvvuri는 2026-10-22 16:34 UTC에 팀 사이 병목을 들었다. 코딩 에이전트가 보안 검토보다 빨리 변경을 만들면 보안 팀의 밀린 일만 는다는 예다. 저자는 “좋은 지적”이라고 답했다. 논문은 다른 직업에 놓인 보완 역할 사이의 병목을 정의상 놓친다(38쪽). 계정 @doing_ai_well은 2026-11-22에 직무가 새 과업을 떠맡는 문제를 분석했는지 물었다. 두 판 모두 이 문제를 열린 질문으로 남긴다(39–40쪽).
남은 질문
남은 미지는 가정 1이 실제 직무에서 성립하는가다. 두 판의 수치는 모두 이 가정 위에서 ‘가치가 오를 자리’로 읽힌다. 개정판 서론은 AI를 도입한 고용주와 도입하지 않은 고용주를 비교하는 검정을 다음 시험으로 꼽는다.
팩트체크
신뢰도 B
수치와 식은 논문 원문 그대로다. 'AI가 아직 못 하는 일'이라는 이름은 2023년 초기 GPT-4의 '작업 시간 절반 단축' 판정을 넓게 부른 것이다. 2억 8,800만 건, 약 90%, 약 53%와 반반 정점 식은 2026-10-21판 PDF와 같다. 원 루브릭의 이름은 노출도(exposure)다. 스레드는 같은 등급을 '실행 가능성(feasibility)'으로 부른다. 2026-11-09 개정판은 세 수치를 그대로 두었다. 정점·순위 문장과 대인·감독 업무 문장은 개정판 초록에서 빠져 본문 결론에만 남았다.
판정 기호 — ✅ 사실: 출처 원문이 주장을 그대로 받친다 · 🟡 부분사실: 핵심은 맞지만 수치·표현 일부가 출처와 다르거나 일부만 확인된다 · ⚠️ 불확실: 열람한 출처로 참·거짓을 정할 수 없다 · ❌ 거짓: 출처가 주장과 반대다
판정 32건 — ✅ 29 · 🟡 3 · ⚠️ 0 · ❌ 0
논문 서지
게시물 1·이미지: 논문 제목은 「Technology Bottlenecks: Measuring Where AI Could Raise the Value of Work It Cannot Yet Do」다
근거: SSRN 초록 페이지 제목과 2026-10-21판 PDF 표지 제목이 같다. 2026-11-09 개정판도 제목을 바꾸지 않았다.
이미지 1: 저자 Soumitra Shukla의 소속은 버닝글래스연구소(Burning Glass Institute)다
근거: 2026-10-21판 PDF 표지 각주가 소속을 "Burning Glass Institute"로 적는다. 연락 주소도 그 연구소 도메인이다. SSRN 저자란과 저자 개인 홈페이지도 같은 소속을 적는다. 연구소 웹사이트 소개 페이지에는 연구진 이름이 없다.
이미지 1: 논문 날짜는 2026-10-21이다
근거: 2026-10-21판 PDF 표지 날짜가 "October 21, 2026"이다. SSRN의 작성일(Date Written)도 2026-10-21이다. 개정판 PDF 표지 날짜는 2026-11-09다.
이미지 2: 논문은 2026-10-13 SSRN에 처음 올라왔다
근거: SSRN 페이지에 "Posted: 13 Oct 2026"이 있다. SSRN 게시는 스레드(2026-10-21)보다 8일 앞선다. 이미지 속 '104쪽, 최종 수정 2026-10-21'은 그 뒤 개정으로 바뀌었다. 2026-11-23 기준 페이지는 130쪽, 최종 수정 2026-11-09다. 104쪽은 2026-10-21판 PDF 분량과 맞는다. 표지 1쪽에 본문 쪽번호가 103까지 간다. 키워드 6개는 현재 페이지와 같다.
데이터와 평가 기준
게시물 1: 기존 AI 노출도 지표는 AI가 할 수 있는 일을 묻는다
근거: Eloundou 등 arXiv 초록은 직업을 대규모 언어모델(large language model, LLM)의 역량과 얼마나 맞는지로 평가한다고 적는다. 논문 1절도 노출도 지표를 AI가 수행할 수 있는 과업을 평가하는 표준 도구로 소개한다.
Eloundou·Manning·Mishkin·Rock, arXiv 2303.10130 초록, 2023-03-17 첫 공개
게시물 1: 미국 구인공고 2억 8,800만 건을 쓴다
근거: 논문 3.1절. 자료는 버닝글래스연구소(BGI)가 중복을 걸러 정리한 미국 구인공고다. 기간은 2018-01부터 2026-06까지다. 인력파견 업체 공고와 수록 범위가 고르지 않은 대형 구인 사이트 1곳은 뺐다. 필터를 거친 784개 직업 3억 2,120만 건 가운데 노출도 점수가 있는 708개 직업의 2억 8,830만 건이 분석 표본이다.
게시물 1: 공고를 한 줄씩 가장 가까운 O*NET 과업에 대응시켰다
근거: 논문 3.1절. 대응 대상은 직무 책임으로 분류된 줄뿐이다. 임베딩 분류기가 줄마다 미국 노동부 직업정보 데이터베이스(O*NET) 과업 문장 후보 2개를 고른다. 높은 신뢰 기준을 넘은 1순위만 남긴다. 원문 '2억 8,800만 건을 한 줄씩 대응' → 확인 '3억 2,120만 건 중 19.9%는 대응된 과업이 0개라 지표에 들어가지 않는다'. 분류 알고리즘은 공개되지 않았다.
게시물 1: 인용한 Eloundou 등(2024)은 실재하는 논문이다
근거: Crossref 서지 기록. Eloundou·Manning·Mishkin·Rock, "GPTs are GPTs: Labor market impact potential of LLMs", Science 384(6702): 1306–1308, 2024-06-21 발행. Science 판 초록은 한 문장이다. 등급 루브릭 전문은 2023년 arXiv 판에 있다.
게시물 1: Eloundou 등(2024)의 GPT-4 등급은 '실행 가능성(feasibility)' 등급이다
근거: Eloundou 등 arXiv 판 3절과 부록 A.1. 원 루브릭의 이름은 노출도(exposure)다. E1은 LLM만으로 같은 품질의 작업 시간을 절반 이상 줄이는 과업이다. E2는 LLM 위에 얹을 소프트웨어를 "쉽게 상상할 수 있으면" 절반 이상 줄이는 과업이다. 원저자는 E1+E2를 노출도의 상한(upper bound)이라 부른다. 원문 'GPT-4 실행 가능성 등급' → 확인 '시간 절반 단축 기준의 GPT-4 노출도 등급 E1+E2'. 논문 본문 1·3.1·7절은 이 기준을 그대로 옮겨 적는다. 기준 아래라도 AI가 도움을 줄 수 있다는 단서도 7절에 있다.
게시물 1·제목: 측정 대상은 'AI가 아직 못 하는 일'이다
근거: Eloundou 등 arXiv 판 3절. GPT-4 등급은 초기 버전 GPT-4에 루브릭을 적용해 얻었다. arXiv 첫 공개는 2023-03-17이다. 논문 7절도 이 등급을 한 시점에 한 기술을 평가한 단일 판정이라 적는다. 원문 'AI가 아직 못 하는 일' → 확인 '2023년 초기 GPT-4가 같은 품질로 시간을 절반 줄이지 못한다고 판정한 과업'. 루브릭은 사람과의 상호작용이 큰 과업을 E0로 분류하라고 지시한다. 로봇 같은 다른 기술은 등급 범위 밖이다.
모형과 수치
게시물 1: AI로 할 수 없는 과업이 받는 압력은 그 과업을 게시한 직업의 노출도와 같다
근거: 논문 2절 식 (3) Bot = (1 − Ft) × Eo. AI 불가능 과업은 Ft = 0이므로 지수가 직업 노출도 Eo와 같다. 그림 6 주석도 같은 문장을 쓴다. 이 지수는 과업 기반 생산 모형을 1차 근사해 얻은 순위 지표다. 직업 안 과업끼리의 보완성이 직업 사이보다 강해야 한다(σ < ρ). 탄력성과 AI 이득은 직업마다 같다고 둔다. 압력의 크기는 지수에 들어 있지 않다(부록 A).
게시물 1: 같은 과업도 직업에 따라 압력이 크게 다르다
근거: 논문 2절과 그림 1. '고객을 맞이하고 환영받는 느낌을 준다'는 과업은 두 직업 모두에서 AI 불가다. 압력은 패스트푸드 직원에서 23, 고객 상담원에서 83이다. 이 과업은 708개 직업 가운데 667개 직업의 공고에 나온다.
이미지 1: 직업 단위 압력은 노출도와 AI 불가능 업무 비중의 곱이다
근거: 논문 2절 식 (4) Bo = Eo × So. 두 비중을 같은 과업·가중치·등급으로 재므로 So = 1 − Eo다. 직업 압력은 Eo(1 − Eo)로 노출도 하나에서 정해진다.
이미지 1: 대응된 과업 언급의 약 90%가 그 직업의 O*NET 과업 목록 밖에 있다
근거: 논문 3.1절. 등급이 붙은 과업 언급 가운데 8.6%가 그 직업의 핵심 과업, 1.2%가 보조 과업에 대응한다. 90.1%는 목록 밖이다. AI 불가능 언급만 보면 89.4%다. 논문은 목록 밖 언급이 새 업무를 뜻하지는 않는다고 적는다. 그 비율에는 대응기의 검색 범위도 반영된다.
이미지 1: AI 불가능 업무의 압력 변동 중 약 53%는 같은 과업 안, 직업 사이에서 나온다
근거: 논문 표 2 A8행 53.2%. AI 불가능 과업 7,485개 전체를 언급 수로 가중한 분산 분해다. 직업 자체 목록의 과업만 쓰면 이 비율은 0.3%로 떨어진다(1절). 3.1절은 대응 오류가 서로 다른 업무를 한 과업 문장으로 묶으면 이 비율이 커질 수 있다고 적는다.
이미지 1: 직업 압력은 공고 업무가 AI 가능·불가로 반반 나뉠 때 가장 크다
근거: 논문 2절. Eo(1 − Eo)는 양 끝에서 0이다. 노출도 0.5에서 정점이다. 최댓값은 0.25, 0–100 척도로 25다. 708개 직업의 압력은 4.2부터 25까지 분포한다(4절).
이미지 1: 반반에서 정점이 생기므로 압력은 노출도와 다른 순서로 직업을 줄 세운다
근거: 논문 2절과 표 2 B행. 압력과 공고 노출도의 순위 상관(Spearman)은 −0.43이다. 목록 노출도와는 −0.37이다. 이 차이는 식에서 바로 나온다. 노출도가 같은 두 직업은 압력도 늘 같다. 직업 단위 순위는 노출도를 0.5 지점에서 접은 값이다.
이미지 1: 압력이 높은 구간일수록 대인·감독 업무 비중이 크다. 신체 업무 비중은 작다
근거: 논문 그림 6. 과업 압력 최하위 5분위에서 신체·기계 업무는 압력의 75%, 대인·감독 업무는 17%를 차지한다. 최상위 5분위에서는 27%와 54%다. AI 불가능 과업의 압력은 직업 노출도와 같으므로 5분위는 직업을 노출도 순으로 가른 셈이다. 같은 판 5절은 단서를 하나 단다. 감독 업무의 압력이 높다고 그 수요가 늘어난다는 뜻은 아니다.
단서와 감사의 글
게시물 2(PS): 이 지표는 잠재 압력이다. 실제로 나타나는지는 기업의 AI 통합에 달렸다
근거: 논문 1절 끝과 7절. 논문은 압력을 잠재 압력으로 정의한다. AI 가능 과업이 실제로 빨라진다는 가정도 둔다. 실제 속도 향상은 조직 안 AI 통합과 유인에 달렸다고 적는다. 7절은 지수가 임금·고용·도입을 예측하지 않는다고 적는다.
게시물 2(PS): 통합 병목을 재는 일은 후속 연구로 남는다
근거: 2026-10-21판 7절은 통합 여부까지 요구하는 기준으로 지수를 다시 정의할 수 있다는 방향만 적는다. 2026-11-09 개정판은 Claude·ChatGPT 사용 데이터(Anthropic Economic Index, OpenAI Signals)를 들여왔다. 개정판은 이를 통합 병목으로 가는 첫걸음이라 부른다. 사용 기록이 있는 과업만 AI 가능으로 셀 때도 과업 단위 결과는 유지된다(개정판 초록).
게시물 3: 감사 인사를 받은 경제학자 6명은 논문 감사의 글에 있다
근거: 2026-10-21판 표지 각주. 감사 명단 20명 안에 Acemoglu·Autor·Goldfarb·Imas·Rock·Stansbury가 모두 있다. 각주는 Anders Humlum을 이 연구의 출발점이 된 멘토로 따로 적는다. 연구 보조로 Claude Opus 5.5와 GPT-6 Astra를, 검토로 refine.ink를 적는다. 개정판 명단은 31명이다.
개정판 대조
개정판 대조: 2억 8,800만 건·약 90% 수치는 2026-11-09 개정판 초록에도 그대로 있다
근거: SSRN 현재 초록. 기간 '2018년부터 2026년 중반'이 초록에 새로 들어갔다. '가장 가까운(closest)'이라는 낱말은 빠졌다. 개정판 3.1절의 2억 8,830만 건과 90.1%도 이전판과 같다.
개정판 대조: 약 53% 수치는 개정판 초록에도 있다. 목록 과업만 쓰면 0.3%라는 비교가 새로 붙었다
근거: SSRN 현재 초록. 개정판 초록에는 새 결과가 넷 붙었다. 같은 직업 안에서 시니어 공고의 AI 불가능 과업이 주니어 공고보다 압력이 높았다(2026년 상반기 6.5%). 직업 평균 압력은 6% 올랐다. 압력이 높은 직업일수록 2022년 이후 공고가 빨리 늘었다. 사용 기록으로 AI 가능 기준을 좁혀도 과업 단위 결과가 유지된다.
개정판 대조: 정점·순위 문장과 대인·감독 업무 문장은 개정판 초록에서 빠졌다. 본문 결론에는 남았다
근거: 2026-11-09 개정판 PDF 9절 결론에 두 문장이 같은 문구로 있다. 4절의 순위 상관 −0.37·−0.43과 그림 6의 5분위 비중도 이전판 수치 그대로다.
인용 인물과 고전 문헌
맥락: Ronnie Chatterji는 OpenAI 수석 이코노미스트다
근거: 그의 인용 게시물(2026-10-22)에 붙은 X 소개란이 "Chief Economist @OpenAI & Distinguished Professor @DukeFuqua"다. CNBC 2024-10-28 기사는 OpenAI가 2024-10-22 그를 첫 수석 이코노미스트로 임명했다고 전한다.
맥락: Daniel Rock은 Google AI x Economy 프로그램 공동 리드다
근거: 뉴욕 연방준비은행 행사 페이지(2026-09-24)가 그를 Google AI x Economy Research Program 공동 리드·디렉터로 소개한다. Rock은 이 논문이 쓰는 GPT-4 등급의 출처인 Eloundou 등(2024)의 공저자다. 이 논문 감사의 글에도 이름이 있다.
맥락: Andy Hall은 Anthropic에서 일한다
근거: Andy Hall의 Substack 글(2026-08-26) 저자 소개가 The Anthropic Institute에서 초지능의 정치경제를 연구한다고 적는다. 스탠퍼드 교수직은 휴직 중이다.
맥락: Daron Acemoglu는 2024년 노벨 경제학상 수상자다
근거: 스웨덴 왕립과학원 보도자료(2024-10-14). 2024년 경제학상은 Daron Acemoglu, Simon Johnson, James A. Robinson이 함께 받았다.
맥락: 논문이 기대는 Baumol(1967) 비용병 논문은 실재한다
근거: JSTOR 서지. William J. Baumol, "Macroeconomics of Unbalanced Growth: The Anatomy of Urban Crisis", American Economic Review 57(3): 415–426, 1967-06. 논문은 이 글을 '미니 보몰(Baumol) 효과'의 근거로 인용한다.
맥락: 논문이 기대는 Kremer(1993) O-링 이론 논문은 실재한다
근거: Crossref 서지 기록. Michael Kremer, "The O-Ring Theory of Economic Development", Quarterly Journal of Economics 108(3): 551–575, 1993-08. 논문은 이 글을 약한 고리가 생산을 묶는다는 근거로 인용한다.
답글의 비판
답글(@relativityofai, 2026-10-22): 과업 가치가 오른다고 노동자 임금이 오르는 것은 아니다
근거: 논문 2절 끝. 노동이 과업에 묶여 있으면 차이는 임금에 나타난다. 노동이 과업·직업 사이를 자유롭게 움직이면 차이는 고용 쪽에 나타난다. 그때 노동자 임금은 모두 같다. 논문은 지수가 이런 임금·고용 변화를 추정하지 않는다고 적는다. 노동자 협상력은 논문 본문에서 다루지 않는다.
답글(@doing_ai_well, 2026-11-22): 일자리가 새 과업으로 넓어지는 효과는 논문이 분석하지 않았다
근거: 답글이 인용한 문장은 논문 8절 결론에 그대로 있다. 결론은 이를 열린 실증 질문이라 부른다. 7절은 지수가 이미 있는 과업만 다룬다고 적는다. 기술이 만드는 새 과업은 범위 밖이다. 2026-11-09 개정판도 과업 묶음을 고정한 틀을 유지한다.
원본 (완역)
게시물 1 — 논문 공개 (2026-10-21)
새 논문 “기술 병목: AI가 아직 못 하는 일의 가치를 AI가 어디에서 높일 수 있는지 측정하기(Technology Bottlenecks: Measuring Where AI Could Raise the Value of Work It Cannot Yet Do)”를 공유하게 되어 무척 기쁘다.
AI 노출도(AI exposure) 지표는 AI가 할 수 있는 일을 묻는다. 우리는 그 대신, AI가 직무의 나머지 부분을 빠르게 처리해 줄수록 AI가 아직 못 하는 일의 한계 가치(marginal value)가 어디에서 오를 수 있는지를 묻는다.
이를 위해 우리는 줄 단위로 가장 가까운 O*NET 과업에 대응시킨 미국 채용 공고(job postings) 2억 8,800만 건과 Eloundou et al. (2024)의 GPT-4 실현 가능성 등급(feasibility ratings)을 사용해, 각 과업에 대해 그 과업을 공고하는 직업별로 “병목 압력(bottleneck pressure)”이라는 지표를 만든다.
단순한 과업 기반 틀(task-based framework)을 써서 우리는 이 압력을 과업 수준에서 도출하고, AI 불가능(AI-infeasible) 과업의 경우 이 압력이 곧 그 과업을 공고하는 직업의 노출도임을 보인다. 따라서 같은 과업이라도 직무에 따라 매우 다른 병목 압력을 받을 수 있다.
병목 압력을 AI 노출도와 나란히 보고하면, AI가 일을 수행할 수 있는 범위와, 역량이 커질 때 AI가 못 하는 일을 개선하는 것이 어디에서 더 큰 이득을 낳을 수 있는지를 함께 보여 준다.
이미지 속 글 (번역)
기술 병목: AI가 아직 못 하는 일의 가치를 AI가 어디에서 높일 수 있는지 측정하기∗
Soumitra Shukla†
2026-10-21
초록
AI 노출도 지표는 AI가 할 수 있는 일을 묻는다. 우리는 그 대신, AI가 직무의 나머지 부분을 빠르게 처리해 줄수록 AI가 아직 못 하는 일의 한계 가치가 어디에서 오를 수 있는지를 묻는다. 이를 위해 우리는 줄 단위로 가장 가까운 O*NET 과업에 대응시킨 미국 채용 공고 2억 8,800만 건과 Eloundou et al. (2024)의 GPT-4 실현 가능성 등급을 사용해, 각 과업에 대해 그 과업을 공고하는 직업별로 “병목 압력”이라는 지표를 만든다. 단순한 과업 기반 틀을 써서 우리는 이 압력을 과업 수준에서 도출하고, AI 불가능 과업의 경우 이 압력이 곧 그 과업을 공고하는 직업의 노출도임을 보인다. 따라서 같은 과업이라도 직무에 따라 매우 다른 병목 압력을 받을 수 있다. 직업 수준으로 합산하면, 압력은 노출도와 공고된 일 가운데 AI 불가능한 일이 차지하는 비중의 곱이다. 우리는 노출도와 공고된 과업 구성을 모두 채용 공고에서 측정하는데, 채용 공고에서는 라벨이 붙은 매칭 과업 언급의 약 90%가 공고를 낸 직업 자체의 O*NET 과업 목록 바깥에 있다. AI 불가능 업무에 걸리는 병목 압력의 언급 가중(mention-weighted) 변동 가운데 약 53%는 과업 내부, 직업 간 차이에서 나온다. 직업 압력은 공고된 일이 AI 가능(AI-feasible) 과업과 AI 불가능 과업으로 고르게 반씩 나뉘는 곳에서 가장 높기 때문에, 직업의 순위를 노출도와 다르게 매긴다. 과업 압력이 높아질수록, 그 압력을 떠안는 AI 불가능 업무 가운데 대인 업무와 감독 업무가 차지하는 몫은 커지고 신체 업무의 몫은 줄어든다. 병목 압력을 AI 노출도와 나란히 보고하면, AI가 일을 수행할 수 있는 범위와, 역량이 커질 때 AI가 못 하는 일을 개선하는 것이 어디에서 더 큰 이득을 낳을 수 있는지를 함께 보여 준다.
∗ 이 프로젝트는 Anders Humlum과 나눈 초기 논의에서 출발했다. 그의 멘토링, 이 주제를 연구해 보라는 격려, 그리고 이 지표를 두고 여러 차례 나눈 대화에서 준 조언에 감사한다. 통찰력 있는 의견과 제안을 준 Daron Acemoglu, David Autor, Peter Cappelli, Luke Chen, Andrey Fradkin, Nick Fucci, Avi Goldfarb, Kartik Hosanagar, Anders Humlum, Alex Imas, Bouke Klein Teeselink, Gad Levanon, Simon Löwe, Ioana Marinescu, Daniel Rock, Scott Spitze, Anna Stansbury, Christopher Stanton, Laura Veldkamp, David Yanagizawa-Drott에게 감사드린다. 훌륭한 연구 보조를 해 준 Claude Opus 5.5와 GPT-6 Astra, 그리고 꼼꼼하게 검토해 준 refine.ink에도 감사드린다.
† Burning Glass Institute. 이메일: [email protected].
게시물 2 — 링크와 단서 (2026-10-21)
링크: papers.ssrn.com/sol3/papers.cfm?abstract_id=7605598
추신: 물론 이것은 잠재적 압력을 측정한 것이며, 그 압력이 실제로 나타나는지는 기업이 AI를 자기 업무에 어떻게 통합하느냐에 달려 있다. 이런 통합 병목을 측정하려면 더 많은 연구가 필요하다.
이미지 속 글 (번역)
기술 병목: AI가 아직 못 하는 일의 가치를 AI가 어디에서 높일 수 있는지 측정하기
104쪽 · 게시: 2026-10-13 · 최종 수정: 2026-10-21
Soumitra Shukla
The Burning Glass Institute
작성일: 2026-10-21
초록
AI 노출도 지표는 AI가 할 수 있는 일을 묻는다. 우리는 그 대신, AI가 직무의 나머지 부분을 빠르게 처리해 줄수록 AI가 아직 못 하는 일의 한계 가치가 어디에서 오를 수 있는지를 묻는다. 이를 위해 우리는 줄 단위로 가장 가까운 O*NET 과업에 대응시킨 미국 채용 공고 2억 8,800만 건과 Eloundou et al. (2024)의 GPT-4 실현 가능성 등급을 사용해, 각 과업에 대해 그 과업을 공고하는 직업별로 “병목 압력”이라는 지표를 만든다. 단순한 과업 기반 틀을 써서 우리는 이 압력을 과업 수준에서 도출하고, AI 불가능 과업의 경우 이 압력이 곧 그 과업을 공고하는 직업의 노출도임을 보인다. 따라서 같은 과업이라도 직무에 따라 매우 다른 병목 압력을 받을 수 있다. 직업 수준으로 합산하면, 압력은 노출도와 공고된 일 가운데 AI 불가능한 일이 차지하는 비중의 곱이다. 우리는 노출도와 공고된 과업 구성을 모두 채용 공고에서 측정하는데, 채용 공고에서는 라벨이 붙은 매칭 과업 언급의 약 90%가 공고를 낸 직업 자체의 O*NET 과업 목록 바깥에 있다. AI 불가능 업무에 걸리는 병목 압력의 언급 가중 변동 가운데 약 53%는 과업 내부, 직업 간 차이에서 나온다. 직업 압력은 공고된 일이 AI 가능 과업과 AI 불가능 과업으로 고르게 반씩 나뉘는 곳에서 가장 높기 때문에, 직업의 순위를 노출도와 다르게 매긴다. 과업 압력이 높아질수록, 그 압력을 떠안는 AI 불가능 업무 가운데 대인 업무와 감독 업무가 차지하는 몫은 커지고 신체 업무의 몫은 줄어든다. 병목 압력을 AI 노출도와 나란히 보고하면, AI가 일을 수행할 수 있는 범위와, 역량이 커질 때 AI가 못 하는 일을 개선하는 것이 어디에서 더 큰 이득을 낳을 수 있는지를 함께 보여 준다.
키워드: 인공지능, 과업 보완성, 병목 압력, 직업 노출도, 채용 공고, 노동시장
게시물 3 — 감사의 말 (2026-10-22)
여러 연구자가 초고를 보고 훌륭한 의견을 주었고, 그 의견 덕분에 논문을 여기에 내놓기 전에 더 낫게 다듬을 수 있었다.
특히 @DAcemogluMIT @davidautor @annastansbury @avicgoldfarb @danielrock @alexolegimas에게 감사한다(트위터에 있는 다른 분들을 빠뜨렸다면 진심으로 사과드린다!)
원본 링크·인용
본문 각 자리에 같은 링크가 원래 위치에 있다. 아래는 같은 링크를 한곳에 모은 목록이다.
번역한 원문
- @soumitrashukla9: Very happy to share a new paper, “Technology Bottlenecks…” — X 게시물(스레드 첫 글) · Soumitra Shukla, 2026-10-21 20:05 UTC
- @soumitrashukla9: link: papers.ssrn.com… PS: Of course, this measures potential pressure… — X 게시물(스레드 둘째 글, 이 문서의 입력 URL) · 2026-10-21 20:05 UTC
- @soumitrashukla9: Many researchers saw an early draft… — X 게시물(스레드 셋째 글) · 2026-10-22 22:19 UTC
스레드가 연결한 논문
- Technology Bottlenecks: Measuring Where AI Could Raise the Value of Work It Cannot Yet Do — SSRN — SSRN 초록 페이지 · DOI 10.2139/ssrn.7605598
- Technology Bottlenecks, 2026-10-21 판 PDF (104쪽) — 스레드가 게시될 때의 판본
- Technology Bottlenecks, 2026-11-09 개정판 PDF (130쪽) — 저자 홈페이지의 현재 판
스레드 셋째 글이 언급한 계정
- @DAcemogluMIT — Daron Acemoglu
- @davidautor — David Autor
- @annastansbury — Anna Stansbury
- @avicgoldfarb — Avi Goldfarb
- @danielrock — Daniel Rock
- @alexolegimas — Alex Imas
스레드를 인용한 게시물
- @danielrock: Bottlenecks are the story when it comes to productivity gains… — Daniel Rock, 2026-10-21 20:08 UTC
- @ahall_research: “Bottleneck pressure” seems like a very important thing… — Andy Hall, 2026-10-21 20:28 UTC
- @RonnieChatterji: Many measures of AI exposure ask what AI can do… — Ronnie Chatterji, 2026-10-22 15:17 UTC
팩트체크가 기댄 외부 출처
- Eloundou, Manning, Mishkin, Rock, “GPTs are GPTs” (arXiv 2303.10130) · arXiv 서지 정보 · Science 게재 서지 정보
- Baumol, “Macroeconomics of Unbalanced Growth” (1967) · Kremer, “The O-Ring Theory of Economic Development” (1993) 서지 정보
- 2024 노벨 경제학상 보도자료 · CNBC, 2024-10-28 · 뉴욕 연준 행사 페이지, 2026-09-24 · Andy Hall, Free Systems, 2026-08-26
기타
용어
- 병목 압력(bottleneck pressure)
- AI가 직업의 나머지 일을 빠르게 할 때 AI 불가능 과업의 노동 한계가치가 얼마나 오르는지를 1차 근사로 줄 세우는 지수. 과업 단위 값은 (1 − Ft) × Eo, 0–100 척도다.
- 기술 병목(technology bottleneck)
- 기술이 못 하는 과업 가운데 기술이 하는 과업과 같은 직업에 놓인 과업.
- AI 가능 과업·AI 불가능 과업(AI-feasible / AI-infeasible task)
- 엘룬두 외(Eloundou et al., 2024)의 GPT-4 넓은 기준에서 언어 모델이 보완 소프트웨어를 써서라도 같은 품질로 시간을 절반 이상 줄일 수 있는 과업이 AI 가능이다. 나머지가 AI 불가능이다.
- AI 노출도(AI exposure)
- 직업의 일 가운데 AI 가능 과업의 비중.
- 공고 노출도(posting exposure)
- 그 직업 공고에 연결된 과업 언급 가운데 AI 가능 언급의 비중. 논문의 기준 노출도다.
- 카탈로그 노출도(catalog exposure)
- O*NET이 그 직업에 적어 둔 핵심 과업 가운데 AI 가능 과업의 비중. 과업마다 같은 가중을 준다.
- AI 불가능 비중(AI-infeasible share)
- 직업 공고의 과업 언급 가운데 AI 불가능 언급의 비중. 공고 노출도와 더하면 1이다.
- 직업 압력(occupation pressure)
- 공고 노출도 × AI 불가능 비중. 최댓값은 25다.
- 과업 평균 압력(average pressure)
- 한 과업을 올린 직업들에서 그 과업이 받는 압력의 공고 가중 평균.
- O*NET 과업 문장(O*NET task statement)
- 미국 직업정보망 O*NET이 직업마다 적어 둔 한 줄짜리 업무 서술. 직업 목록 안에서 핵심 과업과 보조 과업으로 나뉜다.
- 세부 업무 활동·일반 업무 활동(detailed / generalized work activity)
- O*NET이 과업 문장을 묶는 더 굵은 단위.
- 과업 언급(task mention)
- 공고 한 건에 과업 문장 하나가 고신뢰로 연결된 기록. 한 공고 안의 같은 과업은 한 번만 센다.
- 언급 가중(mention-weighted)
- 과업 언급 수로 가중한 값.
- 같은 과업 안, 직업 간 변동(within tasks, across occupations)
- 압력 변동 가운데 같은 과업이 직업마다 다른 압력을 받아서 생기는 몫.
- 범용 문장(near-universal statement)
- 708개 직업 중 650개 이상의 공고에 나오는 AI 불가능 과업 문장 59개.
- 직업(occupation)
- O*NET-SOC 세부 직업 코드 하나. 직업군은 표준직업분류(SOC)의 대분류다.
- 총보완재(gross complements)
- 대체탄력성이 1보다 작은 과업 관계. 한 과업이 빨라지면 느린 과업이 비용 몫을 더 가져간다.
- 능력 병목·통합 병목(capability / integration bottleneck)
- 앞의 것은 AI가 기준만큼 빠르게 하지 못하는 과업이다. 뒤의 것은 AI가 할 수 있지만 아직 생산에 붙지 않은 과업이다.
- 미니 보몰 효과(“mini Baumol” effect)
- AI가 할 수 있는 과업이 빨라질수록 못 하는 과업이 직무 안 노동의 더 큰 몫을 흡수하는 현상. 보몰(Baumol, 1967)의 불균형 성장 논리를 직무 안에 옮긴 이름이다.
- 사용량 보정 압력(usage-adjusted pressure)
- AI 가능 판정에 Claude·ChatGPT 사용 기록 조건을 더해 다시 계산한 압력. 2026-11-09 판에만 있다.
판본
스레드가 링크한 판은 2026-10-21 날짜의 104쪽 PDF다. SSRN의 같은 논문 페이지는 2026-11-09 날짜의 130쪽 개정판으로 바뀌었다. 요약의 숫자·절 번호·쪽 번호는 따로 표시하지 않으면 2026-10-21 판을 따른다. 쪽 번호는 PDF 파일의 쪽 번호다. 논문 본문 아래쪽에 인쇄된 번호보다 1 크다. 개정판에서 달라진 결과는 요약의 ‘2026-11-09 개정판의 추가 결과’에 모았다.
범위
번역은 스레드의 게시물 세 개와 첨부 이미지 두 장의 글을 모두 옮긴다. 이미지 한 장은 논문 표지의 초록과 감사 각주다. 다른 한 장은 SSRN 초록 페이지 화면이다. 104쪽 논문 자체는 옮기지 않는다. 요약이 본문 §1–§8을 절마다 다룬다. 부록(45–104쪽)은 본문이 가리키는 곳만 다룬다. 논문은 동료 심사를 거치지 않은 working paper다.