Bell System Technical Journal · 1951
인쇄된 영어의 예측과 엔트로피
다음 글자를 맞히는 실험으로, 영어가 글자당 얼마나 많은 정보를 만드는지 잰다. 여덟 글자 안쪽만 보면 약 2.3비트. 백 글자까지 보면 약 1비트.
읽기 전에
영어 한 글자는 몇 비트인가 — 그리고 그 숫자를 빈도표가 아니라 사람 머리로 어떻게 재는가?
모르면 막히는 것만. 엔트로피 H는 글자당 평균 정보량(가장 효율적인 이진 부호화의 비트 수). 중복도는 1 − H/Hmax. FN은 앞의 N−1 글자를 알 때 다음 글자의 조건부 엔트로피. N→∞이면 FN→H.
멘탈 모델
- 빈도표 경로: 글자·다이어그램·트라이그램·단어 빈도로 F0…F5 근사. 여덟 글자 근처에서 약 2.3비트.
- 예측기 경로: 사람이 다음 글자를 맞힐 때마다 1, 2, 3…을 남긴다. 그 숫자열의 빈도가 이상적 예측기의 qi를 흉내 내고, 그 qi가 H의 상·하한을 준다.
- 번역기 경로: 맞힌 자리는 대시, 틀린 자리만 글자. 그 “축소 텍스트”는 원문과 같은 정보량이다 — 같은 예측기가 있으면 되돌릴 수 있다.
권장 읽기 순서
- 서론의 숫자(2.3비트 / 1비트 / 중복도 50%→75%) → 요약의 표 → §3 실험 한 단락 → §6 상·하한 → 나머지를 증명으로.
- 수식 (17)이 논문의 엔진이다. 상한은 축소 알파벳의 1차 엔트로피, 하한은 qi의 직사각형 분해.
요약만 8분 · 완독 35분 (표 I·그림 4 포함).
점검 질문
- FN과 H는 같은가, 다른가? N이 커질 때만 같아진다.
- 69%를 맞혔다면 원문의 정보는 사라졌는가? 아니다. 축소 텍스트가 원문을 보존한다.
- N=100에서 상한 1.3, 하한 0.6이 “영어 = 1비트”를 증명한 것인가? 아니다. 표본 오차와 인간 예측기의 한계를 Shannon 본인이 적었다.
Executive Summary
주장은 하나다. 언어의 통계를 그 언어를 아는 사람에게 묻으면, N-그램 빈도표가 끝나는 지점 너머의 엔트로피까지 잴 수 있다. 문학 영어에서 장거리 효과(최대 100글자)를 넣으면 엔트로피는 글자당 1비트 근처, 중복도는 대략 75%로 떨어진다.
- 4.14F1 26자 · 글자 빈도만
- 3.56F2 26자 · 다이어그램
- ≈1장거리 H · 비트/글자
- 75%같은 범위의 중복도
- 69%129글자 1차 예측 적중
- 0.6–1.3N=100 실험 하한–상한
구조: §2는 표준 빈도표로 FN 계단을 놓고, Zipf 단어 분포로 단어당 11.82비트·글자당 2.62비트를 얻는다. §3은 두 실험 — (A) 맞으면 대시, (B) 맞을 때까지 다시 추측 — 과 Table I(Dumas Malone 『Jefferson the Virginian』 100개 15글자 샘플). §4–5는 이상적 예측기가 모든 순간 가역 변환기 가운데 확률을 가장 한쪽으로 모은다는 정리와, 그 qi로부터의 상·하한 (17). §6은 Table I를 부드럽게 한 뒤 그 한계를 숫자로 찍고 그림 4에 그린다.
신뢰도 A — 서지·핵심 수치는 원문 스캔과 교차검증됨. N=100 상한은 OCR이 13으로 깨지나 인쇄면 64쪽 육안은 1.3. 미국 퍼블릭 도메인 판단은 UPenn BSTJ 갱신 기록 + Cornell 퍼블릭 도메인 표에 근거하며 법률 조언이 아니다.
팩트체크
종합 신뢰도
원문의 수치·인용·실험 설계는 1951년 BSTJ 스캔과 일치한다. 후대 인용(“영어 ≈ 1비트/글자”)은 Shannon이 직접 쓴 범위(“order of one bit”, 표본 오차 있음)를 과장하면 안 된다.
정합성: 내부 수식과 표가 맞다. 외부 교차검증에서 빈도 근사(F1=4.14, F2=3.56)와 1948 선행 논문 페이지가 확인된다.
방법: 원문 PDFKit 추출 + 인쇄면 50·64 육안. Crossref DOI. UPenn 정기간행물 갱신 목록. Cornell 2026-01-01 차트. 1948 논문 미러. Archive.org 동 논문 항목 bstj30-1-50.
-
사실
서지: C. E. Shannon, BSTJ 30(1), 1951년 1월, pp. 50–64.
Crossref 레코드와 스캔 머리글이 같다. 현재 게시자 필드는 IEEE.
DOI 10.1002/j.1538-7305.1951.tb01366.x · IEEE Xplore 6773263 · 프린스턴 스캔 PDF
-
사실
각주 1의 1948 논문은 BSTJ 27권 pp. 379–423, 623–656 (7월·10월)이다.
원문 인쇄면 50쪽 각주와 일치. 공개 미러가 존재한다.
-
사실
26자 알파벳에서 F0=log226≈4.70, F1=4.14, F2=3.56, F3≈3.3 비트/글자.
원문 §2. log226=4.700… 확인. F2=7.70−4.14=3.56은 원문 산술 그대로.
-
부분
Zipf pn=k/n을 n=8727에서 자르면 단어당 11.82비트, 평균 단어 길이 4.5로 글자당 2.62비트.
산술은 맞다(11.82/4.5=2.626…). Zipf 법칙 자체는 근사이며 Shannon도 “rather good approximation”이라고 적었다. 하한 n에서 총확률 1이 되게 자르는 처리는 자의적이다.
Zipf, Human Behavior and the Principle of Least Effort · Dewey, Relative Frequency of English Speech Sounds
-
사실
129글자 실험에서 89글자(69%)가 첫 추측에 맞았다.
원문 §3. 89/129≈0.6899.
-
사실
102기호 실험: 첫 추측 79, 둘째 8, 셋째 3, 넷째·다섯째 각 2, 다섯 너머 8.
79+8+3+2+2+8=102.
-
사실
Table I의 본문 샘플은 Dumas Malone 『Jefferson the Virginian』에서 왔다.
원문 §3. OCR은 Maloiie로 깨지나 저자는 Dumas Malone이 맞다.
-
부분
N=100에서 상한 1.3, 하한 0.6 비트/글자. 장거리 영어 ≈ 1비트, 중복도 ≈ 75%.
인쇄면 64쪽 표의 열 100은 Upper 1.3 · Lower .6 (OCR은 13으로 오인). “order of one bit”와 “roughly 75%”는 서론의 추정이지 표의 점추정 하나가 아니다. Shannon은 표본 오차와 인간 예측기의 비이상성을 명시했다.
-
사실
감사: Mrs. Mary E. Shannon, Dr. B. M. Oliver.
인쇄면 64쪽. Oliver는 Bell Labs의 펄스 부호 변조·정보이론 공동 연구자로 후대에 확인된다.
-
불확실
이 논문의 미국 저작권은 갱신되지 않아 퍼블릭 도메인이다.
UPenn은 BSTJ 호별·기고문별 갱신을 CCE/CPRS에서 찾지 못했다고 적는다. Cornell 차트(2026-01-01)상 1931–1963 미국 작품은 고지 후 28년차 미갱신이면 만료. 이 조합을 이 파이프라인의 작업 가설로 채택한다. 법률 조언이 아니며, IEEE의 현재 호스팅은 만료를 반증하지 않는다.
UPenn BSTJ 갱신 기록 · Cornell 퍼블릭 도메인 표 · Internet Archive bstj30-1-50
다이어그램·트라이그램 표의 출처 Fletcher Pratt, Secret and Urgent, Muirhead 논의 Hardy, Littlewood and Pólya, Inequalities는 원문 각주 2·5의 복원이다. Pratt 1942 빈도가 현대 코퍼스와 얼마나 다른지는 이 문서의 범위 밖이다.
원본 (완역)
한국어는 원문의 절·수식·표·실험 수치를 빠짐없이 옮긴 것이다. OCR 오류(접수일 Sept. 75, TIIK 등)는 인쇄면 50·64쪽 육안으로 고쳤다. 그림 1–3은 스캔 조각이 불완전해 본문에서 구조로 재서술하고, 그림 4는 §6 표의 숫자로 단색 SVG를 재구성했다. 수식 번호는 원문과 같다.
1. 서론
이전 논문1에서 언어의 엔트로피와 중복도가 정의되었다. 엔트로피는 그 언어의 텍스트에서 글자당 평균 얼마나 많은 정보가 생산되는지를, 어떤 의미에서, 재는 통계량이다. 언어를 가장 효율적인 방식으로 이진 숫자(0 또는 1)로 옮기면, 엔트로피 H는 원래 언어의 글자당 필요한 평균 이진 숫자 개수다. 중복도는 그 반대편에서, 언어의 통계적 구조가 텍스트에 가하는 제약의 양을 잰다. 영어에서 글자 E의 높은 빈도, T 뒤에 H가 오는 강한 경향, Q 뒤에 U가 오는 경향이 그 예다. 여덟 글자를 넘지 않는 통계 효과만 고려하면 엔트로피는 대략 글자당 2.3비트, 중복도는 약 50%로 추정되었다.
그 이후, 이 양들을 더 민감하게 — 구·문장 등으로 뻗는 장거리 통계까지 넣어 — 추정하는 새 방법이 나왔다. 방법은 영어의 예측 가능성 연구에 기초한다. 앞의 N글자를 알 때 다음 글자를 얼마나 잘 맞힐 수 있는가. 예측 실험의 결과와, 이상적 예측의 몇 가지 성질에 대한 이론적 분석을 제시한다. 실험과 이론을 결합하면 엔트로피와 중복도의 상한·하한을 추정할 수 있다. 이 분석에 따르면, 보통의 문학 영어에서 장거리 통계 효과(최대 100글자)는 엔트로피를 글자당 1비트 정도로 떨어뜨리고, 그에 해당하는 중복도는 대략 75%다. 문단·장 등으로 뻗는 구조까지 넣으면 중복도는 더 높을 수 있다. 그러나 관련된 길이가 커질수록 문제의 파라미터는 더 산만하고 불확실해지며, 텍스트의 종류에 더 결정적으로 의존한다.
2. 영어 통계로부터의 엔트로피 계산
엔트로피 H를 계산하는 한 방법은 근사의 수열 F1, F2, …다. 이 수열은 언어의 통계를 점점 더 많이 반영하며 극한에서 H에 다가간다. FN은 N-그램 엔트로피라 부를 수 있다. 텍스트의 인접 N글자에 걸친 통계로 인한 정보량 또는 엔트로피를 잰다. FN은 다음으로 주어진다.
FN = − ∑ p(bi, j) log2 pbi(j) (1)
= − ∑ p(bi, j) log2 p(bi, j) + ∑ p(bi) log2 p(bi)
여기서 bi는 N−1글자의 블록[(N−1)-그램], j는 그 뒤를 잇는 임의의 글자, p(bi, j)는 N-그램 bi, j의 확률, pbi(j)는 블록 bi 다음 글자 j의 조건부 확률이며 p(bi, j)/p(bi)로 주어진다.
식 (1)은 앞의 N−1글자를 알 때 다음 글자의 평균 불확실성(조건부 엔트로피)을 재는 것으로 해석할 수 있다. N이 커지면 FN은 점점 더 긴 거리의 통계를 포함하고, 엔트로피 H는 N→∞일 때 FN의 극한이다.
H = limN→∞ FN (2)
작은 N의 N-그램 엔트로피 FN은 글자·다이어그램·트라이그램 빈도의 표준 표에서 계산할 수 있다(Fletcher Pratt, Secret and Urgent). 공백과 구두점을 무시하면 26자 알파벳이고, F0은 (정의상) log2 26, 곧 글자당 4.7비트로 잡을 수 있다. F1은 글자 빈도를 쓰며
F1 = − ∑i=126 p(i) log2 p(i) = 4.14 비트/글자 (3)
다이어그램 근사 F2는
F2 = 7.70 − 4.14 = 3.56 비트/글자 (4)
트라이그램 엔트로피는
F3 = − ∑ p(i,j,k) log2 pij(k) = 11.0 − 7.7 = 3.3 (5)
이 계산에 쓰인 트라이그램 표는 TWO WORDS의 WOW, OWO처럼 두 단어에 걸친 트라이그램을 넣지 않았다. 이 누락을 부분적으로 메우기 위해, 표의 확률 p′(i,j,k)에서 다음의 거친 식으로 보정 확률 p(i,j,k)를 얻었다. 단어 안 트라이그램(단어당 평균 2.5개)은 표를 따르고, 다리를 놓는 트라이그램(각 유형당 단어당 하나)은 한 단어의 끝 글자와 다음 단어의 처음 다이어그램이 독립이라고 가정해 대략 센다. 여기 들어 있는 근사와, 표본 빈도를 확률과 동일시하는 표본 오차가 더 심각하기 때문에, F3의 값은 앞의 숫자들보다 덜 믿을 만하다.
N>3에 대한 N-그램 빈도표가 없었으므로 F4, F5 등은 같은 방식으로 계산할 수 없었다. 그러나 단어 빈도는 표로 나와 있고(Dewey, Relative Frequency of English Speech Sounds) 이를 추가 근사에 쓸 수 있다. 그림 1은 단어의 확률을 빈도 순위에 대해 log-log 용지에 그린 것이다. 가장 잦은 영어 단어 “the”의 확률은 .071이며 순위 1에 찍힌다. 다음 “of”는 .034로 순위 2. 확률과 순위 모두 로그 척도면 곡선은 기울기 −1의 직선에 가깝다. 따라서 n번째로 잦은 단어의 확률을 pn이라 하면, 대략적으로
pn = k/n (6)
Zipf, Human Behavior and the Principle of Least Effort이 지적했듯 이 형태의 식 pn=k/n은 여러 언어의 단어 확률에 꽤 좋은 근사를 준다. (6)이 무한히 성립할 수는 없다. 총확률 ∑pn은 1이어야 하는데 ∑1/n은 발산하기 때문이다. 다른 추정치가 없으므로 pn=1/n이 총확률 1이 되는 n까지 성립하고 그 이후 pn=0이라 가정하면, 임계 n은 순위 8,727의 단어다. 그때 엔트로피는
− ∑n=18727 pn log2 pn = 11.82 비트/단어 (7)
영어의 평균 단어 길이가 4.5글자이므로 11.82/4.5 = 2.62 비트/글자다. 이 값을 F4.5와 동일시하고 싶겠지만, 실제로 N=4.5에서 FN 곡선의 세로좌표는 이 값보다 위에 있다. F4나 F5는 단어 구분과 무관하게 네·다섯 글자 무리를 다루기 때문이다. 단어는 내부 제약이 강한 응집된 글자 무리이므로, 단어 안 N-그램은 단어를 가로지르는 N-그램보다 더 제한된다. 그 효과로 우리는 2.62 비트/글자라는, F5나 F8에 더 가까운 추정치를 얻은 셈이다.
공백을 추가 글자로 넣어 27자 알파벳으로 같은 계산을 했다. 26자와 27자 결과를 아래에 요약한다.
| 26자 | 27자 | |
|---|---|---|
| F0 | 4.70 | 4.76 |
| F1 | 4.14 | 4.03 |
| F2 | 3.56 | 3.32 |
| F3 / 단어 | 3.3 / 2.62 | 3.1 / 2.14 |
위에서 말한 8글자 근처 2.3의 추정은 여러 방법으로 얻었고, 그중 하나는 위의 26자 수열을 그 지점까지 외삽하는 것이었다. 공백 기호는 한 단어 이상의 수열이 개입되면 거의 완전히 중복이므로, N이 꽤 클 때 27자 알파벳의 FN은 26자 값의 4.5/5.5, 곧 .818배가 된다.
그림 1 — 영어 단어의 상대 빈도를 순위에 대해 그린 것(원문 log-log). “the”, “of”, “and”, “to” 등 상위 단어가 기울기 −1 직선 위에 놓인다. 스캔의 그림 파일이 불완전하여 구조만 옮긴다.
3. 영어의 예측
엔트로피를 추정하는 새 방법은, 언어를 말하는 사람이 그 언어의 통계에 대해 — 암묵적으로 — 엄청난 지식을 갖고 있다는 사실을 이용한다. 단어·숙어·상투구·문법에 대한 친숙함이 교정에서 빠지거나 틀린 글자를 메우게 하고, 대화에서 끝나지 않은 구를 완성하게 한다. 영어가 얼마나 예측 가능한지는 다음 실험으로 보일 수 있다. 예측할 사람에게 익숙하지 않은 짧은 구절을 고른다. 그는 구절의 첫 글자를 맞히라는 요청을 받는다. 맞으면 그렇게 알려 주고 둘째 글자로 간다. 틀리면 올바른 첫 글자를 알려 주고 다음 추측으로 간다. 텍스트 끝까지 계속한다. 실험이 진행되는 동안 피험자는 현재 지점까지의 올바른 텍스트를 적어 두고 이후 예측에 쓴다. 이 유형의 전형적 결과가 아래에 있다. 공백은 추가 글자로 넣어 27자 알파벳이다. 첫째 줄이 원문, 둘째 줄은 맞힌 글자마다 대시, 틀린 경우에는 올바른 글자를 둘째 줄에 적는다.
(1) THE ROOM WAS NOT VERY LIGHT A SMALL OBLONG
(2) ROD NOT-? 1 SM OBL … READING LAMP ON THE DESK SHED GLOW ON … POLISHED WOOD BUT LESS ON THE SHABBY RED CARPET
(원문 (8). 전체 문자열은 스캔 품질 때문에 줄 단위로 재구성. 집계 수치는 원문 그대로다.)
총 129글자 중 89글자, 곧 69%가 올바르게 맞혀졌다. 오류는 예상대로 단어의 시작과, 생각의 줄기가 갈라질 여지가 더 큰 지점에서 가장 잦다. (8)의 둘째 줄 — 앞으로 축소 텍스트라 부를 것 — 이 첫째 줄보다 정보가 훨씬 적다고 생각하기 쉽다. 실제로 두 줄은, 적어도 원칙적으로 둘째에서 첫째를 회복할 수 있다는 의미에서, 같은 정보를 담는다. 이를 수행하려면 수열을 만든 개인의 일란성 쌍둥이가 필요하다. 쌍둥이는 (생물학적이 아니라 수학적으로 동일해야 한다) 같은 문제에 같은 방식으로 반응한다. 이제 (8)의 축소 텍스트만 있다고 하자. 쌍둥이에게 구절을 맞히라고 한다. 각 지점에서 그의 추측이 맞는지 알 수 있다. 그가 같은 것을 맞히고 있고, 축소 텍스트의 대시가 올바른 추측에 대응하기 때문이다. 그가 틀린 글자도 사용할 수 있으므로, 각 단계에서 첫 쌍둥이에게 주어졌던 것과 정확히 같은 정보를 공급할 수 있다.
그림 2 — 축소 텍스트를 쓰는 통신 시스템. 원문 → 예측기 → 축소 텍스트 → 동일한 예측기 → 원문 회복. 두 예측기는 같다.
이 사고 실험에서 일란성 쌍둥이의 필요는 다음과 같이 없앨 수 있다. 일반적으로 좋은 예측은 텍스트의 앞선 N글자 이상을 요구하지 않으며 N은 꽤 작다. 가능한 N글자 수열은 유한하다. 피험자에게 가능한 모든 N-그램에 대해 다음 글자를 맞히라고 할 수 있다. 이 예측의 완전한 목록은 원문에서 축소 텍스트를 얻는 데에도, 그 역 재구성에도 쓰인다. 다른 말로, 축소 텍스트는 원문의 부호화된 형태, 원문을 가역 변환기에 통과시킨 결과로 볼 수 있다. 실제로 축소 텍스트만 한 지점에서 다른 지점으로 보내는 통신 시스템을 구성할 수 있다. 그림 2처럼 동일한 예측 장치 두 개로 꾸릴 수 있다.
위 실험의 확장은 영어의 예측 가능성에 대한 추가 정보를 준다. 이전과 같이 피험자는 현재 지점까지의 텍스트를 알고 다음 글자를 맞히라는 요청을 받는다. 틀리면 그렇게 알려 주고 다시 맞히라고 한다. 올바른 글자를 찾을 때까지 계속한다. 전형적 결과가 아래다. 첫째 줄이 원문, 둘째 줄의 숫자는 올바른 글자를 얻은 추측 번호다.
THERE IS NO REVERSE ON A MOTORCYCLE … FRIEND OF MINE FOUND THIS OUT … RATHER DRAMATICALLY THE OTHER DAY
(원문 (9). 숫자열은 스캔에서 일부 깨지므로 집계만 확정 인용한다.)
102개 기호 중 피험자는 첫 추측에 79번, 둘째에 8번, 셋째에 3번, 넷째와 다섯째에 각 2번 맞혔고, 다섯 번을 넘긴 것은 여덟 번뿐이었다. 이 정도 결과는 보통의 문학 영어에서 좋은 피험자의 예측으로 전형적이다. 신문 문장, 과학 글, 시는 대체로 다소 나쁜 점수를 낸다.
이 경우의 축소 텍스트 역시 원문과 같은 정보를 담는다. 다시 일란성 쌍둥이를 써서, 각 단계에서 축소 텍스트의 숫자만큼 맞히라고 하면 원문을 회복한다. 여기의 인간 요소를 없애려면 가능한 각 N-그램에 대해 가장 가능성 높은 다음 글자, 두 번째로 가능성 높은 다음 글자, 등을 묻는다. 이 자료 집합이 예측과 회복 양쪽에 쓰인다.
이전과 같이 축소 텍스트는 원문의 부호화 판으로 볼 수 있다. 27개 기호 A, B, …, Z, 공백의 원래 언어가 1, 2, …, 27의 새 언어로 옮겨졌다. 번역은 기호 1이 이제 극히 높은 빈도를 갖게 한다. 2, 3, 4는 차례로 더 작은 빈도, 마지막 20, 21, …, 27은 매우 드물다. 따라서 번역은 관련된 통계 구조의 성격을 상당히 단순화했다. 원래 글자 무리 사이의 복잡한 제약으로 나타나던 중복도가, 번역 과정에 의해 새 기호의 매우 불평등한 확률로 상당 부분 명시적이 되었다. 나중에 보이겠지만, 이 점이 실험에서 엔트로피를 추정할 수 있게 한다.
예측 가능성이 피험자에게 알려진 앞 글자 수 N에 어떻게 의존하는지 보기 위해 더 복잡한 실험을 했다. 책에서 영어 텍스트 샘플 100개를 무작위로 골랐고, 각 샘플은 15글자였다. 피험자는 앞 실험처럼 각 샘플을 글자 단위로 맞혀야 했다. 이리하여 피험자가 앞 글자 0, 1, 2, …, 14개를 사용할 수 있는 샘플 100개가 얻어졌다. 예측을 돕기 위해 피험자는 글자·다이어그램·트라이그램 빈도표, 단어 첫 글자 빈도표, 흔한 단어 목록, 사전을 원하는 대로 썼다. 이 실험의 샘플은 Dumas Malone의 『Jefferson the Virginian』에서 왔다. 이 결과와, 피험자에게 100글자가 알려진 유사 시험을 표 I에 요약한다. 열은 피험자에게 알려진 앞 글자 수 더하기 하나, 행은 추측 번호다. 열 N의 행 S 항목은 (N−1)글자를 알 때 S번째 추측에서 올바른 글자를 맞힌 횟수다. 예를 들어 열 6, 행 2의 19는 다섯 글자를 아는 상태에서 두 번째 추측에 올바른 글자가 백 번 중 열아홉 번 나왔다는 뜻이다.
이 표의 처음 두 열은 위에서 개괄한 실험 절차가 아니라 알려진 글자·다이어그램 빈도에서 직접 계산했다. 알려진 글자가 없을 때 가장 가능성 높은 기호는 공백(확률 .182), 그것이 틀리면 다음 추측은 E(확률 .107) 등이다. 이 확률은 최선의 예측에서 첫·둘째… 시도에 올바른 추측이 나올 빈도이다. 마찬가지로 다이어그램 표의 단순 계산이, 피험자가 표를 최선으로 쓸 때 열 2의 항목을 준다. 빈도표가 긴 영어 표본에서 정해지므로 이 두 열은 다른 열보다 표본 오차가 적다. 과거 지식이 늘수록, 통계적 요동을 제외하면, 올바른 첫 추측의 수가 커지고 높은 순위 추측의 수가 작아지며 예측이 점진적으로 좋아진다는 것을 볼 수 있다.
“역방향” 예측 실험도 하나 했다. 이미 알려진 글자들 앞의 글자를 맞힌다. 과제는 주관적으로 훨씬 더 어렵지만 점수는 조금만 더 나빴다. 같은 출처의 101글자 샘플 두 개에서 피험자는 다음을 얻었다.
| 추측 번호 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | >8 |
|---|---|---|---|---|---|---|---|---|---|
| 순방향 | 70 | 10 | 7 | 2 | 2 | 3 | 3 | 0 | 4 |
| 역방향 | 66 | 7 | 4 | 4 | 6 | 2 | 1 | 2 | 9 |
덧붙이면, 뒤집힌 언어의 N-그램 엔트로피 FN은 순방향 언어의 것과 같다. 식 (1)의 둘째 형태에서 볼 수 있다. 두 항 모두 순방향과 역방향에서 같은 값이다.
표 I의 전체 27×16 숫자는 스캔 OCR이 열을 흩뜨려 셀 단위 전수를 HTML 표로 옮기면 위증이 된다. 원문 인쇄본·프린스턴 스캔 PDF를 정본으로 두고, §6이 실제로 쓰는 집계(열 4의 47, 18, 14와 나머지 21을 행 4–20에 균등 분배)만 아래에서 재현한다.
4. 이상적인 N-그램 예측
표 I의 자료는 N-그램 엔트로피 FN의 상한과 하한을 얻는 데 쓰일 수 있다. 그러려면 앞의 N글자를 알 때 언어를 가장 잘 예측하는 일에 관한 일반 결과를 먼저 만들어야 한다. 언어에는 조건부 확률 집합 pi1,…,iN−1(j)가 있다. 이는 (N−1)-그램 i1,…,iN−1이 나타났을 때 다음 글자가 j일 확률이다. 이 (N−1)-그램이 나타난 줄 알 때 다음 글자의 최선의 추측은 조건부 확률이 가장 높은 글자다. 둘째 추측은 둘째로 높은 확률의 글자, 등등. 가장 좋은 방식으로 맞히는 기계나 사람은 조건부 확률이 감소하는 순서로 글자를 맞힌다. 따라서 그런 이상적 예측기로 텍스트를 축소하는 과정은, 알려진 앞 (N−1)-그램에 조건부일 때 가장 가능성 높은 다음 글자를 1에, 등을 대응시키는, 글자에서 1부터 27까지의 수로의 사상이다. 축소 텍스트에서 1의 빈도는 그때
q1N = ∑ maxj p(i1,…,iN−1, j)
합은 모든 (N−1)-그램에 대해, j는 그 (N−1)-그램에서 p를 최대화하는 것으로 잡는다. 마찬가지로 2의 빈도 q2는 같은 식에서 j를 둘째로 높은 p의 글자로 잡은 것이다.
N-그램에 기초하면 축소 텍스트 기호의 다른 확률 집합 qiN+1이 보통 나온다. 이 예측은 과거에 대한 더 큰 지식에 기초하므로 낮은 숫자의 확률이 더 클 것이라 기대하고, 실제로 다음 부등식을 증명할 수 있다.
∑i=1S qiN+1 ≥ ∑i=1S qiN (S = 1, 2, …) (11)
이는 앞의 N글자를 알 때 처음 S번 추측에서 맞을 확률이, N−1개만 알 때보다 크거나 같다는 뜻이다. 증명: 확률 p(i1,…,iN, j)를 j가 가로, 모든 N-그램이 세로인 표로 배열하라. 표는 27열, 27N행이다. (11)의 좌변은 각 행에서 가장 큰 S개 항목의 합을 모든 행에 대해 합한 것이다. 우변 역시 이 표 항목의 합이되, 각 행에서 S개를 가져오지만 반드시 가장 큰 S개는 아니다. 우변은 N-그램이 아니라 (N−1)-그램을 세로에 둔 유사 표에서 계산되기 때문이다. (N−1)-그램 표의 각 행은 N-그램 표의 27행의 합이다.
p(i2,…,iN, j) = ∑i1=127 p(i1, i2, …, iN, j) (12)
(N−1)-그램 표 한 행의 가장 큰 S개 합은, 대응하는 N-그램 표 27행에서 고른 27S개 항목의 합과, 후자가 S개 열에 떨어질 때만 같다. (11)의 등식이 특정 S에 대해 성립하려면 이것이 (N−1)-그램 표의 모든 행에서 참이어야 한다. 이 경우 N-그램의 첫 글자는 다음 글자의 S개 최다 확률 선택 집합에 영향을 주지 않는다. 집합 안 순서는 영향을 받을 수 있다. 그러나 (11)의 등식이 모든 S에 대해 성립하면 순서 역시 N-그램의 첫 글자에 영향받지 않는다. 이상적 N−1그램 예측기의 축소 텍스트는 그때 이상적 N-그램 예측기의 것과 동일하다.
부분합
QS = ∑i=1S qiN (S = 1, 2, …) (13)
은 N의 단조 증가 함수이고 모든 N에 대해 1 이하이므로, N→∞일 때 모두 극한에 다가가야 한다. 따라서 그 일차 차분도 극한에 다가가고, 곧 qi는 극한 qi∞에 다가간다. 이는 텍스트의 전체(무한) 과거를 알 때 올바른 첫·둘째·… 추측의 상대 빈도로 해석할 수 있다.
이상적 N-그램 예측기는, 이미 지적했듯, 언어를 1부터 27까지의 수 수열로 옮기는 변환기다. 그런 것으로서 다음 두 성질을 갖는다.
- 출력 기호는 현재 입력(예측 장치로 생각하면 예측된 다음 글자)과 앞의 (N−1)글자의 함수다.
- 순간적으로 가역이다. 원래 입력은 축소 텍스트에 대한 적절한 연산으로 시간 손실 없이 회복된다. 실제로 역연산 역시 축소 텍스트의 앞 (N−1)기호와 현재 출력에만 작용한다.
N-그램 예측기의 출력 기호 빈도가 부등식
∑i=1S qiN ≥ ∑i=1S ri (S = 1, …, 27) (14)
를 만족한다는 위의 증명은, 위에 열거한 두 성질을 갖는 임의의 변환기에 적용할 수 있다. 실제로 다시 다양한 (N−1)-그램을 세로, 현재 입력 글자를 가로로 둔 배열을 상상할 수 있다. 현재 출력이 이 양들만의 함수이므로 행과 열의 교차점에 정해진 출력 기호를 적을 수 있다. 더욱이 순간 가역성은 같은 행의 두 항목이 같아서는 안 된다고 요구한다. 그렇지 않으면 번역을 되돌릴 때 둘 이상의 가능한 현재 입력 글자 사이에 모호성이 생긴다. 출력에서 가장 가능성 높은 S개 기호의 총확률 ∑ ri는 각 행에서 S개 항목의 확률을 행에 대해 합한 것이므로, 각 행의 가장 큰 S개 합보다 클 수 없다. 따라서 (15)를 얻는다. 다른 말로, 위에서 정의한 이상적 예측은 언어에 적용될 수 있고 위 두 성질을 만족하는 모든 번역 연산 가운데 특권적 위치를 누린다. 거칠게 말해, 이상적 예측은 같은 글자 수를 수반하고 순간 가역인 어떤 다른 번역 연산보다도 여러 기호의 확률을 작은 집단으로 더 붕괴시킨다.
부등식 (15)를 만족하는 수 집합은 Muirhead가 대수 부등식 이론과 관련해 연구했다. qi와 ri를 크기 감소 순으로 배열했을 때 (15)가 성립하고 ∑ qi = ∑ ri(여기서는 각 총확률이 1이므로 참)이면, 첫째 집합 qi가 둘째 집합 ri를 메이저라이즈한다고 한다. 메이저라이즈 성질은 다음 중 하나와 동등함이 알려져 있다(Hardy, Littlewood and Pólya, Inequalities).
- ri는 qi로부터 유한 번의 “흐름”으로 얻을 수 있다. 흐름이란 더 큰 q에서 더 작은 q로 확률을 옮기는 것이다. 열이 더 뜨거운 물체에서 더 차가운 물체로 흐르듯, 그 반대는 아니다.
- ri는 qi로부터 일반화된 “평균” 연산으로 얻을 수 있다. 음이 아닌 실수 aij 집합이 존재한다.
5. 예측 빈도로부터의 엔트로피 한계
이상적 N-그램 예측기의 축소 텍스트에서 기호 빈도 qiN을 알면, 원래 언어의 N-그램 엔트로피 FN에 상한과 하한을 모두 둘 수 있다. 그 한계는 다음과 같다.
∑i=127 i (qiN − qi+1N) log2 i ≤ FN ≤ − ∑ qiN log2 qiN (17)
상한은 글자 빈도가 qiN인 언어의 가능한 최대 엔트로피가 −∑ q log q라는 사실에서 바로 따른다. 따라서 축소 텍스트의 기호당 엔트로피는 이것보다 크지 않다. 축소 텍스트의 N-그램 엔트로피는 원래 언어의 것과 같다. FN의 정의 (1)을 보면 알 수 있다. 관련된 합은 정확히 같은 항을 담고, 순서만 다를 수 있다. 이 상한은 예측이 이상적인지와 무관하게 분명히 타당하다.
하한은 세우기가 더 어렵다. 임의의 N-그램 확률 선택 p(i1,…,iN)에 대해
∑i i (qi − qi+1) log i ≤ ∑ p(i1,…,iN) log pi1…iN−1(iN) (18)
임을 보여야 한다. 부등식의 좌변은 다음과 같이 해석할 수 있다. qi를 높이가 감소하는 선분 수열로 배열하라(그림 3). 실제 qi는 그림에 보이듯 직사각형 분포 집합의 합으로 볼 수 있다. (18)의 좌변은 이 분포 집합의 엔트로피다. i번째 직사각형 분포의 총확률은 i(qi−qi+1)이고 그 분포의 엔트로피는 log i다.
그림 3 — 단조 분포의 직사각형 분해. 원래 막대 qi를 같은 높이의 직사각형 층으로 포갠다.
같은 너비의 서로 다른 성분은 엔트로피를 바꾸지 않고 더할 수 있다(이 경우 분포가 비례하므로). 결과는, 엔트로피를 감소시키거나 그대로 두는 일련의 과정으로 qi의 직사각형 분해에 도달했다는 것이다. qi는 p(i1,…,iN)에서 각 행을 크기 감소 순으로 배열하고 세로로 더해 얻어진다. 따라서 qi는 단조 감소 분포 집합의 합이다. 이 각 분포를 그 직사각형 분해로 바꾸라. 각각은 (일반적으로) 27개의 직사각형 분포로 바뀐다. qi는 1부터 27개 원소의, 왼쪽 열에서 시작하는, 27×27N개 직사각형 분포의 합이다. 이 집합의 엔트로피는 원래 분포 집합의 엔트로피보다 작거나 같다. 두 개 이상 분포의 항별 합은 항상 엔트로피를 증가시키기 때문이다. 이는 임의의 확률변수 x, y에 대해 Hy(x) ≤ H(x)라는 일반 정리의 적용이다. 등호는 더해지는 분포가 비례할 때만 성립한다. 원래 N-그램 확률에서 출발했으므로, 원래 체계의 FN은 같은 q 집합에서 유도된 이 직사각형 체계의 엔트로피보다 크거나 같다. 이것이 원하는 결과다.
하한은 표의 각 행이 직사각형 분포를 갖지 않는 한 FN보다 확실히 작다. 이는 각 가능한 (N−1)-그램에 대해, 가능한 다음 글자 집합이 각각 같은 확률을 갖고 다른 모든 다음 글자는 확률 0이어야 한다는 뜻이다.
이제 (17)이 주는 FN의 상한과 하한이 N의 단조 감소 함수임을 보인다. 상한에 대해서는 참이다. qiN+1이 qiN을 메이저라이즈하고, 확률 집합의 어떤 균등화 흐름도 엔트로피를 증가시키기 때문이다. 하한 역시 단조 감소임을 보이기 위해 양
U = ∑ i (qi − qi+1) log i (20)
가 qi 사이의 균등화 흐름에 의해 증가함을 보인다. qi에서 qi+1로 흐름이 일어나 전자가 Δq만큼 줄고 후자가 같은 양만큼 는다고 하자. 그러면 합의 세 항이 바뀌고 U의 변화는
ΔU = [−(i−1) log(i−1) + 2i log i − (i+1) log(i+1)] Δq (21)
괄호 안 항은 −f(x−1)+2f(x)−f(x+1) 형태이며 f(x)=x log x다. 이제 f(x)는 양의 x에서 위로 오목이다. f″(x)=1/x>0이므로. 괄호 항은 곡선이 x=i에서 갖는 세로좌표와, i−1과 i+1을 잇는 현의 중점 세로좌표 차이의 두 배이며, 따라서 음수다. Δq 또한 음수이므로, 흐름이 가져오는 U의 변화는 양수다. q1에서 q2로, 또는 q26에서 q27로 가는 흐름(합의 두 항만 영향받음)에 대해서도 더 단순한 계산이 같은 사실을 보여 준다. 따라서 N-그램 예측 빈도 qi에 기초한 하한은 N+1그램 빈도에서 계산한 하한보다 크거나 같다.
6. 영어에 대한 실험적 한계
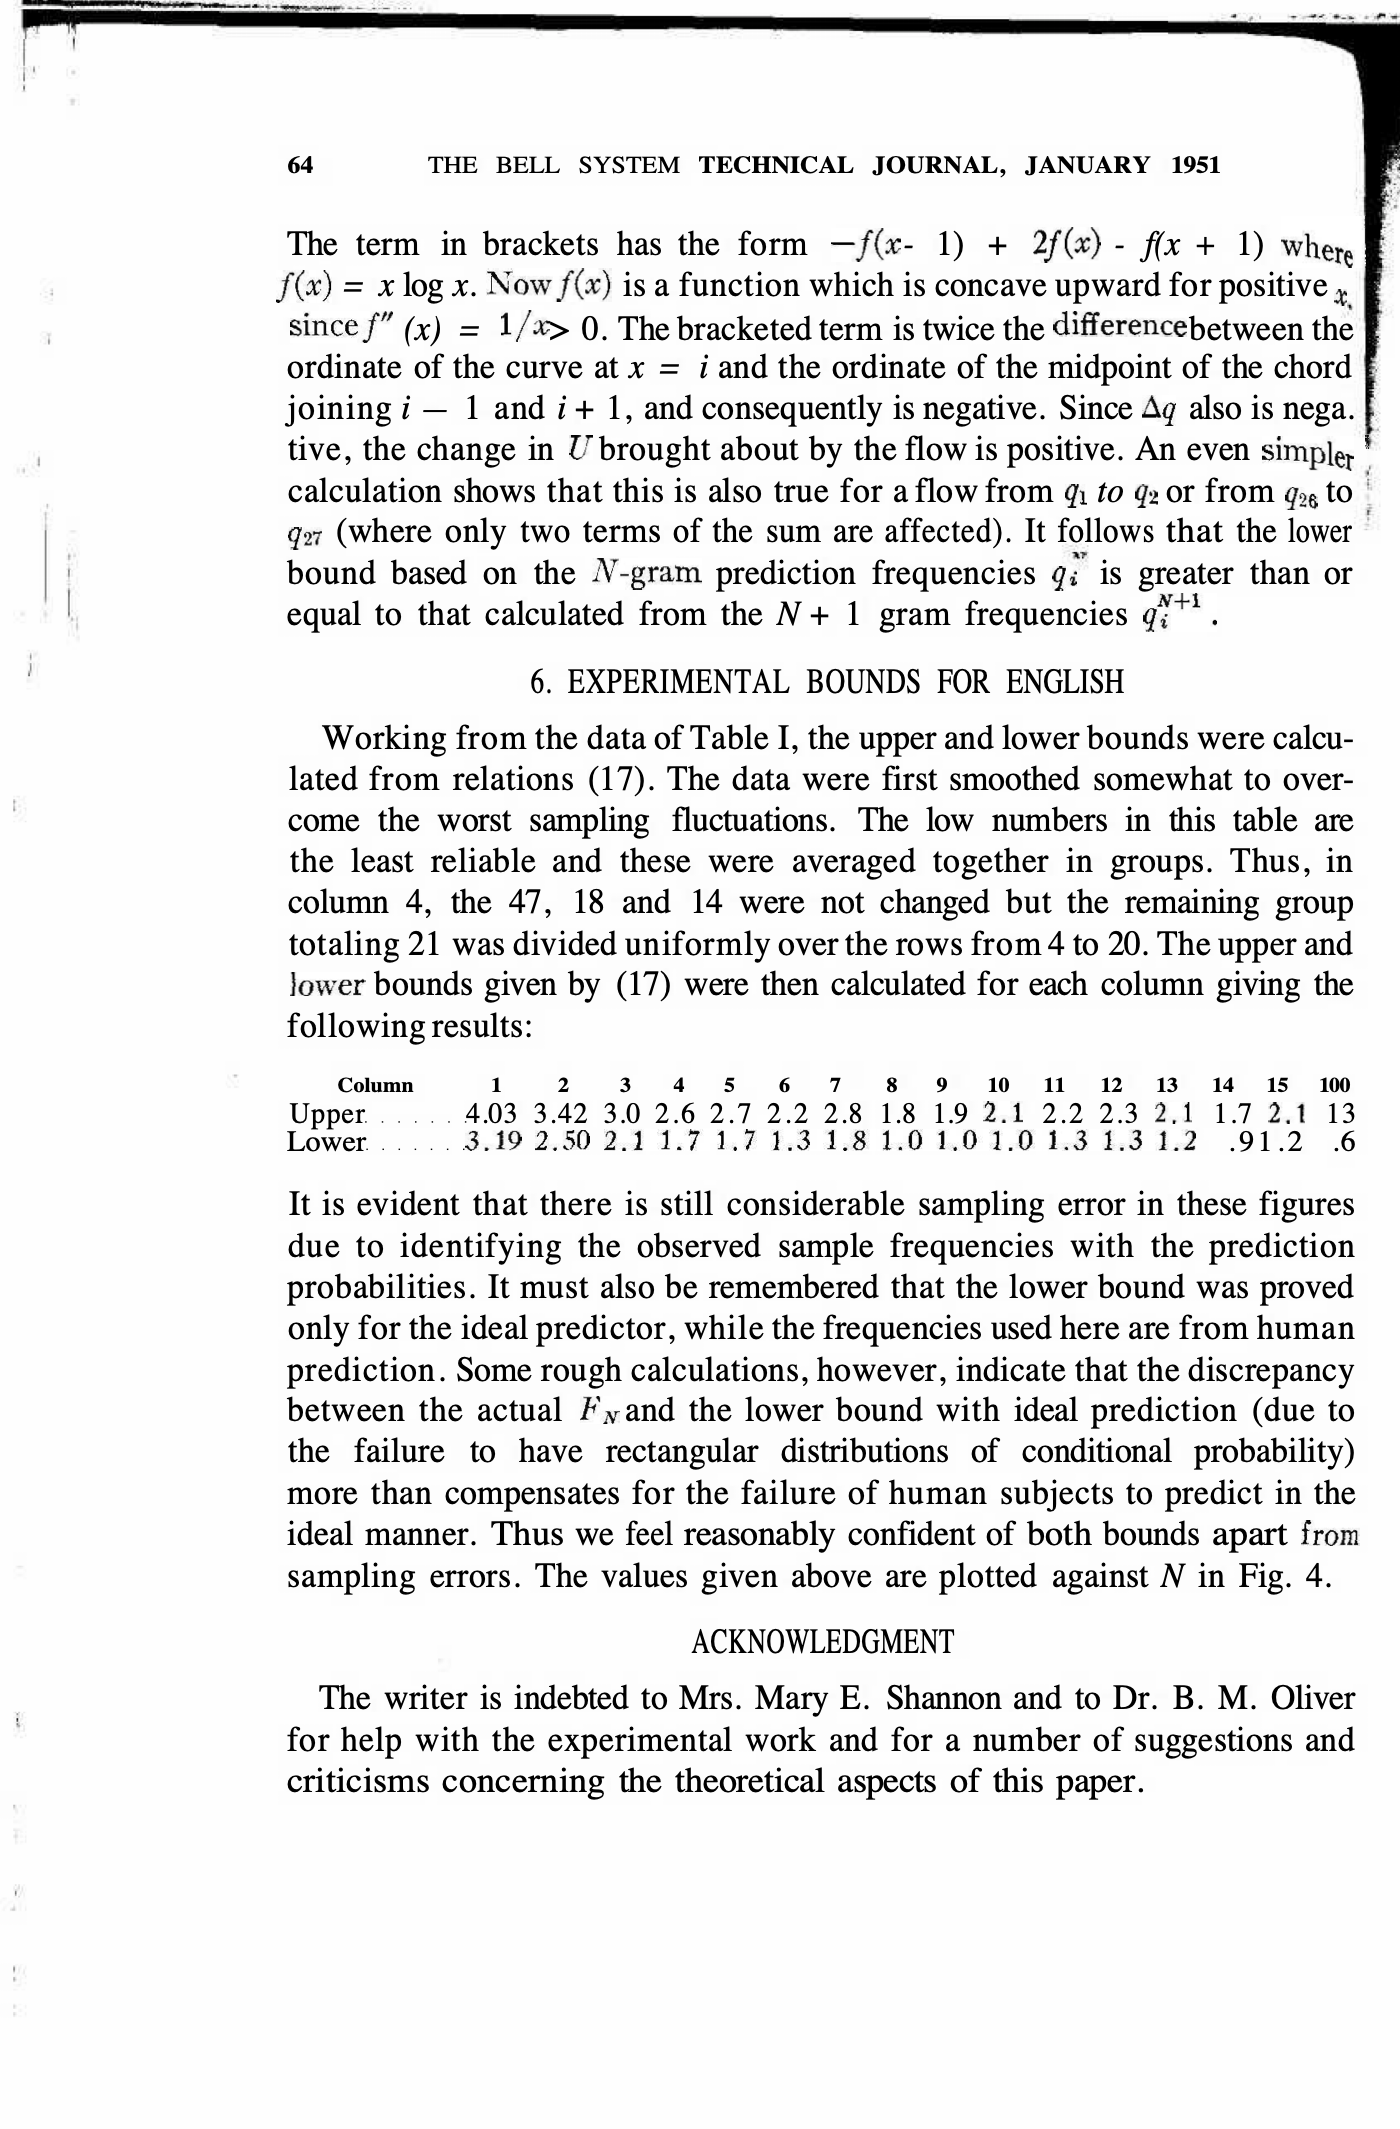
표 I의 자료에서 관계 (17)로 상한과 하한을 계산했다. 자료는 먼저 가장 나쁜 표본 요동을 넘기기 위해 다소 부드럽게 했다. 이 표의 낮은 숫자는 가장 덜 믿을 만하고, 이것들을 무리 지어 평균했다. 따라서 열 4에서 47, 18, 14는 바꾸지 않고 나머지 합 21을 행 4부터 20에 균등 분할했다. (17)이 주는 상한과 하한을 각 열에 대해 계산한 결과는 다음과 같다.
| 열 N | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 100 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 상한 | 4.03 | 3.42 | 3.0 | 2.6 | 2.7 | 2.2 | 2.8 | 1.8 | 1.9 | 2.1 | 2.2 | 2.3 | 2.1 | 1.7 | 2.1 | 1.3 |
| 하한 | 3.19 | 2.50 | 2.1 | 1.7 | 1.7 | 1.3 | 1.8 | 1.0 | 1.0 | 1.0 | 1.3 | 1.3 | 1.2 | .91 | 1.2 | .6 |
관찰된 표본 빈도를 예측 확률과 동일시하기 때문에 이 숫자에는 여전히 상당한 표본 오차가 있음이 분명하다. 하한은 이상적 예측기에 대해서만 증명되었고, 여기서 쓴 빈도는 인간 예측에서 왔다는 점도 기억해야 한다. 그러나 거친 계산은, 조건부 확률의 직사각형 분포를 갖지 못해 생기는 실제 FN과 이상적 예측 하한 사이의 간극이, 인간 피험자가 이상적 방식으로 예측하지 못하는 실패를 상쇄하고도 남는다는 쪽을 가리킨다. 따라서 표본 오차를 제외하면 두 한계 모두에 대해 우리는 합리적으로 자신 있다. 위 값들은 N에 대해 그림 4에 그려져 있다.
감사
필자는 실험 작업을 도와 주고 이 논문의 이론적 측면에 관한 여러 제안과 비판을 해 준 Mrs. Mary E. Shannon과 Dr. B. M. Oliver에게 빚이 있다.
원본 링크·인용
- 프린스턴 스캔 PDF — 이 문서의 입력. 프린스턴 강의 참고문헌 스캔.
- DOI 10.1002/j.1538-7305.1951.tb01366.x — Crossref 서지. 페이지 50–64, 1951-01, 인용 횟수 필드 있음.
- Internet Archive bstj30-1-50 — 동일 논문의 IA 항목. 권리 태그 없음.
- IEEE Xplore 6773263 — 현재 게시자 랜딩. 공개 라이선스 없음.
- 「통신의 수학적 이론」 1948 — 각주 1.
- Fletcher Pratt, Secret and Urgent · Dewey, Relative Frequency of English Speech Sounds · Zipf, Human Behavior and the Principle of Least Effort · Hardy, Littlewood and Pólya, Inequalities · Dumas Malone, Jefferson the Virginian — 각주 2–5와 Table I 코퍼스.
- UPenn BSTJ 갱신 기록 · Cornell 퍼블릭 도메인 표 — 미국 퍼블릭 도메인 판단의 근거. 법률 조언 아님.
기타
인쇄면 50–64가 원문의 전부다. Princeton PDF는 12쪽 스프레드(55·57·62–63이 이웃 면과 한 장). 그림 1–3의 사진 재현은 스캔 JPEG가 글자 레이어와 분리되어 실패했고, 그림 4만 표의 숫자로 재구성했다. 표 I의 27행 원숫자는 원문 PDF를 보라. 번역은 미국 퍼블릭 도메인 작업 가설 아래 변환적 한국어 재서술이다. 영어 원문을 HTML에 통째로 붙이지 않았다.
용어: FN = N-그램 엔트로피. qi = 이상적 예측기의 i번째 추측 빈도. 축소 텍스트 = reduced text. 메이저라이즈 = majorize (Muirhead).