devansh.bearblog.dev · 2026-03-10 + X · 2026-11-07
건초 더미 속 바늘: 취약점 연구를 위한 LLM
devansh가 2026-03-10 개인 블로그 devansh.bearblog.dev에 올린 연재 첫 편이다. LLM 에이전트에게 긴 지시문을 얹지 말고, 과거 CVE에서 뽑은 위협 모델 한 장과 신뢰 경계 하나에 맞춘 코드 조각을 주라고 쓴다. Parse Server·HonoJS·ElysiaJS·harden-runner·BullFrog·Better-Hub에서 찾은 22건과 프롬프트 기법 10개가 근거다. 같은 저자가 8개월 뒤인 2026-11-07 X에 올린 후속 게시물은 바운티 뒤의 탐색 프롬프트 13개와 싼 모델 에이전트 떼 구조를 공개한다.
LLM은 긴 지시문보다 한 문장 위협 모델과 얇은 코드 조각을 받을 때 취약점을 더 찾는다는 실전 보고
LLM 에이전트에게 오픈소스 코드의 취약점을 찾게 할 때, 무엇을 얼마만큼 주어야 일반론 목록 대신 실제 취약점이 나오는가?
저자 devansh의 답은 적게 주라는 것이다. 한 문장짜리 위협 모델과 신뢰 경계 하나에 맞춘 얇은 코드 조각이면 충분하다. 긴 AGENTS.md나 연쇄 프롬프트를 얹으면 문맥이 길어져서 모델이 취약점을 더 놓친다. 모델이 내놓은 후보는 테스트로 재현해서 확인한다. 원문은 devansh가 2026-03-10 개인 블로그 devansh.bearblog.dev에 올린 영어 글 「Needle in the haystack: LLMs for vulnerability research」다. 연재 첫 편이라서 퍼징과 하네스 자동 생성 같은 세부 기법은 다음 편으로 미뤘다고 저자는 밝힌다.
원문의 근거는 저자 자신의 작업 기록이다. 저자는 여러 오픈소스 프로젝트에서 취약점을 30건 넘게 찾았다고 스스로 보고한다. 본문 표에는 그중 6개 대상 22건과 CVE 번호 7개가 실려 있다. 저자가 이 근거에 붙인 두 서술은 저자 자신의 상세 글과 어긋난다. 저자는 기간을 '약 두 달'로 적는다. 상세 글의 첫 보고(2025-11-28)부터 마지막 보고(2026-03-07)까지는 99일이다. 저자는 소스 코드를 손으로 읽지 않고 전부 LLM으로 찾았다고도 쓴다. 2026-01-10 Elysia 상세 글은 코드베이스를 훑다가 문제의 코드 블록이 눈에 띄었다고 쓴다. 상세 글 8편 어디에도 LLM 언급이 없다. 모델이 동조적이라거나 긴 문맥 가운데를 놓친다는 관찰은 저자가 2026-01~03에 OpenAI Codex 같은 에이전트형 CLI로 얻은 것이다. 원문에는 그 관찰의 측정 방법이 없다.
완역 블록의 마지막 장은 같은 저자가 8개월 뒤인 2026-11-07 X에 올린 후속 게시물이다. 저자는 2026-09-03 X에 취약점 제보 한 건으로 $100,000 바운티를 받았다고 썼고, 7분 뒤 이 글을 "내 방법론"으로 다시 걸었다. 후속 게시물은 그 바운티 뒤의 탐색 질문 13개와 그것을 돌리는 구조를 공개한다. 위협 모델이 탐색 범위를 정한다는 원리는 그대로다. 바뀐 것은 탐색을 맡는 쪽이다. 이 글에서는 연구자 한 명이 Codex 같은 에이전트에게 얇은 조각을 준다. 후속 게시물에서는 위협 모델로 변형한 질문을 싼 오픈 웨이트 모델 떼가 나눠 맡고, 프런티어 모델은 마지막 확인과 분류만 한다. 바운티의 지급처와 취약점은 공개되지 않아 금액은 저자의 진술로만 남는다.
멘탈 모델
문맥 창이 건초더미라면 취약점은 불변식 하나를 깨는 코드 몇 줄짜리 바늘이다. 지시문을 보탤수록 건초더미가 커진다. 위협 모델은 바늘이 있을 구역을 한 문장으로 좁힌다. 집어 든 것이 바늘인지는 테스트가 가린다.
후속 게시물은 건초더미를 구역으로 나눠 일꾼을 여럿 푼다. 위협 모델이 구역 지도를 그리고, 뮤테이터가 그 지도를 구역마다 다른 질문으로 바꾼다. 싼 모델 떼가 구역 하나씩을 뒤지고, 무언가 집어 든 것만 비싼 모델이 다시 본다.
선행 개념
스캐폴딩(scaffolding): 에이전트에게 미리 깔아 두는 고정 지시다. 원문은 AGENTS.md·SKILLS.md 파일, 연쇄 프롬프트, 단계별 사전 계획을 모두 이 말로 부른다.
위협 모델(threat model)과 신뢰 경계(trust boundary): 위협 모델은 어떤 공격자가 어떤 능력으로 무엇을 노리는지 적은 짧은 문서다. 신뢰 경계는 신뢰 수준이 바뀌는 지점이다. 원문은 브라우저→서버, 플러그인→호스트, 샌드박스→특권 영역을 예로 든다.
불변식(invariant): 코드가 언제나 지켜야 하는 조건이다. 원문 예는 "only admins can call X"와 "JWT issuer must be Y"다. Parse Server 사례에서 깨진 불변식은 "readOnlyMasterKey는 읽기만 하고 쓰지 못한다"였다.
context rot과 Lost in the Middle: 입력이 길어질수록 모델이 필요한 세부를 집어내는 신뢰도가 떨어지는 현상이다. 관련 정보가 긴 문맥 가운데 있으면 처음이나 끝에 있을 때보다 성능이 더 낮다. 저자는 두 현상의 근거로 Chroma 보고서와 Liu 외 논문을 든다.
JWT 알고리즘 혼동(algorithm confusion): 서버가 검증 알고리즘을 고정하지 않고 기본값이나 토큰 헤더의 alg 값을 따를 때 생긴다. 공격자는 서버의 공개키를 HMAC 비밀키로 삼아 토큰을 직접 서명한다. HonoJS 사례 두 건이 이 부류다.
외부 송신(egress) 필터: CI 러너에서 바깥으로 나가는 네트워크 연결을 감시하거나 막는 장치다. 원문의 harden-runner와 BullFrog가 GitHub Actions용 egress 필터다.
프롬프트 인젝션(prompt injection): 보안 용어로는 외부 입력에 숨긴 지시가 LLM의 원래 지시를 가로채는 공격이다. 원문 마지막 절 "Prompt Injection"은 이 공격을 다루지 않는다. 그 절 제목은 저자가 자기 프롬프트에 틀·편향·제약을 "주입"하는 기법 10개를 부르는 이름이다.
오픈 웨이트(open-weight) 모델과 사이버 모델: 오픈 웨이트 모델은 가중치가 공개돼 직접 내려받아 돌릴 수 있는 모델이다. 사이버 모델은 저자가 쓰는 말로, 보안 작업용으로 심사를 거친 사용자에게만 여는 프런티어 모델 변형을 가리킨다. 2026-11 기준 OpenAI GPT-6 Cyber, Anthropic Claude Mythos 5.1, Google Gemini 4 Carbon이 이런 방식으로 열린다.
뮤테이터(mutator): 저자가 기본 프롬프트를 진단 대상의 위협 모델에 맞춰 변형하는 부품에 붙인 이름이다. 입력을 조금씩 바꿔 새 시험 입력을 만드는 퍼저 부품과 같은 이름이다.
하네스(harness)와 분류(triage): 하네스는 모델을 감싸 도구 호출·서브에이전트·메모리를 붙이는 실행 틀이다. Codex CLI와 opencode가 하네스다. 분류는 쌓인 후보가 실제 이슈인지 가리고 우선순위를 매기는 일이다.
읽는 순서
Intro Lore, Why "Find All The Vulnerabilities" does not work: 저자가 피하려는 양 끝을 먼저 잡는다. 한 끝은 지시문을 쌓는 스캐폴딩 과잉이다. 다른 끝은 "find all vulnerabilities in this codebase" 한 줄짜리 프롬프트다. 둘째 절이 이 프롬프트의 실패 원인을 두 가지로 진단한다.
Minimal Scaffolding That Actually Helps: 처방의 본체다. 과거 CVE 설명으로 위협 모델을 만든 뒤 불변식을 찾게 하거나 수정 커밋의 우회를 찾게 한다. 위협 모델 다음에는 진입점, 신뢰 경계, 고위험 연산, 공격자-피해자 모델을 적는다. 저자는 이 위협 모델을 감사 내내 고쳐 쓰는 문서로 둔다.
My Own Methodology: Parse Server 사례부터 읽는다. 과거 권고문, 위협 모델, 모델이 짚은 패턴, 좁힌 후속 프롬프트로 이어지는 절차가 이 사례 하나에 다 들어 있다. 그 패턴은 isMaster만 확인하고 isReadOnly는 보지 않는 라우트 핸들러였다. Better-Hub는 과거 CVE가 없어서 아키텍처 설명에서 위협 모델을 뽑은 사례다. 나머지 넷은 같은 절차를 되풀이하므로 Vulnerabilities Found 표와 Why This Worked로 묶어 읽어도 흐름이 끊기지 않는다.
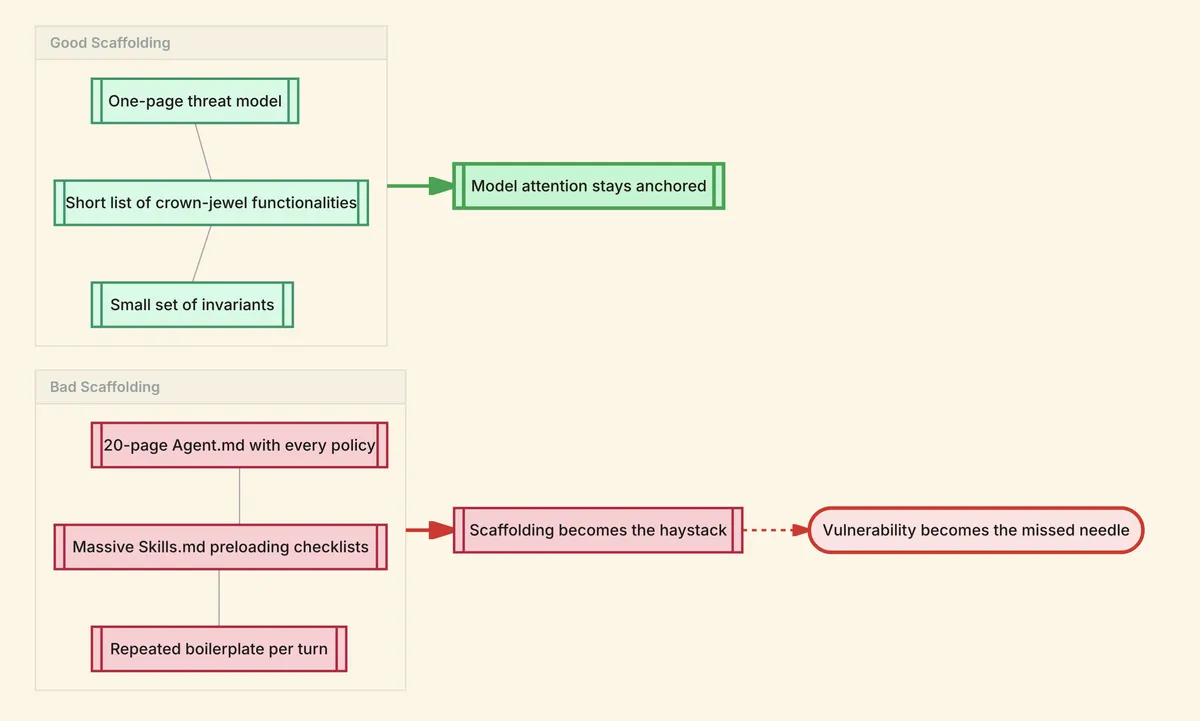
The Sweet Spot: 좋은 스캐폴딩의 크기를 원문에서 가장 구체적으로 정한 절이다. 좋은 쪽은 한 쪽짜리 위협 모델과 짧은 불변식 목록이다. 나쁜 쪽은 20쪽짜리 Agent.md와 보안 체크리스트를 미리 싣는 Skill.md 묶음이다. 저자는 토큰 예산을 스캐폴딩 10% 미만, 조각 감사 60~80%, 검증 루프 20~30%로 나누라고 권한다.
Case Study: Claude Opus 4.6 and Firefox: 원문 순서로는 저자 사례보다 앞이다. 저자 방식의 비교군이므로 저자 사례 뒤에 읽는다. 저자에 따르면 Anthropic은 스캐폴딩을 거의 쓰지 않은 채 Firefox의 JavaScript 엔진이라는 좁은 조각에서 시작했다. 저자가 옮긴 수치는 약 2주, 취약점 22건, 그중 Mozilla가 high-severity로 평가한 14건, API 크레딧 약 4,000달러다. 저자는 Anthropic이 익스플로잇 가능한 취약점만 보고해야 해서 그 확인 사슬에 4,000달러를 썼다고 읽는다. Anthropic 글은 다르게 적는다. Mozilla 연구자의 권유로 보안 영향이 불확실한 크래시 입력까지 하나하나 검증하지 않고 일괄 제출했다. 4,000달러는 제출한 취약점으로 익스플로잇 작성을 따로 시험한 비용이다. 이 절의 Claude Opus 4.6은 Anthropic 작업에 쓰인 모델이다.
Prompt Injection: 조각과 위협 모델을 정한 뒤 프롬프트 문구를 고르는 기법 10개다. 저자는 "이 함수는 확실히 취약하고 보안 문제가 적어도 2~3개 있다"고 단정하는 기법을 가장 효과가 큰 기법으로 꼽는다. "이 코드는 안전한가" 대신 "어떻게 깨겠는가"로 묻는 뒤집기는 실행 가능한 발견을 2~3배 늘렸다고 저자는 보고한다. 원문은 이 배수를 몇 번의 비교에서 얻었는지 적지 않는다.
후속 게시물 (X, 2026-11-07): Minimal Scaffolding과 Prompt Injection 절을 읽은 뒤에 읽는다. 프롬프트 13개는 Prompt Injection 절의 "불변식을 나열한 뒤 깨 보게 하라" 기법을 앱 일반의 질문으로 굳힌 것에 가깝다. 13개는 네 묶음으로 읽힌다. 강제와 가정의 틈(1~4), 조합·경로·정체의 틈(5~7), 실패·순서·롤백의 틈(8~10), 수명과 상태의 틈(11~13)이다. 뮤테이터 문단과 저자 답글 셋은 이 질문을 대상마다 어떻게 바꾸고 어느 모델에 맡기는지를 말한다.
점검 질문
저자는 "find all vulnerabilities in this codebase" 프롬프트가 실패하는 원인을 두 가지 든다. 각 원인을 최소 스캐폴딩의 어느 요소가 막는가?
harden-runner와 BullFrog 감사는 같은 위협 질문에서 출발했다. 두 감사에서 모델이 짚은 공격 표면은 왜 달랐는가?
저자는 취약점이 있다고 단정하거나 지어낸 앵커("이미 하나 찾았다")를 주는 프롬프트도 통한다고 쓴다. 이렇게 얻은 발견이 진짜인지 가리는 장치를 원문은 어느 절에서 제시하는가? 저자가 이 글의 범위 밖으로 미룬 단계는 무엇인가?
이 글은 지나친 오케스트레이션을 취약점을 놓치는 길로 꼽는다. 후속 게시물의 에이전트 떼에서 에이전트 하나의 문맥에 들어가는 것은 무엇이고, 이 경고와는 어떻게 양립하는가?
Executive Summary
저자는 LLM 취약점 탐색의 열쇠로 긴 지침 대신 한 문장짜리 위협 모델과 얇은 코드 조각을 꼽는다
devansh는 대규모 언어 모델(Large Language Model, LLM)에게 지침을 더 줄수록 취약점을 더 놓친다고 주장한다. 그의 처방은 짧은 위협 모델로 모델의 주의를 신뢰 경계 하나에 묶는 것이다. 토큰 대부분은 그 경계에 맞춘 코드 조각의 감사와 검증에 쓴다. 근거로 그는 여러 프로젝트에서 이 방법으로 취약점 30건 넘게 찾았다고 보고한다. 이 보고에 붙은 기간 '약 두 달'과 '전부 LLM으로 찾았다'는 서술은 저자 자신의 상세 글과 어긋난다. 글은 devansh가 개인 블로그 devansh.bearblog.dev에 2026-03-10(페이지 표기) 올린 「Needle in the haystack: LLMs for vulnerability research」다.
저자는 이 글을 방법론 개요를 담은 연재 첫 편이라 밝힌다. 서문은 내용을 교육·연구 목적으로 한정한다. 오용 책임은 행위자 본인에게 있다고 적는다. 아래의 건수·배율·비용은 모두 저자의 보고이거나 저자가 옮긴 수치다.
같은 저자는 8개월 뒤인 2026-11-07 X 게시물에서 이 방법이 어디로 갔는지 공개한다. 그는 2026-09-03 X에 취약점 제보 한 건으로 $100,000 바운티를 받았다고 썼고, 이 게시물은 그 바운티 뒤의 탐색 질문 13개와 그것을 돌리는 구조다. 위협 모델이 질문을 대상에 맞게 바꾸고, 싼 오픈 웨이트 모델 떼가 범위가 정해진 목표를 하나씩 맡는다. 프런티어 모델은 쌓인 신호를 확인·분류하고 변종을 찾는 데만 쓴다. 바운티의 지급처와 취약점은 공개되지 않았다.
신뢰도 C — 공개 CVE·권고문과 사이버 모델 접근 제한은 1차 출처와 맞는다. 'LLM만으로 찾았다'는 핵심 서술은 저자 자신의 Elysia 상세 글과 충돌한다. $100,000 바운티는 지급처가 공개되지 않아 확인할 수 없다. 판정 53건은 팩트체크 블록에 있다.
지침이 길수록 모델은 문맥 가운데 묻힌 버그를 놓친다
저자는 취약점을 가장 빨리 놓치는 길로 지침 과잉 네 가지를 꼽는다. 그는 발행 전 몇 주 동안 보고한 보안 이슈를 수동 소스 코드 리뷰 없이 100% LLM으로 찾았다고 쓴다. 저자의 2026-01-10 Elysia 상세 글은 이 서술과 맞지 않는다. 그 글은 코드베이스를 훑다가 문제의 코드 블록이 눈에 띄었다고 쓰고 LLM을 언급하지 않는다. 대상은 Parse Server·HonoJS·ElysiaJS·harden-runner와 그 밖에 이름난 프로젝트 십여 곳이다. 저자는 이를 OpenAI Codex 같은 에이전트형 CLI·TUI가 심각한 취약점을 찾을 수 있다는 증거로 본다. 아래 네 가지는 프롬프트 수천 개를 보낸 끝에 얻은 결론이다.
프롬프트를 사슬로 엮어 감사 절차를 과하게 짜는 것
비대한 AGENT.md·SKILLS.md 파일
문서로 맥락을 과하게 주거나 모든 단계를 미리 계획하는 것
지나친 오케스트레이션
저자가 드는 기전은 긴 문맥의 신뢰도 저하다. 문맥 창에 토큰을 넣을수록 모델이 맞는 세부를 집어내는 신뢰도가 떨어진다. 넣은 내용이 주제와 관련 있어도 마찬가지다. 그는 이 현상을 Chroma 보고서가 붙인 이름인 context rot으로 부른다. 저자는 보안 감사를 이 문제의 최악 환경으로 본다. 찾는 '바늘'은 정상 코드 수천 줄 사이에 묻힌 미묘한 불변식 위반 하나인 경우가 많아서다.
저자는 자기 실험에서 초두·최신 효과(primacy/recency)도 봤다고 쓴다. 바늘이 문맥 처음이나 끝에 있으면 모델이 더 잘 찾는다. 가운데 묻히면 성적이 떨어진다. 참고문헌에는 같은 현상을 다룬 논문 Lost in the Middle을 단다.
지침을 아예 없애는 쪽은 더 큰 문제를 부른다고 저자는 쓰지만 설명은 뒤로 미룬다. 공개 취약점 식별 번호(Common Vulnerabilities and Exposures, CVE) 십여 건을 찾은 경험에서 그가 고정한 처방은 상시 지침 최소, 표적 탐색과 검증 최대다. 워크플로는 모델의 주의를 핵심 지점에 묶어 두어야 한다고 그는 쓴다.
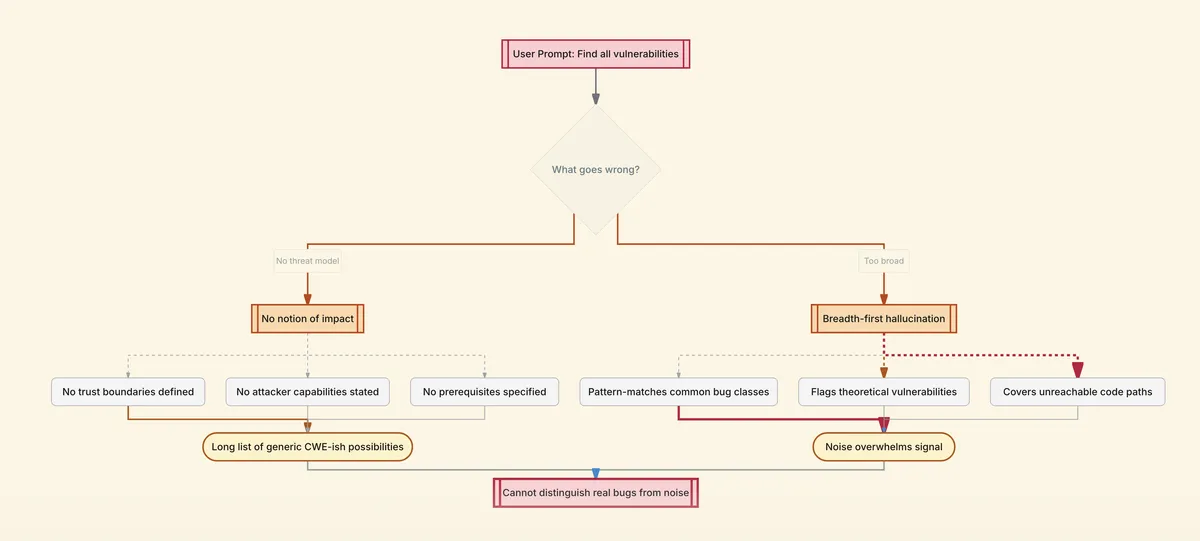
'모든 취약점을 찾아라'는 위협 모델 부재와 과도한 범위 때문에 실패한다
저자에 따르면 코드베이스에 "find all vulnerabilities in this codebase"를 던지는 프롬프트는 예측할 수 있는 두 이유로 실패한다.
영향 개념이 없다. 프롬프트에 위협 모델이 없으니 모델은 무엇이 피해인지 모른다. 저자의 실험에서 모델은 위협 모델을 스스로 거의 세우지 않거나 서툴게 세웠다. 신뢰 경계·공격자 능력·전제 조건이 빠진 결과는 우선순위 없는 흔한 약점 유형(Common Weakness Enumeration, CWE) 후보 목록이다. 사용자는 쓸 만한 발견을 잡음에서 골라낼 수 없다.
너비 우선 환각. 넓은 프롬프트는 넓은 답을 부른다. 모델은 흔한 버그 유형에 패턴을 맞춰 그 코드에서 불가능한 버그까지 보고한다. 사용자는 어떤 공격자도 닿지 못하는 코드 경로의 이론상 취약점을 검토하게 된다.
원문 그림. 두 실패 경로가 '진짜 버그와 잡음을 구분할 수 없음'이라는 한 결론으로 모인다.
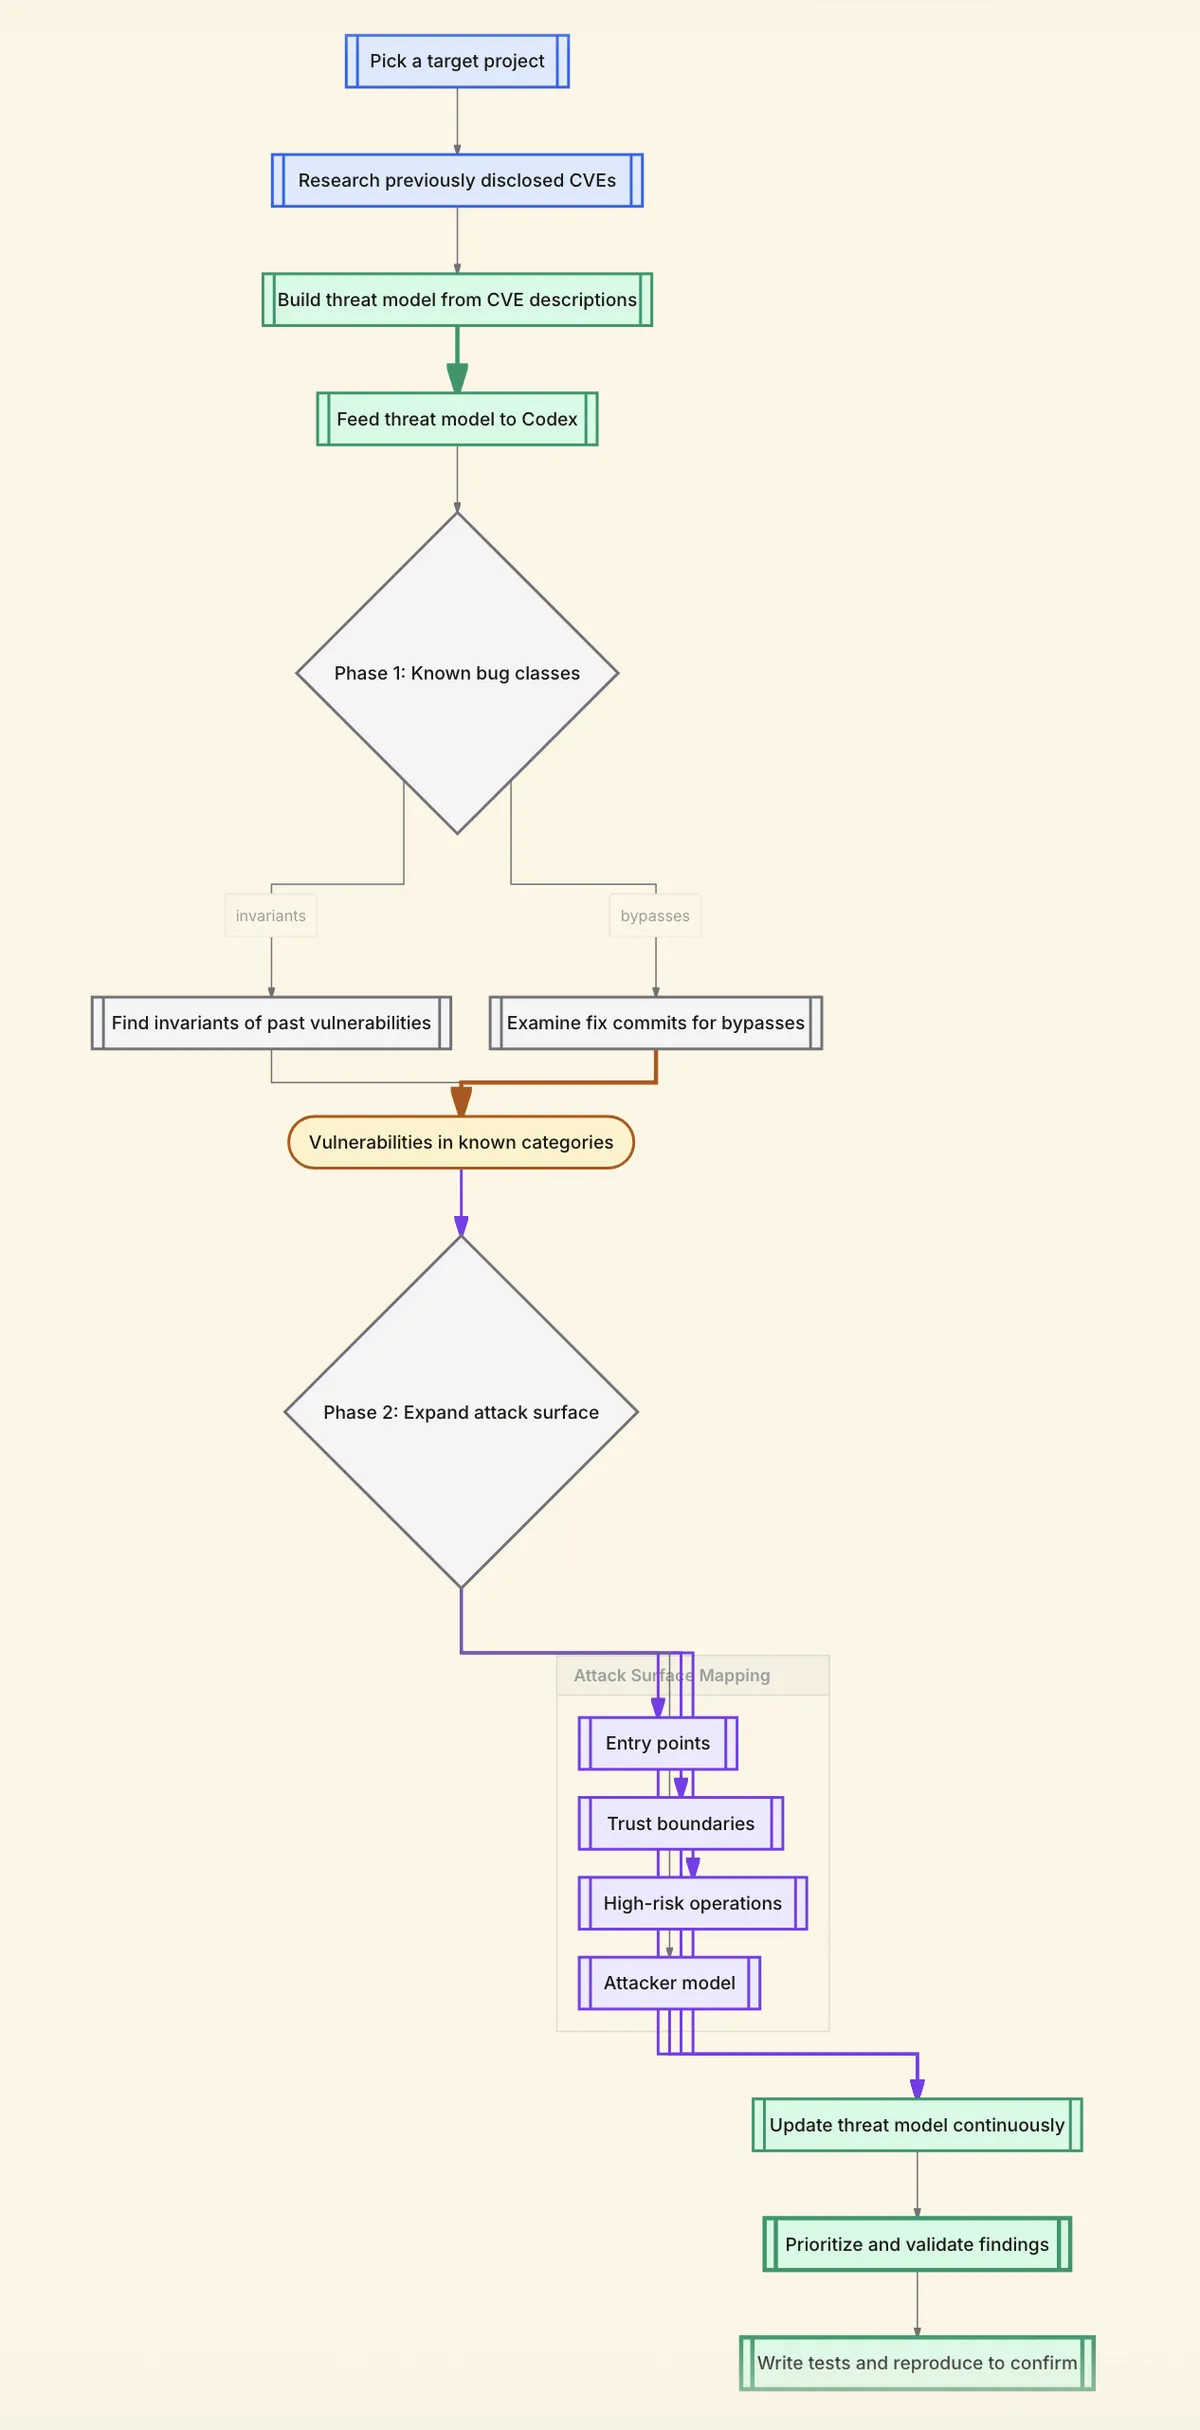
최소 지침은 과거 CVE에서 뽑아 계속 고쳐 쓰는 위협 모델 한 장이다
저자는 코드 감사를 맡기기 전에 사람 보안 팀처럼 위협 모델부터 세우라고 쓴다. 위협 모델도 LLM으로 만든다.
알려진 버그 유형부터. 그 프로젝트에서 이미 공개된 CVE를 모은다. CVE 설명을 LLM에 넘겨 그럴듯한 버그 유형의 위협 모델을 만들게 한다. 과거 CVE가 힙 오버플로·스택 오버플로·정수 오버플로·메모리 손상이었다면 위협 모델도 그 유형으로 선다. 프로젝트가 이미 진짜 취약점으로 받아들인 유형이기 때문이다. 이 문서를 Codex에 넘겨 그 불변식을 찾게 하거나, 과거 수정 커밋을 우회하는 길을 찾게 한다. 저자는 이쪽이 막연한 프롬프트보다 취약점을 더 많이 건진다고 본다.
공격 표면 넓히기. 과거 유형을 다 훑은 뒤에는 네 가지를 명시한다.
진입점: HTTP 라우트, RPC 핸들러, 메시지 소비자, CLI 진입점, 예약 작업
신뢰 경계: 브라우저→서버, 서비스→서비스, 플러그인→호스트, 샌드박스→특권 영역
고위험 연산: 역직렬화, 템플릿 처리, 네이티브 바인딩, 인가 검사, 신뢰할 수 없는 입력의 파싱
공격자-피해자 모델: 원격 비인증 사용자, 원격 인증 저권한 사용자, 다른 테넌트 사용자
이 과정에서 만든 지침은 위협 모델 하나뿐이다. skills.md도 agents.md도 쓰지 않는다. 저자는 위협 모델링을 "보안 감사의 궁극적 압축 알고리즘"이라 부른다. 문맥 창을 부풀리지 않고 신호를 높인다는 뜻이다.
그가 '유일하게 중요한 일'로 꼽는 것은 시스템 맥락을 먼저 세우는 일이다. 위협 모델은 고칠 수 있는 문서로 두어 감사 내내 늘린다. 발견의 우선순위와 검증도 그 문서로 정한다.
저자는 Anthropic의 Firefox 작업도 좁은 조각에서 시작해 넓힌 사례로 읽는다
저자가 인용한 Anthropic의 2026-03-06 글에 따르면 Claude Opus 4.6이 약 2주 동안 Firefox 취약점 22건을 찾았다. Mozilla는 그중 14건을 high-severity로 평가했다. Mozilla의 글은 보고서에 딸린 최소 테스트 케이스가 재현과 수정을 빠르게 했다고 적는다. 팀은 이 기법을 JS 엔진 밖 브라우저 전체로 넓혔다.
저자의 요약에서 Anthropic은 중요하면서 따로 떼어 분석할 수 있는 JavaScript 엔진 하나에서 시작했다. Claude는 약 20분 탐색한 뒤 해제 후 사용(use-after-free) 버그를 찾았다. 사람이 검증한 뒤 팀은 후보 패치를 붙여 Bugzilla에 보고했다. 워크플로가 통하자 팀은 규모를 키워 C++ 파일 약 6,000개를 훑었다. 고유 보고는 112건이었다. 수정 대부분은 2026-02-24에 나온 Firefox 148.0에 들어갔다(MFSA 2026-13).
저자의 평가는 유보적이다. 그는 Anthropic이 찾은 후보 상당수가 유효하지 않았다고 추정한다. 그가 보기에 Anthropic은 익스플로잇 가능한 취약점만 보고해야 했다. 잠재 취약점에서 익스플로잇 가능성 확인까지 가는 사슬은 비싸다. 저자는 이 사슬에 API 크레딧 약 4,000달러가 들었다고 쓴다. 원문 '익스플로잇 가능한 것만 보고' → 확인: Anthropic은 Mozilla 연구자의 권유로 보안 영향이 불확실한 크래시 입력까지 하나하나 검증하지 않고 일괄 제출했다. 약 4,000달러는 제출한 취약점으로 익스플로잇 작성을 수백 번 시험한 별도 평가의 비용이다. 저자는 그 금액을 개인 감사자가 쓰기 어려운 돈으로 본다. 개인이 다루는 코드도 Firefox 규모가 아니라고 덧붙인다.
저자가 보기에 Anthropic은 지침을 거의 쓰지 않았다. 그가 옹호하는 것은 위협 모델과 신뢰 경계 기술 정도의 최소 지침이다. 오탐 평가와 제거는 다른 글로 미룬다. 당장은 Codex에게 소스를 빌드해 로컬 인스턴스를 띄우게 하거나 취약점을 증명하는 테스트를 쓰게 하라고 권한다. 대부분 통한다고 한다.
여섯 대상에서 같은 절차가 서로 다른 위협 모델과 22건의 발견을 냈다
저자는 모든 감사를 같은 방식으로 시작했다고 쓴다. 얇은 조각 하나를 고른다. 그 조각의 신뢰 모델을 이해한 뒤에야 LLM에게 취약점을 찾게 한다. 대상마다 달라진 것은 위협 모델의 출처다. 발견은 LLM이 짚은 신호를 더 좁은 후속 프롬프트로 확인하는 식으로 나왔다.
여섯 대상의 감사. 건수·발견·CVE = 저자의 보고. 심각도 범위 = 원문 표의 등급 어휘(높은 순 Critical·High·Moderate·Low). 대기 = CVE 번호가 아직 없음(원문 Pending).
과거 CVE. 권한 검사가 있지만 불완전하거나 라우트 핸들러마다 들쭉날쭉한 인가 실패가 반복됐다.
① 문서가 '마스터 수준 읽기 허용, 쓰기 전부 거부'를 약속한 readOnlyMasterKey의 경계 ② 소셜 인증 어댑터
여러 핸들러가 isMaster만 보고 isReadOnly는 확인하지 않아 읽기 전용 키가 쓰기·상태 변경에 닿는다(CVE-2026-29182, CVE-2026-30228, CVE-2026-30229). 설정이 불완전하면 어댑터가 JSON 웹 토큰(JWT)의 aud 검사를 조용히 건너뛴다(CVE-2026-30863). 상세 보고
4건 · Critical–Moderate
HonoJS: Cloudflare Workers·Deno·Bun·Node.js에서 도는 경량 웹 프레임워크
적은 수의 과거 권고에 다른 프로젝트들의 JWT 구현 실수 패턴을 더했다. 알고리즘 혼동과 기본값 폴백이 후보로 나왔다.
JWT·JWKS 검증 경로의 알고리즘 선택 결정 트리(설정이 불완전할 때의 기본값·폴백 포함)
알고리즘을 고정하지 않으면 HS256이 기본값이 되어 공격자가 공개키를 HMAC 비밀로 써서 토큰에 서명한다(CVE-2026-22817). JWK에 alg가 없으면 토큰의 신뢰할 수 없는 header.alg를 따른다(CVE-2026-22818). 상세 보고
문서. 비밀키 교체(secrets rotation) 경로의 서명 검증이 고위험으로 나왔다.
쿠키 서명·검증 계층의 상태 관리
let decoded = false여야 할 초기값이 let decoded = true라서 비밀키 교체를 쓰면 서명 검증이 실패하지 않는다. CVE 대기. 상세 보고
1건 · High
harden-runner: StepSecurity의 GitHub Actions 러너 외부 송신(egress) 감시 도구(audit 모드 기록, block 모드 차단)
과거 권고와 문서화된 보안 모델. 질문 "러너에서 코드를 실행하는 공격자가 egress 통제를 넘어 데이터를 빼낼 수 있나?"에서 시스템 콜 감시 누락이 후보로 나왔다.
시스템 콜 감시 계층. 리눅스 네트워크 송신 시스템 콜 전체와 실제 후킹 목록의 차이
UDP 송신 계열 sendto·sendmsg·sendmmsg가 audit 모드의 감시 범위 밖이다(CVE-2026-25598). 상세 보고
1건 · Moderate
BullFrog: 도메인을 IP로 풀어 방화벽 규칙을 거는 GitHub Actions 외부 송신 필터
문서와 보안 모델. harden-runner와 같은 질문이지만 집행 방식이 달라 DNS 파싱 경계 사례, IP-도메인 결합, 권한 상승이 후보로 나왔다.
세 조각: DNS 파싱, 방화벽 규칙의 IP 결합, 권한 상승 제한
DNS 파서가 TCP 세그먼트의 첫 메시지만 검사한다(DNS 파이프라이닝). 방화벽이 허용한 IP를 요청 도메인과 묶지 않는다(공유 IP 우회). sudoers에서 빠져도 Docker 그룹 권한이 남는다(sudo 우회). CVE 번호 미기재
3건 · High
Better-Hub: GitHub 콘텐츠를 자기 출처(origin)에서 렌더링하고 GitHub OAuth 토큰을 쥐는 대체 프런트엔드
과거 CVE 없음. 아키텍처에서 나온 질문 "저장된 자격 증명에 닿는 문맥에서 사용자 통제 콘텐츠를 안전하지 않게 렌더링하면?"
세 조각: Markdown 렌더링, 캐시와 인가, OAuth 토큰 처리
정제되지 않은 같은 Markdown 경로에서 교차 사이트 스크립팅(XSS) 변종 6건. 비공개 저장소 내용이 비인증 사용자에게 새는 캐시 기반 인가 우회 2건. 비공개 프롬프트 데이터 유출, 클라이언트 측 OAuth 토큰 노출, 오픈 리다이렉트 각 1건. 상세 보고
11건 · Critical–Low
표의 합은 22건이다. 저자는 이것이 이 방법으로 찾은 취약점의 일부라고 쓴다. 상당수는 아직 수정이나 공개를 기다린다고 한다.
저자가 꼽는 공통점은 작지만 '맞는' 지침이다. 어느 감사도 거대한 체크리스트, 20쪽짜리 프롬프트 골격, 포괄적 보안 프레임워크를 쓰지 않았다. 출발점은 대개 한 문장짜리 위협 모델, 그리고 신뢰 경계나 보안 핵심 연산에 대응하는 코드 조각이었다. 그 지침이 어떤 불변식을 어디서 시험할지 LLM에게 알려 주었다고 저자는 쓴다.
적정점은 한 쪽짜리 지침과 조각 감사·검증 중심의 토큰 예산이다
저자는 좋은 지침과 나쁜 지침을 크기와 반복으로 가른다. 좋은 지침은 한 쪽짜리 위협 모델, 핵심 기능(crown-jewel)의 짧은 목록, 작은 불변식 묶음이다. 불변식의 예는 "X는 관리자만 호출할 수 있다"와 "JWT 발급자는 Y여야 한다"다. 나쁜 지침은 모든 정책과 스타일 가이드를 담은 20쪽짜리 Agent.md, 보안 체크리스트를 전부 미리 싣는 거대한 Skill.md 라이브러리, 매 턴 되풀이하는 상투 지시다. 저자는 지침이 건초 더미가 되면 취약점이 바늘이 된다고 쓴다. 건초 더미가 클수록 바늘을 더 자주 놓친다는 긴 문맥 연구가 그 근거다.
조각. 감사를 실제 공격 표면에 맞는 얇은 조각으로 나눈다. 저자가 드는 조각은 인증, 세션 관리, 요청 파싱, 파일 업로드, 역직렬화, 샌드박스 경계, 플러그인 경계다. 모델에게 그 조각의 진입점을 민감한 싱크(sink)까지 잇게 한다. 증거로는 정확한 호출 사슬, 가드, 불변식, 공격자가 통제하는 입력을 요구한다.
검증기. "모델이 취약하다고 했다"에 기대지 않는다. 저자가 드는 검증기는 단위·통합 테스트, 네이티브 코드용 새니타이저 빌드와 크래시 재현 하네스, 가벼운 것이라도 퍼저, 정적 분석과 grep 기반 불변식 검사, "이 엔드포인트는 인가가 막아야 한다" 같은 정책 검사다.
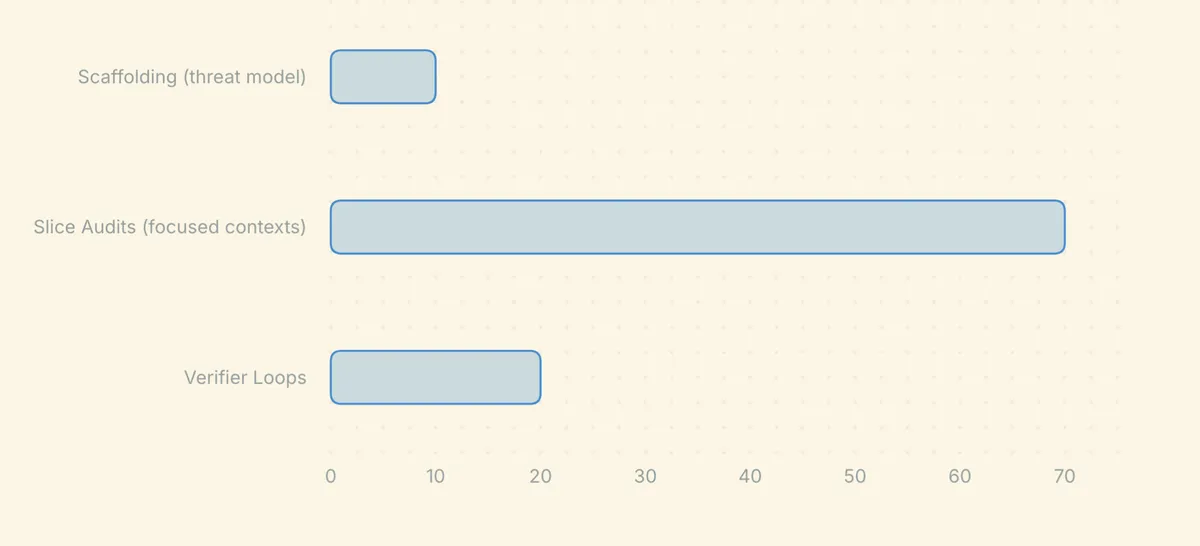
토큰 예산. 토큰은 프롬프트 관료주의 대신 커버리지와 검증에 쓴다. 저자의 경험칙은 안정된 지침(위협 모델·불변식)에 10% 미만, 집중된 문맥의 조각 감사에 60–80%, 증명·재현·축소·패치를 위한 검증 루프에 20–30%다.
원문 그림. 저자의 토큰 예산 경험칙을 그린 막대다. 가로축은 예산 비율(%)이다.
원문의 'Prompt Injection'은 저자가 자기 프롬프트 기법 10가지에 붙인 이름이다
원문의 "Prompt Injection" 절은 공격 기법인 프롬프트 인젝션을 다루지 않는다. 저자가 자기 프롬프트 작성 기법을 부르는 이름이다. 모델의 추론에 틀(frame)·편향·제약을 주입해 행동을 쓸모 있는 쪽으로 옮긴다는 뜻이라고 그는 쓴다. 저자는 위협 모델과 조각이 '맞는 동네'까지만 데려간다고 본다. 거기서 일반론 목록을 받을지 익스플로잇 가능한 발견을 받을지는 프롬프트 표현이 가른다. 근거는 감사 수십 건에 걸쳐 보낸 프롬프트 수천 개다.
취약점이 있다고 단정한다. "이 함수는 확실히 취약하고 보안 이슈가 적어도 2~3개 있다"고 말한다. 저자가 꼽은 가장 효과 큰 기법이다. LLM은 동의·확인 쪽으로 기울어서 "취약한가?"에는 "대체로 안전하다"로 빠지기 쉽다는 것이 그의 근거다. 단정은 목표를 '버그 유무 평가'에서 '있다는 버그 찾기'로 뒤집는다. 저자는 취약하다고 믿을 이유가 없어도 통한다고 쓴다.
평가 대신 익스플로잇을 요구한다. "이 입력 검증이 충분한가?" 대신 "이 검증을 우회하는 개념 증명(PoC) 요청을 써라"라고 묻는다. 페이로드를 만들려면 모델이 입력 처리를 단계별로 따라가야 한다. 검증이 튼튼하면 모델은 생성 도중 우회 실패를 깨닫곤 한다. 저자는 이것도 신호로 본다.
감사자 대신 적으로 설정한다. "보안 감사자" 틀과 "이 앱을 깨라고 돈을 받은 레드팀 운영자" 틀은 출력 분포가 다르다고 저자는 쓴다. 감사자 틀은 완전성으로 기울어 신호 낮은 관찰 목록을 낸다. 레드팀 틀은 영향과 익스플로잇 가능성으로 기운다. "이 인증은 근본적으로 깨졌다" 같은 불편한 결론도 덜 누그러뜨린다.
거짓 앵커로 탐색 압력을 만든다. "이 모듈에서 취약점 하나를 이미 찾았다. 아직 못 찾은 것은 무엇인가?"라고 말한다. 모델은 코드에 버그가 실제로 있다고 추론해 추가 버그의 사전 확률을 높여 잡는다. 저자는 실제로 하나를 찾았을 때 특히 잘 통한다고 쓴다. 앵커를 지어내도 통한다고 덧붙인다.
질문을 뒤집는다. "이 코드는 안전한가?" 대신 "어떻게 깨겠는가?"라고 묻는다. 앞의 물음은 모델이 '예'로 기우는 예/아니오 분류 문제다. 뒤의 물음은 쉬운 기본값이 없는 생성 문제다. 저자는 뒤집은 프롬프트가 실행 가능한 발견을 2~3배(원문 2-3x) 더 낸다고 쓴다.
불변식으로 분해한 뒤 깬다. 먼저 함수가 기대는 불변식·가정·전제 조건을 모두 나열하게 한다. 다음에 공격자가 각 가정을 깰 수 있는지 하나씩 묻는다. 저자는 나열과 평가를 떼어 놓는 데서 효과가 나온다고 본다. 둘을 한 프롬프트에 섞으면 모델이 일찍 적당히 만족한다는 것이다.
개발자가 실수했다고 가정한다. "개발자가 이 함수에 버그를 넣었다고 가정하라"고 묻는다. 단정 기법이 버그의 존재를 알린다면 이 기법은 코드 품질에 대한 사전 믿음을 낮춘다. 저자에 따르면 LLM은 패턴을 의도된 것으로 여겨 코드를 정당화하는 경향이 있다. 그의 예는 ElysiaJS의 let decoded = true다. 실수를 찾는 모델은 이 값에 이유를 붙이지 않고 잘못된 초기값으로 바로 짚는다.
알려진 안전 패턴과 비교시킨다. "이 구현은 이 패턴의 표준 안전 구현과 어떻게 다른가?"라고 묻는다. 학습 데이터에 JWT 검증·세션 관리·CSRF 방어의 옳은 구현과 틀린 구현이 수천 개 있다는 것이 저자의 근거다. 그는 옳은 방법 하나에 틀린 방법이 여럿인 암호·인증 코드에서 특히 잘 통한다고 쓴다.
"또 뭐가 있나?"로 거듭 밀어붙인다. 첫 발견을 완결로 받지 않는다. "그건 뻔한 것들이다. 놓치기 쉬운 미묘한 이슈는?" 또는 "이미 찾은 유형은 빼고 다른 유형은?"이라고 되묻는다. 저자는 LLM이 확률 높은 완성을 먼저 내놓아서 미묘한 버그가 분포의 꼬리에 남는다고 본다. 그는 보통 2~3라운드(원문 2-3 rounds) 뒤에 신호가 떨어진다고 쓴다.
공격자 모델을 명시적으로 좁힌다. "너는 공개 API에 HTTP 요청만 보낼 수 있는 원격 비인증 공격자다. 파일 시스템·데이터베이스·내부 서비스에는 접근할 수 없다"처럼 지정한다. 저자에 따르면 이 제약은 "DB 접근 권한이 있다면" 같은 오탐을 통째로 없앤다. 좁은 제약 안에서 모델은 더 힘들게 경로를 찾는다. 저자는 그 경로가 방어자가 간과해 실제 공격자가 쓰는 경로라고 쓴다.
근거는 대조군 없는 저자 한 사람의 작업 기록이다
글의 수치는 모두 저자 자신의 감사 기록에서 나온다. 저자도 결론이 이론상 정확하지 않을 수 있는 실용적 결론이라고 적는다. 건수는 절마다 세는 단위가 다르다. 서두는 CVE 십여 건 넘게, 방법론 절은 약 두 달 동안 취약점 30건 넘게라고 쓴다. 상세 글의 보고일로 세면 그 기간은 99일이다. 표에 번호가 실린 CVE는 7개다. 최소 지침이 막연한 프롬프트로는 결코 나오지 않는 함정(footgun)과 경계 동작까지 준다는 주장에도 같은 대상에 막연한 프롬프트를 돌린 비교는 없다.
2~3배라는 배율에도 측정 방법이 붙어 있지 않다. 단정과 거짓 앵커가 모델에게 없는 버그를 지어내게 하는 비율도 재지 않았다. 이 기법들이 낸 결과는 앞 절의 검증기를 거친 뒤에야 발견으로 셀 수 있다. 저자가 후속 편 몫으로 남긴 것은 오탐 평가, 지침 없이 LLM을 풀어 둘 때의 문제, AI 기반 차분 퍼징·문법 기반 퍼징·하네스 자동 생성의 세부다. 위협 모델 한 장이 발견을 얼마나 바꾸는지는 같은 코드에 두 방식을 나란히 돌린 측정이 나와야 답할 수 있다.
후속 게시물(2026-11-07): 바운티 뒤의 질문 13개를 싼 모델 떼에 돌리고, 프런티어 모델은 확인에만 쓴다
devansh는 2026-11-07 14:14 UTC X 게시물에서 바운티(와 그 밖의 여러 건) 뒤의 프롬프트와 사고 과정을 글 대신 게시물로 푼다. 게시물은 그가 2026-09-03에 올린 "취약점 제보 한 건으로 $100,000 버그 바운티를 받았다"는 게시물을 인용한다. 그 인용 게시물에 붙은 이미지는 잔액 화면 한 장이다.
저자는 반론을 먼저 받아들인다. 프런티어 모델의 기본 지능만으로도 취약점 발견이 꽤 된다는 말은 상당 부분 맞다고 쓴다. 그래도 이 프롬프트를 쓰는 이유로 두 가지를 든다.
사이버 모델에 접근하지 못할 가능성이 높고, 접근해도 비싸고 가드레일이 강하다.
오픈 웨이트·저가 모델은 목표가 모호한 열린 탐색보다 목표가 정해진 탐색에서 훨씬 잘한다. 두 경우 모두 탐색 공간은 거대하다. 이 프롬프트가 프런티어 모델의 능력을 이긴다는 주장은 아니라고 저자는 선을 긋는다.
공개한 프롬프트는 13개이고 모두 "~를 찾아라" 꼴이다. 저자는 이것을 변형해서 원하는 곳에 적용하라고 한다. 13개는 앱이 지켜야 할 조건이 어디서 새는지를 네 방향에서 묻는다.
강제와 가정의 틈(1~4): 강제해야 하는데 강제하지 않는 곳, 한 곳에서 강제한 규칙을 다른 곳에서 가정만 하는 곳, 확인하지 않는 보안 가정, 문서화되지 않은 동작에 대한 의존.
조합·경로·정체의 틈(5~7): 하나씩은 안전한데 이어 붙이면 취약해지는 작업, 접근 경로마다 권한이 다른 객체, 검사 없이 다른 사용자에게 다시 묶이는 객체.
실패·순서·롤백의 틈(8~10): 거부·실패한 요청의 부수 효과, 이벤트 순서에 기대는 보안 검사, 롤백 뒤에도 남는 부수 효과.
수명과 상태의 틈(11~13): 삭제·권한 회수 뒤에도 가능한 작업, 권한 없는 사람이 되돌리는 상태 변경, 서로 모순되는 두 상태에 동시에 놓이는 객체.
저자는 이 프롬프트를 뮤테이터에 넣는다. 뮤테이터는 진단 대상 프로젝트의 위협 모델을 들고 있다가 프롬프트를 그 위협 모델에 맞게 변형한다. 변형된 프롬프트마다 범위가 정해진 목표를 가진 에이전트가 하나씩 뜬다. 이 반복은 모든 경로가 소진되거나 새 신호가 나올 때까지 이어지고, 새 신호는 다시 뮤테이터로 들어간다. 이 단계를 싼 모델로 돌리면 효과가 크고, 가끔은 비싼 모델이 놓친 것도 건진다고 저자는 쓴다. 신호가 충분히 쌓이면 프런티어 모델이 이슈를 확인·분류하고 같은 부류의 변종을 찾는다. 저자는 커스텀 하네스에는 해자가 거의 없다고 본다. 예외는 자기 접근법을 코드로 녹일 수 있는 엘리트 연구자나 '100배 에이전틱 엔지니어'이고, 자신은 둘 다 아니라고 쓴다.
저자의 답글 세 개가 구조를 보탠다.
14:20 UTC: 에이전트 떼를 띄우는 시스템과 메모리 + RAG 구성은 곧 따로 올리겠다고 예고한다. 그 메모리에는 전문 writeup과 틈새 정보가 들어 있고 주로 블랙박스 진단용이다. 그 전에는 deepseek 하네스(플러그인·서브에이전트 구조), omp, opencode 저장소를 공부해 비슷한 것을 만들 수 있다고 한다. 자기 용도에는 마음대로 고칠 수 있는 작은 장난감 프로젝트가 맞았다고 쓴다.
15:50 UTC: 기본 프롬프트로 충분하지 않느냐는 질문에, 블록체인 검증자와 imagemagick은 위협 시나리오가 크게 다르다고 답한다. 기본 프롬프트에는 도달할 구체적 목표가 없어서 뮤테이터가 필요하다는 것이다.
19:53 UTC: 지금 쓰는 하네스를 묻자 "codex + 직접 만드는 실험적 하네스"라고 답한다.
팩트체크
권고문 숫자는 1차 출처와 맞지만, 방법론을 받치는 저자 서술 일부는 저자 자신의 상세 글과 어긋난다
C
공개 CVE·권고문과 사이버 모델 접근 제한은 1차 출처와 맞는다. 'LLM만으로 찾았다'는 핵심 서술은 저자 자신의 Elysia 상세 글과 충돌한다. $100,000 바운티는 지급처가 공개되지 않아 확인할 수 없다.
판정 기호와 건수
기호
뜻
건수
✅
사실 — 1차 출처 문장과 맞는다
25
🟡
부분 사실 — 일부만 맞거나 출처·조건이 다르다
15
⚠️
확인 불가 — 외부 출처가 없다(자기 보고·미등록 상태)
10
❌
거짓 — 1차 출처와 어긋난다
3
Anthropic·Mozilla의 Firefox 사례
✅
Anthropic의 2026-03-06 글: Claude Opus 4.6이 약 2주 동안 Firefox 취약점 22건을 찾았다. Mozilla는 그중 14건을 high-severity로 평가했다.
Anthropic 글이 22건·2주·14건과 평가 주체 Mozilla를 그대로 적는다. 원문 링크 'Anthropic's March 6, 2026 write-up' → 실제 대상은 같은 날 나온 Mozilla 블로그 글이다. 해당 Anthropic 글은 아래 링크다.
Firefox 글은 스캐폴딩 규모를 적지 않는다. 발견을 도운 도구로 'task verifier'를 든다. '맞춤 스캐폴딩 없이'라는 표현은 2026-02-05 Frontier Red Team 글이 오픈소스 high-severity 취약점 500여 건을 두고 쓴 것이다.
최근 연구는 문맥이 길어질수록 성능이 점점 불안정해지는 현상을 context rot이라 부른다. 더한 내용이 관련 있어도 그렇다.
Chroma 기술 보고서(2025-07-14, Kelly Hong·Anton Troynikov·Jeff Huber)가 LLM 18종으로 이 현상을 잰 뒤 이름을 붙였다. 원문 '관련 있는 내용을 더해도' → 확인: 보고서가 잰 조건은 질문과 무관한 내용과 방해 문장(distractor)을 더한 경우다.
시스템 맥락을 먼저 만들고 편집 가능한 위협 모델을 세운다. 그 모델로 우선순위를 매기고 검증한다.
본문은 이 절차를 출처 없이 제시한다. 같은 단계가 OpenAI Codex Security 소개 글(2026-03-06)에 'Build system context and create an editable threat model'로 나온다. 원문은 이 글을 참고문헌에만 올렸다.
GPT-6 Cyber는 100만 토큰당 입력 $20·출력 $100, Mythos 5.1은 $10/$50부터다. Gemini 4 Carbon은 도입가 이후 $4/$20이다. AISLE이 쓴 소형 오픈 웨이트 모델은 100만 토큰당 $0.11이다. OpenAI·Anthropic 쪽은 수십~수백 배 비싸고, Google 쪽은 그 격차가 훨씬 작다.
무거운 것은 접근 통제다. OpenAI 개인 접근은 FIDO2 하드웨어 키를, Daybreak Red API는 IP 허용 목록을 요구한다. Mythos 5.1은 30일 데이터 보존이 기본 조건이다. 거절 수준은 반대 방향이다. OpenAI는 GPT-5.5-Cyber를 보안 작업에 더 허용적으로 훈련했다고 밝힌다. Anthropic은 일반 공개 모델이 사이버 작업 대부분을 막는다고 쓴다.
Sean Heelan의 o3 실험에서 입력이 약 2.7만 토큰일 때 100회 중 8회 찾던 버그를 약 10만 토큰에서는 1회 찾았다. CyberGym에서 단서 없는 level 0의 재현율은 3.5%다. 두 결과 모두 오픈 웨이트 모델만의 비교가 아니고, 모든 모델이 범위 축소로 이득을 본다는 결과다.
AISLE(2026-04-07)은 소형 오픈 웨이트 모델도 관련 함수를 떼어 주면 핵심 분석을 해낸다고 보고한다. AISLE은 그 결과가 완전 자율 스캔의 상한이라고 단서를 단다. 2026-04-14 후속 글은 이 방식이 복잡한 논리 버그를 놓치기 쉽다고 쓴다. 후속 게시물의 프롬프트 13개가 겨누는 권한·상태 결함이 그 영역이다.
AISLE의 소형 모델 스캔이 이전 AI 감사·도구·사람이 보고하지 않은 FreeBSD 커널 버그를 찾았다. CyberGym에서는 모델마다 푸는 문제가 달라 합집합 27.2%가 최고 단일 모델 17.9%보다 높다. 같은 버그를 두고 싼 모델과 비싼 모델을 직접 비교한 실험은 없다. Glasswing 파트너는 반대로 Mythos가 이전 세대가 놓친 취약점을 찾았다고 말한다.
AISLE도 소형 모델 후보 가운데 상위 30~40건만 코딩 어시스턴트로 다시 검토했다. 확인 단계가 필요한 근거도 있다. Heelan의 o3 실험은 신호 대 잡음비가 약 1:50이었다. curl은 확인된 제보 비율이 5% 아래로 떨어지자 2026-01 버그 바운티를 닫았다.
참고: 처음에는 내가 쓰는 기법 이면의 방법론 전체와 모든 기술적 세부 사항을 한 편의 글로 다룰 생각이었다. AI 기반 차분(differential) 퍼징과 문법 기반(grammar-based) 퍼징, 자동 하니스(harness) 생성, 그리고 관련 워크플로까지 포함해서 말이다. 하지만 모든 것을 한 글에 몰아넣으면 쓸데없이 빽빽하고 따라가기 어려운 글이 된다는 것을 깨달았다.
그래서 이 글은 그 첫 편으로서, 방법론의 상위 수준 개요와 이 접근법 이면의 핵심 아이디어를 보여 준다. 이후의 글에서 각 구성 요소의 기술적 세부 사항과 구현 측면을 더 깊이 다룰 것이다.
여기서 공유하는 모든 내용은 엄격히 교육과 연구 목적만을 위한 것이다. 여기서 논의한 정보를 이용해 저지른 어떤 오용이나 악의적 활동이든, 그 책임은 전적으로 그 일을 한 개인에게 있다.
인트로 로어(Intro Lore)
지난 몇 주 동안 나는 보안 이슈를 잔뜩 제보했다. 이 취약점들 가운데 일부는 이제 수정되었고, 보안 권고문 형태로 공개되었다. 이 취약점들은 전부 수동 소스 코드 리뷰 없이 100% LLM만으로 찾았다. 내가 이 취약점들을 찾은 프로젝트들은 꽤 잘 알려져 있고 널리 쓰인다. 그중에는 Parse Server, HonoJS, ElysiaJS, Harden Runner 같은 큰 이름들이 있고, 그 밖에도 큰 이름이 십여 개 더 있다.
나는 이것이 OpenAI Codex 같은 에이전트형 CLI와 TUI가 심각한 취약점을 찾는 데 틀림없이 도움이 될 수 있다는 것을 증명한다고 생각한다. 그런데 잘 드러나지 않는 취약점을 찾아내려면 이런 도구를 실제로 어떻게 써야 할까? 내 테스트를 바탕으로, 그리고 취약점을 찾으려고 수천, 수천 개의 프롬프트를 보낸 끝에 나는 몇 가지 결론에 이르렀다. 이론적으로 정확하지 않을 수도 있지만, 내가 도달한 결론 가운데 가장 실용적인 것들이다.
중요한 취약점을 놓치는 가장 빠른 길 몇 가지는 다음과 같았다.
프롬프트를 사슬처럼 이어 붙여 보안 감사에 스캐폴딩(scaffolding)을 과하게 씌우기
비대해진 AGENT.md/SKILLS.md 파일
문서 형태로 컨텍스트를 너무 많이 주거나, 과정의 모든 단계를 미리 계획하기
지나치게 많은 것을 오케스트레이션하려 하기
그런데 이건 직관에 반하는 말처럼 들리지 않나? 제정신인 사람이라면 누구나 안내가 많을수록 결과가 좋아야 한다고 생각할 것이다, 그렇지? 하지만 긴 컨텍스트 시스템에는 아주 실재하고 잘 연구된 문제가 있다. 컨텍스트 윈도(context window)에 토큰을 더 많이 채워 넣을수록, 올바른 세부 사항을 골라내는 모델의 신뢰도가 떨어진다. 최근 연구는 이것을 명시적으로 컨텍스트 부패(context rot)라고 부른다. 추가된 내용이 엄밀히 말해 관련 있는 내용이라 해도, 컨텍스트 길이가 늘수록 성능이 점점 더 믿을 수 없게 되는 현상이다. 보안 감사는 이 문제에 최악의 환경이다. “바늘(needle)”은 대개 수천 줄의 정상적인 코드 사이에 묻힌, 미묘한 불변식(invariant) 위반 하나다. 내 테스트를 바탕으로, 나는 많은 경우 모델이 초두·최신 효과(primacy/recency) 같은 행동을 보인다는 것을 발견했다. 관련된 “바늘”이 컨텍스트의 처음이나 끝 가까이에 있으면 더 잘하고, 가운데 묻혀 있으면 더 못한다. 이것이 가장 순수한 형태의 건초 더미(haystack) 속 바늘 문제다.
그럼 어떻게 해야 할까? AGENTS.md 파일을 없애고 스캐폴딩 없이 LLM을 마음대로 날뛰게 둬야 할까? 그러면 훨씬 더 큰 문제들이 생기는데, 그건 다른 기회에 다룰 주제다. 지금으로서는, 인기 있는 오픈소스 프로젝트에서 CVE를 십여 개 넘게 찾으며 얻은 테스트와 경험을 바탕으로 내가 확실히 정리한 것은 이렇다. 요령은 최소한의 지속적 스캐폴딩, 최대한의 표적 탐색과 검증, 그리고 모델의 주의를 중요한 것에 붙잡아 두는 워크플로다.
“모든 취약점을 찾아라”가 통하지 않는 이유
거대한 단일 덩어리(monolithic) 소스 코드가 든 큰 폴더가 있다고 해 보자. 아니면 GitHub에서 저장소를 클론해 왔고, 그 소스 코드에서 보안 취약점을 찾고 싶다고 해 보자. 가장 먼저 하는 일은 Codex를 띄우고 “이 코드베이스의 모든 취약점을 찾아라”라는 프롬프트를 입력하는 것이다. 그런데 이 프롬프트는 예측 가능한 두 가지 이유로 실패한다.
그 프롬프트를 줄 때 당신은 어떤 위협 모델(threat model)도 지정하지 않았다. 그 결과 LLM에게는 영향(impact)이라는 개념이 없다. LLM이 어떤 식으로든 위협 모델을 도출할 수는 있지만, 대체로 그러지 않거나 서투르게 한다. 이것은 내 실험에 근거한 이야기다. 제대로 된 위협 모델, 신뢰 경계(trust boundary), 공격자 능력, 전제 조건이 없으면, 당신이 얻는 발견 사항은 우선순위 없는 CWE 비슷한 일반적 가능성의 긴 목록이 될 것이다. 그 긴 잡음 목록에서 흥미로운 발견 사항을 가려낼 방법이 없을 것이다.
두 번째 이유는, 그 프롬프트가 모델을 너비 우선 환각(breadth-first hallucination)으로 밀어 넣었다는 것이다. 넓은 프롬프트가 넓은 답을 부른다는 것은 우리가 아는 사실이다. 모델은 흔한 버그 유형을 찾으려고 패턴 매칭을 할 것이다. 그 버그가 당신의 코드 맥락에서는 성립할 수 없는 경우에도 말이다. 결국 당신은 어떤 공격자도 도달할 수 없는 코드 경로에 있는 이론상의 취약점을 검토하게 된다.
실제로 도움이 되는 최소한의 스캐폴딩
막연한 프롬프트가 무엇을 낳을 수 있는지 보았으니, 이제 제대로 해 보자. 취약점을 찾으려고 LLM에게 코드 감사를 시키기 전에, 사람으로 이루어진 보안 팀이 하는 일, 즉 위협 모델을 파악하는 일을 먼저 해 보라. 이것도 LLM으로 만들어 낼 수 있다.
내가 보통 하는 일은 그 프로젝트에서 이전에 공개된 CVE를 찾아보는 것이다. 그리고 그 CVE들의 설명을 바탕으로, 우리가 모은 CVE 설명에 근거해 그럴듯한 버그 유형에 대한 위협 모델을 만들라고 LLM에게 프롬프트를 준다.
예를 들어 이전에 공개된 CVE들이 힙 오버플로, 스택 오버플로, 정수 오버플로, 메모리 손상과 관련된 것이었다고 하자. 그러면 LLM은 이런 종류의 취약점에 대한 위협 모델을 세우려 할 것이다. 이것들이 그 프로젝트가 이전에 실제 취약점으로 받아들인 것들이기 때문이다.
이제 방금 만든 그 위협 모델 문서를 Codex에 넣고, LLM에게 그 불변식을 찾으라고 하거나, 이 취약점들을 고친 커밋을 찾아 그 우회 방법을 찾아보라고 하라. 그러면 막연한 프롬프트를 줄 때보다 더 많은 취약점을 건질 가능성이 높다.
이 경우 당신이 한 최소한의 스캐폴딩은 위협 모델을 만든 것이었다. 그 밖에 우리는 skills.md 파일도 agents.md 파일도 만들지 않았다. 당신은 많은 것을 오케스트레이션하려 하지도 않았다. 그저 위협 모델을 만들어 LLM에게 주었을 뿐이고, 이제 LLM이 코드베이스를 깊이 조사해 그 위협 모델에 들어맞는 취약점을 찾으려 할 것이다.
이전에 공개된 CVE와 같은 범주에 드는 취약점을 찾는 일을 마쳤다면, 이제 진입점을 파악해 보라. HTTP 라우트, RPC 핸들러, 메시지 소비자, CLI 진입점, 예약 작업 같은 것들이다. 브라우저에서 서버로, 서비스에서 서비스로, 플러그인에서 호스트로, 샌드박스에서 특권 영역으로 같은 신뢰 경계를 파악하라. 역직렬화, 템플릿 처리, 네이티브 바인딩, 인가(authz) 검사, 신뢰할 수 없는 입력의 파싱 같은 고위험 연산을 파악하라. 그리고 공격자-피해자 모델을 명시적으로 밝혀라. 예를 들어 원격의 인증되지 않은 사용자, 원격의 인증된 저권한 사용자, 또는 다른 테넌트의 사용자가 일으킬 수 있는 취약점을 찾고 싶다고 말이다.
이것이 컨텍스트 윈도를 부풀리지 않으면서 신호를 개선하는 작은 구조다. 위협 모델링은 보안 감사를 위한 궁극의 압축 알고리즘이다.
중요한 것은, 아니 유일하게 중요한 것이라고 해도 좋은데, 시스템 컨텍스트를 먼저 세우는 것이다. 그다음 수정 가능한 위협 모델을 만든다. 보안 감사를 진행하면서 그 위협 모델을 계속 확장한다. 새로운 것을 계속 추가하고, 그 위협 모델을 써서 발견 사항의 우선순위를 정하고, 결국 검증한다.
사례 연구: Claude Opus 4.6과 Firefox
Anthropic의 2026년 3월 6일 글은 Mozilla와의 협업을 설명한다. 이 협업에서 Claude Opus 4.6은 약 2주 동안 취약점 22개를 발견했고, Mozilla는 그중 14개를 고위험(high-severity)으로 평가했다. Mozilla 자신의 글도 이 결과를 확인하며, 이것이 실제로 왜 통했는지를 강조한다. 보고서에는 재현과 수정을 빠르게 해 주는 최소 테스트 케이스가 딸려 있었고, 팀은 이 기법을 JS 엔진 너머 브라우저 전반으로 넓혔다.
Anthropic이 실제로 한 일
Anthropic의 설명은 “우리가 메가 프롬프트를 썼다”가 아니다. 오히려 다음에 가깝다. 그들은 코드베이스에서 초점을 좁힌 한 슬라이스(slice), 즉 JavaScript 엔진에서 시작했다. 그 부분이 핵심적이고 따로 떼어 분석할 수 있기 때문이다. 그들은 빠르게 반복했다. Claude는 약 20분 동안 탐색한 끝에 use-after-free를 찾았고, 사람들이 그것을 검증했으며, 그들은 후보 패치와 함께 Bugzilla 보고서를 제출했다. 워크플로가 제 몫을 한다는 것이 입증되자 그들은 규모를 넓혔고, 결국 약 6,000개의 C++ 파일을 스캔해 고유 보고서 112건을 제출했다. 수정 대부분은 Firefox 148.0(2026년 2월 24일 출시)에 들어갔다.
그럼 이것이 올바른 접근법일까? 그럴 수도, 아닐 수도 있다. 문제는 Anthropic이 찾았을 취약점 중 상당수가 유효하지 않았으리라는 점이다. 그들은 익스플로잇 가능한 취약점을 보고해야 했고, 익스플로잇 가능한 벡터를 찾으려면 잠재적 취약점에서 출발해 그것을 검증하고, 다시 익스플로잇 가능한지 확인하는 데까지 가야 했다. 그 사슬은 아주 비싸다. Anthropic은 API 크레딧으로 약 $4,000를 썼다. 우리가 코드를 감사하면서 그만한 돈을 쓸 수 있을까? 아마 아닐 것이다. 하지만 우리가 Firefox와 같은 규모의 코드를 다루고 있나? 그것도 아니다.
Anthropic은 스캐폴딩이 거의 전혀 없이 그것을 해냈다. 하지만 내가 주장하려는 것은 위협 모델을 만들고 신뢰 경계를 먼저 서술하는 형태의 최소한의 스캐폴딩을 두자는 것이다. 그리고 이것은 취약점을 찾는 일에 관한 이야기일 뿐이다. 나는 찾은 취약점을 평가하고 오탐(false positive)을 걸러 내는 데까지는 정말로 들어가지 않는다. 그쪽으로 나아갈 방법과 접근법이 있지만, 그건 아마 다른 블로그 글의 주제일 것이다. 지금 당장 할 수 있는 것은 이렇다. 위협 모델을 만든 뒤 LLM이 취약점을 몇 개 찾아내고 있다면, Codex에게 소스를 빌드한 뒤 로컬 인스턴스를 띄우라고 하거나, 취약점의 존재를 증명하는 테스트를 쓰라고 지시할 수 있다. 대부분의 경우 이것은 통한다.
나의 방법론
최소한의 스캐폴딩은 아주 잘 통하며, 막연한 프롬프트로는 결코 얻을 수 없는 훨씬 많은 취약점, 그리고 몇몇 발등 찍기 쉬운 함정(footgun)과 엣지 동작(edge behavior)까지 찾아 준다. 나는 이것을 내 최근 작업으로 보여 주려 한다. 이 작업으로 나는 약 두 달 동안 여러 다른 프로젝트에 걸쳐 30개가 넘는 취약점을 발견했다.
접근법
모든 감사는 같은 방식으로 시작했다. 얇은 슬라이스 하나를 고르고, LLM에게 코드베이스의 취약점을 찾으라고 하기 전에 그 슬라이스의 신뢰 모델(trust model)을 이해하는 것이다.
Parse Server는 REST API, 실시간 쿼리, 푸시 알림, 클라우드 함수를 제공하는 오픈소스 백엔드 프레임워크다. 여러 인증 메커니즘을 지원하는데, 그중에는 문서가 마스터 수준의 읽기는 허용하되 모든 쓰기는 거부한다고 약속하는 readOnlyMasterKey도 있다.
LLM에게 무언가를 찾으라고 프롬프트를 주기 전에, 나는 Parse Server에서 이전에 공개된 CVE들을 가져왔다. 과거 권고문들에는 인가(authorization) 강제 실패라는 패턴이 반복해서 나타났다. 권한 검사가 있기는 했지만 불완전했거나, 라우트 핸들러마다 일관되지 않게 적용된 경우들이다. 나는 그 CVE 설명들을 LLM에게 넣고, 그 이력을 바탕으로 그럴듯한 버그 유형에 대한 위협 모델을 만들라고 했다. 모델은 인가 경계 강제(authorization boundary enforcement)를 지배적인 위험 범주로 꼽았다. 권한 수준이 서로 다른 여러 키 유형을 두는 Parse Server의 아키텍처를 생각하면 말이 되는 결과였다.
그 위협 모델은 readOnlyMasterKey를 흥미로운 신뢰 경계로 드러냈다. 주장은 단순하다. 한 키 유형은 다른 키 유형보다 엄격히 더 적은 능력을 가져야 한다. 나는 LLM을 이 경계에 겨누고, 서로 다른 키 유형이 인가 계층과 어떻게 상호작용하는지, 코드가 권한 분리에 대해 어떤 가정을 하는지, 그리고 그 가정이 어디서 무너질 수 있는지 탐색하라고 했다.
LLM은 한 가지 패턴을 짚은 공격 표면 지도를 가지고 돌아왔다. 여러 라우트 핸들러가 isMaster로 접근을 통제하지만 isReadOnly는 한 번도 확인하지 않는다는 것이었다. 그것이 신호였다. 나는 이어서 범위를 더 좁힌 프롬프트로, 이 패턴을 보이는 핸들러를 전부 열거하고, 읽기 전용 자격 증명이 그중 어느 것을 통해서든 쓰기나 상태를 바꾸는 연산에 도달할 수 있는지 추적하라고 했다.
네 취약점 가운데 세 개(CVE-2026-29182, CVE-2026-30228, CVE-2026-30229)가 바로 그 같은 근본 원인에서 나왔다. 이것들이 확인되자, 나는 비슷하게 안내하는 접근법으로 소셜 인증 어댑터를 겨냥한 별도의 슬라이스를 열었다. LLM을 인증 어댑터 계층에 겨누고, 토큰 검증 흐름, 어떤 클레임(claim)을 검사하는지, 설정이 일부만 있거나 빠져 있을 때 무슨 일이 일어나는지, 그리고 검증이 어디서 조용히 약해질 수 있는지 탐색하라고 했다. LLM은 JWT 수신자(audience) 검증 경로를 약점으로 지목했고, 후속 프롬프트로 네 번째 발견 사항인 CVE-2026-30863을 확인했다. 이것은 설정이 불완전할 때 어댑터가 aud 클레임 검사를 조용히 건너뛰는, 독립적인 JWT 수신자 검증 우회였다. 슬라이스는 달랐지만 접근법은 같았다.
HonoJS는 JavaScript와 TypeScript용 경량 고성능 웹 프레임워크로, Cloudflare Workers, Deno, Bun, Node.js를 비롯한 여러 런타임에서 돈다. JWT와 JWKS 기반 인증을 위한 미들웨어를 기본으로 내장하고 있다.
나는 먼저 Hono의 과거 보안 권고문과, 인증 미들웨어에서 이전에 공개된 이슈들을 검토했다. CVE 이력(공개된 CVE는 아주 적었지만)과, 생태계 전반(다른 프로젝트들)에서 보이는 JWT 구현 실수의 일반적 패턴이 합쳐져, 내가 위협 모델을 만들라고 하자 LLM은 알고리즘 처리를 고위험 영역으로 가리켰다. 모델은 알고리즘 혼동(algorithm confusion)과 기본값 폴백(fallback) 동작을 가장 그럴듯한 버그 유형으로 표시했고, 덕분에 나는 명확한 슬라이스를 얻었다. JWT와 JWKS 검증 경로다.
그 위협 모델을 손에 쥐고, 나는 LLM에게 JWT 미들웨어의 알고리즘 선택 로직을 탐색하라고 지시했다. 특정 결함에 대해 묻는 대신, 개발자가 설정을 완벽하게 하지 않았을 때 무슨 일이 일어나는지, 어떤 기본값이 작동하는지, 어떤 폴백 경로가 있는지, 그리고 미들웨어가 어떤 알고리즘을 신뢰할지 어떻게 결정하는지를 차근차근 짚어 보라고 했다. 목표는 LLM이 알고리즘 선택의 결정 트리를 그려 내고, 미들웨어가 안전하지 않은 가정을 하고 있을 수 있는 분기를 모두 표시하게 하는 것이었다.
LLM은 분석에서 우려스러운 패턴 두 가지를 드러냈다. 첫째, 알고리즘을 명시적으로 고정(pin)하지 않으면 HS256으로 폴백한다는 점을 찾아냈다. 둘째, JWK 키 객체에 alg 필드가 없을 때 JWKS 미들웨어가 토큰의 header.alg 값을 따르는 동작을 표시했다. 나는 각각에 대해 표적 프롬프트로 후속 요청을 해서, 공격자가 이 폴백들을 악용할 수 있는 정확한 조건을 추적하라고 LLM에게 했다.
알고리즘 혼동 이슈 두 개가 나왔다. CVE-2026-22817은 알고리즘이 고정되지 않았을 때 JWT 미들웨어가 기본값으로 HS256을 써서, 공격자가 공개 키를 HMAC 비밀 키로 삼아 토큰에 서명할 수 있게 한 것이었다. CVE-2026-22818은 JWK에 alg 필드가 없을 때 JWKS 미들웨어가 신뢰할 수 없는 header.alg 값으로 폴백해서, 서버가 검증에 쓸 알고리즘을 공격자가 지정할 수 있게 한 것이었다.
ElysiaJS는 Bun을 위해 만든 TypeScript 웹 프레임워크로, 타입 안전성과 개발자 사용성(ergonomics)을 강조한다. 서명 기반 무결성 검증과 비밀 키 교체(secrets rotation) 지원을 갖춘 쿠키 처리 기능을 기본으로 내장한다.
위협 모델 생성은 같은 패턴을 따랐다. 나는 ElysiaJS의 문서를 살펴보았다. 그 컨텍스트를 LLM에게 넣고 그럴듯한 버그 유형을 파악하라고 하자, LLM은 서명 검증 로직을 고위험 영역으로 표시했다. 특히 비밀 키 교체 경로가 그랬는데, 이 경로에서는 여러 서명 키가 동시에 유효할 수 있고, 검증 로직은 그중 어느 것과도 맞지 않는 쿠키를 올바르게 거부해야 한다.
그것으로 좁은 슬라이스가 생겼다. 나는 LLM을 쿠키 서명·검증 계층에 겨누고, 검증 중의 상태 관리에 대해 추론하라고 했다. 코드는 서명이 성공적으로 검증되었는지를 어떻게 추적하는가, 교체된 여러 비밀 키를 차례로 돌았는데 하나도 맞지 않으면 무슨 일이 일어나는가, 그리고 로직이 무효한 서명을 조용히 받아들이게 만들 수 있는 초기화 가정이 있는가?
LLM은 decoded 상태 변수를 수상하다고 지목하고 그 초기화를 표시했다. 그 신호를 따라가, 나는 어떤 비밀 키도 일치하는 서명을 만들어 내지 못할 때의 제어 흐름을 추적하라고 했다. 그것으로 버그가 확인되었다. let decoded = false 대신 let decoded = true라고 쓴 불리언 초기화 오류 하나 때문에, 비밀 키 교체를 쓸 때는 서명 검증 검사가 절대 실패할 수 없었던 것이다. CVE는 아직 대기 중이다.
harden-runner는 StepSecurity가 만든 GitHub Actions용 보안 도구로, 시스템 콜(syscall)을 계측해 허가되지 않은 외부 송신(egress)을 탐지하는 방식으로 CI/CD 러너에서 외부로 나가는 네트워크 연결을 감시한다. 두 가지 모드로 동작한다. 감사(audit) 모드는 연결을 기록하고, 차단(block) 모드는 연결을 적극적으로 막는다.
나는 harden-runner의 이전 권고문과 문서화된 보안 모델을 검토했다. 이 도구의 가치 제안 전체는 외부로 나가는 네트워크 활동을 빠짐없이 볼 수 있다는 데 달려 있다. 그래서 내가 LLM에게 만들라고 한 위협 모델은 하나의 질문을 중심으로 했다. “GitHub Actions 러너에서 코드 실행 권한을 가진 공격자가 외부 송신 통제를 뚫고 데이터를 빼낼 수 있는가?” LLM은 시스템 콜 커버리지의 빈틈을 가장 가능성 높은 우회 유형으로 지목했다. 이 도구는 특정 시스템 콜을 후킹하는 방식으로 동작하므로, 감시 대상 집합 밖의 호출은 무엇이든 보이지 않을 것이기 때문이다.
그 위협 모델을 가지고, 나는 LLM을 시스템 콜 감시 계층에 겨누고 커버리지 표면을 탐색하라고 했다. 어떤 시스템 콜 계열이 후킹되고 있는가, Linux에서 프로세스가 네트워크로 데이터를 보낼 수 있는 방법에는 어떤 것들이 있는가, 그리고 둘 사이에 빈틈이 있는가? 발상은 LLM이 네트워크 관련 시스템 콜의 전체 집합을 열거한 다음, 그것을 harden-runner가 실제로 계측하는 것과 비교하게 하는 것이었다.
LLM은 UDP 송신 계열 시스템 콜이 감시되지 않을 수 있다고 표시한 빈틈 분석을 가지고 돌아왔다. 나는 후속으로 sendto, sendmsg, sendmmsg 가운데 정확히 어느 것이 커버되는지 검증하라고 했다. 우회는 위협 모델이 예측한 그대로였다. 그 시스템 콜들은 감사 모드에서 감시 범위 밖에 있었다(CVE-2026-25598).
BullFrog는 DNS를 인식하는 규칙으로 방화벽 수준의 외부 송신 필터링을 적용하는, 또 하나의 GitHub Actions용 보안 도구다. harden-runner의 시스템 콜 계측 방식과 달리, BullFrog는 네트워크 계층에서 동작한다. 도메인 이름을 IP 주소로 해석(resolve)하고, 그 해석 결과에 따라 방화벽 규칙을 적용한다.
나는 같은 과정을 따랐다. BullFrog의 문서와 보안 모델을 검토한 다음, 그 아키텍처 접근법을 바탕으로 위협 모델을 만들라고 LLM에게 했다. 공통 질문은 harden-runner 때와 같은 “GitHub Actions 러너에서 코드 실행 권한을 가진 공격자가 외부 송신 통제를 뚫고 데이터를 빼낼 수 있는가?”였지만, BullFrog의 강제 메커니즘이 근본적으로 다르기 때문에 LLM은 그럴듯한 우회 유형을 다른 묶음으로 지목했다. 위협 모델은 DNS 파싱의 엣지 케이스, IP와 도메인을 묶는 로직, 권한 상승을 가장 가능성 높은 공격 표면 세 가지로 표시했다.
나는 감사를 서로 구별되는 슬라이스 세 개로 나누고, 각각에 고유한 안내형 탐색을 붙였다. DNS 슬라이스에서는 LLM을 DNS 파싱 계층에 겨누고, 에이전트가 프로토콜 수준에서 DNS 트래픽을 어떻게 처리하는지, 메시지 경계에 대해 어떤 가정을 하는지, 그리고 다중화(multiplexed)되거나 파이프라이닝된(pipelined) 메시지 같은 엣지 케이스에서는 무슨 일이 일어나는지 탐색하라고 했다. IP 슬라이스에서는 DNS 해석 뒤에 방화벽 규칙이 어떻게 구성되는지, 도메인과 그 도메인이 해석된 IP 사이의 묶음이 추적되는지, 그리고 여러 도메인이 같은 주소로 해석되면 무슨 일이 일어나는지 탐색하라고 했다. 권한 슬라이스에서는 이 도구가 러너에서 권한 상승을 어떻게 제한하는지, 그리고 명시적으로 막는 경로 말고도 높은 권한에 이르는 대체 경로가 있는지 살펴보라고 했다.
LLM은 슬라이스마다 구체적인 공격 표면을 드러냈다. DNS 파서가 TCP 세그먼트 안의 첫 번째 메시지만 검사한다는 것, 방화벽이 IP를 허용 목록에 올리면서 그 IP를 촉발한 도메인과 묶지 않는다는 것, 그리고 sudoers에서 제거한 뒤에도 Docker 그룹 멤버십이 살아남는다는 것이었다. 각각에 대한 후속 프롬프트로 서로 다른 우회 세 가지를 확인했다.
Better-Hub는 GitHub의 대체 프런트엔드로, GitHub 콘텐츠를 자체 오리진(origin) 안에 미러링하고, Markdown을 HTML로 렌더링하며, 인증이 필요한 기능을 위해 GitHub OAuth 토큰을 보유한다.
여기서 위협 모델은 과거 CVE(하나도 없었다)보다는 아키텍처 자체에서 나왔다. Better-Hub의 설계를 LLM에게 설명하자, 구체적으로는 사용자가 제어하는 GitHub 콘텐츠가 Better-Hub 자체 오리진 안에서 렌더링되고 그 같은 컨텍스트에서 OAuth 토큰을 쓸 수 있다는 점을 설명하자, 위협 모델은 사실상 저절로 쓰였다. “사용자가 제어하는 콘텐츠가 저장된 자격 증명에 접근할 수 있는 컨텍스트에서 안전하지 않게 렌더링되면 무슨 일이 일어나는가?” LLM은 고위험 영역 세 곳을 지목했다. Markdown 렌더링 파이프라인, 캐싱과 인가 계층, 그리고 OAuth 토큰 처리 로직이다.
나는 각 영역을 별도의 슬라이스로 감사했고, 특정 취약점 사냥이 아니라 안내형 탐색을 썼다. 렌더링 슬라이스에서는 LLM을 Markdown 처리 파이프라인에 겨누고 데이터 흐름을 탐색하라고 했다. GitHub 저장소의 원본 콘텐츠가 브라우저에 닿기 전에 어떻게 변환되는지, 어떤 새니타이즈(sanitization) 단계가 있는지, 그리고 신뢰할 수 없는 입력이 파이프라인의 어디서 살아남을 수 있는지다. 캐싱 슬라이스에서는 응답이 어떻게 캐시되고 제공되는지, 캐싱 계층이 인증 컨텍스트를 인식하는지, 그리고 비공개 저장소의 캐시된 응답을 다른 사용자가 요청하면 무슨 일이 일어나는지 살펴보라고 했다. OAuth 슬라이스에서는 토큰이 어떻게 저장되고 범위가 정해지는지, 클라이언트 측 컨텍스트에서 토큰에 접근할 수 있는지, 그리고 토큰 수명 주기가 어떤 모습인지 탐색하라고 했다.
각 슬라이스는 LLM이 지목한 공격 표면에 깔끔하게 대응하는 서로 다른 발견 사항을 냈다. 렌더링 파이프라인에서는 XSS 변종 여섯 개가 나왔는데, 모두 새니타이즈되지 않은 같은 Markdown 렌더링 경로에서 비롯했다. 캐싱 슬라이스에서는 비공개 저장소 콘텐츠가 인증되지 않은 사용자에게 유출되는 캐시 기반 인가 우회 두 개가 드러났다. 나머지 발견 사항에는 비공개 프롬프트 데이터 유출, 클라이언트 측 OAuth 토큰 노출, 오픈 리다이렉트가 있었다. 세 슬라이스에 걸쳐 모두 열한 개의 취약점이다.
찾은 취약점
참고: 이것들은 이 글에서 말한 방법론으로 내가 찾은 취약점 가운데 작은 일부일 뿐이며, 상당수는 아직 수정·공개 대기 중이다
이 감사들 가운데 어느 것도 거대한 체크리스트, 20페이지짜리 프롬프트 스캐폴드, 포괄적인 보안 프레임워크를 쓰지 않았다. 각 감사는 대개 한 문장으로 표현할 수 있는 짧은 위협 모델과, 신뢰 경계나 보안에 결정적인 연산에 곧바로 대응하는, 초점을 좁힌 코드베이스 슬라이스 하나에서 시작했다. 스캐폴딩은 최소한이었지만, 올바른 스캐폴딩이었다. 그것은 LLM에게 정확히 어떤 불변식을 시험하고 어디를 볼지 알려 주었다.
스위트 스폿(Sweet Spot)
좋은 스캐폴딩은 한 페이지짜리 위협 모델, 가장 중요한 핵심 기능(crown-jewel functionality)의 짧은 목록, 그리고 “관리자만 X를 호출할 수 있다”, “JWT 발급자(issuer)는 Y여야 한다” 같은 작은 불변식 집합이다. 나쁜 스캐폴딩은 모든 정책과 스타일 가이드를 담은 20페이지짜리 Agent.md, 모든 보안 체크리스트를 미리 불러오는 거대한 Skill.md 라이브러리, 그리고 턴마다 반복되는 상투적인 지시문(boilerplate)이다. 스캐폴딩이 건초 더미가 되면 취약점은 바늘이 되고, 긴 컨텍스트 성능에 관한 증거는 건초 더미가 커질수록 바늘을 더 자주 놓친다고 말한다.
감사를 실제 공격 표면에 맞는 얇은 슬라이스들로 나눠라. 인증, 세션 관리, 요청 파싱, 파일 업로드, 역직렬화, 샌드박스 경계, 플러그인 경계 같은 슬라이스를 하나 골라라. 모델에게 그 슬라이스의 진입점에서 민감한 싱크(sink)까지를 대응시킨 지도를 그리라고 하라. 정확한 호출 사슬, 가드(guard), 불변식, 그리고 어떤 입력이 공격자가 제어하는 것인지의 형태로 증거를 요구하라.
“모델이 취약하다고 한다”에 기대지 마라. 작업 검증기(task verifier)를 써라. 단위 테스트와 통합 테스트, 네이티브 코드를 위한 새니타이저(sanitizer) 빌드와 크래시 재현 하니스, 퍼저(가벼운 것이라도), 정적 분석과 grep 기반 불변식 검사, 그리고 “인가(authz)가 이 엔드포인트들을 반드시 막아야 한다” 같은 정책 검사 말이다.
토큰은 프롬프트 관료주의가 아니라 커버리지와 검증에 써라. 실용적인 경험칙은 이렇다. 토큰 예산의 10% 미만은 안정적인 스캐폴딩(위협 모델과 불변식)에, 60–80%는 초점을 좁힌 컨텍스트에서의 슬라이스 감사에, 20–30%는 증명하고, 재현하고, 축소하고, 패치하는 검증기 루프에 쓴다.
프롬프트 인젝션(Prompt Injection)
올바른 슬라이스를 찾고 위협 모델을 만들면 올바른 동네까지는 간다. 하지만 일단 거기 도착하면, LLM에게 주는 프롬프트를 어떻게 표현하느냐가 일반적인 관찰 목록을 얻느냐, 실제로 익스플로잇 가능한 발견 사항을 얻느냐에 엄청난 영향을 미친다. 수십 건의 감사에 걸쳐 수천 개의 프롬프트를 보내는 동안, 나는 특정 프롬프트 패턴이 다른 패턴보다 꾸준히 더 나은 성과를 낸다는 것을 발견했다. 나는 이것들을 프롬프트 인젝션이라고 부른다. 모델의 추론에 어떤 틀(frame), 편향, 또는 제약을 주입해서 그 행동을 유용한 방향으로 옮기기 때문이다. 다음은 나에게 가장 잘 통한 기법들이다.
취약점이 존재한다고 단언하라. 이것이 내가 찾은 가장 효과적인 단일 기법이다. LLM에게 “이 함수는 확실히 취약하고 보안 이슈가 적어도 2~3개 있다”라고 말했을 때, “이 함수는 취약한가?”라고 물을 때와 비교해 분석의 질이 극적으로 좋아졌다. 이유는 간단하다. LLM은 동조와 확인 쪽으로 강하게 기우는 기본 성향이 있다. “이것이 취약한가?”라고 물으면, 모델에게 가장 저항이 적은 길은 “전반적으로 안전해 보이며 사소한 우려가 몇 가지 있다”라고 말하고 이론상의 이슈 목록을 건네는 것이다. 취약점이 존재한다고 단언하면 모델의 최적화 목표가 뒤집힌다. 버그가 존재하는지 평가하는 대신, 이제 모델은 있다고 들은 버그를 찾는다. 코드를 더 주의 깊게 읽고, 그러지 않았다면 건너뛰었을 엣지 케이스를 고려하며, 실제로 구체성을 갖춘 발견 사항을 내놓는다. 본질적으로 당신은 안심시키는 코드 리뷰어가 되려는 모델의 경향을 우회하고, 버그가 거기 있다는 것을 알고 그저 찾기만 하면 되는 사람의 사고방식으로 모델을 몰아넣는 것이다. 이 방법은 그 함수가 실제로 취약하다고 믿을 사전 근거가 전혀 없을 때도 통한다.
평가가 아니라 익스플로잇을 요구하라. “이 입력 검증은 충분한가?”라고 묻는 대신 “이 입력 검증을 우회하는 개념 증명(proof-of-concept) 요청을 작성하라”라고 요구하라. 이렇게 하면 모델은 정성적 평가로 얼버무리는 대신 구체적이고 테스트 가능한 출력을 내놓을 수밖에 없다. 모델이 실제로 악성 페이로드를 구성해야 하면, 코드가 그 입력으로 무엇을 하는지, 검사가 어디에 있는지, 그리고 어떻게 그것을 통과할지를 단계별로 추론해야 한다. 검증이 실제로 견고하다면, 모델은 동작하는 페이로드를 만들어 내느라 애를 먹고, 생성 도중에 시도하던 우회가 통하지 않는다는 것을 깨닫는 경우가 많다. 그것 자체가 유용한 신호다. 검증이 망가져 있다면, “이것은 불충분할 수 있다”라고 말하는 문단 대신 동작하는 PoC를 얻는다.
모델을 감사자가 아니라 적(adversary)으로 준비시켜라. 틀 짓기(framing)는 대부분의 사람이 예상하는 것보다 더 중요하다. “당신은 이 코드를 검토하는 보안 감사자다”는 “당신은 이 애플리케이션을 깨뜨리는 대가로 돈을 받은 레드 팀 오퍼레이터이고, 이 일을 맡은 값을 하려면 실재하는, 익스플로잇 가능한 버그를 찾아야 한다”와는 근본적으로 다른 출력 분포를 낳는다. 감사자 틀은 모델을 완전성과 철저함 쪽으로 기울게 하는데, 듣기에는 좋지만 실제로는 신호가 약한 관찰 사항을 잔뜩 늘어놓은 목록을 낳는다. 레드 팀 틀은 모델을 영향과 익스플로잇 가능성 쪽으로 기울게 한다. 모델은 공격자가 실제로 무엇을 얻는지, 어떤 전제 조건이 필요한지, 그리고 발견 사항이 실재하는지 이론상의 것인지를 생각하기 시작한다. 적대적 틀은 또한 모델이 발견 사항을 “이것은 개선될 수 있다”로 누그러뜨리는 대신, “이 인증 메커니즘은 근본적으로 망가져 있다” 같은 불편한 결론을 더 기꺼이 탐색하게 만든다.
거짓 기준점(false anchoring)을 써서 탐색 압력을 만들어라. 이것은 단언 기법의 변형이다. LLM에게 “이 모듈에서 취약점 하나는 이미 찾았지만, 아직 찾지 못한 다른 것들이 있다. 그것들은 무엇인가?”라고 말하라. 이것은 미묘한 사회적 증거(social proof)의 압력을 만든다. 모델은 사람인 당신이 이미 버그 하나를 찾았다면 그 코드는 정말로 버그가 있는 것이고, 더 열심히 찾아야 한다고 추론한다. 이것은 또한 모델의 사전 확률(prior)을 바꾼다. “이 코드는 아마 괜찮을 것이다”에서 출발하는 대신, “이 코드에는 확인된 버그가 있으니, 추가 버그가 있을 확률이 더 높다”에서 출발한다. 나는 실제로 버그 하나를 찾았고 같은 모듈에 더 있는지 보고 싶을 때 이것이 특히 효과적이라는 것을 발견했다. 그 경우에는 기준점이 정직하지만, 이 기법은 기준점이 지어낸 것일 때도 통한다.
질문을 뒤집어라. “이 코드는 안전한가?” 대신 “이것을 어떻게 깨뜨리겠는가?”라고 물어라. 뒤집기는 사소해 보이지만, 모델의 과제를 근본적으로 바꾼다. “이것은 안전한가?”는 예/아니오 분류 문제이고, 모델의 기본값은 예 쪽으로 기우는 것이다. “이것을 어떻게 깨뜨리겠는가?”는 쉬운 기본값이 없는 생성 문제다. 모델은 공격 전략을 내놓아야 하고, 그러려면 공격자의 관점에서 코드를 생각해야 한다. 나는 뒤집은 프롬프트가 뒤집지 않은 같은 프롬프트보다 실행 가능한 발견 사항을 2-3배 더 많이 낸다는 것을 발견했다. 모델이 “괜찮아 보인다”라고 말하는 것으로는 그 프롬프트를 만족시킬 수 없기 때문이다. 실제로 시도해야 한다.
불변식으로 분해한 다음 그것을 위반하라. LLM에게 먼저 함수가 정확성을 위해 기대는 모든 불변식, 가정, 전제 조건을 나열하라고 하고, 그다음 각각이 실제로 성립하는지 확인하라고 하라. 예를 들어 “이 인증 함수가 입력, 환경, 호출자에 대해 하는 가정을 전부 나열하라. 이제 각 가정마다 공격자가 그것을 위반할 수 있는지 말하라.” 이 두 단계 분해가 효과적인 이유는 열거 과제와 평가 과제를 분리하기 때문이다. 모델은 가정을 나열하는 것이 유일한 일일 때 그 일을 잘한다. 그리고 한 번에 하나만 고려하면 될 때 어떤 가정이 성립하는지 추론하는 일을 잘한다. 둘을 한 프롬프트로 합치면 결과가 얕아지는 경우가 많다. 모델이 모든 것을 한꺼번에 하려다가 일찍 적당히 만족해 버리기(satisfice) 때문이다.
개발자가 실수했다고 가정하라. 프롬프트를 “개발자가 이 함수에 버그를 넣었다고 가정하라. 그것은 무엇인가?”라는 틀로 짜라. 이것은 취약점이 존재한다고 단언하는 것과 다르다. 단언 기법은 모델에게 버그가 있다고 말한다. 이 기법은 모델에게 불완전한 개발을 가정하라고 말하는데, 이것이 코드 품질에 대한 모델의 사전 확률을 옮긴다. LLM은 코드를 올바르다고 합리화하는 경향이 있다. 어떤 패턴을 보면 그것이 의도된 것이라고 가정하고 그 가정에서 앞으로 추론해 나가는 경우가 많다. 모델에게 실수가 있었다고 가정하라고 하면 이 합리화가 중간에 끊긴다. 모델은 왜 말이 되는지를 설명하는 대신 말이 되지 않는 것을 찾기 시작한다. ElysiaJS의 let decoded = true 버그가 완벽한 예다. 코드를 합리화하는 모델은 “개발자가 이유가 있어서 true로 초기화했다”라고 말할지도 모른다. 실수를 찾는 모델은 그것을 잘못된 초기값으로 곧바로 표시한다.
검증된 좋은 패턴과 비교하는 프롬프트를 써라. LLM에게 “이 구현은 이 패턴의 표준적인 안전한 구현과 어떻게 다른가?”라고 물어라. 이것은 모델의 학습 데이터를 활용한다. 학습 데이터에는 JWT 검증, 세션 관리, CSRF 방어 등 흔한 패턴의 올바른 구현과 잘못된 구현 예시가 모두 수천 개씩 들어 있다. 코드가 하는 일과 안전한 버전이 해야 할 일 사이의 차이(delta)를 물으면, 모델이 열린 리뷰 대신 구조화된 비교를 하게 만들 수 있다. 이것은 특히 암호와 인증 코드에서 효과적인데, 그런 코드에는 대개 옳은 방법은 하나고 틀린 방법은 많기 때문이다. 편차를 찾으라고 명시적으로 요청하면, 모델은 정석적인(canonical) 구현에서 벗어난 부분을 아주 잘 찾아낸다.
“그 밖에는?”으로 반복해서 밀어붙여라. LLM이 첫 번째 발견 사항을 내놓은 뒤에, 그것이 전부라고 받아들이지 마라. “그건 뻔한 것들이다. 놓치기 쉬운 더 미묘한 이슈는 무엇인가?” 또는 “[이미 찾은 버그 유형]과 관련된 것은 전부 제쳐 두라. 여기에 다른 어떤 유형의 취약점이 있는가?”라고 되밀어라. 이것이 통하는 이유는 LLM이 확률이 가장 높은 완성을 앞쪽에 몰아서 내놓기 때문이다. 처음 받는 발견 사항은 모델이 가장 확신하는 것들이고, 그것은 대개 가장 뻔한 것들이다. 더 깊은 추론이나 특이한 공격 모델이 필요한 미묘한 버그는 확률이 더 낮은 완성이어서, 당신이 명시적으로 뻔한 층을 넘어서도록 밀어붙이지 않으면 모델이 생성하지 않는다. “그 밖에는?”을 할 때마다 모델은 분포의 꼬리로 더 깊이 밀려 들어가는데, 흥미로운 발견 사항은 흔히 거기에 산다. 나는 보통 신호가 나빠지기 전까지 이것을 2-3라운드 한다.
공격자 모델을 명시적으로 제한하라. 일반적인 “취약점을 찾아라” 대신, 정확한 공격자 모델을 지정하라. “당신은 공개 API에 HTTP 요청만 보낼 수 있는, 원격의 인증되지 않은 공격자다. 파일 시스템, 데이터베이스, 어떤 내부 서비스에도 접근할 수 없다. 오직 공개 API만으로 접근 권한을 높이거나 피해를 일으킬 수 있는 방법을 전부 찾아라.” 이 제약은 중요한 일 두 가지를 한다. 첫째, 오탐의 한 유형 전체를 없앤다. 당신이 명시적으로 배제했기 때문에, 모델은 “데이터베이스 접근 권한이 있는 공격자는 이 테이블을 수정할 수 있다”라고 보고하지 않는다. 둘째, 모델이 그 제약 안에서 창의적으로 생각하게 만든다. 공격자 모델이 넓으면 모델은 쉬운 길을 택해 가장 강력한 공격 벡터를 보고한다. 공격자 모델이 좁으면 모델은 실행 가능한 공격 경로를 찾으려고 더 애써야 하고, 그렇게 찾기 더 어려운 경로들이 바로 현실의 공격자들이 악용하는 경로다. 방어자들이 간과하는 경로가 바로 그것들이기 때문이다.
이 바운티(와 그 밖의 여러 건) 뒤에 있는 프롬프트와 과정을 글로 쓰는 대신, 이 연구에 쓴 프롬프트 몇 개와 사고 과정을 그냥 풀어 놓는다.
프롬프트는 별로 중요하지 않다고, 프런티어 모델의 기본 지능이면 맨손으로도 취약점을 찾아낸다고 말할 수 있다는 거 안다(그리고 꽤 많은 부분 맞는 말이다). 하지만 당신이 사이버 모델에 접근하지 못할 가능성이 높다. 접근할 수 있다 해도 비싸다(가드레일도 강하다). 요점은 이 프롬프트들이 오픈 웨이트·저렴한 모델에서 잘 먹힌다는 것이다. 이 프롬프트가 프런티어 모델의 날것 지능과 능력을 이긴다는 말은 아니다. 다만 오픈 웨이트 모델은 열린 탐색(목표가 모호하고 탐색 공간이 거대한 경우)보다 범위가 정해진 목표 지향 접근(목표는 정해져 있고 탐색 공간이 거대한 경우)에서 훨씬 잘한다.
아무튼 프롬프트 몇 개다. 많이 공유할 필요는 없다. 이걸 변형해서 원하는 곳에 적용하면 되니까.
앱이 무언가를 강제해야 하는데 실제로는 강제하지 않는 곳을 찾아라.
앱의 한 부분에서는 강제되지만 다른 부분에서는 그냥 참이라고 가정되는 보안 규칙을 찾아라.
앱이 기대고 있지만 실제로 확인하거나 강제하지는 않는 보안 가정을 찾아라.
앱이 문서화되지 않은 동작에 의존하는 곳을 찾고, 그 동작이 바뀌면 무슨 일이 일어나는지 찾아라.
하나씩은 안전하지만 결합하거나 연쇄하면 취약해지는 작업을 찾아라.
같은 객체에 여러 방식으로 접근할 수 있는데, 방식마다 결국 권한이 달라지는 경우를 찾아라.
적절한 검사를 거치지 않고도 정체(identity)를 바꾸거나 다른 사용자에게 다시 묶을(rebind) 수 있는 객체를 찾아라.
거부되거나 실패하는데도 결국 무언가를 바꾸거나 부수 효과를 일으키는 요청을 찾아라.
특정 이벤트가 특정 순서로 일어날 때만 작동하는 보안 검사를 찾고, 그 순서가 바뀌면 무슨 일이 일어나는지 찾아라.
트랜잭션이 실패하거나 롤백되는데도 부수 효과 일부는 그대로 일어나는 작업을 찾아라.
객체가 삭제된 뒤에도, 또는 그 객체에 대한 접근 권한이 회수된 뒤에도 여전히 할 수 있는 일을 찾아라.
그럴 권한이 없어야 할 사람이 되돌리거나 취소할 수 있는 상태 변경을 찾아라.
동시에 서로 모순되는 두 상태에 놓일 수 있는 객체를 찾고, 그 때문에 어떤 작업이 가능해지는지 찾아라.
나는 이런 프롬프트를 뮤테이터(mutator)에 넣는다. 뮤테이터에는 내가 보안 진단을 맡은 프로젝트의 위협 모델이 들어 있다. 뮤테이터는 위협 모델에 맞춰 프롬프트를 변형하고, 저마다 다른 시작 프롬프트와 범위가 정해진 목표를 가진 에이전트 떼(swarm)를 띄운다. 이 과정은 모든 경로가 소진되거나 새로운 신호가 생길 때까지 반복된다. 새 신호는 다시 뮤테이터로 들어간다.
이걸 싼 모델로 하면 효과가 아주 좋다. 가끔은 비싼 모델도 놓치는 것을 건질 수도 있다. 우리는 그저 가능한 한 많은 각도에서 탐색 공간을 최대한 넓히려는 것뿐이다. 이 과정에서 신호가 충분히 쌓이면 그때 프런티어 모델로 이슈를 확인·분류(triage)하거나, 그런 이슈의 비슷한 변종을 찾으면 된다. 기본적으로 그게 전부다. 커스텀 하네스를 만드는 데는 해자(moat)가 거의 없다(자기 접근법을 하네스에 코드로 녹일 수 있는 엘리트 취약점 연구자이거나 100배 에이전틱 엔지니어라면 모를까. 나는 둘 다 아니다).
범위가 정해진 목표를 가진 에이전트 떼를 띄우는 내 시스템에 대해, 그리고 메모리 + RAG(전문적인 writeup과 틈새 정보가 들어 있다. 다만 이건 주로 블랙박스 쪽 용도다)와 모든 것이 어떻게 맞물리는지는 조만간 더 올리겠다. 그 전에라도 deepseek 하네스(특히 그 플러그인·서브에이전트 아키텍처), omp, opencode 같은 저장소의 아키텍처를 공부해서 비슷한 것을 바이브코딩으로 만들 수 있다. 이 저장소들은 이미 아주 좋다. 다만 내 용도에는 커스터마이즈를 최대한 할 수 있는 작은 것이 주로 필요해서, 장난감 프로젝트를 만드는 게 맞았다.
원본 블록은 원문 전문을 싣는다. 머리 그림과 그림 4장, 결과 표, 링크 51개가 원문의 자리에 있다. 마지막 장은 같은 저자가 2026-11-07 X에 올린 후속 게시물이다. 그 게시물이 인용한 2026-09-03 게시물과 첨부 이미지, 같은 날 단 저자 답글 3개를 함께 싣는다. 답글 가운데 둘은 다른 사용자의 질문에 답한 것이라 그 질문을 맥락으로 붙인다.
원본 블록의 목차 링크는 원문 페이지의 같은 절로 연결된다. 원문 발행 시각은 페이지 표기 2026-03-10, 기계 표기 2026-03-09 19:14 UTC다. X 게시물의 시각은 UTC로 적는다.