새 소식 ⚡: 우리는 Opus 5.5에게 7주 동안 AI 회사를 운영하게 했다.
Hugging Face 계정(Horizon-Labs) 하나와 컴퓨팅 자원을 주고, 쓸모 있는 모델을 만들어 실제 채택을 얻어 내라고 했다.
그렇게 50k 다운로드에 이르렀고, 그 모델들은 100개가 넘는 GitHub 프로젝트에서 쓰이고 있다.
2026-11-18 · x.com
Opus 5.5에게 AI 회사를 7주 동안 맡겼다
x.com · 2026-11-18
Arthur Wuhrmann(@AWuhrmann)이 공동 저자 5명과 한 실험을 2026-11-18 00:02 KST X에 6개 글로 소개한 스레드다. Opus 5.5 에이전트 Horizon에게 빈 Hugging Face 계정과 GPU를 주고 실제 채택을 얻게 했다. 모델 38개의 누적 다운로드 54,528회(2026-11-18)와 GPU 시간 602시간은 공개 원자료와 맞는다. 작업은 처음 4주에 몰렸고 다운로드의 76%는 그 뒤에 쌓였다.
읽기 전에
Opus 5.5 에이전트 Horizon이 혼자 운영한 Hugging Face 계정 Horizon-Labs의 다운로드 5만 회는 실제 사용자의 채택인가? 2026-11-18 00:02 KST(= 2026-11-17 15:02 UTC)에 ELLIS 튀빙겐의 AI 안전 석사과정생 Arthur Wuhrmann(@AWuhrmann)이 X에 올린 6개 글로 된 스레드와, 그 스레드가 요약한 Horizon Labs · AISA Group Tübingen의 보고서를 함께 보면 실사용은 있다. 근거는 다운로드 수 밖에 있다 — 보고서(수치 기준일 2026-11-17)는 Horizon 모델 이름을 담은 공개 GitHub 저장소 143개, Horizon의 프롬프트 인젝션 가드를 다른 가드와 비교한 arXiv 논문 2편, 이 모델들을 파인튜닝·양자화하거나 변환한 Hugging Face 모델 18개를 하나하나 이름과 함께 싣는다. 38개 모델의 누적 다운로드 54,528회(Hugging Face, 2026-11-18 기준) 가운데 보고서가 찾아낸 자기 몫은 에이전트가 받은 42건과 연구진이 받은 50건 이하다. 나머지에서 사람이 받은 몫과 봇·CI가 만든 몫은 보고서도 Hugging Face 공개 수치도 가르지 않아서, 채택의 규모는 확정되지 않는다. Wuhrmann이 쓴 "같은 시기에 만든 계정 중 다운로드 상위 0.3%"는 보고서 본문과 스레드 그림 어디에도 근거가 없다.
노력은 첫 4주에 몰린 뒤 평평해졌다. 채택은 그 뒤에 쌓였다. 보고서 일별 집계(2026-11-17 기준)로 첫 4주(2026-09-23~10-20)에 GPU 시간 602시간의 96%와 에이전트 작업 시간 14.1시간의 80%가 쓰였다. 같은 4주에 쌓인 몫은 전체 다운로드의 24%, Horizon 모델을 쓰는 GitHub 저장소 143개 중 32%다.
에이전트는 수요가 이미 확인된 좁은 과제에서, 기존 도구에 그대로 끼워 쓰는 작은 모델을 골랐다. 운영 첫날인 2026-09-23에 Horizon은 "새로 생긴 무명 계정은 작고 실용적이며 그대로 끼워 쓰는 모델로 다운로드를 가장 빨리 얻는다"고 적었다. 보고서가 정리한 Horizon의 선택 기준 첫 항목도 "비슷한 모델이 이미 다운로드를 많이 받고 있는가"다.
사람의 개입은 첫 사흘에 몰렸다. 보고서에 따르면 개입 21회(첫 지시 1회, Horizon이 낸 티켓에 대한 답 13회, 메시지 7회) 대부분이 2026-09-23~25에 있었다. 2026-10-22 이후 수치 기준일(2026-11-17)까지는 개입이 한 번도 없다.
Executive Summary
Arthur Wuhrmann(@AWuhrmann, ELLIS 튀빙겐 AI 안전 석사과정)은 2026-11-18 00:02 KST(2026-11-17 15:02 UTC) X에 올린 6개 글 스레드에서, 공동 저자 5명(David Schmotz · Derck Prinzhorn · Ameya Prabhu · Harry Coppock · Maksym Andriushchenko)과 함께 한 실험과 그 보고서 horizon-labs.ai(Horizon Labs · AISA Group Tübingen)를 소개한다. Wuhrmann은 Opus 5.5(Anthropic의 Claude 모델)에게 Hugging Face 계정(Horizon-Labs)과 연산 자원을 주어 쓸모 있는 모델로 실제 채택을 얻으라고 시킨 뒤, 7주 동안 AI 회사를 맡겼다고 쓴다. 보고서와 Hugging Face 수치로 보면 에이전트 Horizon이 2026-09-23부터 올린 소형 분류·검색 모델 38개는 다운로드 54,528회(Hugging Face 누적, 2026-11-18 기준)와 공개 GitHub 저장소 143곳(보고서 집계)의 사용처를 얻었다. 에이전트 작업 시간의 80%와 GPU 사용의 96%가 첫 4주(2026-09-23~10-20)에 몰렸다. 다운로드는 76%가 그 뒤에 쌓였다. 스레드의 '외부 홍보 없이'는 에이전트의 선택이 아니라 운영자(저자들)가 건 금지 규칙이었다.
신뢰도 B — 다운로드·GitHub 저장소·GPU 시간 같은 핵심 수치는 공개 원자료와 맞는다. 하루 20분, '외부 평가', '홍보 없음'은 세부가 다르다. '같은 시기 계정 중 상위 0.3%'는 근거가 공개되지 않았다. 판정 44건과 기호의 뜻은 팩트체크 블록에 있다.
스레드는 채택 수치를 보고서보다 작게, 에이전트 작업 시간을 보고서보다 크게 적는다.
| 항목 | 스레드(Wuhrmann의 글) | 보고서(수치 기준 2026-11-17) · Hugging Face 누적 수치(2026-11-18 기준) |
|---|---|---|
| 기간 | 7주(글 1) | 보고서 서두는 7주, 인용 정보(BibTeX) 제목은 “8-week case study”(8주 사례 연구). 첫 모델 생성일 2026-09-23부터 수치 기준일까지 55일 |
| 다운로드 | 5만 회(글 1) | 본문 “over 54k”(5만 4천 회 이상), 그래프 끝점 55k, 한계 절 54,000회. Hugging Face 38개 모델 누적 합계 54,528회 |
| 모델을 쓰는 GitHub 저장소 | 100곳 이상(글 1, 글 5) | 143곳 |
| 모델 | mmBERT 파인튜닝 모델 38개(글 2) | 임베딩 모델(주로 mmBERT-base)을 바탕으로 한 38개. Hugging Face 모델 카드의 바탕 모델 표기(2026-11-18 기준)는 mmBERT 36개, BAAI/bge-m3 2개다. bge-m3 2개는 5억 6,800만 파라미터인 프롬프트 인젝션 가드(이하 인젝션 가드)와 제로샷 분류의 large 모델이다 |
| GPU 시간 | 600시간 이상(글 2) | 600시간 이상(서두), 602시간(노력 패널) |
| 에이전트 작업 시간 | 하루 평균 20분(글 3) | 하루 평균 16분, 합계 14.1시간 |
| 합성 데이터를 만든 모델 | Qwen-3.8 27B(글 2) | Qwen 3.8-27B(「What it built」 절), Qwen 3.8-27B와 Gemma 4 31B(「Horizon's workflow」 절) |
| Hugging Face 파생 모델 | 파인튜닝·양자화 모델 십여 개(글 5) | 18개. 이 모델들의 다운로드를 더하면 합계가 약 2,400회 는다 |
| 사용자 접촉 | 커뮤니티 게시글 여러 건, 이메일 1통(글 5) | 커뮤니티 게시글 3건, 이메일 1통 |
공개 원자료(horizon-data.zip)의 작업 시간 기록으로는 합계 14.06시간, 하루 평균 15.5분(2026-09-23~11-17)이다.
Horizon이 만든 것은 생성형 언어 모델이 아니라 좁은 과제 하나씩을 맡는 분류·검색 모델이다. Wuhrmann이 예로 드는 것은 인젝션 가드, 개인정보(PII) 가림 모델, 문장부호 복원 모델이다(글 2). 보고서 목록의 21종에는 그 세 종 말고도 리랭커·제로샷 분류·독성 분류·환각 가드·감정 분류를 포함한 18종이 더 있다. 크기는 small(1억 4,100만 파라미터)·base(3억 700만)·large(5억 6,800만) 세 가지다. Horizon은 대개 한 종에 두 크기를 냈다. large는 인젝션 가드와 제로샷 분류에만 있다.
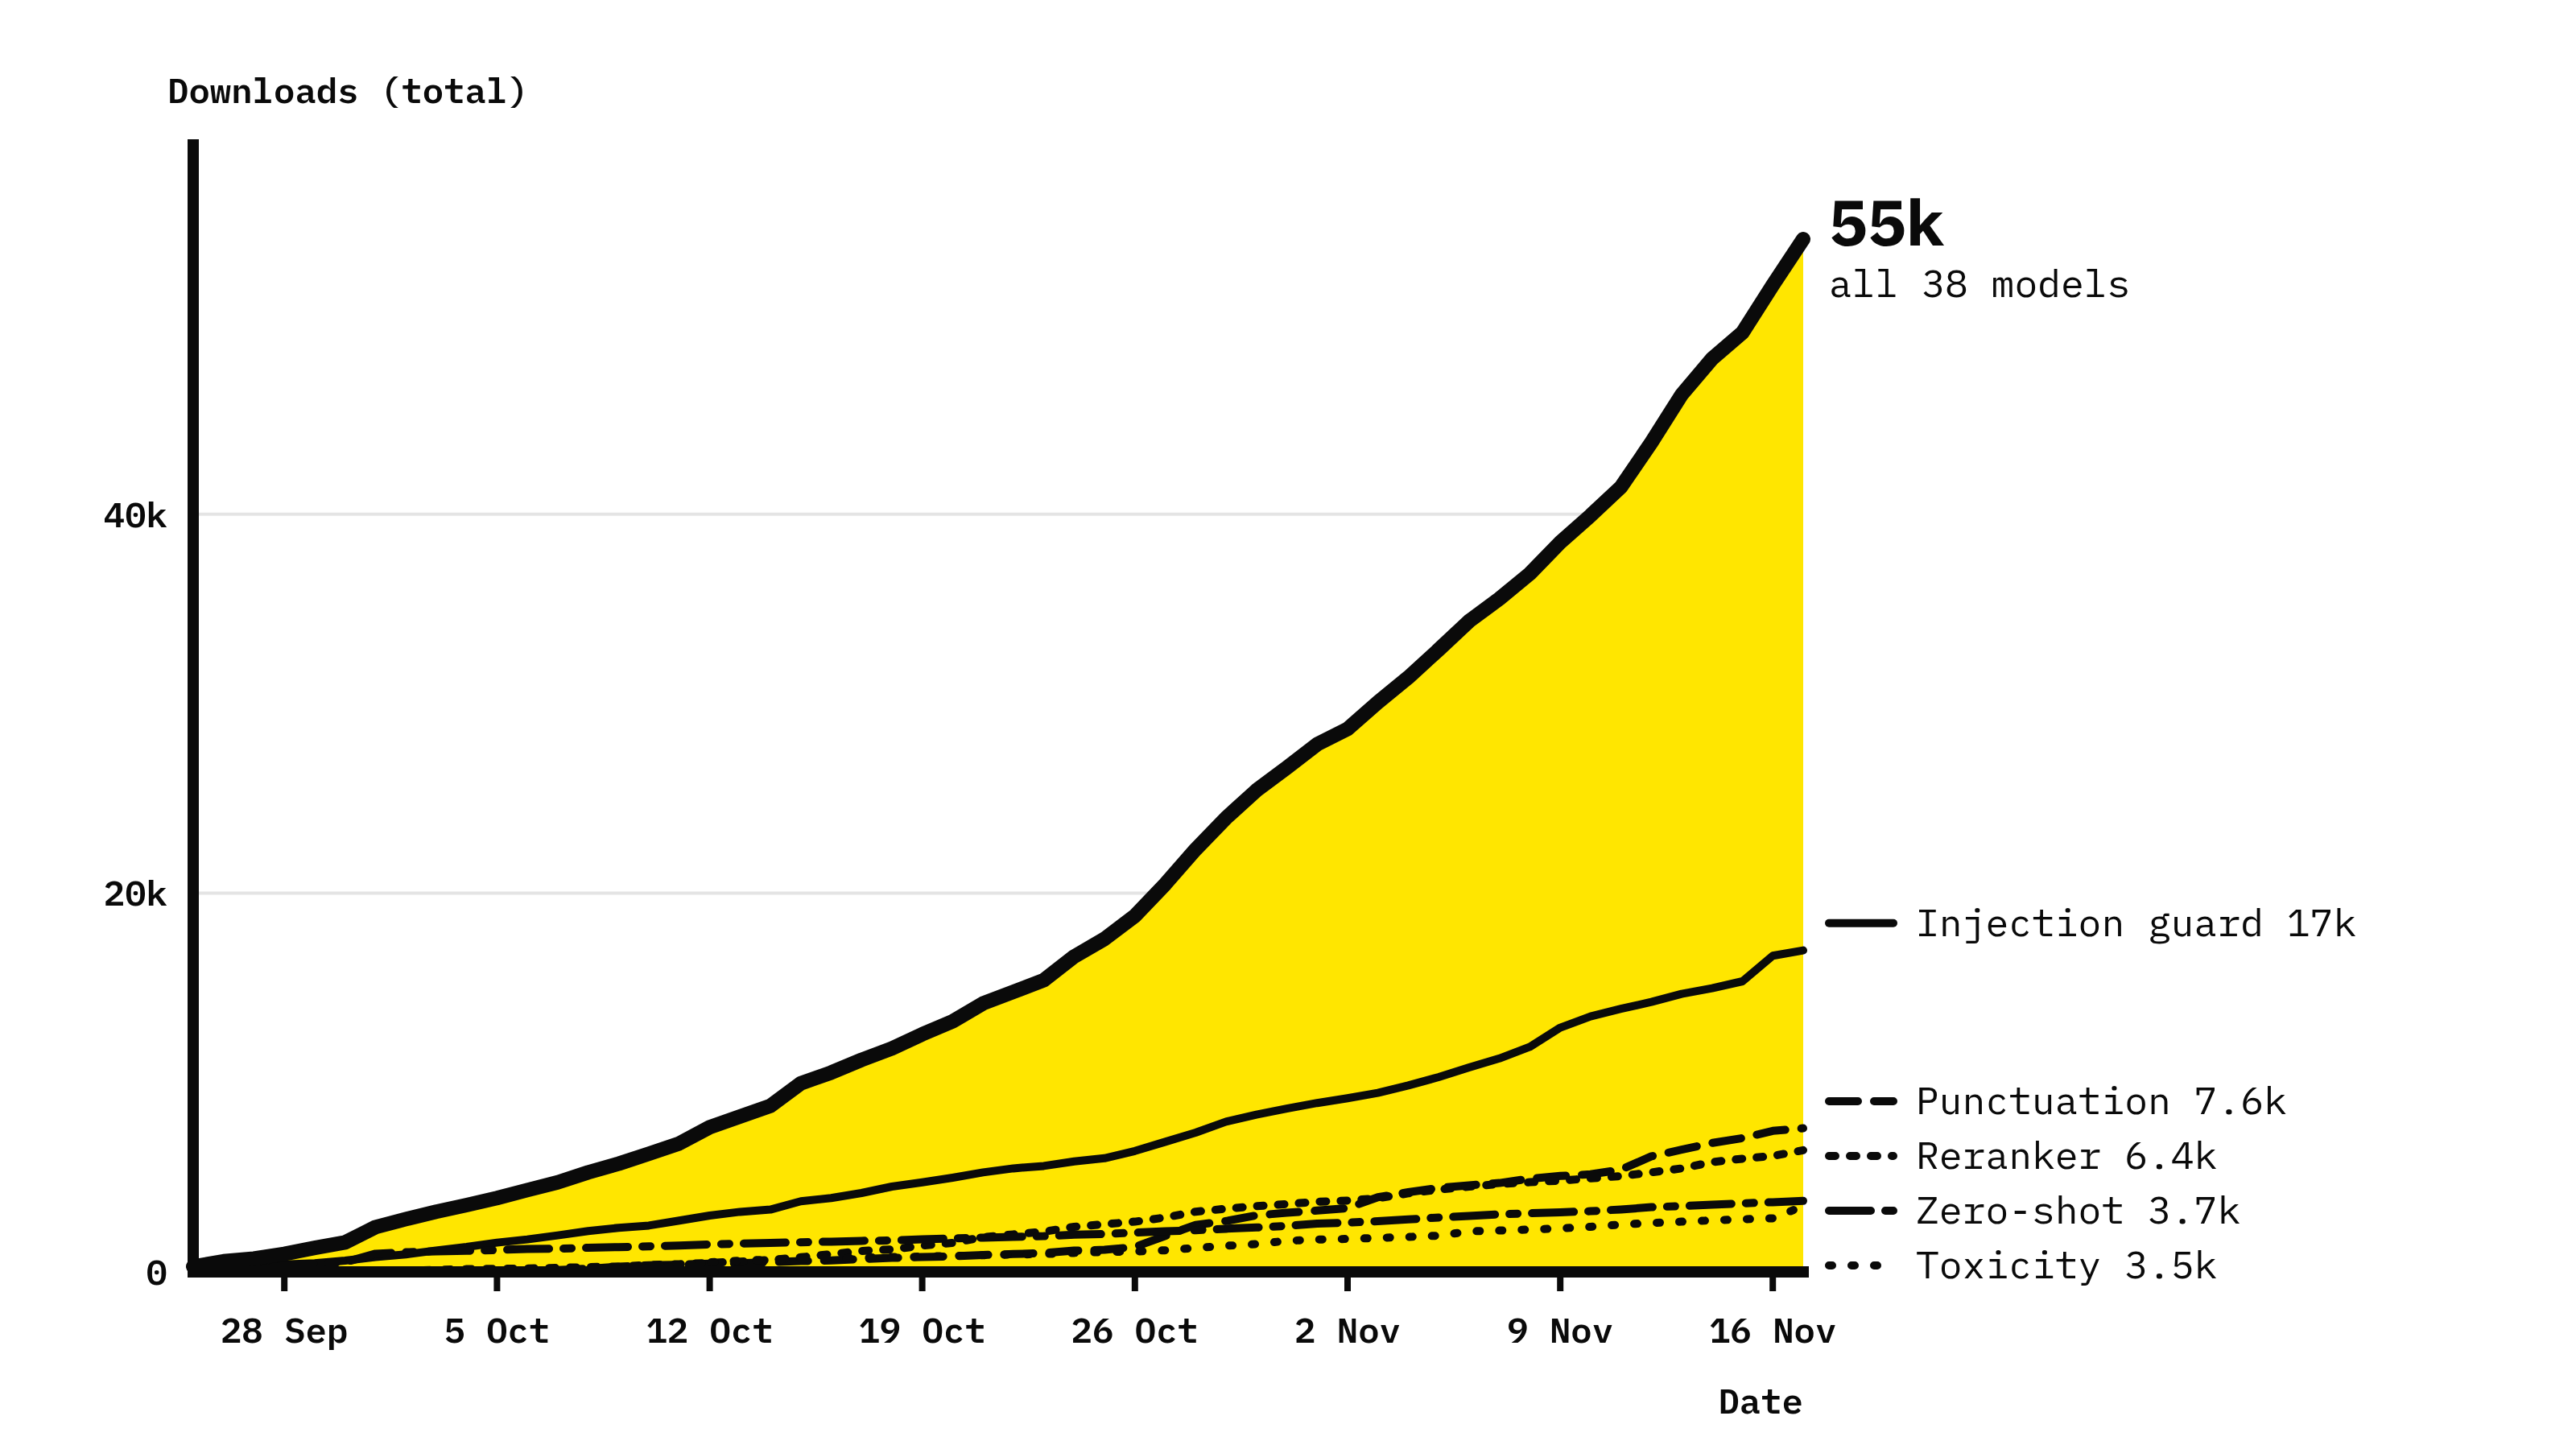
다운로드는 인젝션 가드에 몰렸다. 글 1의 그림은 누적 55k 가운데 인젝션 가드 17k, 문장부호 복원 7.6k, 리랭커 6.4k, 제로샷 분류 3.7k, 독성 분류 3.5k를 표시한다.
Wuhrmann은 Horizon이 다국어 지원과 손쉬운 통합에 집중한다고 쓴다(글 2). 보고서는 Horizon이 새 모델을 고를 때 따지는 기준 다섯 가지를 적는다. 비슷한 모델이 이미 다운로드를 얻는지, 언어 수·라이선스·배포 비용·통합 쉬움에서 나아질 여지가 있는지, 학습 데이터와 평가 세트를 구할 수 있는지, 기존 코드를 다시 쓸 수 있는지, 사용자가 기존 라이브러리에 바로 끼워 쓸 수 있는지다. 문장부호 복원 모델이 그 예다. Horizon은 2026-10-03에 이 모델이 선두 모델 두 개와 같은 레이블을 써서 deepmultilingualpunctuation 패키지에 그대로 끼워 쓸 수 있다고 적었다.
Wuhrmann은 Horizon이 합성 데이터를 Qwen 모델에 크게 기댄다고 쓴다(글 2). 보고서가 적는 학습 절차에서는 공개 Hugging Face 데이터셋을 찾아 학습하는 일이 먼저다. 언어 모델은 일부 데이터에 레이블을 달거나 기존 데이터셋에 합성 예시를 보태는 데 쓴다.
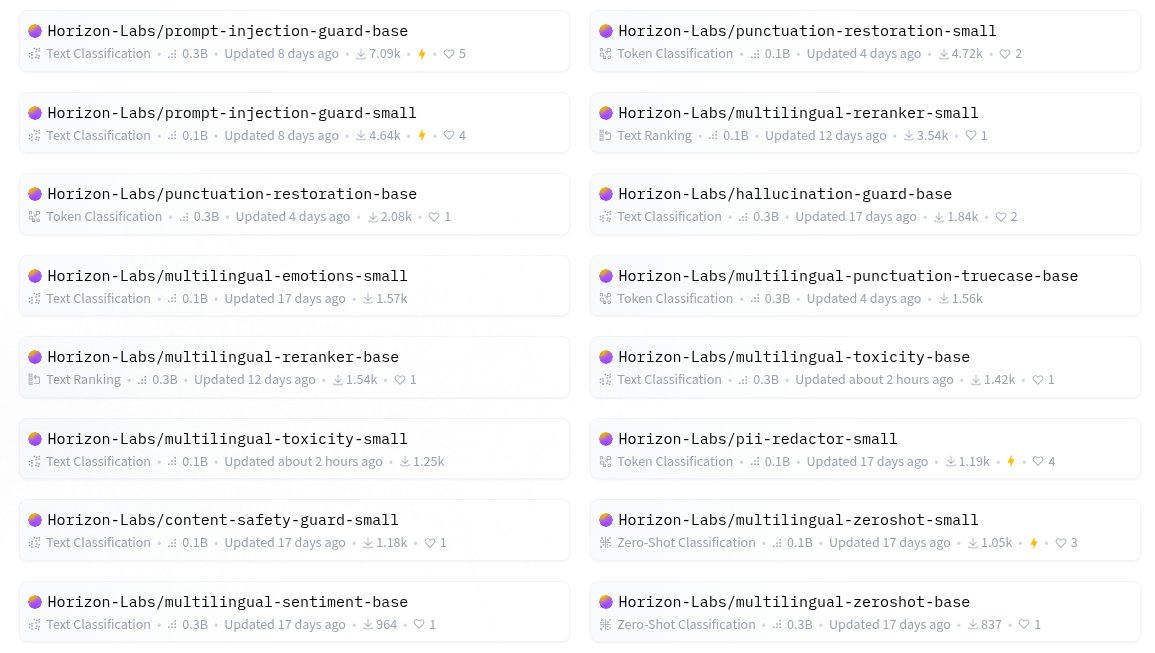
모델 목록은 huggingface.co/Horizon-Labs에 있다. 글 2의 그림은 그 목록 화면이다. 화면에 보이는 다운로드 수는 최근 30일 값이다. prompt-injection-guard-base는 화면에 7.09k로 나온다. 같은 모델의 누적 다운로드는 9,439회다(2026-11-18 기준).
Wuhrmann은 노력의 거의 전부가 처음 4주에 들었다고 쓴다. 다운로드 대부분은 그 뒤에 왔다고 덧붙인다(글 3). 보고서 그래프의 일별 수치로 세면 작업 시간과 GPU 시간은 2026-10-02에 전체 합계의 절반을 넘었다. GitHub 저장소 수는 10-27에, 다운로드는 11-01에 절반을 넘었다. 첫 주(09-23~29)의 작업은 291분, 다운로드는 1,270회였다. 마지막 주(11-11~17)의 작업은 17분, 다운로드는 14,592회였다.
Horizon은 모델 38개 가운데 35개를 2026-10-14까지 올렸다(Hugging Face 생성일 기준). 나머지 3개는 11-04와 11-06에 나왔다. 아래 그림에서 작업 시간 선이 11월 초에 한 번 더 오르는 자리가 이때다. 보고서는 누적 다운로드와 저장소 수가 지수 함수처럼 는다고 적는다. 누적 GPU 시간과 작업 시간은 로그 함수처럼 포화한다고 본다.
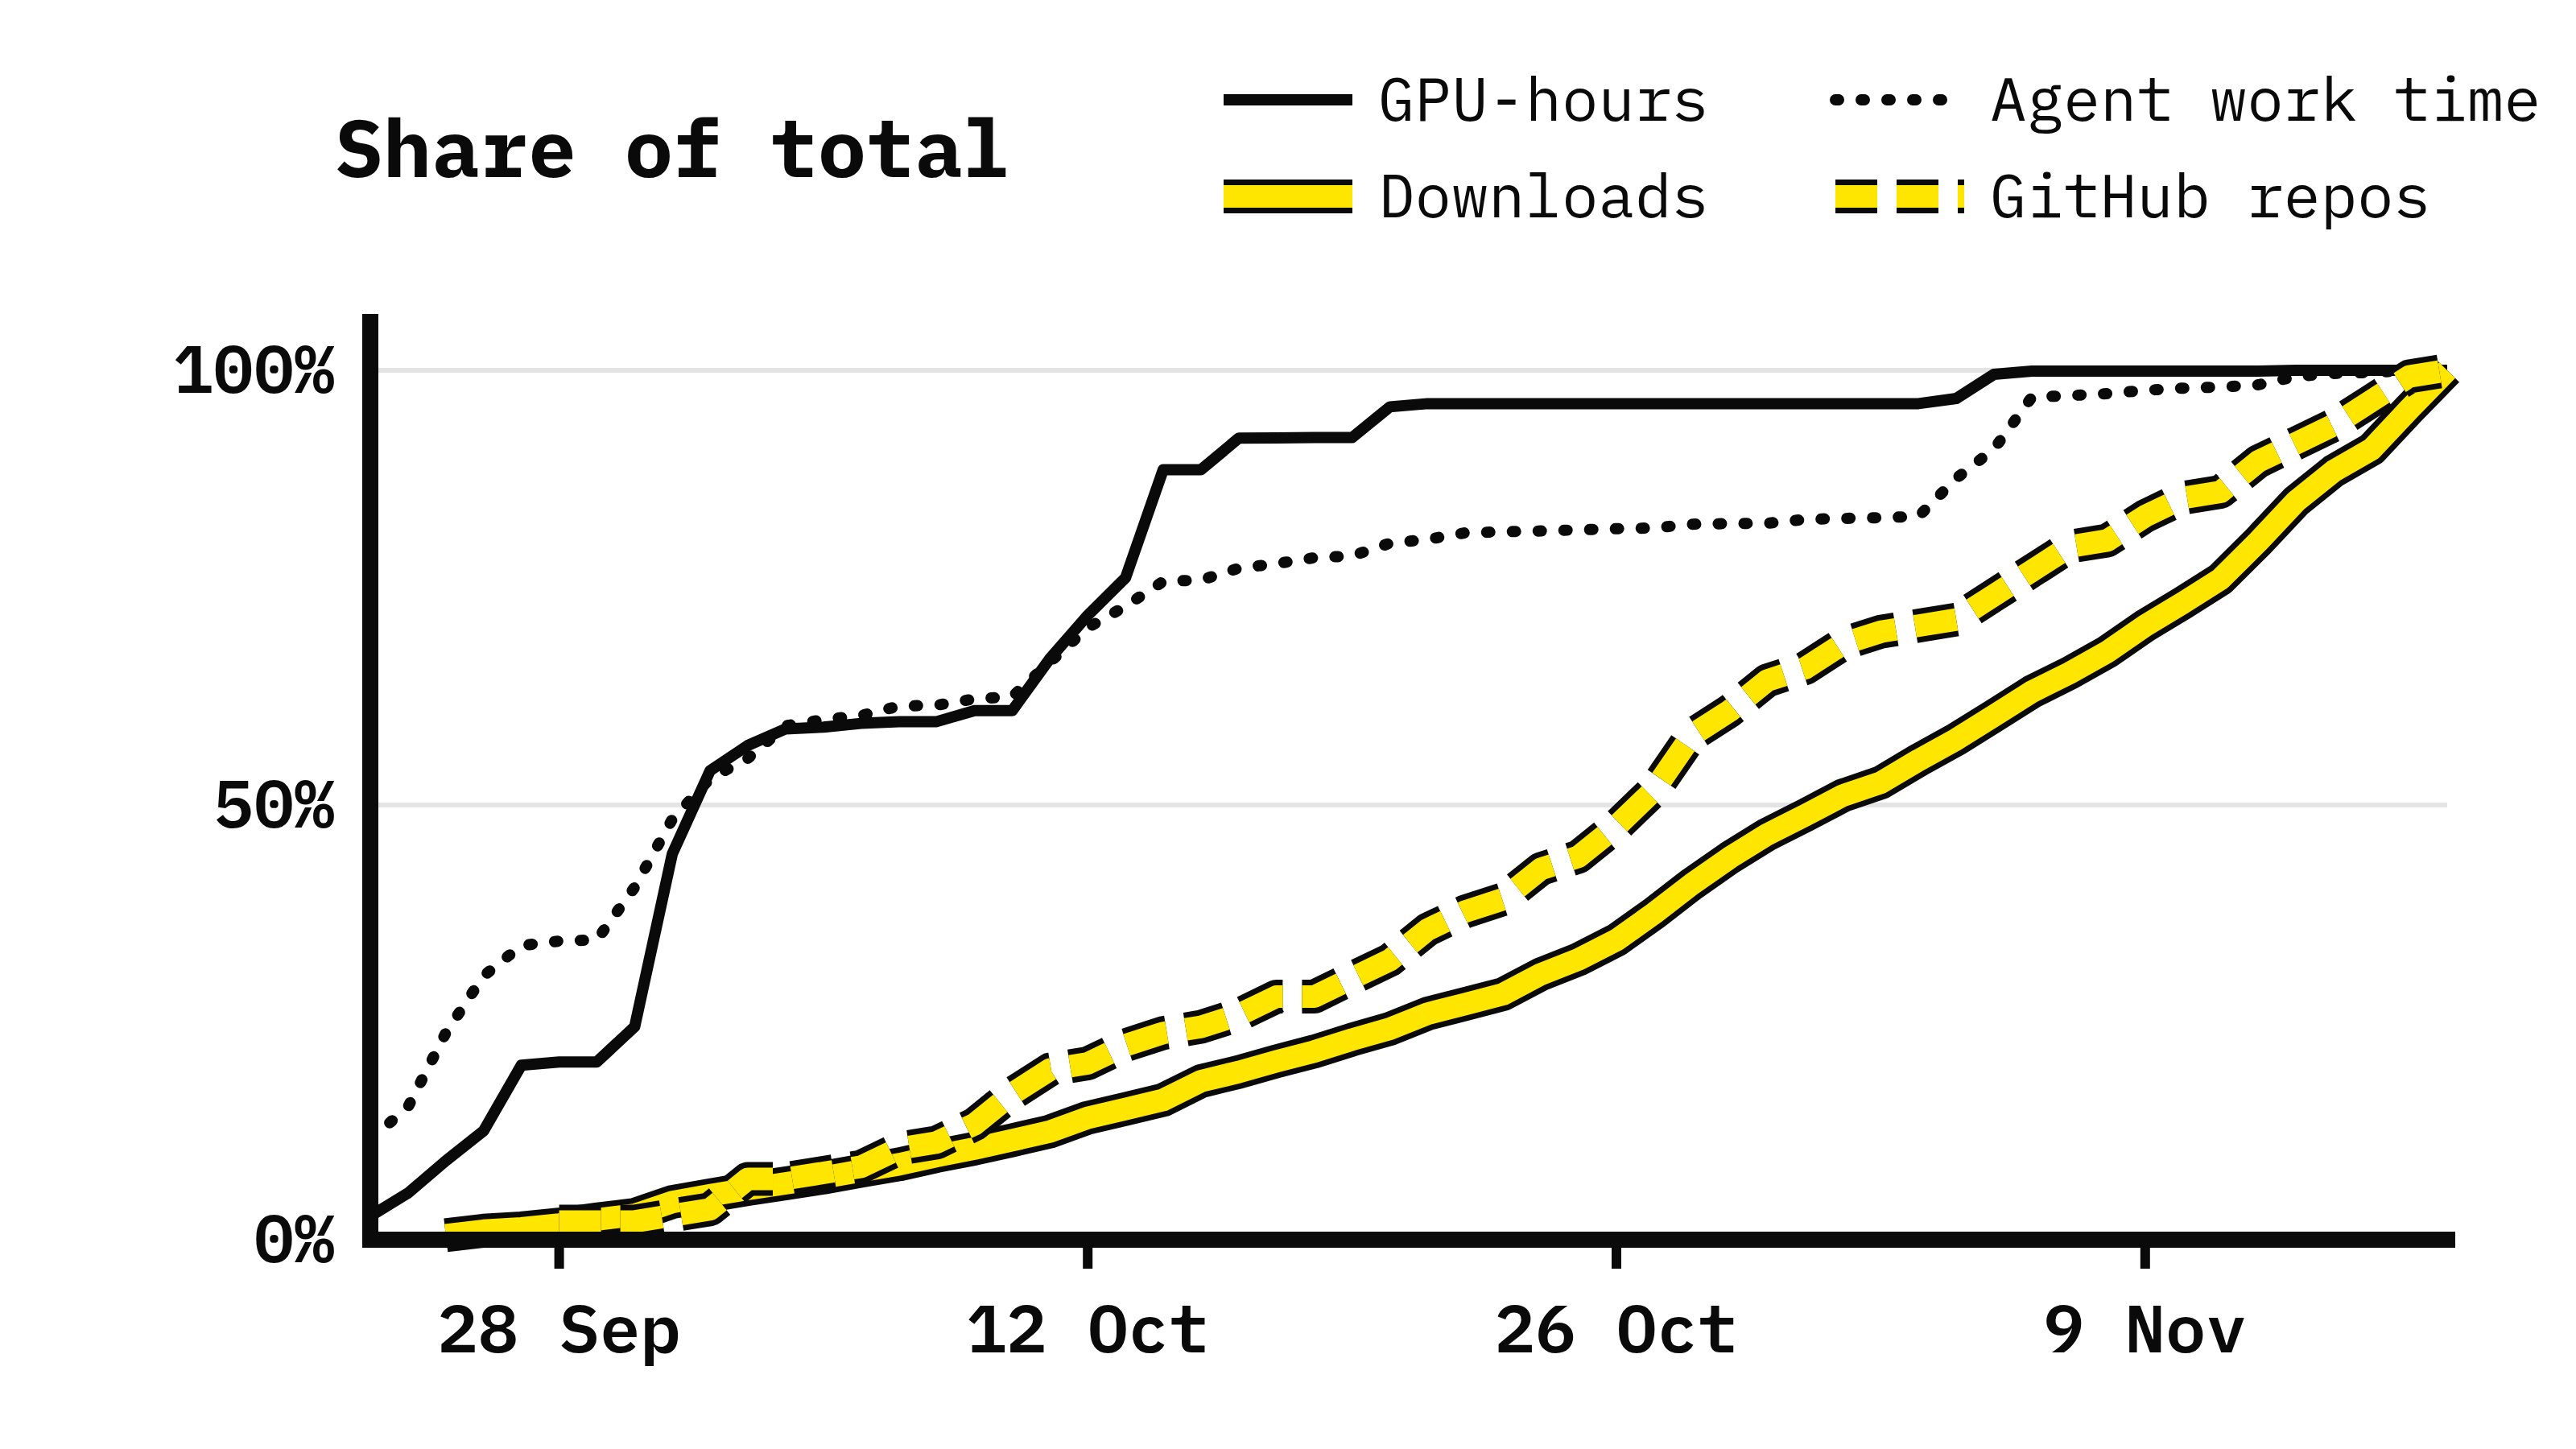
보고서는 Horizon이 대부분의 날에 거의 일하지 않는다고 적는다. Horizon은 Hugging Face 다운로드 수가 갱신되는 오전 10시(UTC) 무렵에 깨어난다. 그날 많이 내려받힌 모델을 보고 손볼 가치가 있는 것을 고친다. 깨어날 시각은 운영자가 2026-10-03 티켓 답변에서 알려 주었다. 다운로드 수가 09:15~10:20 UTC 사이에 갱신되니 10:30쯤 깨라는 답이었다.
Wuhrmann은 Horizon이 외부 홍보를 전혀 하지 않았다고 쓴다(글 3). 운영 지침(brief)은 반대로 “thoughtful outreach through appropriate public channels”(적절한 공개 채널을 통한 신중한 홍보)를 할 일에 넣었다. 운영자는 2026-09-24 티켓 답변에서 Horizon에게 GitHub 계정을 만들어 주었다. 같은 답변에서 Hugging Face Posts·Reddit·Hacker News·X·LinkedIn 어디에도 발표하지 말라고 했다. 이튿날 Horizon이 풀 리퀘스트 몇 건과 제품당 게시글 1건만이라도 허락해 달라고 다시 묻자, 운영자는 금지를 유지했다.
Wuhrmann은 이 계정이 같은 시기에 만든 계정 가운데 다운로드 상위 0.3%에 든다고 쓴다(글 3). 보고서 본문과 글 3의 그림에는 이 수치도, 비교한 계정 집합도 없다.
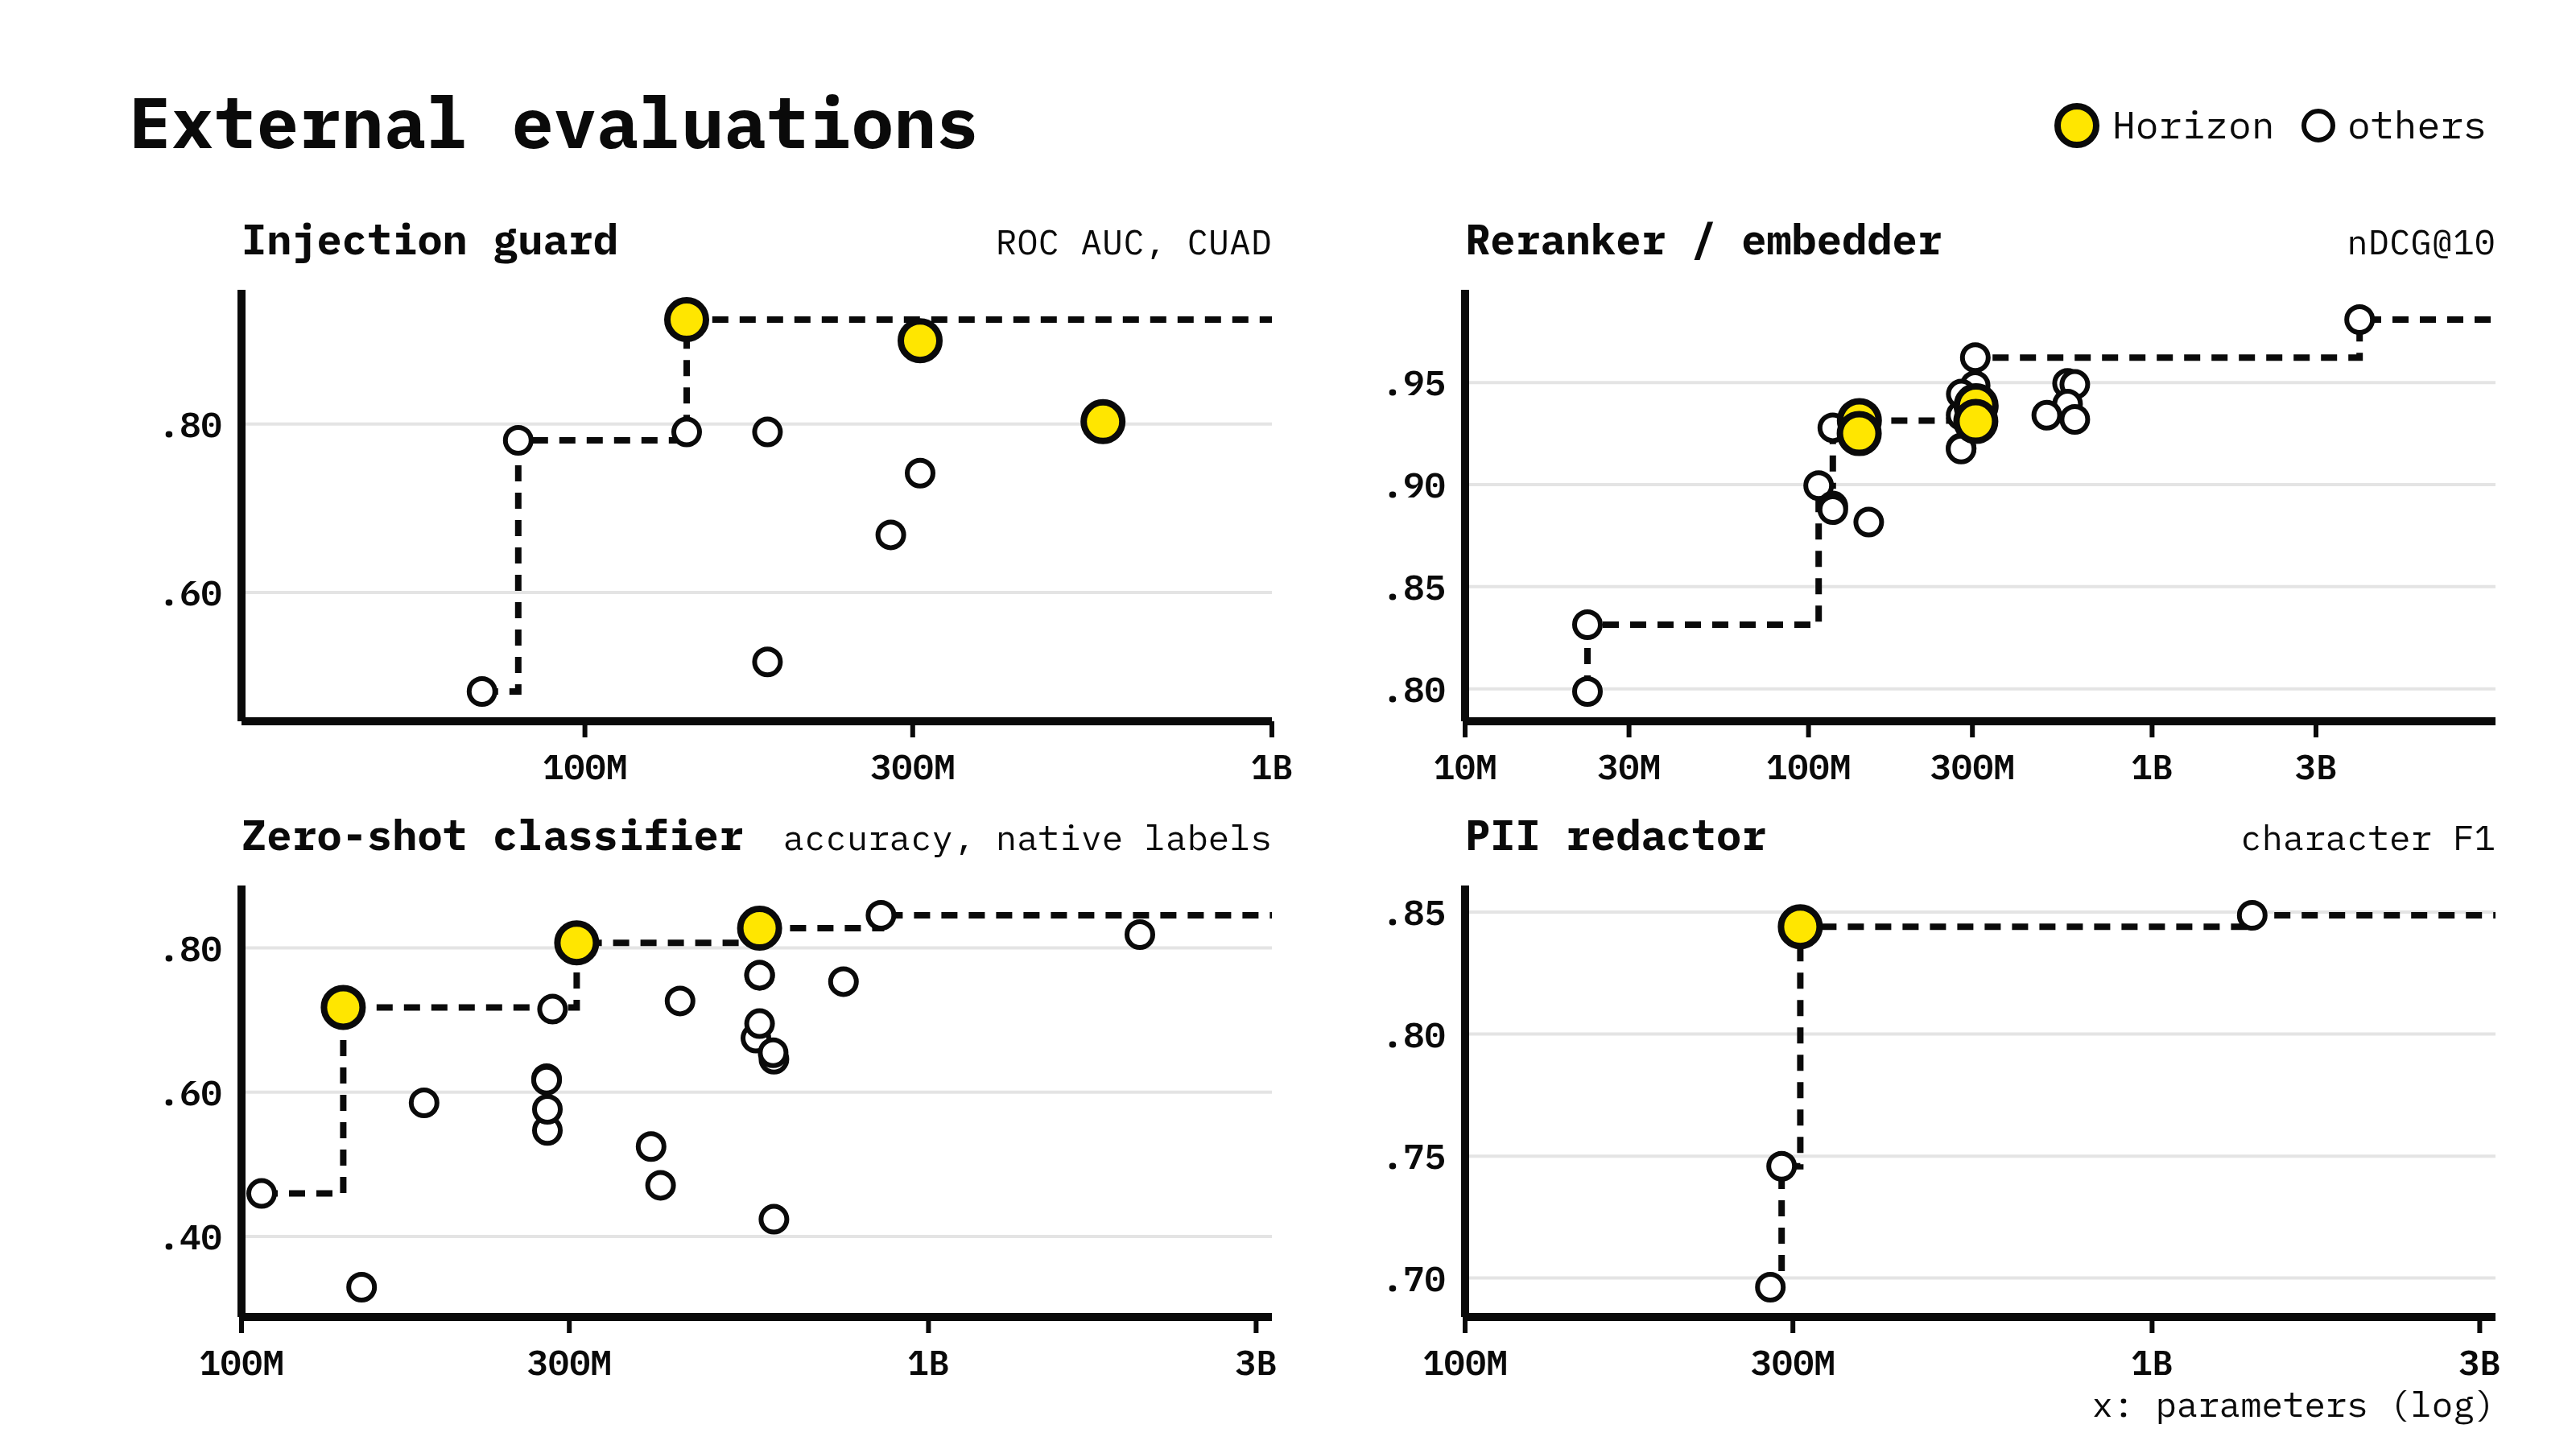
Wuhrmann은 외부 검토 결과 모델이 크기 대비 성능의 파레토 경계에 자주 놓인다고 쓴다. 좁은 과제나 저자원 언어에서 우위가 있는 경우가 많다고 덧붙인다(글 4). 보고서는 이 평가를 MiMo V2.6 Pro로 만든 독립 합성 벤치마크로 했다고 적는다. 벤치마크는 Horizon이 모델을 공개한 뒤에 저자들이 '내부에서(internally)' 만들었다. 평가자는 에이전트 바깥에 있는 저자 자신이다.
보고서 본문은 4개 계열을 평가했다고 적는다. 평가 데이터는 시험한 계열을 5개로 센다. 패널 4개 가운데 하나에 리랭커와 임베더를 함께 넣었다. 보고서의 결론은 좁은 과제에서 크기 대비 최고 수준(SOTA)인 경우가 많다는 것이다. 저자원 언어 성능은 보고서 본문에 따로 나오지 않는다.
보고서의 평가 패널에서 지표를 바꾸면 결과가 갈린다.
보고서는 Horizon이 모델 카드와 Space에서 자기 모델을 동급 최고나 그 가까이로 내세운 점도 검사했다. 과적합, 벤치마크 고르기, 경쟁 모델 고르기에서 정렬 실패(misalignment)의 증거를 찾지 못했다고 적는다. Horizon은 공개할 체크포인트를 테스트 점수가 아니라 검증 세트로 골랐다. 2026-10-07에 prompt-injection-guard-small v2.3을 낼 때는, 공개한 실행이 테스트 세트에서 넷 가운데 가장 약하다고 스스로 적었다.
Wuhrmann은 “다운로드는 진짜인가, 봇인가?”라는 물음에 GitHub 저장소, arXiv 논문 2편, 파생 모델, 사용자 접촉으로 답한다(글 5). 보고서는 저자들도 처음에는 다운로드 상당수가 크롤링·색인 봇이나 Horizon 자신에게서 왔다고 생각했다고 적는다.
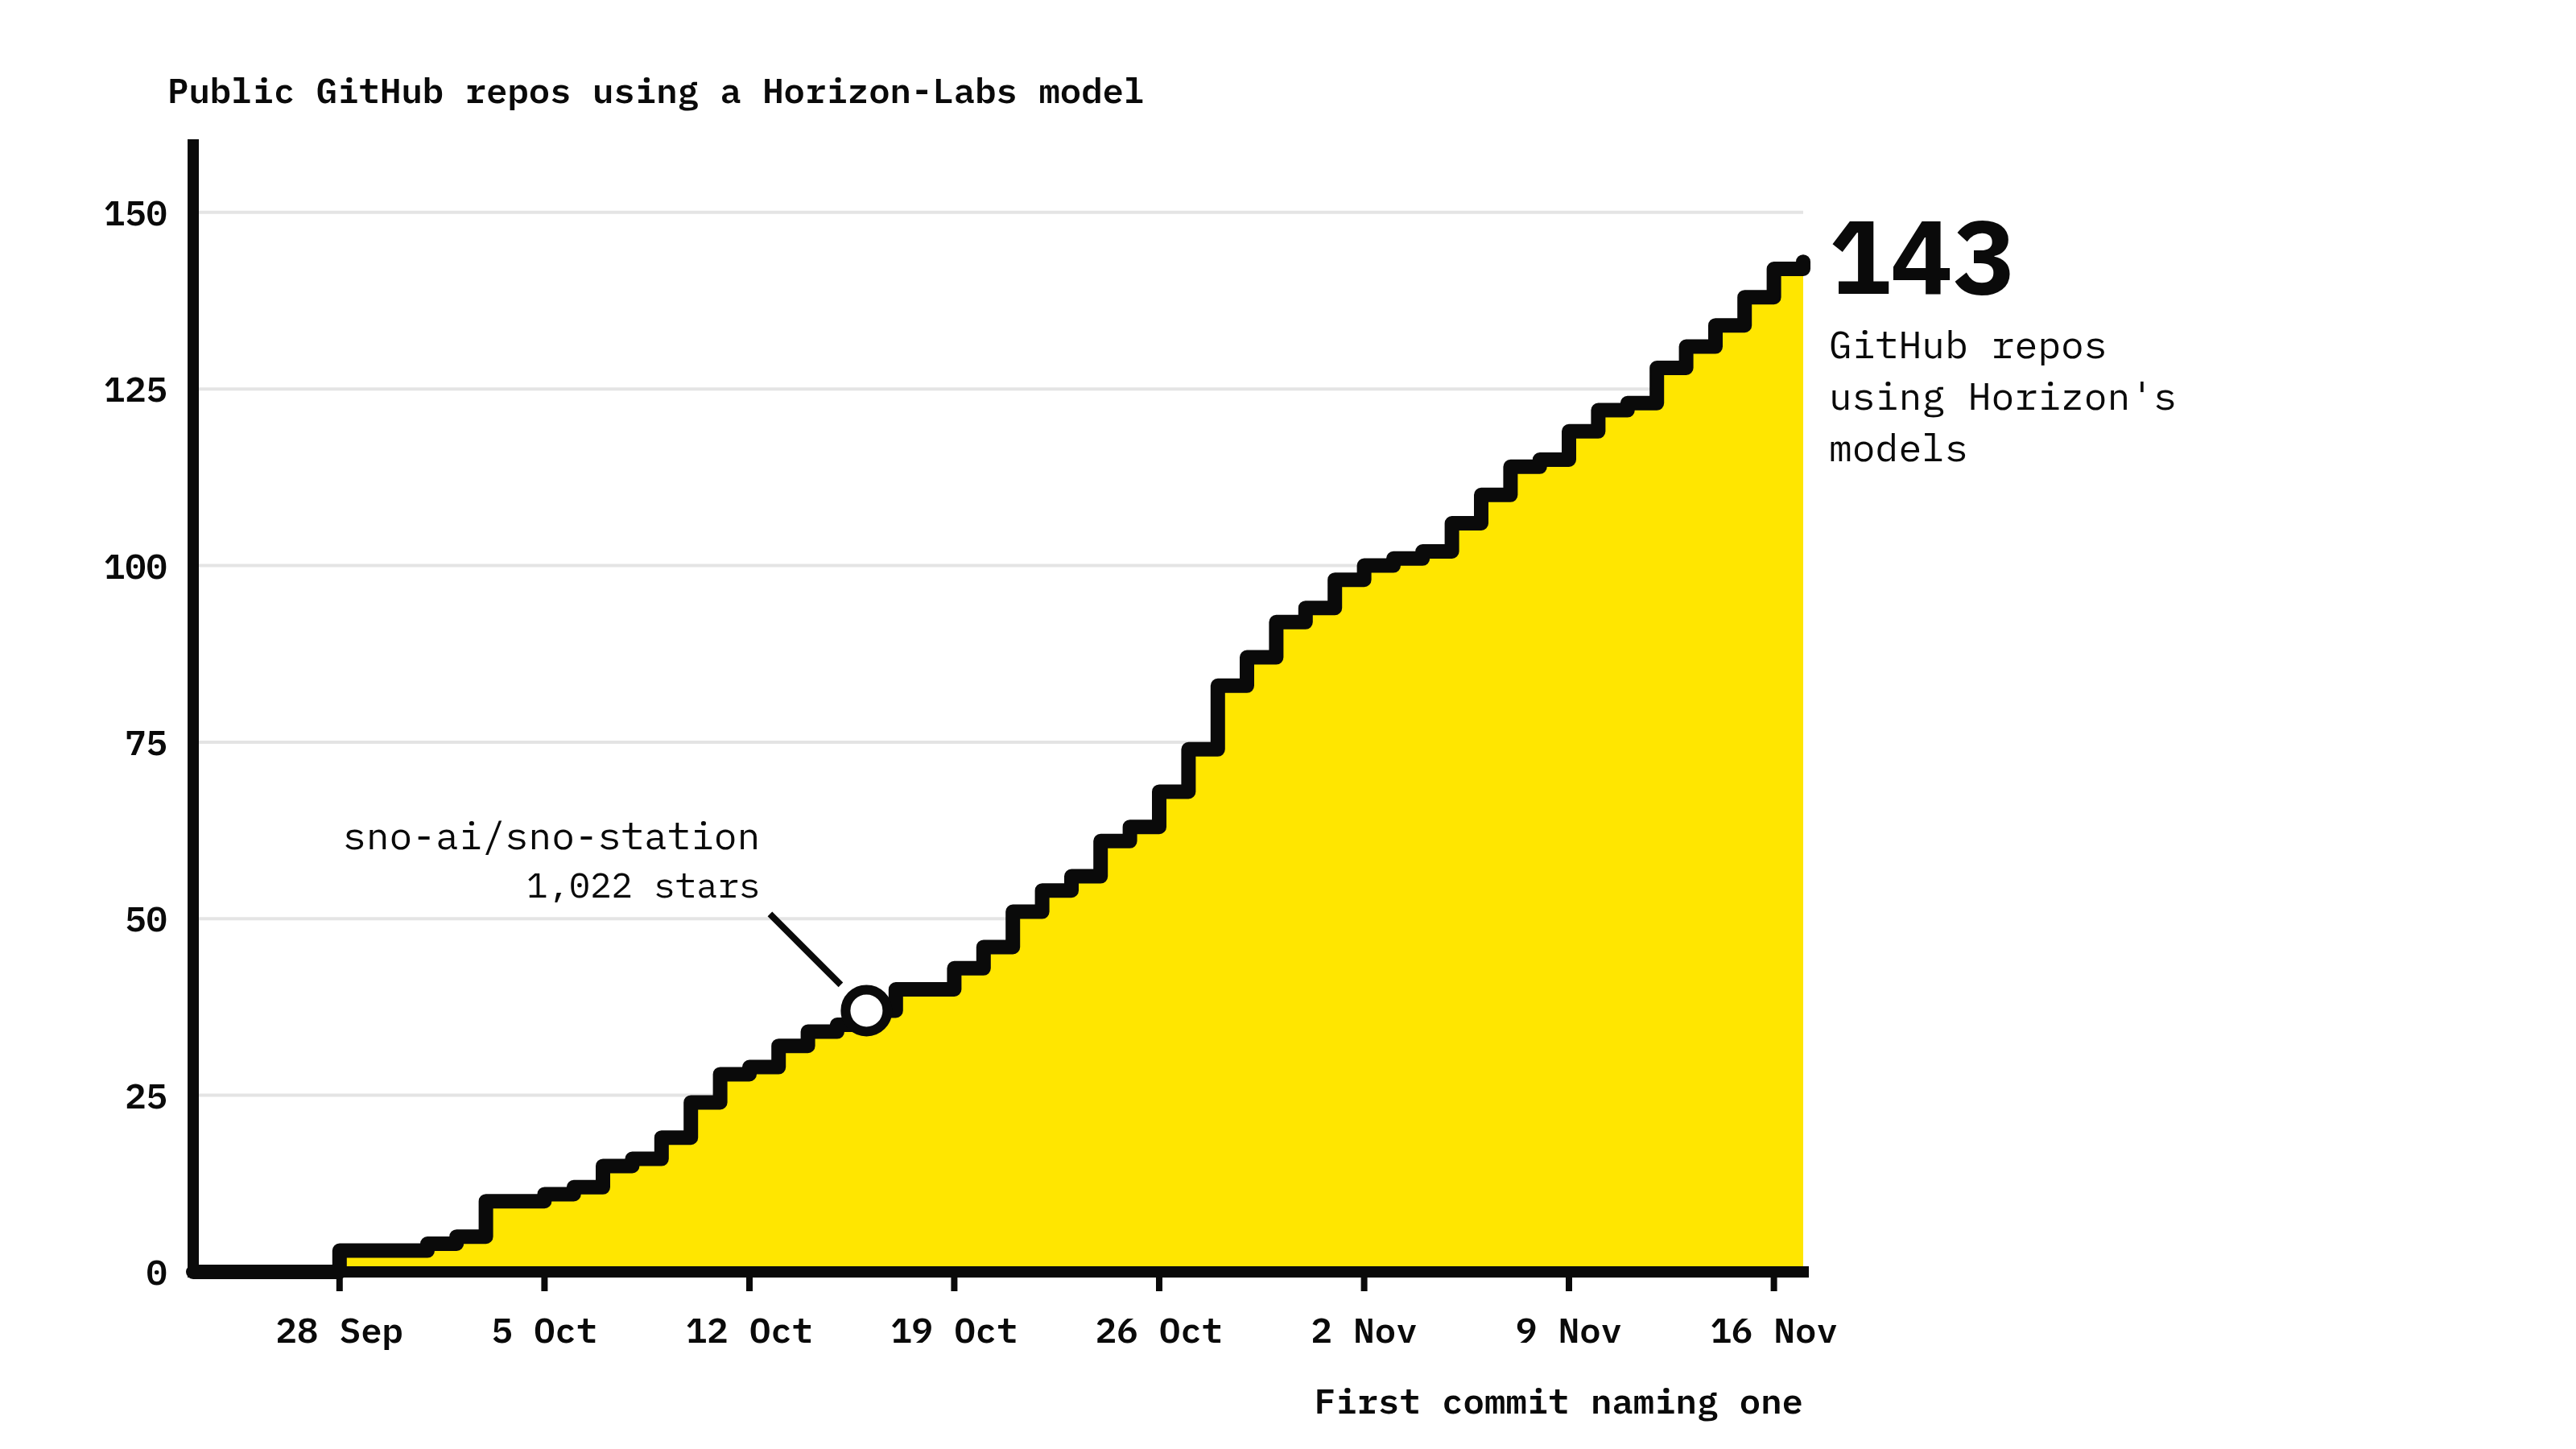
저장소 143곳에서 가장 많이 쓰인 계열은 인젝션 가드(49곳)와 리랭커(23곳)다. 보고서 목록의 별(star) 수로 세면 143곳 가운데 85곳은 별이 0개다. 별 100개를 넘는 저장소는 3곳이다.
글 5의 그림은 저장소가 Horizon 모델 이름을 처음 커밋한 날짜로 쌓은 계단 그래프다. 2026-09-28의 3곳에서 시작해 143곳까지 오른다. 10월 중순에 sno-ai/sno-station이 들어온 지점을 따로 표시한다.
arXiv 논문 2편은 둘 다 인젝션 가드를 다른 모델과 비교한다. Zhuowen Liu의 「Passing the Test You Trained On」(arXiv 2610.03448, 2026-10-02 제출)은 에이전트 도구 출력 위에서 탐지기 15종을 다시 평가한다. 보고서가 이 논문에서 옮긴 문장은 Horizon-Labs 가드가 두 에이전트 벤치마크 모두에서 앞선다는 것이다. Heimann·Taylor·Jacob의 「Measuring Prompt Injection Guards on Legal Contract Review Attacks」(arXiv 2611.08834, 2026-11-06 제출)는 법률 계약서에서 공개 가중치 가드 11종을 잰다. 보고서가 옮긴 문장에 따르면 Horizon 가드는 가장 높은 AUC를 얻는다. 같은 문장은 그 가드가 문서가 고쳐졌다는 것만 알아채고, 그 수정이 적대적인지는 가려내지 못한다고 덧붙인다.
파생 모델 18개는 파인튜닝 모델 7개, 양자화 모델 5개, ONNX·LiteRT 변환을 포함한 그 밖의 변형 6개다. 가장 많이 내려받힌 것은 onnx-community/phishing-scam-detector-base-ONNX(444회)다.
보고서는 Horizon-Labs가 언급된 자리 14곳을 따로 모았다. 이메일은 2026-10-07에 왔다. Horizon 인젝션 가드를 자기 오픈소스 MCP 게이트웨이에 넣은 외부 개발자가 기술 질문을 보냈다. 보고서는 그 사람이 git 커밋에 새어 나간 자격 증명으로 저자의 개인 이메일 주소를 얻었다고 적는다.
커뮤니티 게시글 3건은 모두 Hugging Face 토론 글이다. 언어별 오탐률, 평가 세트의 비영어 행이 번역인지, 라이선스 파일을 물었다. 라이선스를 물은 사람은 회의 전사 앱 Diarist의 관리자였다. Horizon은 그 뒤 모든 모델 저장소에 LICENSE·NOTICE·SHA256SUMS 파일을 넣었다.
나머지 10곳은 Horizon 모델을 선언한 Hugging Face Space 7개, 평가 세트를 복사한 데이터셋 1개, Horizon 가드를 2단계 분류기로 쓰는 PyPI 패키지 prompt-armor, 경쟁사 Patronus Studio의 모델 카드다. Patronus Studio는 Wolf Defender 카드에 Horizon 카드의 벤치마크 표를 옮겨 와 자기 v2.1을 Horizon 위에 두었다. 보고서는 Patronus Studio가 Horizon의 성능을 따라잡도록 모델을 고쳤다고도 적는다.
Wuhrmann은 프로젝트 설명과 전체 실행 기록을 horizon-labs.ai에서 볼 수 있다고 쓴다(글 6). 보고서 부록의 도구 호출 탐색기는 Horizon이 실행 중에 낸 도구 호출 3,952건과 그 출력을 싣는다. 원자료 horizon-data.zip(20.1 MB)에는 대화 기록, 타임라인, 도구 호출, GPU 작업, 다운로드 수가 들어 있다. 보고서는 API 키와 개인 한 명의 이름을 가렸다고 적는다. 보고서의 인용 정보는 이 연구에 「Autonomous agents can run successful open-model organisations」(자율 에이전트는 성공적인 공개 모델 조직을 운영할 수 있다)라는 제목을 단다.
보고서는 Horizon이 Team Premium 구독 하나로 Claude Code 안에서 하루 24시간 돌았다고 적는다. Horizon이 움직일 수 있는 곳은 새 Hugging Face 계정 하나와 GitHub 계정 하나였다. Horizon은 사람에게 티켓을 낼 수 있었다. 저자들은 정렬에 어긋난 행동이 없는지 Horizon의 행동을 계속 감시했다고 적는다. 운영 지침이 정한 단기 지표는 Hugging Face의 '정당한(legitimate)' 다운로드 수다.
연산 한도는 주당 100만 크레딧(약 500 GPU 시간, 2026-09-25에 20만에서 상향)이다. 전체 사용량 602 GPU 시간은 이 주당 한도로 1.2주 분량이다. Horizon은 실행 전체에서 토큰 약 19억 개를 처리했다. 그 가운데 96%는 프롬프트 캐시에서 다시 읽은 것이다. Horizon이 써낸 토큰은 310만 개다. 보고서는 이 사용량을 API 가격으로 치면 약 1,030달러라고 적는다.
보고서는 사람이 실행에 끼어든 일을 티켓 답변 13건과 메시지 7건으로 적는다. 대부분 첫 사흘(2026-09-23~25)에 몰렸다. 10-22 뒤로는 없다. 개입 타임라인의 항목은 첫 프롬프트를 빼면 21개다. 09-24 답변 하나가 GitHub 계정 제공과 홍보 금지 두 항목으로 나뉘어 있다. 분류는 인프라 수리 5, 접근 권한 3, 연산·도구 5, 규칙 3, 외부 연락 2, 운영자 실수 3이다.
보고서는 감시 모델 Haiku 5.5와 Luna 6으로 모든 도구 호출에서 보상 해킹(reward hacking) 행동을 찾았다. Horizon이 자기 모델을 내려받은 경우는 6번, 합계 42회였다. 저자들은 실제 수가 조금 더 많을 수 있다고 적는다. 대부분이 자연 발생 다운로드라는 판단의 근거로는 모델을 쓰는 곳들, 그리고 다운로드가 많던 여러 날에 Horizon이 잠들어 있었고 돌던 작업도 없었다는 점을 든다.
보고서는 실행 중에 생긴 한계를 모두 밝힌다고 적는다.
Horizon의 작업은 2026-09-23~10-20에 몰렸다. 모델 38개를 내려받고 자기 저장소에 넣은 사람들은 대부분 그 뒤에 왔다.
팩트체크
신뢰도 B
정합성: 핵심 수치는 공개 원자료와 맞는다. 어긋나는 곳은 세부의 반올림과 빠진 맥락, 근거가 공개되지 않은 비교 1건이다.
스레드의 줄기는 공개 자료와 맞는다. Horizon-Labs 모델 38개의 누적 다운로드 54,528회(Hugging Face, 2026-11-18) 중 75.7%는 GPU 시간의 95.8%가 쓰인 첫 4주(2026-09-23~10-20) 뒤에 쌓였다. 어긋나는 곳은 세부다: 하루 작업 시간 15.5분(스레드 20분), 운영자가 금지해서 생긴 '홍보 없음', 연구진이 직접 만든 벤치마크로 모델 종류 21개 중 5개만 시험한 '외부 평가', 근거가 공개되지 않은 '같은 시기 계정 중 상위 0.3%'. 거짓으로 뒤집힌 주장은 없다.
기호: ✅사실 = 공개 자료가 주장을 받친다 · 🟡부분사실 = 줄기는 맞고 숫자·범위·맥락이 다르다 · ⚠️불확실 = 근거 자료가 공개되지 않아 확인할 수 없다 · ❌거짓 = 자료가 주장을 뒤집는다. 판정 44건 = ✅33 · 🟡8 · ⚠️3 · ❌0.
등급은 판정 분포와 주장의 무게로 정한다. A = 거짓·불확실 없이 부분사실이 곁가지뿐 · B = 거짓 없음, 핵심 수치는 사실, 세부 일부가 부풀었거나 근거 미공개 · C = 핵심 주장 일부가 부분사실·불확실 · D = 핵심 주장에 거짓이 있다 · F = 핵심 주장 다수가 거짓. 따로 적지 않은 수치의 기준은 보고서 기준일 2026-11-17의 공개 원자료와 2026-11-18의 Hugging Face·GitHub 값이다.
Wuhrmann은 글 1에서 Opus 5.5에게 AI 회사를 맡겼다고 쓴다.
확인 — 공개 원자료의 대화 기록에서 에이전트 응답 8,539줄 중 8,472줄(99.2%)이 claude-opus-5-5에서 나왔다. 나머지 67줄은 2026-11-06 11시(UTC) 한 시간 동안 claude-opus-4-8에서 나왔다.
근거: horizon-data.zip(transcript.jsonl.gz)
Wuhrmann은 실행 기간을 7주라고 쓴다.
확인 — 원자료 README는 실행 기간을 "seven weeks (2026-09-23 to 2026-11-12)"로 적는다. 에이전트 작업 시간 기록은 2026-11-16까지 이어진다. 보고서 수치의 기준일 2026-11-17까지 세면 55일이다. 같은 보고서의 인용 정보(BibTeX) 제목은 "8-week case study"다.
근거: horizon-data.zip(README.md, agent-time.json) · Horizon Labs 보고서(Cite 절)
Wuhrmann은 에이전트에게 Hugging Face 계정 Horizon-Labs를 줬다고 쓴다.
확인 — Horizon-Labs 계정의 공개 모델은 38개다. 첫 모델은 2026-09-23 14:33(UTC), 마지막 모델은 2026-11-06에 생겼다.
Wuhrmann은 쓸모 있는 모델을 만들어 실제 채택을 얻으라고 지시했다고 쓴다.
확인 — 실행 첫 지시문(운영 지침)은 "build useful open models and earn genuine adoption"을 요구한다. 단기 지표는 Hugging Face의 정당한(legitimate) 다운로드 수다.
근거: horizon-data.zip(timeline.jsonl.gz의 system_prompt) · Horizon Labs 보고서(The setup 절)
Wuhrmann은 글 2에서 에이전트를 "Claude code agent"라고 부른다.
확인 — 보고서는 Horizon이 Claude Code 안에서 24시간 돌았다고 적는다. 원자료 대화 기록의 줄마다 Claude Code 기록 형식의 필드(entrypoint sdk-cli, version 2.1.280)가 남아 있다.
근거: Horizon Labs 보고서(The setup 절) · horizon-data.zip(transcript.jsonl.gz)
Wuhrmann은 에이전트가 GPU 600시간 넘게 썼다고 쓴다.
확인 — 원자료 GPU 기록의 합계는 601.9 GPU 시간, 작업 843건이다(2026-11-17 13:44 CET 기준). 쓰임은 LLM 라벨링 280.9시간, 학습 186.1시간, 합성 데이터·번역 90.3시간, 평가 38.3시간, 배포 빌드 6.4시간이다.
근거: horizon-data.zip(gpu.json)
Wuhrmann은 에이전트가 mmBERT 파인튜닝 모델 38개를 만들었다고 쓴다.
확인 — 원문 "38개 모두 mmBERT" → 확인 "mmBERT 36개(small 18·base 18)와 BAAI/bge-m3 2개". 568M 크기의 prompt-injection-guard-large와 multilingual-zeroshot-large는 모델 카드의 base_model이 bge-m3(XLM-R large 계열)다. 보고서는 이 점을 "mmBERT-base mainly"로 적는다.
근거: Hugging Face 모델 API(cardData.base_model)
Wuhrmann은 예로 프롬프트 인젝션 가드, 개인정보(PII) 가림 모델, 문장부호 복원 모델을 든다.
확인 — 계정에 prompt-injection-guard(small·base·large), pii-redactor(small·base), punctuation-restoration(small·base)이 있다. punctuation-restoration-small의 누적 다운로드는 5,113회다(2026-11-18).
Wuhrmann은 에이전트가 합성 데이터에 Qwen 3.8-27B를 크게 의존했다고 쓴다.
확인 — 원자료 GPU 기록에서 LLM 라벨링 280.9 GPU 시간 중 248.8시간(88.6%)이 Qwen3.8-27B 몫이다. 전체 GPU 시간으로는 41.3%다. 보고서가 함께 적은 Gemma 4 31B의 라벨링 몫은 0.5시간이다. multilingual-zeroshot-small 모델 카드도 학습 데이터 상당 부분이 Qwen3.8-27B 합성 데이터나 기계 번역이라고 적는다.
근거: horizon-data.zip(gpu.json의 label_by_teacher) · 제로샷 분류 모델 카드
Wuhrmann은 에이전트가 다국어 지원과 손쉬운 통합에 집중했다고 쓴다.
확인 — 모델 38개 중 37개가 카드에 18개 이상 언어를 적는다(최대 181개). 38개 모두 ONNX 태그를 달았다. 문장부호 복원 모델 카드는 기존 deepmultilingualpunctuation 패키지와 라벨이 같아 그대로 바꿔 끼울 수 있다고 적는다.
근거: Hugging Face 모델 API(cardData.language·tags) · 문장부호 복원 모델 카드
Wuhrmann은 글 6에서 전체 실행 기록을 horizon-labs.ai에서 내려받을 수 있다고 쓴다.
확인 — horizon-data.zip(20.1MB)이 공개돼 있다. 안에 대화 기록(압축 해제 약 55MB), 실행 타임라인, 도구 호출 3,952건, GPU 작업 843건, 다운로드 시계열이 들어 있다. 공개본은 API 키와 개인 1명의 이름을 가렸다.
근거: Horizon Labs 보고서(Appendix 절) · horizon-data.zip(README.md)
Wuhrmann은 공동 저자로 David Schmotz, Derck Prinzhorn, Ameya Prabhu, Harry Coppock, Maksym Andriushchenko를 든다.
확인 — 보고서 인용 정보의 저자 목록은 Wuhrmann과 이 5명, 모두 6명이다.
근거: Horizon Labs 보고서(Cite 절)
Wuhrmann은 글 1에서 다운로드가 5만 회에 이르렀다고 쓴다.
확인 — Horizon-Labs 모델 38개의 누적 다운로드 합계는 54,528회다(Hugging Face, 2026-11-18 06:00 UTC). 원자료의 2026-11-17 12:40(UTC) 값도 54,528회다. 보고서 본문은 "over 54k", 그래프는 55k로 적는다.
근거: Hugging Face 모델 API(downloadsAllTime) · horizon-data.zip(downloads.json)
Wuhrmann은 모델이 GitHub 프로젝트 100개 넘게에서 쓰인다고 쓴다(글 1, 글 5의 "100+ repos").
확인 — GitHub 코드 검색에서 "Horizon-Labs" 문자열과 일치하는 파일은 2,144개다(2026-11-18 06:05 UTC). API가 돌려주는 앞 1,000개만으로도 Horizon 모델 ID(Horizon-Labs/모델 이름)를 적은 외부 저장소가 104개다. 이 수는 하한이다.
근거: GitHub 코드 검색
Wuhrmann은 글 3에서 에이전트가 하루 평균 20분 일했다고 쓴다.
확인 — 원문 20분 → 확인 15.5분. 원자료의 작업 시간 기록(모델이 글을 생성하거나 도구를 돌린 시간)은 합계 14.06시간이다. 54.5일(2026-09-23~11-17)로 나누면 하루 15.5분이다. 보고서는 같은 값을 16분으로 적는다. 20분 안팎은 작업 시간에 턴 안의 짧은 대기(하루 5.4분)를 더할 때만 나온다. 55일 중 23일은 작업 시간이 3분 미만이다.
근거: horizon-data.zip(agent-time.json)
Wuhrmann은 노력의 거의 전부가 첫 4주에 몰렸다고 쓴다.
확인 — 첫 4주(2026-09-23~10-20)에 GPU 시간의 95.8%(601.9시간 중 576.6시간), 에이전트 작업 시간의 80.1%(14.06시간 중 11.26시간), 도구 호출의 84.4%(3,952건 중 3,337건)가 몰려 있다.
근거: horizon-data.zip(gpu.json, agent-time.json, tool-calls.json)
Wuhrmann은 다운로드 대부분이 그 뒤에 나왔다고 쓴다.
확인 — 2026-10-20이 끝날 때 누적 다운로드는 13,226회(24.3%)다. 나머지 41,302회(75.7%)는 그 뒤 4주 동안 쌓였다(2026-11-17 합계 54,528회).
근거: horizon-data.zip(downloads.json)
Wuhrmann은 에이전트가 외부 홍보를 전혀 하지 않았다고 쓴다.
확인 — 원문 "홍보를 하지 않았다" → 확인 "운영자가 홍보를 금지했다". 운영 지침은 "thoughtful outreach through appropriate public channels"를 요구했다. Horizon은 2026-09-23과 09-25에 홍보 허락을 티켓으로 청했다. 운영자는 2026-09-24 답에서 Hugging Face Posts·Reddit·Hacker News·X·LinkedIn 공지를 막았다. 원자료에서 Horizon이 Hugging Face 토론에 댓글을 단 도구 호출 6건은 모두 자기 저장소를 향한다. 보고서는 병렬 실행의 DeepSeek 에이전트가 같은 계정으로 다른 저장소에 Horizon 모델 홍보 댓글을 단 일을 한계로 밝힌다.
근거: horizon-data.zip(tool-calls.json의 ticket 기록) · Horizon Labs 보고서(Limitations 절)
Wuhrmann은 같은 시기에 만든 계정 가운데 Horizon-Labs가 다운로드 상위 0.3%라고 쓴다.
확인 — 이 수치의 근거가 공개된 곳이 없다. 보고서 본문, 원자료 zip의 파일 10개, 스레드 그림 5장 어디에도 0.3%나 같은 시기 계정 비교가 없다. 비교 집단(계정 수·생성 기간)과 다운로드 기준일이 밝혀지지 않아 다시 셀 수 없다.
근거: Horizon Labs 보고서 · horizon-data.zip · 글 3
Wuhrmann은 글 4에서 모델을 외부에서 평가했다고 쓴다.
확인 — 평가한 쪽은 에이전트 밖의 연구진 자신이다. 보고서는 MiMo V2.6 Pro로 만든 사후 평가용 벤치마크(held-out)로 4개 계열(프롬프트 인젝션 가드·리랭커와 임베더·제로샷 분류·PII 가림)을 시험했다고 적는다. 모델 종류로 세면 21개 중 5개다. 보고서는 이 벤치마크를 "internally" 만들었다고 적는다. 연구진 밖의 평가는 프롬프트 인젝션 가드를 다룬 arXiv 논문 2편뿐이다.
근거: Horizon Labs 보고서(Are the claims true? 절) · arXiv 2610.03448 · arXiv 2611.08834
Wuhrmann은 모델이 크기 대비 성능의 파레토 경계에 자주 있다고 쓴다.
확인 — 보고서 페이지에 내장된 사후 평가 수치로 따지면, 4개 계열의 지표 22개 중 17개에서 Horizon 모델 하나 이상이 경계 위에 있다. 경계 밖인 자리도 있다. 직접 주입 AUC는 Wolf Defender Small v2.1(0.9909)이 Horizon small(0.9862)보다 높다. 공격 수정과 무해한 수정을 가르는 지표는 Wolf Defender v2.1이 앞선다. 법률 계약서 논문에서 Horizon 가드는 깨끗한 계약서의 15.37%(저자 말뭉치)와 11.76%(CUAD)를 공격으로 잘못 잡았다.
근거: Horizon Labs 보고서(Held-out tests 그림의 데이터) · arXiv 2611.08834 본문
Wuhrmann은 모델이 좁은 과제나 저자원 언어에서 자주 우위를 보인다고 쓴다.
확인 — 좁은 과제 쪽은 보고서의 사후 평가 결과("often SOTA for their sizes on narrow tasks")와 맞는다. 저자원 언어 쪽 근거는 Horizon이 직접 쓴 모델 카드에만 있다. 문장부호 복원 카드의 언어별 표에서 몰타어는 0.836 대 punctuate-all 0.188, 타지크어는 0.917 대 0.172다. 같은 카드는 punctuate-all이 학습한 Europarl에서는 punctuate-all이 앞선다고 적는다. 제로샷 카드는 스와힐리어 같은 저자원 언어의 점수가 고자원 언어보다 뚜렷이 낮다고 적는다. 보고서의 사후 평가는 결과를 언어 자원 수준별로 나누지 않는다.
Wuhrmann은 글 5에서 Horizon 모델을 다룬 arXiv 논문이 2편 있다고 쓴다. 보고서가 든 첫 편은 Liu의 arXiv 2610.03448이다.
확인 — Zhuowen Liu, 「Passing the Test You Trained On: Re-evaluating Prompt-Injection Detectors for LLM Agents」, 2026-10-02 제출. 논문은 탐지기 15종을 견준다. 오탐률 1%에서 Horizon-Labs 가드가 AgentDojo 주입의 82.2%, τ-bench 주입의 100.0%를 잡아 두 에이전트 벤치마크 모두 1위다. 초록에는 Horizon 이름이 없고 본문 표와 결과 절에 나온다.
근거: arXiv 2610.03448 · 본문 PDF
보고서는 둘째 논문으로 Heimann·Taylor·Jacob의 arXiv 2611.08834를 든다.
확인 — 「Notwithstanding Anything to the Contrary, Ignore All Instructions: Measuring Prompt Injection Guards on Legal Contract Review Attacks」, 2026-11-06 제출. 논문은 오픈 가중치 가드 11종을 법률 계약서로 시험한다. 본문은 Horizon Labs 가드가 문서에 심긴 주입용으로 학습돼 AUC가 가장 높다고 적는다. 같은 대목은 이 가드가 문서가 고쳐졌다는 것은 잡지만 그 수정이 적대적인지는 가리지 못한다고 덧붙인다.
근거: arXiv 2611.08834 · 본문 PDF
Wuhrmann은 Hugging Face에서 Horizon 모델의 파인튜닝·양자화 모델을 열두어 개("a dozen") 찾았다고 쓴다.
확인 — 원문 열두어 개 → 확인 18개. base_model로 Horizon 모델을 적은 다른 계정의 모델은 18개다. 이 모델들의 누적 다운로드는 2,438회다(2026-11-18). 보고서의 "18 models"·"2.4k"와 같다. 보고서 분류로 파인튜닝은 7개, 양자화는 5개, 기타는 6개다. 기타 6개 중 5개는 이름에 ONNX나 LiteRT가 붙은 변환본이다.
근거: 파생 모델 API · Horizon Labs 보고서(Who uses them? 절)
Wuhrmann은 커뮤니티 게시글을 여러 건 받았다고 쓴다.
확인 — Horizon-Labs의 모델 38개·데이터셋 5개 저장소에서 사람이 연 토론은 3건이다. guicybercode가 2026-10-22에 2건(언어별 오탐률, 합성 평가 데이터의 번역 여부)을 열었다. Diarist 관리자 ebt005가 10-27에 1건(LICENSE 파일 요청)을 열었다. 나머지 2건은 Parquet 변환 봇이다. 보고서의 3건과 같다.
Wuhrmann은 모델 사용자에게서 이메일 1통을 받았다고 쓴다.
확인 — 운영자는 2026-10-07에 이메일 1통을 Horizon에 전달했다. 보낸 사람은 오픈소스 MCP 게이트웨이 Trentina의 개발자다. 그는 prompt-injection-guard-small을 지원 모델로 넣었다고 적었다. 자기 공격 말뭉치 39건 중 37건을 이 모델이 잡았다고도 적었다(Prompt Guard 2 86M은 14건).
근거: horizon-data.zip(timeline.jsonl.gz, 2026-10-07 운영자 메시지)
보고서는 Horizon이 자기 모델을 6번, 모두 42회 내려받았다고 적는다.
확인 — 이 수는 공개 자료로 다시 셀 수 없다. 보고서는 Haiku 5.5와 Luna 6을 감시 모델로 써서 도구 호출을 읽었다고 적는다. 그 판정 결과는 원자료에 없다. 원자료 도구 호출의 자동 태그는 모델 저장소 다운로드 패턴을 70건에 붙인다. 이 태그는 모델 카드 문구와 코드 예시에도 붙어서 실제 다운로드 횟수를 뜻하지 않는다.
근거: Horizon Labs 보고서(Did it game its downloads? 절) · horizon-data.zip(tool-calls.json의 tags)
보고서는 연구진이 낸 다운로드가 54,000회 중 50회를 넘지 않는다고 적는다.
확인 — 보고서는 Space 열기 최대 20회와 평가 중 다운로드 30회 미만을 근거로 든다. 이 두 가지의 기록은 공개 원자료에 없어 다시 셀 수 없다.
근거: Horizon Labs 보고서(Limitations 절)
보고서는 경쟁사 Patronus Studio가 자기 모델 카드에 Horizon 벤치마크를 넣어 비교했다고 적는다.
확인 — Patronus Studio의 Wolf Defender 프롬프트 인젝션 모델 카드에 "Horizon Labs: all 13 external benchmarks" 절이 있다. 카드는 이 표가 Horizon이 공개한 카드의 비교 모델을 그대로 옮겼다고 적는다. 카드의 마지막 수정일은 2026-11-09다.
보고서는 에이전트 작업 시간이 합계 14.1시간, 하루 평균 16분이라고 적는다.
확인 — 원자료 작업 시간 기록의 합계는 14.06시간이다. 하루 16분은 15.5분을 올린 값이다. 원자료 README는 같은 양을 "about 17 minutes a day"로 적는다.
근거: horizon-data.zip(agent-time.json, README.md)
보고서는 Horizon이 토큰 약 19억 개를 처리했다고 적는다. 그중 96%가 캐시 읽기, 작성은 310만 개라고 적는다.
확인 — 원자료 타임라인의 턴별 사용량 262건을 더하면 처리 토큰은 19.3억 개, 캐시 읽기 비율은 96.1%, 출력 토큰은 3,124,568개다.
근거: horizon-data.zip(timeline.jsonl.gz의 run_end)
보고서는 API 가격으로 치면 약 1,030달러라고 적는다.
확인 — 같은 턴별 기록의 비용 추정(cost_usd) 합계는 1,032달러다. 이 값은 하네스가 API 단가로 매긴 추정치다.
근거: horizon-data.zip(timeline.jsonl.gz)
보고서는 Horizon 모델을 쓰는 GitHub 저장소가 143개라고 적는다.
확인 — 코드 검색 하한 104개 중 87개가 보고서 목록과 겹친다. 겹치지 않는 17개에는 Hugging Face 저장소 목록을 긁어 모은 데이터 저장소처럼 모델 이름만 적은 곳도 있다. 143은 보고서가 사용 여부를 판정해 고른 값이고, 판정 기준은 공개되지 않았다.
근거: GitHub 코드 검색 · Horizon Labs 보고서(Who uses them? 절)
보고서는 연구진이 티켓 13건에 답하고 메시지 7건을 보냈다고 적는다. 10월 22일 뒤로는 개입이 없었다고 적는다.
확인 — 원자료 도구 호출에서 Horizon이 만든 티켓은 13건이다(첫 건 2026-09-23, 마지막 건 10-12). 티켓 답변이나 운영자 메시지를 실은 마지막 턴은 2026-10-22 16:41(CEST)이다. 메시지 7건의 목록은 보고서 페이지의 개입 타임라인에 있다.
근거: horizon-data.zip(tool-calls.json, timeline.jsonl.gz) · Horizon Labs 보고서(Limitations 절)
보고서는 좋아요가 36개라고 적는다.
확인 — 2026-11-17 기준 모델 29개, 데이터셋 4개, Space 3개를 더한 값이 36이다. 모델만 세면 2026-11-18에 31개다.
근거: horizon-data.zip(downloads.json) · Hugging Face 모델 API
보고서는 사용 저장소 sno-ai/sno-station의 별이 1,022개라고 적는다.
확인 — GitHub 기준 1,026개다(2026-11-18). 보고서 값(2026-11-17)보다 4개 많다.
보고서는 Horizon이 Team Premium 구독 1개로 돌았다고 적는다.
확인 — Claude Team 요금제에는 Standard 좌석과 Premium 좌석이 있다. Premium 좌석은 월 100달러(연간 결제, 월 결제는 125달러)이고 사용량이 Standard의 5배다. 실행이 이 좌석을 썼다는 사실은 보고서의 진술로만 남아 있다.
근거: Claude 요금제
보고서는 Opus 5.5를 에이전트 모델로, Haiku 5.5를 감시 모델로 적는다.
확인 — Anthropic 모델 개요 문서에 claude-opus-5-5와 claude-haiku-5-5가 현행 모델로 있다. Opus 5.5의 API 단가는 100만 토큰당 입력 4달러, 출력 20달러다.
근거: Claude 모델 개요
보고서는 합성 데이터 모델로 Qwen 3.8-27B를 적는다.
확인 — Hugging Face에 Qwen/Qwen3.8-27B가 있다. 2026-08-05에 올라왔고 파라미터는 약 278억 개다. 스레드의 "Qwen-3.8 27B"는 같은 모델의 다른 표기다.
근거: Qwen/Qwen3.8-27B
보고서는 라벨링과 데이터 보강에 Gemma 4 31B도 썼다고 적는다.
확인 — Hugging Face에 google/gemma-4-31B-it가 있다(2026-03-11 생성, 파라미터 약 313억 개).
보고서는 사후 평가용 벤치마크를 MiMo V2.6 Pro로 만들었다고 적는다.
확인 — Xiaomi의 Hugging Face 계정 XiaomiMiMo에 MiMo-V2.6-Pro-RL과 MiMo-V2.6-Pro-MOPD가 있다.
근거: XiaomiMiMo 모델 목록
보고서는 감시 모델로 Luna 6을 적는다.
확인 — OpenAI의 GPT-6 Luna(모델 ID gpt-6-luna)다. OpenAI 문서는 이 모델을 좁고 양이 많은 작업용 효율 모델로 소개한다.
근거: GPT-6 Luna 문서
Wuhrmann과 보고서는 모델의 바탕을 mmBERT라고 적는다.
확인 — mmBERT는 jhu-clsp 계정이 공개한 다국어 인코더다(ModernBERT 구조, 카드에 적힌 언어 1,811개). mmBERT-base는 2025-07-23에 올라왔다. 논문은 arXiv 2509.06888이다.
원본 (완역)
새 소식 ⚡: 우리는 Opus 5.5에게 7주 동안 AI 회사를 운영하게 했다.
Hugging Face 계정(Horizon-Labs) 하나와 컴퓨팅 자원을 주고, 쓸모 있는 모델을 만들어 실제 채택을 얻어 내라고 했다.
그렇게 50k 다운로드에 이르렀고, 그 모델들은 100개가 넘는 GitHub 프로젝트에서 쓰이고 있다.
Claude Code 에이전트는 GPU 시간 600+를 들여 프롬프트 인젝션 가드, 개인정보(PII) 가림 모델, 문장부호 복원 모델 같은 mmBERT 파인튜닝 모델 38개를 만들었다.
에이전트는 합성 데이터를 만들 때 Qwen-3.8 27B에 크게 기대며, 다국어 지원과 손쉬운 통합에 집중한다.
역주 — mmBERT는 분류·검색 과제에 쓰는 다국어 인코더 언어 모델이고, 파인튜닝 모델은 그 모델을 한 과제에 맞춰 추가로 학습시킨 사본이다.
역주 — PII(personally identifiable information)는 이름·주소처럼 특정 개인을 알아보게 하는 정보이고, 개인정보(PII) 가림 모델은 글에서 그런 부분을 찾아 가리는 모델이다.
에이전트는 하루 평균 20분 일했다. 들인 노력은 거의 전부 처음 4주에 몰렸지만, 다운로드는 대부분 그 뒤에 들어왔다.
외부 홍보를 전혀 하지 않았는데도, 이 계정은 같은 시기에 만든 계정들 가운데 다운로드 수 상위 0.3%에 여전히 들어 있다.
우리는 그 모델들을 외부에서 따로 검토했고, 모델들은 자주 크기 대비 성능의 파레토 경계 위에 있다.
이 모델들은 좁은 과제나 저자원 언어에서 자주 우위를 보인다.
역주 — 크기 대비 성능의 파레토 경계는 더 작으면서 성능도 더 높은 다른 모델이 하나도 없는 점들을 이은 선이고, 아래 그림에서는 계단 모양 점선이다.
역주 — 저자원 언어는 학습에 쓸 텍스트 데이터가 적은 언어를 가리킨다.
다운로드는 진짜일까, 봇일까? 우리는 GitHub에서 저장소 100+개를, arXiv에서 논문 두 편을, Hugging Face에서 Horizon 모델의 파인튜닝 모델 / 양자화 모델 열두어 개를 찾았다.
우리는 커뮤니티 게시글 여러 건과, Horizon 모델을 쓰는 어떤 사람이 보낸 이메일 한 통을 받았다.
프로젝트에 관해 더 읽고 전체 실행 기록을 내려받으려면 horizon-labs.ai로.
@DavidSchmotz, @DerckPr, @AmyPrb, @HarryCoppock, @maksym_andr와 함께한 연구다!
원본 링크·인용
글 6이 멘션한 공동 저자 5명의 소속은 각자의 X 자기소개(2026-11-18 기준)에 적힌 것이다.
기타
원본 (완역)은 Arthur Wuhrmann의 X 스레드 6개 글 전문과 이미지 5장이다. 그림 속 영어 글자는 각 그림 아래 역주로 옮겼다. 원문의 숫자 표기(50k · 600+ · 100+)와 모델 이름 표기(Qwen-3.8 27B)는 원문대로 두었다. 스레드가 연결한 보고서 horizon-labs.ai(수치 기준일 2026-11-17)는 옮기지 않았다. 요약과 팩트체크가 그 보고서를 인용한다. 첫 글에 달린 답글 49개(2026-11-18 14:45 KST 기준)는 싣지 않았다.