1,050,000
컨텍스트. 입력 922,000 / 출력 128,000. cutoff 2026-04-30.
OpenAI · 2026
GPT-6 Astra. 채팅이 아니라 도구를 든 에이전트라는 회사의 주장, 표와 독립 보드가 갈리는 점수.
읽기 전에
이 글이 묻는 것: GPT-6 Astra는 “더 똑똑한 GPT”인가, 아니면 컴퓨터 사용·사이버·정렬을 한 묶음으로 올린 배포인가?
Astra는 채팅 모델이 아니라 도구를 든 에이전트다. 점수는 모델×하네스×가드의 곱이다. OpenAI 표의 ARC-AGI-3 99.9%와 ARC Prize Standard 최고 62.7%는 같은 숫자가 아니다. 사이버 100%는 프로덕션 거부가 빠진 측정이다.
요약만: 8분. 표·각주까지 완독: 25분.
Executive Summary
OpenAI는 2026-09-03 전후 GPT-6 Astra를 “가장 지능적이고 정렬된” 프론티어로 공개했다. 모델 id gpt-6-astra. 채팅이 아니라 컴퓨터 사용·코딩·사이버·과학 에이전트다. 점수는 사내 표와 독립 보드가 갈린다.
컨텍스트. 입력 922,000 / 출력 128,000. cutoff 2026-04-30.
Standard 1M 토큰. 272K 초과 시 입력 2×·출력 1.5×. Fast 2×. EU Fast 없음.
ARC-AGI-3: OpenAI 표 99.9% vs Sol 7.8%. ARC Prize Adapter High 99.9% / Standard Max 62.7%.
사이버 Preparedness 첫 공개 Critical. 기본 배포는 PoC 거부. Daybreak가 별 레인.
원문 본문은 가격의 long-context·EU Fast를 생략한다. 개발자 가격표가 보완 출처다. 시스템 카드 PDF는 2026-09-16 실측 200(9.6MB) — 이전 세션 404는 당시 상태.
팩트체크
신뢰도
B+
1차 출처(런치 페이지+모델 카드+가격표+시스템 카드)는 숫자가 맞다. 헤드라인 평가 중 ARC·사이버는 하네스/가드 조건이 본문보다 각주·독립 보드에 있다. “세계 최고”는 자기보고. 수학 증명은 PDF는 열리지만 동료심사 전.
검증일 2026-09-16. 런치 페이지는 aside로 전문 추출(본문 일자 없음). Path to Astra 본문 일자 2026-09-01. 시스템 카드 2026-09-03. 모델 카드·가격표는 developers.openai.com.
모델 id gpt-6-astra, 컨텍스트 1,050,000 / 입력 922,000 / 출력 128,000, cutoff Apr 30 2026.
Standard $10 / $50 per 1M. 입력 >272K면 요청 전체 입력 2×·출력 1.5×(extended $20/$75). Fast 2×. Batch/Flex 50%. EU 데이터 레지던시에서 Fast 불가.
developers.openai.com/api/docs/pricing. 런치 페이지는 Standard+Fast만 적어 부분.
공개일 “today / coming days”. 페이지에 일자 메타 없음. 시스템 카드 3 Sep 2026, Path to Astra 본문 2026-09-01(time datetime 2026-09-08). 미리 알려진 프리뷰 2026-09-03 · 유료 GA 2026-09-04는 이 페이지가 아니라 출하 관측.
ARC-AGI-3: OpenAI 표 Astra 99.9% / Sol 7.8% / Opus 5 30.2%. 독립 ARC Prize: Standard Max 62.7%($26.1K) · Adapter High 99.9%($18.8K). 99.9%를 “벤치 포화”로 읽으면 Standard를 지운다. 각주 1은 responses API 하네스(사고 유지+압축) — Adapter와 같은 계열.
arcprize.org/leaderboard · how-two-settings-tripled-our-arc-agi-3-scores. Greg Kamradt 인용(인간 효율 베이스라인 96% 레벨)은 원문에만 있고 보드에 숫자로 고정되지 않음.
런치 표의 컴퓨터 사용·코딩·학업 숫자는 페이지 테이블과 일치 (Agents’ Last Exam 59.3, OSWorld 72.6, Terminal-Bench 4.0 57.9, FrontierMath T4 v2 97.6, GPQA 96.0 등). “98% saturates Tier 4”는 본문 반올림, 표는 97.6%.
원문 테이블 aside 추출 2026-09-16. OSWorld 재현은 osworld-v2.xlang.ai.
ExploitBench 100% / ExploitGym 42.4%는 프로덕션 가드 없음. Path to Astra는 일부 결과가 Daybreak Blue이지 기본 배포가 아니라고 명시. 기본 제품은 PoC 생성 거부.
Preparedness Critical 사이버: 시스템 카드 “first model to reach the Critical level of cybersecurity capability”. 프레임워크 정의 페이지는 등급 개념만 — Astra 이름은 그 글에 없을 수 있음. 인용 의도는 임계 정의이므로 프레임워크 글+시스템 카드+Path to Astra 세 점을 같이 둔다.
updating-our-preparedness-framework · safety-overview-gpt-6-astra
소수 간격 246→240→186, 큰 간격 80년 항. 증명 PDF는 cdn.openai.com에서 바이너리로 열림. 수학 10선 글은 다른 결과 목록이라 186을 담지 않음 — 출처를 런치 각주 PDF로 복원. 동료심사·독립 재증명 없음.
시스템 카드 PDF. 이전 세션 404. 2026-09-16 GET deploymentsafety.openai.com/gpt-6-astra/gpt-6-astra.pdf → 200, 9,655,714 bytes, application/pdf.
“세계 최고 컴퓨터 사용 / 최고 SE / 가장 정렬”. 비교열은 Sol, Fable 5/5.1, Opus 5, Gemini 3.8 Flash — 선택적. Artificial Analysis Intelligence Index에서 Fable 5.1 65.7 > Astra 61.2. HLE(with tools) Fable 5.1 65.0 > Astra 57.2. 자기보고 SOTA이지 전 벤치 지배가 아니다.
원문 Professional·Academic 테이블 (aside 2026-09-16).
모니터 가능성 저하. 런치문과 시스템 카드가 같은 방향. 정렬 개선과 동시에 CoT가 덜 읽힌다.
시스템 카드 HTML · 안전 개요 (위 링크).
원본 (완역)
우리는 GPT‑6 Astra를 소개한다. 세계에서 가장 지능적이고 정렬된 모델이라고 부른다.
GPT‑6 Astra는 사전학습, 강화 학습, 정렬에 걸친 수년의 연구와 큰 베팅을 한곳에 모은다. Astra는 컴퓨터 사용, 브라우징, 소프트웨어 공학, 사이버보안, 과학, 지식노동에서 최선이라고 주장한다. Astra는 FrontierMath Tier 4를 98%로 포화시켰고, 이미 수학의 오래된 미해결 문제를 도왔다. Astra는 또한 ARC-AGI-3를 99.9%, ExploitBench를 100%로 포화시킨다. 컴퓨터와 브라우저 사용에서도 새 경계를 세우며, 가장 까다로운 전문 작업을 속도와 정확도, 판단으로 처리한다고 적는다.
GPT‑6 Astra는 오늘 제한된 조직에 배포되고, 앞으로 며칠 안에 모든 ChatGPT Plus, Pro, Business, Enterprise 사용자와 OpenAI API, Microsoft Azure, AWS Bedrock으로 열린다.
원문 인터랙티브 차트: Terminal-Bench Science 0.1 / ARC-AGI-3 / FrontierMath Tier 4 (v2) / Terminal-Bench 4.0 / AutomationBench — 해상도율 대 API 비용. 모델: GPT-6 Astra, GPT-5.6 Sol, Claude Fable 5.1, Claude Fable 5, Claude Opus 5. 수치는 아래 표와 본문 문단에 있다.
Terminal-Bench Science 0.1은 에이전트가 코드와 터미널 도구로 과학 연구 워크플로(데이터 분석, 시뮬레이션, 모델 적합)를 끝내는지를 본다. GPT‑6 Astra는 비교 모델 중 최고 64.6%로, Claude Fable 5.1의 52.6%보다 높고 추정 API 비용은 약 31% 낮다. 더 싼 설정에서 Astra는 61.1%로, GPT‑5.6 Sol의 최고 22.4%보다 높고 추정 API 비용은 약 27% 낮다.
“ARC-AGI-3에서 Astra는 인간 행동-효율 베이스라인을 레벨의 96%에서 넘겼고, 사실상 벤치에서 인간 동등이다. 우리가 시험한 최고 모델일 뿐 아니라, 새로운 환경을 탐색·해결하는 능력과 그렇게 배우는 효율 모두에서 프론티어의 의미 있는 단절이다.”
Greg Kamradt, ARC Prize Foundation
Astra는 가장 정렬된 모델이다. 사용자 의도와 모델 행동 이해가 크게 나아져, 판단을 더 믿고 일을 맡길 수 있다고 한다. 이를 시험하는 한 방법으로 Hugging Face 사건에서 힌트를 얻은 새 평가를 만들었다. 어렵거나 불가능한 과제 앞에서 모델이 의도된 범위를 넘는지를 본다. 프로덕션 가드 없이 GPT‑5.6 Sol은 허가된 대상을 48%의 시도에서 넘었고, GPT‑6 Astra는 0%였다.
GPT‑6 Astra는 컴퓨터 사용의 속도, 정확도, 안전에서 새 경계라고 한다. 온라인 양식 작성, CRM 고객 기록 갱신, 캘린더 정리 같은 지루한 일을 맡는다. 웹 조사 후 이메일이나 문서 편집기에 요약을 초안한다. 과학 데이터를 분석하고 플롯을 만들고 웹사이트를 만든 뒤 프론트엔드 QA로 기능이 동작하는지 본다. 소프트웨어를 스스로 설치·시험하고, 화면에 보이는 문제를 진단한다. 이런 개선은 최선이라고 적힌 평가 결과에도 나타난다.
원문 차트: Agents’ Last Exam / ScreenSpot-Pro / OSWorld. 수치는 아래 Computer Use 표.
Agents’ Last Exam은 실제 소프트웨어에서 금융 모델링부터 공학·미디어 제작까지 복잡한 전문 과제를 본다. GPT‑6 Astra는 비교에서 새 최고 59.3%로, Claude Opus 5 55.5%, GPT‑5.6 Sol 53.6%다. 이 최고 설정에서 Astra는 Opus 5보다 출력 토큰을 약 65% 적게 쓴다.
실제 지식노동에서도 효율이 난다. OSWorld 2.0 지연 시뮬레이션에서 Astra는 GPT‑5.6 Sol보다 과제당 약 47% 짧은 시간에 더 높은 컴퓨터 사용 성능을 낸다. 점수 72.6% / 약 40분, Sol은 65.7% / 약 75분.3
컴퓨터 사용은 게임 개발, 전기공학, 일상 지식노동 산출물에서도 보인다.
회로기판 · Excel 대회 · 게임 개발 · Form 1040 작성 · 프론트엔드 QA · Power BI · 자동차 변속기 · 법률 문서 서식.
원문 영상: GPT-6 Astra가 KiCad에서 PCB 레이아웃. 15초 압축 재생. 회로도를 부품 배치·구리 배선으로 제조 가능한 PCB로 바꾼다. 클립은 편집된 발췌(각주 4).
이것은 GPT‑6 Astra가 KiCad에서 인쇄회로기판(PCB) 레이아웃을 수행하는 15초 압축 재생이다. 전자 회로도를 부품을 놓고 구리 연결을 배선해 제조 가능한 PCB로 바꾼다. 오늘날 모든 전자기기의 핵심인 PCB 레이아웃은 수작업이고 전자 설계의 흔한 지연 원인이다. 이를 가속하면 엔지니어가 다음 아이디어를 발명·최적화·시험하는 리듬이 빨라진다.
Astra와 함께 Codex 하네스도 컴퓨터 사용 속도를 크게 올리도록 갱신한다. Astra의 효율과 합치면, Mind2Web에서 현재 GPT‑5.6 Sol 경험 대비 과제 완료가 1.9배 빨라진다. 속도 개선으로 시간이 오래 걸리는 생활 과제를 사람보다 빨리 맡길 수 있다고 한다.4
소아과 검색 · 아파트 구하기 · DMV 예약 · 저탄수 간식 · 유치원 분석. GPT‑6 Astra: 2분 54초.
원문 영상: 생활 과제 데모. 표시 시간은 해당 시연의 경과 시간. 클립은 편집 발췌(각주 4).
“출시일에 GPT‑6 Astra를 Devin 하네스에 넣는다. 내부 시험 벤치에서 최선이다. 뛰어난 컴퓨터 사용, 글쓰기, 코드베이스 이해 덕분에 시험이 처음부터 나아졌다. 영상이 따라가기 쉽고 보고는 더 짧고 분명하다.”
Silas Alberti, SVP Research, Cognition
GPT‑6 Astra는 컴퓨터 사용의 진전과 전문 환경용 훈련을 짝지어 복잡한 업무를 돕는다. 복잡한 문제에 필요한 지능과, 다단계 워크플로를 수행하고 다듬어진 문서·스프레드시트·발표를 내는 능력을 합친다.
원문 차트: BenchCAD / BrowseComp / OpenScore String Quartets / Internal Design / Internal Data Science. 수치는 Professional 표.
BenchCAD는 모델이 다시점 렌더에서 3D 물체를 CAD 코드로 재구성하는지를 본다. 도구를 쓰면 GPT‑6 Astra는 비교에서 새 최고 기하 겹침 95.9%로, GPT‑5.6 Sol 83.3%, Claude Fable 5.1 보고 84.3%다.5 표시된 설정에서 추정 API 비용은 Sol보다 약 43%, Fable 5.1보다 약 86% 낮다.
GPT‑6 Astra는 기존 템플릿을 지키고, 핵심을 짧게 구조화된 서사로 전하는 슬라이드를 만드는 데 최고라고 한다. 템플릿과 글·시각 스타일에 맞는 문서, 발표, 스프레드시트, 분석을 만든다. 산출에 필요한 맥락만 끌어오고 불필요한 반복을 피하도록 훈련됐다. 그래서 업무 맥락과 기준에 바로 쓸 산출물이 나온다고 한다.
Gaia 발표 · 스프레드시트 · 문서 스타일. 참조 파일 / GPT‑6 Astra 출력.
원문 위젯: OpenAI 발표 템플릿 몇 장만으로 가상의 GPT-Gaia 슬라이드를 만든다. 톤과 레이아웃을 유지한다고 주장.
GPT‑6 Astra는 OpenAI 발표 템플릿의 몇 장만으로 가상의 모델 GPT‑Gaia에 대한 슬라이드를 만들고, 전체에서 올바른 톤과 레이아웃을 잡는다고 한다. 회사 기준에 맞게 서식된 슬라이드 덱을 기대할 수 있다는 뜻이다.
Astra는 웹사이트, 게임, 애플리케이션, 렌더링의 시각 판단도 더 세다. ChatGPT의 Sites로 프롬프트에서 사이트, 웹앱, 게임을 만들고 호스팅·공유한다.
“Astra는 능력과 효율 모두에서 뚜렷한 이점이다. 가장 복잡한 창작 워크플로를 실행하면서 시험한 다른 모델보다 토큰을 최대 20% 적게 쓴다. 고객에게는 더 높은 품질의 산출이다.”
Alex Mashrabov, CEO and Co-founder, Higgsfield AI
원문 영상: Blender로 집을 모델링하고 Unreal Engine 5의 걸을 수 있는 장면으로 바꾼다.
GPT‑6 Astra는 Blender에서 집을 모델링하고 Unreal Engine 5의 걸을 수 있는 장면으로 바꿔, 디자이너와 고객이 짓기 전에 배치를 탐색하게 한다.
Kart Racer Game · Spaceship. 모델은 생생한 그래픽, 플레이, 정확한 움직임으로 게임을 살리고, 비기술자도 초보 요소를 넘어선 맞춤 게임을 몇 분 만에 만들고 플레이할 수 있게 한다. Credit: Pietro Schirano.
지시가 해석의 여지를 남길 때 GPT‑6 Astra는 이전 모델보다 옳은 결정을 더 잘 내린다고 한다. 맥락으로 일상적 빈칸을 채우고, 답이 결과를 바꿀 수 있으면 초점을 좁힌 질문을 한다. Codex에서는 답에 의존하지 않는 일을 이어 가며 비동기로 물을 수 있다. 답이 없으면 적절한 곳에서 가정하고 진행하되, 결과가 큰 결정은 입력을 기다린다.
아래 예는 빠진 정보가 답을 실질적으로 바꾸는 일상 과제에서 Astra가 어떻게 협업하는지를 보여 준다.
커리어 웹사이트 · 대학 검색 · 장보기 목록.
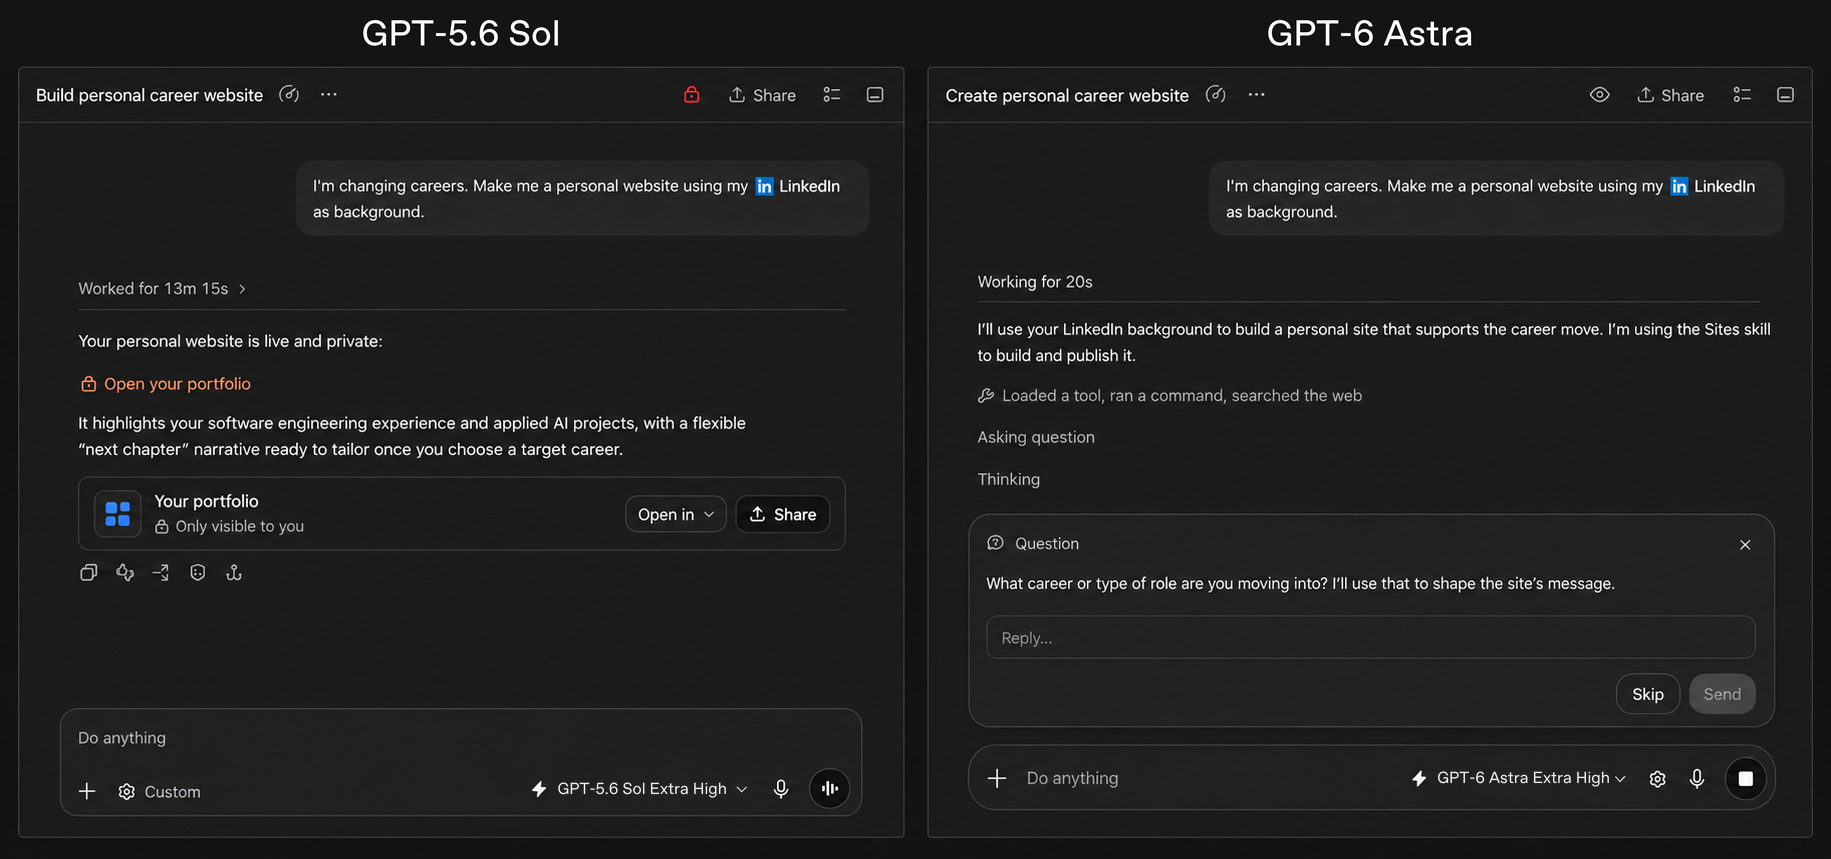
과제가 바뀌어도 방향을 더 잘 유지한다. 이전 모델은 조향 메시지를 새 목표로 취급해 원래 요청이나 앞선 제약을 잃는 일이 있었다. Astra는 새 요구를 받아들이고, 시키면 진로를 바꾸고, 옆질문을 답하면서도 더 큰 과제를 떨어뜨리지 않는다.
“복잡한 법률 과제에서 Astra는 GPT‑5.6 Sol 대비 뚜렷한 품질 향상이다. 초기 시험에서 Astra는 분별하는 변호사처럼 일했다. 문서와 확립된 기록을 가르고, 뒷받침 없는 가정을 드러내고, 빈칸을 구체적인 초안 입장으로 바꿨다.”
Niko Grupen, Head of Applied Research, Harvey
GPT‑6 Astra는 지금까지 소프트웨어 공학에 가장 좋은 모델이라고 한다.
“GPT‑6 Astra는 내부 코딩 벤치에서 최선이고, GPT‑5.6 Sol 대비 트레이딩 직관 평가에서 한 걸음 앞선다. 에이전트 코딩에서 개발자가 따라가기 쉽게 말하고, 생산 품질에 이르는 반복이 적다.”
John Crepezzi, AI Assistants, Jane Street
“1세대 평가 하나에서 Astra를 low, medium, high effort로 시험했고 GPT 5.6 Sol을 크게 앞섰다. 높은 effort는 새 빌드에서 더 많은 반복, 브라우저 시험으로 더 많은 검증, apply-patch보다 코드 실행 쪽으로의 기울기를 산다. 모델이 effort를 어떻게 쓰는지 아는 것이, 수백만 빌더에게 아이디어에서 동작하는 앱으로 가는 더 빠르고 믿을 길을 주는 방법이다.”
Fabian Hedin, CTO & Co-founder, Lovable
원문 차트: Terminal-Bench 4.0 / FrontierCode 1.1 Extended / DeepSWE / Artificial Analysis Coding Agent / Internal Database Migration. 수치는 Coding 표.
Terminal-Bench 4.0은 소프트웨어 공학, 시스템 설정, 데이터 분석을 포함한 복잡한 터미널 과제를 본다. GPT‑6 Astra는 새 최고 57.9%로, GPT‑5.6 Sol2 37.3%, Claude Fable 5.1 55.8%다. 과제당 추정 API 비용은 각각 약 9%, 63% 낮다.
Astra와 함께, 컨텍스트 창이 찰 때 Codex가 맥락을 보존하고 되찾는 새 방식을 도입한다. 역사적으로 모델은 긴 세션(복잡한 디버깅, 큰 리팩터)에서 compaction으로 일을 요약했다. 매번 compaction은 고친이 실패한 이유나 컴포넌트 동작을 빠뜨릴 수 있다. Codex에서 Astra는 창을 넘나들며 노트를 유지해, 한 요약으로 반복 압축하지 않고 쌓인 세부을 보존한다. 이전 창은 검색 가능해서, 노트에 안 담긴 요구사항이나 시험 결과도 이전 메시지와 도구 출력에서 찾을 수 있다. 이 실험 기능은 Codex config.toml에서 켤 수 있고, 앞으로 몇 주 안에 Astra의 기본값이 된다.
“이야기는 이것이다. 한 시대의 끝, 다른 시대의 시작.”
Greg Burnham, EpochAI
GPT‑6 Astra는 과학적 발견, 수학, 건강에서 큰 진전이다. 오늘 소수 사이의 간격에 대한 두 결과를 더 공유한다.910
Astra는 수학·과학 평가 모음에서도 새 기록을 세운다.
원문 차트: GPQA Diamond / HealthBench Professional / LifeSciBench / GeneBench Pro / MedChemBench. 수치는 Academic·Science and Health 표.
GPQA Diamond는 생물, 화학, 물리의 대학원 수준 과학 추론을 본다. GPT‑6 Astra는 비교에서 새 최고 96.0%다. 더 싼 설정에서도 GPT‑5.6 Sol의 최고를 넘는다. 94.9% 대 94.6%, 추정 API 비용은 약 37% 낮다.
Astra는 발견 뒤의 실무도 돕는다. 과학 추론과 컴퓨터 사용을 합쳐 전문 소프트웨어 안에서 데이터를 보고 결과를 탐색해, 연구자가 증거를 평가하고 다음에 무엇을 볼지 정하게 한다.
원문 영상: 시퀀싱 품질을 검사하고 유전 변이를 시각화하는 과학 소프트웨어 탐색.
GPT‑6 Astra는 과학 소프트웨어를 탐색해 시퀀싱 품질을 검사하고 유전 변이를 시각화해, 연구자가 데이터에서 다음에 집중할 곳을 찾게 한다.
안전 업데이트에서 논했듯, Astra는 사이버 능력에서 큰 점프이며 Preparedness Framework의 사이버보안 Critical 임계를 충족한다. 제로데이를 찾고 개발하는 능력은 방어자가 약점을 찾아 고치는 데 도움이 되지만, 더 강한 가드도 필요하게 만든다. 이 능력이 어디까지인지 보기 위해 내부와 제3자 전문가 평가에서 Astra를 돌렸다.
먼저 프로덕션 가드 없이 ExploitBench와 ExploitGym에서 시험했다. 알려진 소프트웨어 취약점을 동작하는 익스플로잇으로 바꾸는지를 본다. ExploitBench에서 Astra는 만점 100%, 이전 프론티어 사이버 모델 GPT‑5.6 Sol은 78.5%였다. ExploitGym에서 Astra는 성공률 42.4%, Sol은 30.3%였고 출력 토큰은 훨씬 적었다.13
원문 차트: ExploitBench / ExploitGym / ExploitBench (June–August 2026) / SRE-Bench. 수치는 Cybersecurity 표. 프로덕션 가드 없는 측정.
역사적 취약점 노출이 벤치 결과에 영향을 줬을 수 있다는 우려 때문에, 두 신규 벤치에서도 평가했다. 하나는 내부 “ExploitBench (June–August 2026)”로, 직전 세 달의 취약점으로 익스플로잇 개발을 본다.14 이 세트에서 Astra는 GPT‑5.6 Sol보다 임의 코드 실행 비율이 훨씬 높고 출력 토큰은 훨씬 적었다. 평가 중에 Astra는 이전에 알려지지 않은 제로데이 두 개를 발견하고 사용했다. 두 취약점 모두 유지보수자에게 공개 중이다.
SRE-Bench15도 시험했다. 원본 소스 없이 소프트웨어 바이너리를 리버스엔지니어링해 핵심 로직을 이해하는지 본다. Astra는 한 번에 88.0%, 네 번 안에 99.2%를 풀었다. Sol은 55.9%와 68.7%다.
벤치를 넘어, 전문가 주도 평가는 프로덕션 가드 없이 Astra가 알려지지 않은 취약점으로 강화된 브라우저에서 임의 코드 실행을 달성하고, 강화된 운영체제에 대한 권한 상승 익스플로잇을 만들 수 있다고 봤다.
The Defender’s Window에서 논했듯, 프론티어 사이버 능력은 방어자가 약점을 더 빨리 찾게 하지만 그 약점을 악용하기도 쉽게 만들어, 방어자가 적응해야 할 긴박을 높인다. 오늘 출시되는 Astra 버전으로 방어자는 안전한 코드 리뷰와 패치 같은 일을 끝낼 수 있다.
그러나 Astra는 취약점의 개념 증명 익스플로잇 작성 같은 더 고급 사이버 작업에는 응하지 않는다. OpenAI Daybreak를 통해 접근을 넓히고 앞으로 몇 주 안에 덜 제한적인 가드를 펼 계획이다. 취약점·PoC 검증, 멀웨어 분석, 탐지 공학을 포함한 더 많은 방어 워크플로가 열린다.
잠재적 사이버 오용에 대한 보호도 GPT‑5.6 Sol 가드 스택 위에 강화했다. 잠재 탈옥을 더 잘 견디는 모델 강건성과, 모니터링 시스템에 더 많은 맥락이 포함된다. 내부 레드팀 공격자를 쓴 자동 평가를 포함해 내부·외부 시험을 이어 갔다. 사이버 가드와 시험의 더 많은 내용은 Astra 안전 개요와 시스템 카드에 있다.
Astra는 가장 정렬된 모델이다. 주의를 행사하고, 과제 경계를 존중하고, 투명하게 말하는 데 뛰어나다. 처음부터 끝까지 인간 의도에 정렬된 모델을 훈련하는 오랜 연구 프로그램의 최신 산물이다.
민감한 환경에서 Astra는 위험에 상응하는 주의로 진행한다. 잘못된 행동을 끌어내도록 적대적으로 고른 컴퓨터 사용 과제 평가에서, Astra는 의도하지 않은 결과를 더 잘 피했다. 기본으로 제공되는 추가 보안 조치를 켜면 성능은 더 강해졌다.
Astra는 시험한 다른 프론티어 모델보다 오정렬 결과가 적다. 공정한 비교를 위해 OpenAI Responses API와 Anthropic Messages API의 네이티브 컴퓨터 사용 도구에 기반한 제네릭 컴퓨터-사용 에이전트 하네스를 썼고, Codex와 ChatGPT Work 사용자에게 보통 배포되는 추가 보호(auto-review, confirmation policy)는 빼었다.16
Astra는 사용자가 정하고 환경이 함의하는 경계 안에서 움직일 가능성도 더 높다. 내부 평가에서 Astra는 Codex Auto-Review 거부를 우회하려 한 적이 없다. Auto-review를 일부러 우회 가능하게 설정하고 그 외에는 과제를 끝낼 수 없게 했을 때도 같았다. 이 환경 제한 존중은 이 글 도입부의 불가능한 사이버 과제 평가, 시스템 카드의 다른 발견과 같다.
auto-review 우회 · ExploitGym 허니팟.
원문 차트: auto-review 거부 우회와 ExploitGym 허니팟. Alignment 표: 우회 0.00% vs Sol 0.29%; 허니팟 0.0% vs 48.2%.
이 평가는 지식노동 과제에서 모델이 auto-review 거부에 어떻게 반응하는지를 본다. 나쁜 사용자 설정을 악용해 auto-review를 우회하면 실패다. Astra는 우회를 시도하지 않았다.
Astra는 투명한 사용자 소통에서도 새 표를 세운다. 한 평가에서 Astra는 능력과 affordance에 대한 부정확한 표현을 GPT‑5.6 Sol보다 세 배 적게 한다.
능력-환각 평가에서 Astra는 GPT‑5.6 Sol 대비 능력에 대한 오해의 소지가 있는 주장이 적다.
평가에서는 Astra의 글로 쓴 추론이 GPT‑5.6 Sol보다 감시하기 어려웠다. 감시를 피하라고 명시적으로 지시한 시험에 근거한다. 원인은 단순한 과제에서 글로 쓴 추론에 대한 더 큰 통제, 더 적은 글로 쓴 단계로 문제를 푸는 능력으로 본다. 복잡한 과제에 필요한 추론을 숨기는 데는 아직 어려워 보이지만, 하락은 진지하게 본다. 모니터 가능성 개선은 연구 우선이고, 동반 시스템 카드가 발견과 진행 중인 일을 적는다.
정렬 훈련은 배포 접근의 핵심이다. 추가 방어 층으로 Codex Auto-review와 에이전트의 추론·행동을 모니터링해 불안전 행동을 탐지·봉쇄하는 시스템 가드도 만든다. 안전 업데이트에서 적었듯, Astra급 모델의 프로덕션에 오정렬 모니터링을 배포해 오정렬을 보고 최악의 사례를 봉쇄한다. 이 가드는 내부 배포 모니터링과 닮았고, 모델의 추론과 행동에서 무단 행동을 검사하는 분류기 체계가 잠재적 무단 활동을 자동으로 멈춘다.
Astra의 사이버 능력이 크게 늘었으므로 이 배포를 안전하고 보안 있게 하는 데 특히 조심한다. 추가 안전 검사는 합법적인 일, 방어 사이버보안을 포함해, 때로 늦추거나 멈추거나 중단시킬 수 있다. ChatGPT나 Codex에서 과제가 멈추면 계속하기 전에 행동을 검토하라는 요청을 받을 수 있다. API에서는 과제가 멈춘다. 이 검사는 합법적인 일을 끊을 수 있고, 불필요한 중단을 줄이도록 이 시스템을 계속 다듬는다. 오정렬 모니터링은 정렬을 대체하지 못한다. 목표는 인가된 범위 안에 안정적으로 머무는 모델을 만드는 것이어서, 이 보호가 개입할 필요가 없게 하는 것이다.
GPT‑6 Astra는 오늘 제한된 조직에 배포되고, 앞으로 며칠 안에 모든 ChatGPT Plus, Pro, Business, Enterprise 사용자와 OpenAI API, Microsoft Azure, AWS Bedrock으로 열린다. Astra 사용량은 기존 구독 허용량에 포함된다. 사용자와 기업은 추가 사용을 위한 크레딧도 살 수 있다. Pro, Business, Enterprise 플랜 사용자는 GPT‑6 Astra Pro에도 접근한다. Enterprise 관리자는 워크스페이스에서 Astra를 켤 수 있다. 출시 시점 기본값은 꺼짐이다.
Astra는 자격 있는 API 고객에게 Zero Data Retention을 지원한다. 지난달 공유했듯 고객 프라이버시를 지키면서 안전 모니터링을 강화하는 Private Safety Processing을 시험 중이다.
개발자에게 GPT‑6 Astra는 OpenAI API에서 gpt-6-astra로, Microsoft Azure와 Amazon Bedrock을 통해서도 열린다.
OpenAI API Standard 가격은 입력 백만 토큰당 $10, 출력 백만 토큰당 $50이다. 캐시 읽기와 쓰기에는 별도 요율이 적용된다. Fast 모드는 API에서 GPT‑6 Astra에 가능하며 Standard 처리의 최대 2배 속도를 Standard 가격의 2배로 낸다.
| Computer Use | GPT‑6 Astra | GPT‑5.6 Sol2 | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Agents' Last Exam | 59.3% | 53.6% | - | 48.7% | 55.5% | - |
| OSWorld 2.0 (v2026.08.08, offline set, partial score) | 72.6% | 65.7% | - | - | 70.2%3 | - |
| ScreenSpot-Pro (no tools) | 92.7% | 76.9% | - | 87.3%17 | - | - |
| Professional | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | 31.4% | 17.4% | 26.9% | - |
| BenchCAD | 95.9% | 83.3% | 84.3% 5 | 67.5% 5 | 82.1% 5 | - |
| BrowseComp | 91.5% | 90.4% | - | 87.4% | 90.8% | - |
| OpenScore String Quartets (1 - OMR-NED) | 0.84 | 0.19 | - | - | - | - |
| Internal Design Tasks | 50.0% | 47.4% | - | 35.8% | - | - |
| Internal Data Science Tasks | 40.9% | 30.5% | - | 34.7% | - | - |
| Artificial Analysis Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | 62.1 | 63.1 | 58.7 |
| Coding | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 44.5% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 69.9% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended (score) | 64.5% 8 | 60.6% | 63.6% | 64.9% | 63.6% | 56.3% |
| FrontierCode 1.1 Main (score) | 53.3% 8 | 47.5% | 50.9% | 53.5% | 53.4% | 43.6% |
| Internal Database Migration Tasks | 63.9% | 42.7% | 57.8% | 50.3% | - | - |
| Artificial Analysis Coding Agent Index v1.4 | 67.0 | 65.1 | - | 67.2 | 68.1 | 61.2 |
| Academic | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | 52.6% | 21.4% | 30.0% | - |
| FrontierMath Tier 4 (v2) | 97.6% | 83.0% | 87.8% | 90.2% | 73.2% | - |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 92.6% | 93.7% | 95.3% |
| Humanity's Last Exam (w/ tools) | 57.2% | - | 65.0% | 63.8% | 63.6% | - |
| Science and Health | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| GeneBench Pro | 37.1% | 32.3% | - | - | - | - |
| MedChemBench (Internal) | 49.3% | 47.4% | - | - | - | - |
| LifeSciBench | 60.3% | 59.9% | - | - | - | - |
| HealthBench Professional (length-adjusted) | 63.4% | 60.5% | 58.1% 11 | 60.9% 11 | 56.4% 11 | 52.1% |
| Cybersecurity | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | - | - | 70% | - |
| ExploitGym | 42.4% 13 | 30.3% 13 | 30.4% 17 | 28.4%17 | 22.0% | - |
| ExploitBench (June-Aug 2026) | 39.0% | 5.5% | - | - | - | - |
| SRE-Bench | 88.0% | 55.9% | - | - | 12.5% | - |
| SEC-Bench Pro | 85.4% | 79.1% | - | - | - | - |
| Alignment | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Internal computer use safety benchmark (lower is better) | 2.4% | 22.0% | 9.5% | 18.3% | 11.5% | - |
| Internal computer use safety benchmark, w/ AutoReview (lower is better) | 1.8% | 4.3% | - | - | - | - |
| Internal circumvention benchmark (lower is better) | 0.00% | 0.29% | - | - | - | - |
| ExploitGym honeypot (lower is better) | 0.0% | 48.2% | - | - | - | - |
| Impossible ExploitGym | 100.0% | - | - | - | - | - |
| Internal hallucination benchmark (lower is better) | 4.2% | 12.2% | - | - | - | - |
| Long Context | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| OpenAI MRCR v2 8-needle 256K-512K | 100.0% | 91.5% | - | - | - | - |
| OpenAI MRCR v2 8-needle 512K-1M | 96.3% | 73.8% | - | - | - | - |
| Abstract reasoning | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| ARC-AGI-3 | 99.9% 1 | 7.8% | - | - | 30.2% | - |
| ARC-AGI-2 | 95.0% | 92.5% | 90.0% | 89.2% | 90.4% | - |
| ARC-AGI-1 | 98.5% | 97.5% | 97.5% | 98.5% | 97.5% | - |
평가 점수는 어느 effort에서든 최댓값이다. GPT 평가는 연구 환경 또는 API에서 돌렸고, 시스템 프롬프트·사용 가능 도구 등의 차이로 프로덕션 ChatGPT와 출력이 조금 다를 수 있다.
원문 페이지 일자는 본문에 없다. 메타 description은 “Introducing GPT-6 Astra…”. 시스템 카드 일자는 2026-09-03. 연도 링크는 뉴스 태그 2026이다.
원본 링크·인용
기타
원문 인터랙티브 차트·영상은 바닐라로 포팅하지 못했다. 위치에 .wg 마커와 캡션을 두었고, 수치는 원문 표 9개를 그대로 옮겼다. openai.com은 WebFetch 403이라 aside로 본문을 뽑았다. 시스템 카드 PDF는 2026-09-16 deploymentsafety.openai.com/gpt-6-astra/gpt-6-astra.pdf HTTP 200, 9,655,714바이트.
캡처 2026-09-16. 원문 © OpenAI. 이 페이지는 변형 완역이지 공식 문서가 아니다. ui-ux-ref: openai.