bebu(@bebuu_ai)가 2026-11-05 03:48 KST(2026-11-04 18:48 UTC) X에 올린 게시물이다. 탕제(唐杰)의 칭화대 강의 사진을 곧 나올 GLM-5.5(32B·122B·256B)의 학습 파이프라인 공개로 소개했다. 사진 속 데이터 출처 6행은 슬라이드 표와 맞는다. GLM-5.5 연결과 세 크기는 강의 밖에서 붙은 소문이고, 게시자는 2026-11-06 사과했다.
bebu(@bebuu_ai)가 2026-11-04 18:48 UTC(한국 시각 2026-11-05 03:48)에 올린 X 게시물 가운데, 탕제(唐杰, Jie Tang)의 칭화대 강의 슬라이드에 실제로 있는 내용은 어디까지인가?
게시물의 여섯 데이터 출처와 숫자는 강의 슬라이드 표에 그대로 있다. ‘곧 나올 GLM-5.5’와 ‘32B·122B·256B’는 슬라이드 두 장 어디에도 없다. X 소개란에 Z.ai 연구원이자 GLM 핵심 기여자로 적힌 Cunxiang Wang은 2026-11-06 05:41 UTC 답글에서 세 크기를 강의와 무관한 가짜 소식이라고 썼다. 원 게시자 bebu는 9분 뒤 같은 대화에서 소문을 퍼뜨린 일을 사과했다. 자기가 사진에 찍혔다고 항의한 @hongkunwz는 답글에서 슬라이드를 그 주 수요일(2026-11-04) 강의의 ‘이전 모델의 데이터 배합’이라고 했다. ‘GLM-5.5’라는 이름을 강의에 잇는 것은 게시물 첫 문장과 출처가 적히지 않은 이미지 2뿐이다.
멘탈 모델
강의 사진 속 데이터 표에, 강의 전부터 돌던 모델 크기 소문을 이어 붙인 게시물이다.
강의 표제 슬라이드의 손실 식은 파라미터 수 N과 학습 토큰 수 D 가운데 D의 항에 상자를 쳤다. 32B·122B·256B는 N 쪽 숫자다.
선행 개념
Z.ai와 GLM — Z.ai는 중국 회사 Zhipu AI(智谱)의 영문 브랜드다. GLM은 이 회사의 대형 언어 모델 계열이다. 2026-11-07 기준 Z.ai 챗봇 페이지의 제목은 ‘powered by GLM-5.3-Flash’로 끝난다. IAMag 2026-11-05 기사는 출시된 최상위 모델을 GLM-5.3으로 적는다. 같은 기사는 Z.ai가 GLM-5.5의 크기와 날짜를 확인하지 않았다고 쓴다.
탕제 — 원문은 탕제를 Z.ai 수석 과학자로 소개한다. 강의 표제 슬라이드에 적힌 그의 소속은 칭화대 컴퓨터과학기술학과다.
32B·122B·256B — 32B는 파라미터 320억(32 billion) 개를 뜻한다. 파라미터는 학습으로 값이 정해지는 모델 가중치다. 가중치를 16비트(2바이트)로 저장하면 32B 모델은 가중치만 약 64 GB다. 인용 게시물 여럿은 32B를 개인 장비에서 돌릴 모델로 읽었다.
세 크기의 출처는 2026-10-31 Lumina(@LuminaBench)가 올린 캡처다. 캡처한 변경 내역 한 줄에 ‘기본 모델에 합칠 내부 32B / 122B / 256B 모델’이 적혀 있었다. 이 줄을 Z.ai 인턴의 학술 홈페이지 항목으로 지목한 것은 2026-11-01 Mark Kretschmann(@mark_k)이다. 원본 페이지는 확인되지 않았다. Lumina는 같은 날 별도의 세 모델은 나오지 않는다고 정정했다. kie.ai는 2026-11-01 분석에서 이 내용을 다시 옮겼다. 이미지 2는 강의 이틀 전인 2026-11-02 @xiax0603의 소문 게시물에 먼저 실렸다.
사전학습 데이터와 손실 식 — 사전학습(pretraining)은 모델이 대량의 글로 다음 토큰 맞히기를 배우는 첫 학습 단계다. 슬라이드 표는 그 글을 모으는 출처 여섯 개마다 규모와 처리 공정을 한 줄씩 적는다. 강의 표제 슬라이드의 식 L(N,D) = L∞ + A/Nα + B/Dβ는 손실 L을 파라미터 수 N과 학습 토큰 수 D로 쓴다. Hoffmann 외(DeepMind)가 2022-03 논문 「Training Compute-Optimal Large Language Models」에서 맞춘 식과 같은 꼴이다. N이나 D가 커지면 해당 항이 작아져 손실이 줄어든다.
X 커뮤니티 노트 — 사용자가 게시물에 붙이자고 제안하는 맥락 설명이다. X 커뮤니티 노트 안내서에 따르면 관점이 다른 평가자 여럿이 도움이 된다고 평가한 노트만 게시물에 표시된다. 이 게시물에 제안된 노트 2건은 2026-11-07 기준 둘 다 ‘더 많은 평가가 필요함’ 상태라 게시물 아래에 보이지 않는다. 한 건은 X가 ‘실험용 AI 참여자’로 표시한 작성자의 노트다. 이 노트는 강의 슬라이드가 GLM-5.5나 세 크기를 발표하지 않았다고 적는다. 다른 한 건(2026-11-06)은 게시물의 이미지가 AI로 생성됐다고 주장하지만 근거로 SynthID 판별 페이지 주소 하나만 단다.
권장 읽기 순서
원본 (완역)에서 이미지 1 위쪽 사진(데이터 출처 표 슬라이드)과 본문의 여섯 줄을 나란히 놓는다. 숫자는 모두 표에 있다. 다른 곳은 게시물이 덧붙인 단위와 수식어다. 이 사진을 강의 사진의 가장 이른 사본(@NFT_Chen, 2026-11-04 15:09 UTC)과 견주면 바닥글과 맨 아랫줄 글자가 다르다. 표 여섯 행은 두 사본이 같다. 두 사본의 글자 차이는 팩트체크에 표로 있다.
같은 블록에서 이미지 1 아래쪽 사진과 이미지 2를 비교한다. 아래쪽 사진은 강의 표제 슬라이드다. ‘GLM-5.5 (32B/122B/256B)’라는 글자는 이미지 2에만 있다. 이미지 2는 z.ai 로고와 픽셀 말을 얹은 정사각형 그림이다. 강의 장면은 없다.
같은 블록의 답글 세 개를 시간 순서로 읽는다. Cunxiang Wang(2026-11-06 05:41 UTC), bebu(05:51 UTC), @hongkunwz(15:50 UTC) 순이다.
강의 표제 슬라이드가 상자로 강조한 변수와 32B·122B·256B가 가리키는 변수는 각각 무엇인가?
Cunxiang Wang의 답글과 @hongkunwz의 답글은 각각 게시물의 어느 부분을 바로잡나?
Executive Summary
GLM-5.5와 32B·122B·256B 세 크기는 강의 슬라이드에 없다
첨부 사진 속 탕제(唐杰, Jie Tang)의 칭화대 강의 슬라이드가 뒷받침하는 부분은 게시물의 GLM 여섯 데이터 출처 목록뿐이다. 게시물은 이 목록을 “곧 나올 GLM-5.5(32B, 122B, 256B)”의 학습 파이프라인이라고 소개했다. 그 버전 이름과 세 크기는 슬라이드에 없다. 알려진 가장 이른 강의 사진 게시물은 이 표를 이전 GLM 모델의 데이터 배합이라고 소개했다. 게시물에 붙은 강의 사진은 그 사본과 슬라이드 글자 일부가 다른 판본이다.
원문은 bebu(@bebuu_ai)가 한국 시간(KST) 2026-11-05 03:48, 협정 세계시(UTC) 2026-11-04 18:48에 X에 올린 영어 게시물이다. 2026-11-07 기준 이 계정의 팔로워는 1,010명이다. 같은 날 게시물 조회수는 45.8만, 좋아요는 5.1천, 재게시는 493이다.
왕춘샹(Cunxiang Wang)은 자기소개란에 Z.ai 연구원이자 GLM 핵심 기여자라고 적은 사람이다. 그는 게시 약 35시간 뒤인 2026-11-06 05:41 UTC(14:41 KST)에 답글로 세 크기를 “가짜 소식”이라고 반박했다. 같은 답글은 세 크기가 탕제의 강의와 아무 관계가 없다고 적는다. bebu는 9분 뒤 사과 답글을 달았다. 2026-11-07 기준 게시물은 지워지지 않았다.
신뢰도 D — 데이터 출처 6행은 강의 슬라이드와 맞는다. 제목의 GLM-5.5 연결과 모델 크기 세 개는 강의 밖에서 붙은 소문이다. 판정 18건은 팩트체크 블록에 있다.
게시물은 앞서 묶인 강의 사진과 크기 소문을 한 문장으로 옮겼다
게시물 본문은 출처가 다른 두 부분으로 나뉜다. 두 부분은 첫 문장의 “the training pipeline behind the upcoming GLM-5.5” 한 구절에서 만난다.
슬라이드에서 온 부분
둘째 문장의 여섯 출처와 글머리표 6개다. 순서와 수치가 데이터 출처 표 슬라이드의 웹·문서·책·코드·동영상·오디오 행과 같다.
슬라이드 밖에서 온 부분
첫 문장의 “GLM-5.5”와 “32B, 122B, and 256B”다. 세 크기는 강의 나흘 전 Z.ai 인턴의 학술 홈페이지 항목으로 알려진 캡처에서 퍼졌다. 캡처 문구는 세 크기를 GLM-5.5 기본 모델에 합칠 내부(internal) 모델로 적는다. 캡처에 출시를 뜻하는 문구는 없다.
왕춘샹의 답글이 이 이음매를 짚는다. 그는 세 크기가 “1인 미디어가 믿을 수 없는 출처에서 앞뒤를 잘라 잘못 전하고 또 전해 퍼진” 말이라고 썼다. 같은 답글은 “전에도 이걸 엉터리로 퍼뜨린 일이 있었는데, 이제 또 탕 교수님 수업에 이어 붙였다”고 적는다.
두 번째 첨부 이미지는 슬라이드가 아니다. 검은 배경에 Z 로고와 “z.ai”, “GLM-5.5 (32B/122B/256B)” 글자, 앞발을 든 말을 픽셀 점으로 그린 그림을 얹은 정사각형 그래픽이다. 이 그래픽은 강의 이틀 전 크기 소문 게시물에 먼저 실렸다. 제작자는 확인되지 않았다.
bebu보다 3시간 11분 앞서 @xiax0603이 강의 사진과 이 그래픽을 한 게시물에 짝지어 올렸다. 게시물의 두 이미지는 이 짝과 같다. 사진 1은 그 판본을 줄인 사본이다.
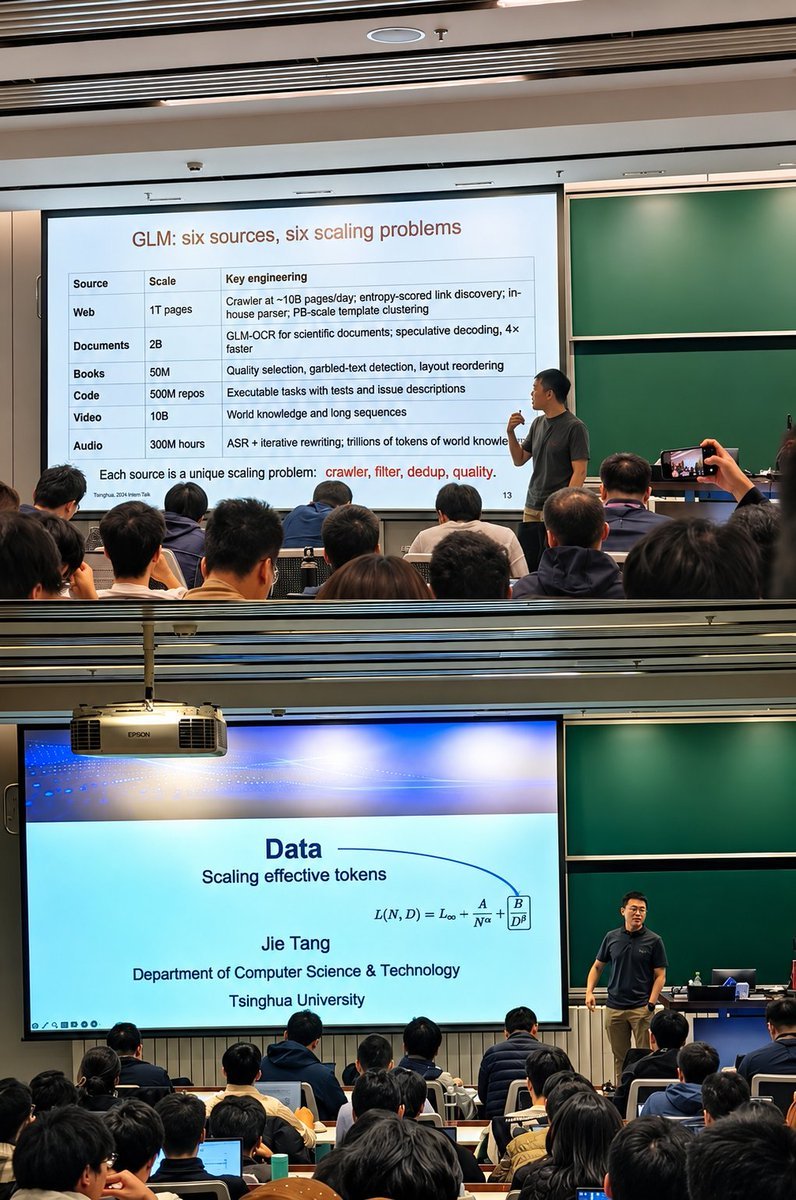
게시물 첨부 이미지 1(bebu, X, 2026-11-04 18:48 UTC). 위 사진은 데이터 출처 표 슬라이드다. 아래 사진은 강의 제목 슬라이드다. 두 슬라이드 어디에도 GLM-5.5나 모델 크기가 없다. 이 사본의 꼬리말은 “Tsinghua, 20?4 Intern Talk”이다. 가장 이른 사본(@NFT_Chen, 2026-11-04 15:09 UTC)의 같은 자리에는 “…a team, 2026 (internal)”이 있다. 쪽 번호 “13”은 이 사본에만 있다. 표 아래 줄 글자도 두 사본이 다르다. 사진을 줄이거나 자르는 편집으로는 글자가 바뀌지 않는다. 데이터 표 6행은 두 사본이 같다. AI 생성 여부는 확인되지 않았다.
주장 17개 가운데 슬라이드 문구와 같은 것은 6개다
게시물 본문을 주장 단위로 나누면 17개다. 슬라이드 문구와 같은 것이 6개, 슬라이드 항목에 단위·수식어를 더한 것이 6개, 슬라이드에 없는 것이 5개다. 슬라이드에 없는 5개는 모두 첫 두 문장에 몰려 있다. 글머리표 목록에 나온 수치는 전부 슬라이드에 있다.
게시물 주장 17개와 첨부 사진 속 슬라이드(데이터 출처 표 슬라이드, 제목 슬라이드)의 대조. 번호는 게시물 안 등장 순서다. ‘슬라이드에 있나’ 칸의 값은 셋이다. 있다 = 같은 수치·같은 뜻의 문구가 슬라이드에 있다. 낱말만 바꿔 쓴 경우도 여기에 든다. 더했다 = 대응 항목은 있으나 게시물이 단위·수식어를 붙이거나 범위를 넓혔다. 없다 = 대응 문구가 슬라이드 어디에도 없다. 주장의 참·거짓은 팩트체크에서 판정한다.
슬라이드: “1T pages”, “Crawler at ~10B pages/day”, “PB-scale template clustering”. 같은 칸의 “entropy-scored link discovery”와 “in-house parser”는 빠졌다.
10. 문서 규모: 과학 PDF 20억 개 “2 billion scientific PDFs”
더했다
규모 칸은 단위 없는 “2B”다. ‘PDF’ 형식과 개수 단위는 게시물이 붙였다. ‘과학’ 한정은 처리 칸의 “scientific documents”에서 가져왔다.
11. 문서 처리: GLM-OCR로 파싱, 추측 디코딩(speculative decoding)으로 4배 빠름
있다
슬라이드: “GLM-OCR for scientific documents”, “speculative decoding, 4× faster”.
12. 책 규모: 5천만 권 “50 million books”
더했다
규모 칸은 단위 없는 “50M”이다. ‘권’은 행 이름 Books에서 읽은 단위다.
13. 책 처리: 레이아웃 재정렬, 깨진 글자 필터링
있다
슬라이드는 “garbled-text detection, layout reordering”이다. 슬라이드 낱말은 필터링(filtering)이 아니라 탐지(detection)다. 맨 앞의 “Quality selection”은 빠졌다.
14. 코드: 저장소 5억 개를 실제 테스트와 이슈 설명이 붙은 실행 가능한 과제로 바꿨다.
더했다
슬라이드: “500M repos”, “Executable tasks with tests and issue descriptions”. ‘실제(real)’는 게시물이 붙였다.
15. 동영상 규모: 100억 개 “10 billion videos”
더했다
규모 칸은 단위 없는 “10B”다. ‘개’는 행 이름 Video에서 읽은 단위다.
16. 동영상 용도: 긴 시퀀스 세계 지식 “for long-sequence world knowledge”
있다
슬라이드는 “World knowledge and long sequences”로 두 항목을 나란히 적는다. 게시물은 둘을 한 구로 합쳤다.
17. 오디오: 3억 시간을 음성 인식(Automatic Speech Recognition, ASR)으로 다시 써 수조 토큰으로 만들었다.
있다
슬라이드: “300M hours”, “ASR + iterative rewriting”, “trillions of tokens of world knowledge”. ‘반복(iterative)’과 ‘세계 지식(world knowledge)’은 빠졌다.
게시물은 슬라이드의 데이터 공정 문제를 ‘내부 엔진’ 이야기로 바꿨다
주장 7·8은 여섯 출처를 공개 데이터셋과 대비되는 ‘별도 내부 엔진’으로 묶는다. 데이터 출처 표 슬라이드에는 이 대비가 없다. 슬라이드 제목 “GLM: six sources, six scaling problems”는 여섯 출처를 저마다의 확장 문제로 묶는다. 표 아래 줄은 가장 이른 사본에서 청중 머리에 가려 “Each source is it… scaling problem: cr… …arse, filter, dedu…”까지만 보인다. 게시물 사본의 같은 자리에는 가림 없는 “Each source is a unique scaling problem: crawler, filter, dedup, quality.”가 있다. 게시물 본문은 어느 쪽 문장도 옮기지 않았다.
아래 사진의 제목 슬라이드는 강의 주제를 “Data — Scaling effective tokens”로 적는다. 그 아래 수식은 L(N, D) = L∞ + A/Nα + B/Dβ이다. “Data” 글자에서 나온 곡선이 상자 친 B/Dβ 항으로 이어진다. 슬라이드 구성은 이 항을 강의 주제로 가리킨다. 게시물은 이 슬라이드를 본문에서 다루지 않는다.
@hongkunwz는 2026-11-06 답글에서 이 자료를 “교수님이 대형 모델 데이터 구성을 강의한 PPT”라고 썼다. 그는 “다른 건 없다”고 했다. 표 내용은 “이전 모델의 데이터 배합”이라고 덧붙였다. 그는 자기소개란에 칭화대 자동화과 석사라고 적었다. 이 말은 가장 이른 강의 사진 게시물의 소개와 맞는다.
세 크기는 정정 뒤에도 퍼졌다
Lumina의 정정은 소문을 멈추지 못했다. 정정 이틀 뒤 소문 게시물과 GLM-5.5 그래픽이 세 크기를 다시 옮겼다. 반박이 나오기 전에는 인용 게시물들이 세 크기를 전제로 글을 썼다.
세 크기와 강의 사진이 퍼진 경과. 시각은 협정 세계시(UTC)와 한국 시간(KST, UTC+9)을 함께 적는다. 시각이 알려지지 않은 항목은 날짜만 적는다.
워터마크가 없고 슬라이드 글자 일부가 다른 강의 사진 판본을 GLM-5.5 그래픽과 함께 올렸다.
2026-11-04 18:48 UTC 2026-11-05 03:48 KST
bebu
게시물을 올렸다.
2026-11-05 15:26–17:20 UTC 2026-11-06 00:26–02:20 KST
인용 게시물
ThePrimeagen은 데이터 수집 규모를 두고 중국이 “인터넷을 진짜로 훔쳤다”는 농담을 달았다. Benjamin Marie(“Smaller GLM models are coming!”), 1337hero(“32B coming for GLM-5.5”), Teortaxes, Loktar는 세 크기를 전제로 글을 썼다.
2026-11-06 05:41 UTC 2026-11-06 14:41 KST
왕춘샹
세 크기를 가짜 소식이라고 반박했다.
2026-11-06 05:51 UTC 2026-11-06 14:51 KST
bebu
“가짜 뉴스인 줄 정말 몰랐다”고 썼다. 루머를 퍼뜨린 데 깊이 사과한다고 했다. 앞으로 회사나 모델 소식을 공유하기 전에 검증하겠다고 약속했다.
2026-11-06(KST) 시각 미상
커뮤니티 노트 제안 1
“이 게시물의 이미지는 AI로 생성됐다”는 문장을 올렸다. 근거로 SynthID 홈페이지 주소를 달았다.
2026-11-06 15:50 UTC 2026-11-07 00:50 KST
@hongkunwz
“예의가 있느냐. 나를 사진에 넣지 않는 게 좋겠다”로 시작하는 답글에서 강의 PPT를 맥락에서 잘라 왔다고 항의했다.
2026-11-06(UTC) 2026-11-07 새벽(KST)
커뮤니티 노트 제안 2
X의 실험용 AI 노트 작성자가 썼다. 탕제의 강의 슬라이드가 GLM-5.5나 세 크기를 발표하지 않았다는 내용이다. 근거로 IAMag 기사와 왕춘샹의 답글을 달았다.
2026-11-07
게시물 상태
노트 두 건은 모두 ‘더 많은 평가 필요’ 상태로 X에 표시되지 않았다(노트 페이지). 사과 답글 아래에는 게시물 삭제를 요구하는 답글이 달렸다.
데이터 출처 6행은 강의 슬라이드와 맞는다. 제목의 GLM-5.5 연결과 모델 크기 세 개는 강의 밖에서 붙은 소문이다.
판정 기호와 건수
✅ 사실
🟡 부분사실
⚠️ 불확실
❌ 거짓
1차 출처(슬라이드·공식 문서·당사자 발언)와 일치한다
핵심은 맞다. 단위·범위·수치 일부가 1차 출처와 다르다
접근 가능한 출처로 참·거짓을 정할 수 없다
1차 출처나 당사자 발언과 어긋난다
6건
6건
3건
3건
등급: A 1차 출처와 일치, 차이는 표기 수준 · B 세부 오류 일부 · C 핵심 주장 일부 오류 · D 핵심 주장 다수 오류 · F 핵심 주장이 거짓.
제목 문장: 화자·장소·대상 모델
✅
탕제는 Z.ai의 최고 과학자(chief scientist)다.
탕제는 칭화대(清华大学) 컴퓨터과학기술학과 교수다. 콰이커지(快科技)의 2026-09-18 기사는 그의 현직을 '칭화대 컴퓨터학과 교수 겸 즈푸(智谱) AI 최고 과학자'로 적는다. 즈푸는 2025년 7월 해외 브랜드를 Z.ai로 바꿨다. 탕제는 2019년 칭화대 분사 기업으로 이 회사를 세웠다.
강의는 칭화대에서 '오늘(today)' 열렸다. 게시 시각은 2026-11-04 18:48 UTC다.
강의 사진의 가장 이른 사본은 2026-11-04 15:09 UTC(베이징 23:09) @NFT_Chen 게시물에 있다. 이 게시물은 사진을 '오늘 밤 칭화대 강의(今晚清华授课)'로 소개한다. 칭화대 자동화과 석사라고 밝힌 @hongkunwz는 2026-11-06 같은 자료를 '이번 주 수요일(这周三)' 강의 PPT라 불렀다. 2026-11-04는 수요일이다. 원문의 'today'는 UTC 날짜로 맞다. 베이징 시각으로는 게시 전날 밤이다.
강의 자료에서 나온 것은 'Data — Scaling effective tokens' 강의의 사전학습 데이터 출처 표 한 장이다. @hongkunwz는 이 자료를 '대형 모델 데이터 구성(大模型数据的构成)' PPT라 불렀다. 그는 '다른 것은 없다(并没有其他的东西)'고 덧붙였다. 원문 '훈련 파이프라인' → 확인 '사전학습 데이터 출처 6종과 출처별 처리 과제'. 데이터 표 슬라이드 사진의 발표자는 제목 슬라이드 사진의 발표자와 옷차림이 다르다. 데이터 표 슬라이드를 누가 설명했는지는 사진으로 정할 수 없다.
슬라이드 제목은 버전 없이 'GLM:'으로 시작한다. 데이터 표와 제목 슬라이드 어디에도 GLM-5.5가 없다. 원문 'GLM-5.5의 파이프라인' → 확인 '이전 GLM 모델의 데이터 배합'. @NFT_Chen은 '이전 GLM 모델의 데이터 배합(以往GLM模型的数据配方)', @hongkunwz는 '이전 모델의 데이터 배합(之前模型的数据配方)'으로 적었다.
2026-11-07 현재 Z.ai 개발자 문서의 출시 기록은 2026-08-26 GLM-5.3-Flash에서 끝난다. Hugging Face zai-org와 공식 X 계정(@Zai_org)에도 GLM-5.5 항목이 없다. 2026-10-31 Lumina(@LuminaBench)가 올린 변경 내역 캡처에는 'Next-generation GLM base model (GLM-5.5)'이 적혀 있다. 이 캡처를 Z.ai 인턴의 학술 홈페이지 항목으로 지목한 것은 2026-11-01 Mark Kretschmann(@mark_k)이다. 원본 페이지는 확인되지 않았다. 탕제는 2026-10 초 싱가포르 강연에서 다음 세대 모델의 데이터·규모 확대를 예고했다. 콰이커지의 2026-10-08 기사는 그 모델 이름을 'GLM-5.4 또는 GLM-5.5'로 추측했다. 다음 모델의 이름과 출시 시점을 밝힌 공식 자료는 없다.
GLM 핵심 기여자라고 소개하는 Z.ai 연구원 왕춘샹(Cunxiang Wang)은 2026-11-06 답글에서 세 크기를 '가짜 소식(假消息)'이라 불렀다. 그는 이 숫자가 '탕 교수의 강의와 전혀 관계없다(和唐老师的lecture毫无关系)'고 적었다. 숫자의 출처인 2026-10-31 Lumina 캡처의 문구는 'post-trained internal 32B / 122B / 256B models, merging into the base model'이다. Lumina는 같은 날 '별도 32B / 122B / 256B GLM 5.5 모델은 나오지 않는다'고 정정했다. kie.ai의 2026-11-01 분석도 세 크기를 기본 모델에 합칠 내부 체크포인트로 적었다. 게시자 bebu는 2026-11-06 '소문을 퍼뜨린 데 깊이 사과한다'고 답했다.
원문 '여섯 개의 별도 내부 엔진' → 슬라이드 '여섯 출처, 여섯 스케일링 문제(six sources, six scaling problems)'. 슬라이드는 웹·문서·책·코드·영상·오디오를 데이터 출처로 나눈다. 출처마다 규모와 공학 과제를 한 칸씩 적는다. '엔진'과 '내부'는 게시물이 붙인 말이다.
슬라이드 웹 행과 같다. 규모는 '1T pages'다. 공학 칸에 'Crawler at ~10B pages/day'와 'PB-scale template clustering'이 있다. 게시물은 같은 칸의 '엔트로피 점수 기반 링크 발견(entropy-scored link discovery)'과 '자체 파서'를 뺐다.
GLM-OCR은 Z.ai가 2026-01-30 Hugging Face에 공개한 0.9B 매개변수 문서 인식(OCR) 모델이다. 공식 저장소는 vLLM·SGLang용 다중 토큰 예측(Multi-Token Prediction, MTP) 추측 디코딩 설정을 싣는다. 슬라이드에도 'speculative decoding, 4× faster'가 있다. 2026-03-12 공개된 기술 보고서의 수치는 다르다. 원문·슬라이드 '4배 빠름' → 보고서 '디코딩 단계당 평균 5.2토큰, 처리량 약 50% 향상'. 슬라이드의 4배가 무엇과 비교한 값인지는 슬라이드에 없다.
게시물의 사진은 2026-11-04 15:37 UTC @xiax0603 판본을 줄인 사본이다. 이 판본은 28분 먼저 올라온 @NFT_Chen 사본과 데이터 표 슬라이드의 글자가 다르다. 사진을 줄이거나 자르는 편집으로는 글자가 바뀌지 않는다. 강의 장면과 데이터 표는 두 판본이 같다.
같은 강의 사진의 두 판본 — 데이터 표 슬라이드 글자
항목
가장 이른 사본 (@NFT_Chen, 2026-11-04 15:09 UTC, 1360×2048)
같은 그림이 강의 이틀 전인 2026-11-02 13:23 UTC @xiax0603 게시물에 먼저 실렸다. 그 게시물은 'GLM-5.5 32B/122B/256B 흔적이 사라져 출시가 늦어진다'는 소문을 다룬다. 두 파일은 픽셀 단위로 거의 같다(평균 차이 255단계 중 0.5). 원문 'Z.ai 이미지' → 확인 '소문 계정이 먼저 쓴 그림, 제작자 미상'.
SynthID는 Google DeepMind가 AI 생성물에 넣는 보이지 않는 워터마크다. 노트는 synthid.com 링크만 달았다. 검출 결과 화면은 붙이지 않았다. X가 내려주는 두 이미지 파일에는 생성 도구를 알려 줄 메타데이터가 없다. AI 생성 여부를 가를 공개 근거는 없다. 노트 2건은 2026-11-07 기준 '평가 필요' 상태라서 게시물에 표시되지 않는다.
Z.ai 수석 과학자 탕제(唐杰)가 오늘 칭화대학(淸華大學) 강의에서 출시를 앞둔 GLM-5.5(32B, 122B, 256B)의 학습 파이프라인을 방금 공개했다.
공개 데이터셋에 기대는 대신, 이들의 사전학습 파이프라인은 서로 별개인 내부 엔진 여섯 개에서 데이터를 끌어온다.
웹: 하루 약 100억 페이지 속도로 크롤링한 1조 페이지, PB 규모 템플릿 클러스터링 적용
문서: GLM-OCR로 파싱한 과학 PDF 20억 건(추측 디코딩으로 4배 빠름)
도서: 레이아웃 재정렬과 깨진 텍스트 필터링을 거친 책 5천만 권
코드: 실제 테스트와 이슈 설명이 붙은 실행 가능한 과제로 바꾼 저장소 5억 개
영상: 긴 시퀀스에 걸친 세계 지식을 위한 영상 100억 개
오디오: 음성 인식(ASR)을 거쳐 수조 개의 토큰으로 다시 쓴 3억 시간 분량
이미지 1. 강의실 사진 두 장을 위아래로 이어 붙였다.
위 사진: 흰 화면의 슬라이드 앞에서 회색 티셔츠 차림의 발표자가 표를 가리키고, 앞줄에 청중이 앉아 있다. 오른쪽에는 휴대전화를 들어 화면을 찍는 손이 보인다. 슬라이드 제목은 ‘GLM: six sources, six scaling problems’(GLM: 여섯 가지 출처, 여섯 가지 스케일링 문제)이고, 표의 내용은 다음과 같다.
출처
규모
핵심 엔지니어링
웹(Web)
1T(1조) 페이지
하루 약 10B(100억) 페이지를 수집하는 크롤러; 엔트로피 점수 기반 링크 발견; 자체 개발 파서; PB 규모 템플릿 클러스터링
문서(Documents)
2B(20억)
과학 문서용 GLM-OCR; 추측 디코딩(speculative decoding), 4배 빠름
도서(Books)
50M(5천만)
품질 선별, 깨진 텍스트 탐지, 레이아웃 재정렬
코드(Code)
500M(5억) 저장소
테스트와 이슈 설명을 갖춘 실행 가능한 과제
영상(Video)
10B(100억)
세계 지식과 긴 시퀀스
오디오(Audio)
300M(3억) 시간
음성 인식(ASR) + 반복 재작성; 수조 개 토큰 분량의 세계 지식
오디오 행의 마지막 단어는 화면 오른쪽 끝에서 ‘knowle’까지만 보여 knowledge(지식)로 읽힌다. 표 아래 문장: ‘Each source is a unique scaling problem: crawler, filter, dedup, quality.’(각 출처는 저마다 고유한 스케일링 문제다: 크롤러, 필터, 중복 제거, 품질.) 이 가운데 crawler, filter, dedup, quality는 빨간 글씨다. 왼쪽 아래 꼬리말은 ‘Tsinghua, 202? Intern Talk’(칭화, 202? 인턴 토크)인데, 연도 마지막 자리는 해상도가 낮아 확실히 읽히지 않는다(2024 또는 2026으로 읽힌다). 오른쪽 아래 쪽 번호는 13이다.
아래 사진: 제목 슬라이드. 큰 제목 ‘Data’(데이터), 부제 ‘Scaling effective tokens’(유효 토큰 스케일링), 수식 L(N, D) = L∞ + A/Nα + B/Dβ가 있고, 마지막 항 B/Dβ에 테두리 상자가 쳐져 있으며 제목 ‘Data’에서 이 항으로 곡선이 이어진다. 그 아래에 ‘Jie Tang’(탕제), ‘Department of Computer Science & Technology’(컴퓨터과학기술학과), ‘Tsinghua University’(칭화대학)가 적혀 있다. 화면 오른쪽 칠판 앞에 짙은 색 셔츠 차림의 발표자가 서 있고, 앞에 청중이 앉아 있다.
이미지 2. 검은 배경의 정사각형 그래픽. 왼쪽 위에 흰 사각형 안의 Z 로고, 오른쪽 위에 ‘z.ai’ 글자가 있다. 가운데에는 하늘색 큰 글씨로 ‘GLM-5.5’, 그 아래에 ‘(32B/122B/256B)’가 적혀 있고, 아래쪽에는 흰색과 하늘색 픽셀 점으로 그린, 앞발을 들어 올린 말이 있다.
이 게시물에 단 답글. 프로필 자기소개: Z.ai(@Zai_org) 연구원, 칭화대 KEG(@thukeg) 박사후연구원, 탕제(@jietang)와 함께 일하는 GLM 시리즈 핵심 기여자.
이른바 32B, 122B, 256B라는 건 가짜 소식이다. 전부 1인 미디어들이 믿을 수 없는 출처에서 맥락을 잘라 내 왜곡하고, 잘못된 말을 잘못된 채로 옮기며 퍼뜨린 것이고, 탕 교수님의 강의(lecture)와는 아무 관계가 없다. 전에도 이걸 엉터리로 퍼뜨리는 사람들이 있었는데, 이제는 또 탕 교수님 수업에 짜깁기해 붙였으니 정말 더는 못 봐주겠다.
중국어 원문(所谓32B, 122B, 和 256B是假消息,都是自媒体从不可靠信源里断章取义以讹传讹传出来的,和唐老师的lecture毫无关系。之前就有乱七八糟传这个的,现在又拼接到唐老师课程上,实在看不下去了)
솔직히 이게 가짜 뉴스인 줄 몰랐습니다. 제 의도는 그저 커뮤니티를 위해 곧 나올 기술 유출 소식과 뉴스를 다루는 것이었고, 이 루머를 퍼뜨린 점 깊이 사과드립니다. 모든 책임은 제게 있으며, 앞으로는 어떤 회사나 모델에 관한 것이든 공유하기 전에 정보를 검증하도록 훨씬 더 주의하겠습니다. 🙇♂️
영어 원문(I honestly didn't know this was fake news. My intention was simply to cover upcoming tech leaks and news for the community, and I am deeply sorry for spreading this rumor. I take full responsibility, and I will be much more careful moving forward to verify information before sharing anything about any company or model. 🙇♂️)
원본 블록은 bebu의 게시물 본문 전문과 첨부 이미지 2장을 원래 순서대로 싣는다. 같은 대화의 답글은 원문 해석을 바꾸는 3건만 싣는다. 게시자 본인의 사과, GLM 기여 연구원의 반박, 강의 내용을 설명한 칭화대 출신 계정의 답글이다. 나머지 답글 약 100건과 인용 게시물은 싣지 않는다.
시각은 X가 게시물에 기록한 UTC 시각을 기준으로 적고 한국 시각(KST, UTC+9)을 함께 단다. 원문 게시 시각은 베이징 시각(UTC+8)으로 2026-11-05 02:48이다. 답글이 말한 "이번 주 수요일"은 2026-11-04다.
원본 블록의 이미지 1은 게시물에 첨부된 사본 그대로다. 이 사본의 꼬리말 "Tsinghua, 20?4 Intern Talk"과 표 아래 문장은 같은 강의 사진의 가장 이른 사본과 글자가 다르다. 데이터 표 6행은 두 사본이 같다. 차이는 팩트체크 블록의 사본 대조표에 있다.
용어 대역
원문 용어와 이 문서의 번역어
원문
이 문서의 표기
뜻
Z.ai · Zhipu AI(智谱)
Z.ai, 즈푸(智谱)
GLM 모델 계열을 만드는 중국 회사. Z.ai는 해외 브랜드 이름이다.
Jie Tang (唐杰)
탕제(唐杰)
칭화대학 컴퓨터과학기술학과 교수. 원문은 Z.ai 수석 과학자로 소개한다.
32B, 122B, 256B
320억·1,220억·2,560억 파라미터
모델 크기 표기. B는 10억(billion) 개의 파라미터다.
pretraining
사전 학습
대량의 원시 데이터로 모델의 기본 능력을 만드는 첫 학습 단계.
template clustering
템플릿 군집화
같은 틀로 찍어 낸 웹 페이지를 묶어 중복과 상투 구조를 걸러 내는 처리.
speculative decoding
추측 디코딩
작은 모델이 먼저 여러 토큰을 제안하고 큰 모델이 한 번에 검증해 생성 속도를 올리는 기법.
ASR
음성 인식(ASR)
Automatic Speech Recognition. 음성을 글로 옮긴다.
Community Notes
커뮤니티 노트
X 사용자가 게시물에 붙이는 맥락 설명. 서로 다른 관점의 평가자가 도움이 된다고 평가해야 게시물 아래에 표시된다.