2026-04-27 · drensin.medium.com

코끼리, 금붕어, 그리고 소프트웨어 엔지니어링의 새 황금기

  1. (1)읽기 전에
  2. (2)Executive Summary
  3. (3)팩트체크
  4. (4)원본 (완역)
  5. (5)원본 링크·인용
  6. (6)기타

medium.com · 2026-04-27

코끼리, 금붕어, 그리고 소프트웨어 엔지니어링의 새 황금기

데이브 렌신이 2026-04-27 Medium에 쓴 글이다. 그는 AI가 코드를 쓰면 사람이 붙들 산출물은 설계 문서라고 주장한다. 맥락을 많이 쌓은 AI 세션(코끼리)으로 문서를 쓰고, 기억 없는 새 세션(금붕어)이 그 문서만 읽고 시스템을 설명할 수 있어야 구현에 들어간다. 2026-10-21 이 절차를 담은 플러그인이 egm.dev에 오픈소스로 공개됐다.

읽기 전에

AI가 코드를 쓸 때 사람이 붙들 산출물은 설계 문서다

핵심 질문 — AI가 코드를 쓰는 팀에서 사람은 무엇을 붙들어야 시스템을 이해하고 책임질 수 있는가

렌신의 답은 “설계가 새 코드다”(Design is the new code)라는 한 줄이다. 사람이 코드를 쓰면 작은 설계 결정이 코드 속에 남는다. AI가 코드를 쓰면 그 결정을 사람이 내리지 않는다. 렌신은 그 판단을 코드보다 먼저 설계 문서에 적으라고 쓴다. 기억 없는 새 AI 세션이 그 문서를 읽고 시스템을 설명할 수 있어야 구현을 맡긴다. 2026-04-27 Medium에 실린 데이브 렌신(Dave Rensin, Google Distinguished Engineer)의 글이다.

근거는 저자 팀의 경험이다. 렌신은 2025년 여름 AI의 도움으로 만든 사내 도구를 몇 달 만에 Google 직원 10만 명 넘게 쓰게 됐다고 보고한다. 저자 팀은 그 도구를 키우는 과정에서 이 방법을 찾았다고 쓴다. 비평 제안 중 약 30%가 가치 있다는 수치와 AI가 쓴 README 초안이 말단 디렉터리에서 약 50% 틀린다는 수치도 저자의 관찰이다. 렌신이 쓰는 AI 도구는 Google Antigravity와 Gemini다. 그는 서두에서 이 글이 개인 관점이라고, 1년이면 낡을 수 있다고 밝힌다.

발행 약 6개월 뒤인 2026-10-21 렌신은 글머리에 업데이트 문단을 붙였다. Google의 허락을 받아 팀이 사내에서 쓰던 플러그인을 egm.dev에 오픈소스로 공개했다는 내용이다. egm.dev는 이 플러그인을 AI 코딩 에이전트용 스펙 주도 개발(spec-driven development) 플러그인이라고 소개한다.

멘탈 모델

코끼리 세션에서 설계 문서를 키운다 → 금붕어 세션으로 문서를 시험한다 → 통과한 문서로 코드를 만든다. 렌신은 2부가 1부의 기본 원칙을 소프트웨어 작성에 적용한 것이라고 소개한다. 1부의 자동차 구매 예에서 AI에게 질문을 받아 요구를 넓히는 인터뷰가 코끼리 단계의 원형이다.

모르면 막히는 말

  • 코끼리(Elephant)와 금붕어(Goldfish) — 코끼리는 맥락을 오래 쌓은 AI 세션과 그 세션이 함께 쓴 설계 문서다. 금붕어는 기억이 0인 새 세션이다. 금붕어는 앞에 놓인 문서와 문서가 가리키는 파일만 안다.
  • 진실의 원천(source of truth) — 렌신은 설계 문서를 코드의 진실의 원천이자 가드레일로 둔다. 문서는 문제, 기술 계획, 대안, 상세 구현의 네 절이다. 상세 구현 절은 만들거나 바꿀 파일을 빠짐없이 적는다. 파일마다 이유를 단다. 대안 절에는 검토하고 버린 선택지를 적는다. 렌신은 이 기록이 뒷날의 환각과 되풀이되는 논쟁을 막는다고 쓴다.
  • sizeof(docs) << sizeof(code) — 렌신의 세 번째 깨달음이다. sizeof는 C의 크기 연산자다. 여기서 <<는 비트 시프트가 아니라 수학의 ‘훨씬 작다’(≪)다. AI에게 맥락을 줄 때 코드 수만~수십만 줄보다 평이한 영어 설계 문서가 비용·속도·신뢰도 모두에서 낫다는 주장이다.
  • 제번스 역설(Jevons paradox) — 1865년 영국 경제학자 윌리엄 스탠리 제번스는 석탄 이용 효율이 오르자 석탄 소비가 오히려 늘어난 현상을 기록했다. 렌신은 이 현상을 들어 AI가 일을 쉽게 만들어도 일하는 시간은 줄지 않는다고 쓴다. 노력의 비용이 내려가면 하는 일이 늘어난다는 논리다.

읽는 순서

  1. 세 번의 깨달음과 사라지는 코드를 먼저 읽는다. 문서가 코드의 자리를 넘겨받는다는 논지의 근거가 이 두 절에 있다.
  2. EGM 소개부터 4단계: 구현까지 차례로 읽는다. 단계마다 저자가 실제로 쓰는 프롬프트 원문이 붙어 있다.
  3. 이미 큰 코드베이스가 있으면 현실 부트스트래핑을 읽는다. 말단 디렉터리부터 README를 만들어 루트까지 올라가는 절차다. 렌신은 코드베이스 크기와 거의 무관하게 약 1주가 걸린다고 쓴다.
  4. 1부에서 하나만 고르면 판단에 관한 한마디다. 판단을 기계에 맡기지 말라는 이 절의 주장이 마지막 생각까지 이어진다.
  5. 3부는 저자 스스로 “아마 틀릴 예측”이라 부르는 전망이다. 에이전트와 사람의 닮은 점과 실용적 조언이 에이전트 관리를 사람 관리에 견준다.

짧게 읽으려면 Executive Summary와 사라지는 코드만 읽는다. 원문 수치와 인용의 판정은 팩트체크에 있다. 원문 페이지가 밝힌 완독 분량은 27 min read다.

읽고 나면 답할 수 있어야 하는 질문

  1. 렌신은 왜 코드가 결국 사람에게 불투명해진다고 보는가? 그가 그리는 두 갈래 미래는 사라지는 코드에 있다. 사람이 에이전트의 결과물에 책임을 지는 문제는 속도와 이해에 있다.
  2. 설계 문서가 충분한지 무엇으로 판정하는가? 금붕어 세션이 문서에 던지는 세 질문은 금붕어 프로토콜의 5~7단계에 있다. 사람이 검토하고 승인하는 자리도 같은 절 끝에 있다.
  3. EGM은 스펙 주도 개발과 무엇을 공유하고 무엇을 더하는가? 원문은 ‘스펙 주도 개발’이라는 말을 쓰지 않는다. 문서를 코드보다 먼저 쓰는 부분은 1단계와 2단계에 있다. 기억 없는 세션을 문서의 시험관으로 쓰는 장치는 금붕어 프로토콜에 있다. 기존 코드베이스를 문서로 끌어올리는 장치는 현실 부트스트래핑에 있다. 이 두 장치가 다른 스펙 주도 도구에도 있는지는 원문이 다루지 않는다.

Executive Summary

AI가 코드를 쓰는 동안 사람은 판단을 설계 문서에 먼저 담고, 기억 없는 새 AI 세션으로 그 문서를 시험한다

데이브 렌신(Dave Rensin)은 AI가 코드를 쓰면 엔지니어의 일이 설계 판단으로 옮겨 간다고 본다. 그의 처방은 판단을 코드보다 먼저 설계 문서에 담는 것이다. 그 문서는 기억 없는 새 AI 세션으로 시험한다. Google Distinguished Engineer인 렌신은 2026-04-27 Medium에 실은 글에서 이 방법을 Elephant-Goldfish Model(EGM)이라 이름 붙였다. 2026-10-21 글머리 업데이트에서는 이 방법을 따르는 사내 AI 코딩 어시스턴트 플러그인을 Google의 허락을 받아 오픈소스로 공개했다고 알렸다(egm.dev).

신뢰도 B — 저자 신원·플러그인 공개·모델 한계 주장은 1차 출처와 맞는다. 요기 베라 귀속과 금붕어 은유의 전제는 틀렸다. 판정 32건은 팩트체크 블록에 있다.

같은 원리는 코딩 밖의 조사에도 쓰인다. 바탕 전제는 AI가 아직 판단을 하지 못한다는 것이다. 렌신은 이 전제 위에서 모두가 에이전트를 관리하는 관리자가 된다고 예측한다.

근거는 저자 팀의 경험이다. 원문에는 다른 방법과 비교한 측정이 없다. 아래의 사용자 수와 비율은 모두 저자의 보고다. 렌신 스스로 이 관찰이 개인적 관점이라고 글머리에 적는다. 1년 뒤면 낡을 수 있으니 회의적으로 읽으라고도 쓴다.

녹색 조끼를 입은 코끼리가 빛나는 'Source of Truth' 두루마리를 들고 있다. 조끼 주머니에는 'Design Intent'·'Micro-decisions'·'The Why' 두루마리와 땅콩이 들어 있다. 안경을 쓴 금붕어, 깃펜을 든 금붕어, 안전모를 쓰고 자를 든 금붕어, 돋보기를 든 금붕어가 'Technical Plan' 문서와 'Every Single File' 체크리스트를 검사한다. 왼쪽에 'No-Code Zone' 기계, 오른쪽에 'Design is the New Code' 표지판이 있고 바닥에 코드 블록이 흩어져 있다.
원문 글머리 삽화. 코끼리는 설계 의도와 미세 결정을 쥔 맥락 많은 세션이다. 금붕어 넷은 설계 문서를 검사하는 기억 없는 세션이다. 왼쪽 기계와 오른쪽 표지판은 2부의 코드 금지 규칙과 결론 구호를 옮겼다.

전제: AI는 판단을 하지 못하므로 판단은 사람이 쥔다

렌신은 직무와 상관없이 사람이 고용된 이유를 하나로 본다. 뛰어난 판단으로 사업에 가치를 더하는 일이다. 회사는 판단의 질과 영향으로 사람의 값을 정한다. 경력 초기라면 회사는 판단을 빨리 얻는 능력에 건다. 후반이라면 쌓인 판단을 쓰고 남이 판단을 얻도록 돕는 일을 산다. 그는 AI가 집필 시점(2026-04) 기준으로 이런 판단을 하지 못한다고 쓴다. AI는 판단을 닮은 단어열을 잘 만들 뿐이므로 판단을 기계에 맡기지 말라는 것이 아래 세 부의 전제다 (원문).

1부: AI에게 조사를 맡기기 전에 AI의 질문을 받고 채점 기준을 만든다

렌신은 사용법만 바꾸면 엔지니어가 아니어도 10배 생산성 향상을 얻는다고 쓴다. 예는 새 차 구매다. 흔한 방식은 조건을 리서치 모드에 넣고 가장 포괄적인 보고서를 요구하는 것이다. 20분 뒤 그럴듯한 보고서가 나온다. 저자는 이를 도구를 장난감처럼 써서 장난감 결과를 얻은 것이라 부른다. AI를 심문자(interrogator)로 쓰지 않고 조사원(researcher)으로 쓴 탓이다 (원문).

  1. 질문받기 (Step 1). 그만하라고 할 때까지 AI가 질문하며 내 가정을 따지게 한다. 가끔 AI의 생각도 묻는다. 15~20분 답하며 배우려고 논쟁하면 한 문단이 2~3쪽 문제 설명이 된다.
  2. 채점 기준 만들기 (Step 2). 같은 세션에서 AI에게 회의적인 팩트체커 역할을 맡긴다. 후속 질문 없는 단 한 번의 조사라는 조건으로 믿을 만한 보고서의 요건을 15~20분 정한다. 결과는 2~3쪽 채점 기준이다.
  3. 조사 맡기기 (Step 3). 새 세션의 딥 리서치 모드에 문제 설명과 채점 기준을 함께 주고 시간 제한 없이 돌린다. 결과는 한 번에 묻는 프롬프트보다 낫다고 그는 쓴다.

AI가 맞장구만 치면 아첨 소용돌이(sycophantic spiral)에 빠진 것이다. 렌신은 이를 '친절하고 도움이 되라'는 지시의 결과로 본다. 처방 문장은 "내게 동의할 때 너는 도움이 되지 않는다. 내 생각에 도전할 때 가장 도움이 된다"다.

렌신은 효과가 복리로 쌓인다고 본다 (원문). 문제 설명·채점 기준·최종 산출물 세 가지만 NotebookLM 같은 곳에 저장한다. 대화 전문은 대부분 토큰 잡음이다. 쌓인 기록은 "우리는 왜 이렇게 결정했나?"에 답하고 온보딩과 과거 추론 대조를 돕는다고 그는 쓴다.

2부의 출발: AI로 빨리 쓰는 코드는 실수도 대량 생산한다

렌신은 2025년 여름 업무 문제를 풀려고 AI의 도움으로 작은 도구를 만들었다. 저자의 보고로는 몇 달 안에 Google 직원 10만 명 이상이 이 도구를 정기적으로 썼다. 그는 AI 코딩 어시스턴트(Google Antigravity, Gemini) 없이는 이 속도로 수십 명의 기여를 받으면서 보안·프라이버시·신뢰 기준을 지킬 수 없었다고 본다. 위험도 함께 왔다. 조심하지 않으면 실수를 대량 생산한다. 신호 대 잡음비를 높게 지키지 못하면 생산성은 뒤로 간다. 나쁜 코드가 쓸모 있는 코드보다 빨리 쌓이면 프로젝트는 슬롭(slop)의 무게로 무너진다 (원문).

세 번의 깨달음: 설계 문서 하나가 복구·가드레일·맥락을 맡는다

넷째 칸은 원문이 뒤의 단계 설명에서 같은 이유를 드는 자리다 (원문).

깨달음겪은 일저자의 결론EGM에서 쓰이는 자리
1. 복구한 시간째 세션이 멈췄다. 새 세션에 코드 수백 줄을 다시 먹이느라 토큰과 시간을 썼다.의도와 진행 상태를 적은 문서가 있으면 재시작은 30초 작업이다.Step 8 세션 복구
2. 가드레일맥락을 되찾자 AI가 요청 밖으로 달렸다. 없는 API를 지어내고 맞지 않는 구조를 골랐다.비위를 맞추려는 AI는 엄격한 가드레일 없이는 절벽으로 달린다.Phase 2의 '대안' 절과 파일 목록
3. 맥락새 기능에 소스 코드 대신 설계 문서를 먹였다.sizeof(docs) << sizeof(code). 영어 설계 문서가 코드 수만~수십만 줄보다 싸고 빠르고 믿을 만한 맥락이다.Phase 3 금붕어 시험

AI가 코드를 쓰면 설계 판단은 설계 문서에만 남는다

렌신은 설계 판단이 지금까지 설계 문서와 코드 두 곳에 있었다고 쓴다. 사람이 코드를 쓰면 미세 결정(micro-decision)이 논리에 흔적으로 남는다. AI가 코드를 쓰면 그 흔적이 없다. 판단을 코드 작성 전에 설계 문서로 앞당기지(shift left) 않으면 책임자인 사람이 시스템을 이해하지 못한다. 엄밀함 때문에 아직 코드가 필요하지만 사람이 100% 검토하는 코드는 사라져 가는 중간 단계라고 그는 본다. AI가 사람이 다 검토할 수 없을 만큼 코드를 쏟아 내든 바이너리를 직접 만들든 코드는 불투명해진다고 그는 내다본다. 그때 남는 산출물은 설계뿐이므로 그는 "설계가 새 코드다(Design is the new code)"라고 쓴다 (원문).

근거는 책임이다. 렌신은 에이전트의 모든 행동에 결국 사람이 책임을 진다고 쓴다. 이해하지 못한 시스템의 위험은 질 수 없다. 그가 보기에 엔지니어의 일은 IDE에 구문을 치는 데서 의도·아키텍처·설계 판단으로 옮겨 간다. 설계를 새 코드로 다루면 사람의 이해와 AI의 속도가 맞물린다는 것이 그의 결론이다 (원문).

Elephant-Goldfish Model: 맥락 쌓인 세션으로 설계하고 기억 없는 세션으로 시험한다

코끼리(Elephant)는 프롬프트를 많이 받아 맥락이 쌓인 AI 세션과 그 세션이 함께 쓴 설계 문서다. 조직 지식, 미세 결정, 논쟁, 기능 이력을 쥔다. 금붕어(Goldfish)는 기억이 0인 새 세션이다. 절차는 "코끼리를 먹이고 금붕어로 시험한다"다 (원문). Phase 1의 목표는 코드 한 줄 전에 기능과 평가 기준을 함께 설계하는 것이다. 금붕어 시험은 설계 문서가 코끼리 세션의 맥락 없이 혼자 서는지 가린다. 프롬프트 전문은 원문 Phase 1·2·3·4에 있다.

세션 칸: 코끼리 = Phase 1부터 이어 온 같은 세션 · 금붕어 = 그 단계에서 새로 연 빈 세션 · 구현 = 확정된 설계 문서를 받은 세션
단계세션할 일반복을 멈추는 조건
Phase 1 · Step 1 맥락 적재코끼리설계 문서나 소스 트리를 읽혀 상위 수준 설명을 듣고 오해를 바로잡는다. 1분째의 오해가 10분째의 나쁜 코드가 된다. 새 프로젝트는 건너뛴다.이해가 맞을 때
Step 2 코드 금지코끼리코드를 만들지 말라고 못 박고 설계 토론을 20~30분 한다. 환각에는 바로잡을 파일을 가리킨다. 차 구매의 Step 1과 같다.문제 설명이 선명할 때
Step 3 아첨 대응코끼리AI가 "Great idea, Dave!"로 돌아서면 1부의 아첨 처방을 쓴다. "Why do you think that?"은 환각 고리를 자주 끊는다.AI가 다시 따질 때
Step 4 첫 기술 제안코끼리AI가 먼저 산문과 블록 다이어그램으로 제안해 이해도를 드러낸다. 사람이 먼저 내면 사각지대를 놓친다. 틀린 곳에는 auth.py 같은 파일을 읽힌다. 저자는 Gemini와 2~3일 간 세션도 있었다고 쓴다.견고한 접근에 합의할 때
Phase 2 설계 문서 작성코끼리출력 토큰 한도 때문에 아래 네 절을 하나씩 쓴다. 소스 트리에 저장한 이 문서를 저자는 새 소스 코드라 부른다.네 절을 다 썼을 때
Phase 3 · Step 5 이해 시험금붕어문서와 참조 파일만으로 목표와 현재 시스템을 설명하게 한다. 못 하면 맥락이 빠졌다.설명에 성공할 때. 통과한 문서는 슬롭을 막는다
Step 6 비평 검토금붕어전문 검토자 역할로 놓친 것·틀린 가정·엣지 케이스를 찾는다. 저자 일화로는 제안의 약 30%가 크게 쓸모 있다.지적이 꼬투리 수준일 때
Step 7 구현 준비도금붕어첫 시도에 구현할 정보가 다 있는지 묻는다. 질문에는 문서 안에서 답한다.누락과 모호함이 없을 때. 끝으로 사람이 검토·승인한다
Phase 4 · Step 8 가드레일 코딩구현이때 처음 코드를 쓴다. 지시는 "Follow the plan exactly."다. 문서가 모든 파일과 변경을 적어 두어 품질이 오른다. 세션이 무너지면 새 세션에 문서를 준다.구현 완료
Step 9 '못된' 코드 리뷰구현"이 코드의 질이 낮다는 강한 직감이 있다. 갈가리 찢어 달라"가 저자의 실제 프롬프트다. 주석 없이 10줄을 넘긴 곳을 표시하게 한다.비평이 사소해질 때
Phase 2 설계 문서의 네 절 (원문 순서)
절내용
문제(The Problem)사업 문제를 평이한 영어 3~5문장으로
기술 계획(The Technical Plan)큰 구성 요소와 연결을 전문용어 적은 산문과 블록 다이어그램으로
대안(Alternatives)Phase 1에서 버린 생각과 결정. 뒤의 환각과 논쟁을 막는 가드레일
상세 구현(Detailed Implementation)가장 긴 절. 만들거나 바꿀 모든 파일과 그 이유. AI를 궤도에 붙잡는 장치

기존 코드베이스: README 재귀 요약으로 약 1주 만에 코끼리를 먹인다

수백만 줄 코드베이스에 설계 문서를 쓸 시간이 없다는 반론에 렌신은 크기와 거의 상관없이 약 1주면 된다고 답한다. 소스 전체를 먹이면 AI는 맥락을 잃고 환각한다. 대신 압축한 맥락 조각, 저자의 말로 '땅콩과 건초'인 README.md를 먹인다 (원문).

  1. 가장 아래 디렉터리부터 개발자마다 나눠 맡는다.
  2. AI가 디렉터리의 목적과 파일별 기능을 README.md로 쓴다.
  3. 담당 엔지니어가 5~10분 고친다. 코드만 보고 쓴 잎 디렉터리 초안은 저자 추정으로 약 50% 틀린다.
  4. 한 단계 위에서는 하위 README와 그 디렉터리 코드만 읽혀 같은 형식으로 쓴다. 루트까지 되풀이한다.

이렇게 생긴 맥락 계층을 루트에서 새 세션에 먹이면 AI는 적은 컨텍스트 창으로 주요 서브시스템과 설계 패턴을 집어낸다. 저자는 완벽하지는 않다고 덧붙인다. README는 모든 코드 파일이 설계 문서 하나 이상에 언급될 때까지만 필요하고 그 뒤에는 지워도 된다. 처음부터 EGM으로 시작한 새 애플리케이션에는 필요 없다.

부수 효과: 문서 계층이 온보딩과 비개발자의 기여를 연다

렌신은 새 팀원에게 README 계층과 설계 문서를 넣은 NotebookLM 노트북을 준다. 시스템 지침에는 그가 맡을 부분을 적는다. 첫 과제는 첫 기능의 설계 문서다. 그 문서가 금붕어 시험을 통과하면 기여할 준비가 된 것으로 본다. 몇 주의 그림자 근무(shadowing)가 이 과제로 바뀐다 (원문).

코딩 경험이 조금 있는 제품·프로그램 관리자가 기능을 제안하면 2025년 전처럼 백로그에 넣지 않는다. 노트북을 주어 설계 문서를 직접 쓰게 한다. 저자의 보고로는 며칠 뒤 온 초안이 대개 약 70~80% 정확하다. 한두 번 더 고치면 팀 기준을 넘는다. 그 뒤 그들이 AI로 만든 코드는 평소 검토를 거쳐 소스 트리에 들어간다.

3부 예측: 모두가 에이전트를 관리하는 관리자가 된다

렌신은 3부의 예측이 아마 틀릴 것이라고 적는다. 3부 머리의 "예측은 어렵다, 특히 미래에 관해서는"을 원문은 요기 베라(Yogi Berra)의 말로 인용한다. 첫 예측은 사람 관리자와 개인 기여자(individual contributor, IC)의 구분이 2026년 안에 흐려진다는 것이다. 누구나 자기 대신 일하는 에이전트 여럿을 관리하게 된다고 그는 쓴다. 사람을 관리해 본 이는 쉽게 적응한다 (원문).

근거는 관리의 목적이 같다는 데 있다. 관리는 내 판단을 내가 직접 하는 일 너머로 늘리는 일이다. 모든 단계를 지시하는 마이크로매니징은 규모가 커지지 않는다. 좋은 관리자는 원하는 결과와 가드레일, 권한의 범위, 멈추고 물을 조건을 준다. 눈을 떼도 일이 돌아가는 시간이 길어질수록 1인당 부담이 줄어 더 많이 맡는다. 렌신은 경력 계획 말고는 에이전트 관리와 닮은 점이 더 많다고 보고 IC에게 둘을 권한다 (원문 · 조언).

3부 처방: AI가 덜어 준 시간은 오래 집중하는 판단 일에 쓴다

렌신은 AI가 현황 보고와 업데이트 회의 같은 잡일(toil)을 흡수한다고 쓴다. 되찾은 시간은 어려운 사고, 실제 설계, 남에게 넘길 수 없는 판단에 쓸 시간이다. 걸림돌은 끊임없는 방해 탓에 키우지 못한 집중 지구력이다. 처방은 매 근무일 30~45분 집중으로 시작해 매주 5~10분씩 늘리는 것이다. 몇 달이면 2시간 이상 간다. 그 시간에 AI와 논쟁해도 된다. 목표는 정신적 피로에 닿는 것이다 (원문).

AI가 잡일을 덜어도 사람이 꼭 덜 일하게 되지는 않는다고 그는 본다. 노력의 비용이 떨어지면 일을 더 한다. 그는 이를 제번스 역설이라 부른다. 제번스 역설은 W. S. 제번스(William Stanley Jevons)가 1865년 석탄 사용 효율이 오르자 석탄 총소비가 늘었다고 관찰한 데서 나왔다. 렌신은 자원 소비에 관한 이 관찰을 노동 시간에 옮겨 쓴다.

닫는 말: 판단을 기르고 늘리는 사람에게 수요가 남는다

AI 때문에 긴 경력을 못 가질까 걱정하는 학생과 젊은 동료에게 렌신은 업무는 바뀌어도 가치는 남는다고 답한다. 자기 분야의 안목(taste)을 기르고 그것을 늘리는 법을 배울수록 수요가 커진다. 그는 AI를 장인처럼 쓰는 길이 "산처럼이 아니라 언덕처럼" 힘들다고 쓴다 (원문).


팩트체크

방법론을 받치는 사실 전제는 1차 출처와 맞는다. 틀린 곳은 인용 귀속 1건과 은유 전제 1건이다.

B

논증의 뼈대인 모델 한계 주장은 연구와 맞는다. 아첨의 원인과 제번스 역설은 출처의 범위를 넘겨 썼다. 사용자 수와 성공률은 저자 보고뿐이다.

판정 기호와 건수 (판정 기준일 2026-11-07)
✅ 사실🟡 부분사실⚠️ 불확실❌ 거짓
1차 출처가 같은 내용을 담는다핵심은 맞다. 인과·범위·강도가 출처와 다르다외부 출처로 확인할 수 없다(저자 자기 보고 포함)1차 출처가 반대 내용을 담는다
18건2건10건2건

등급: A 1차 출처와 일치, 차이는 표기 수준 · B 세부 오류 일부 · C 핵심 주장 일부 오류 · D 핵심 주장 다수 오류 · F 핵심 주장이 거짓.

저자와 플러그인

✅

저자 데이브 렌신은 Google Distinguished Engineer다(Medium 프로필 자기소개)

Google Research 인물 페이지가 그를 Distinguished Engineer로 소개한다. 같은 페이지는 그가 Alphabet 최고재무책임자(CFO)에게 자본 배분을 조언하는 기술 자문단에 있다고 적는다. 미시간대학교 EECS 세미나 공지(2026-09-03)는 그가 AI로 모든 Googler의 생산성을 높이는 일에 집중한다고 소개한다.

저자 사이트 기재로는 2014-11 Google에 들어왔다. 2021-03~2022-09에는 Pendo.io 엔지니어링 수석부사장이었다. 2022-09에 Distinguished Engineer로 Google에 돌아왔다.

Google Research — David K. Rensin · 미시간대학교 EECS 세미나 공지 · dkr.bio

✅

저자 이력: Google Customer Reliability Engineering(CRE) 출범을 이끌었다(dkr.bio 자기소개 'Pioneered Google's CRE function')

Google Cloud 블로그의 CRE 출범 글(2016-10-11)을 렌신이 썼다. 서명은 'Director, Customer Reliability Engineering, Google Cloud'다. 글은 CRE를 전주에 발표한 Google의 새 직군으로 소개한다.

SRE(사이트 신뢰성 엔지니어링) 자체는 벤저민 트레이너 슬로스가 2003년 Google에서 7명 팀으로 시작했다. 렌신이 맡은 것은 SRE 원칙을 고객 시스템에 적용하는 CRE다.

Google Cloud 블로그 — CRE 출범 · SRE 책 서론

✅

2026-10-21 업데이트: Google이 저자 팀에 사내 AI 코딩 플러그인의 오픈소스 공개를 허락했다

Google 오픈소스 블로그 공지(2026-10-22)가 같은 내용을 적는다. 공지는 이 플러그인을 Google 엔지니어용 사내 도구로 개발했다고 밝힌다. 공지 저자 5명에 렌신이 있다.

egm.dev 하단은 'This is not an officially supported Google product.'라고 적는다. Google 소유 저장소에서 공개했다는 뜻이다. Google이 제품으로 지원한다는 뜻은 없다.

Google 오픈소스 블로그 공지 · egm.dev

✅

공개 저장소 github.com/google/elephant-goldfish-model이 있다. 라이선스는 Apache 2.0이다

GitHub API는 google 조직 소유 저장소와 Apache-2.0 라이선스를 반환한다. 저장소 홈페이지 필드는 egm.dev다. 공개 플러그인은 Antigravity 외에 Claude Code·Codex 설치 명령도 제공한다.

GitHub 저장소 · GitHub API — 저장소 정보 · egm.dev

✅

공개 시점: 저장소 첫 커밋 날짜가 업데이트 날짜(2026-10-21)와 같다

가장 오래된 커밋은 2026-10-21 16:17 UTC의 'initial open-source release'다. 저장소 생성 기록은 2026-09-13이다. 그 사이 비공개 상태였는지는 API 기록으로 알 수 없다. 첫 릴리스 v0.1.0은 2026-10-27에 나왔다.

GitHub API — 첫 커밋 · GitHub API — 릴리스

✅

감사 인사의 엘리스 유잉은 저자의 Google 동료다

Google 오픈소스 블로그 공지의 공동 저자 5명에 엘리스 유잉(Elise Ewing)이 있다. 공지는 이들을 Elephant-Goldfish Model 팀이라 부른다.

Google 오픈소스 블로그 공지

✅

감사 인사의 앰버 허프먼·파르타 랑가나탄은 저자의 Google 동료다

Google Cloud 블로그(2023-10-18)는 랑가나탄을 'Google VP and Technical Fellow'로 소개한다. 같은 글은 허프먼이 랑가나탄의 뒤를 이어 OCP(Open Compute Project) 이사회의 Google 대표가 됐다고 적는다. 이 글의 기준일은 2023-10-18이다.

Google Cloud 블로그 — OCP Global Summit

⚠️

업데이트가 가리키는 플러그인을 Google 엔지니어 수천 명이 매일 쓴다(egm.dev·Google 오픈소스 블로그)

Google 자체 발표 외에 측정 자료가 없다. 이 수치는 원문 본문의 '10만 명 이상'과 대상이 다르다. 10만 명은 저자가 2025년 여름 업무 문제를 풀려고 만든 사내 도구의 사용자다. 수천 명은 이 방법론을 따르는 데 쓰는 코딩 플러그인의 사용자다.

Google 오픈소스 블로그 공지 · egm.dev

⚠️

2025년 여름 저자가 만든 사내 도구를 몇 달 만에 Googler 10만 명 이상이 정기적으로 썼다

도구 이름과 사용 지표가 공개되지 않았다. 원문 밖 1차 자료로 확인할 수 없는 저자 보고다.

원문

도구와 제품

✅

저자는 Google Antigravity와 Gemini를 쓴다 — Antigravity는 원문 집필(2026-04) 전에 공개된 Google 제품이다

Google은 2025-11-18 Antigravity를 공개 프리뷰로 내놓았다. 출시 글은 Gemini 3 Pro 사용 한도를 함께 제공한다고 적는다. 원문 집필 시점(2026-04)의 현재형 서술과 맞는다. 저자가 사내 도구를 만든 2025년 여름은 공개 전이다. 그때 쓴 코딩 도구가 무엇인지는 원문에 없다.

Antigravity 출시 글 · Google Developers 블로그

✅

현재 모델은 한 번에 내는 출력 토큰 수에 한도가 있다

Google Cloud 문서는 Gemini 2.5 Pro의 최대 출력 토큰을 65,536개로 적는다. 입력 쪽 컨텍스트 창(1,048,576 토큰)과 별개의 상한이다. 설계 문서를 한 번에 쓰게 하지 말라는 원문 조언의 전제와 맞는다.

Gemini 2.5 Pro 모델 문서

✅

NotebookLM은 Google 제품이다

Google은 2023-07-12 Google Labs 실험 제품으로 NotebookLM을 내놓았다. 이전 이름은 Project Tailwind다.

Google 블로그 — NotebookLM 소개

✅

NotebookLM 노트북에 지시(어느 부분에 집중할지)를 넣을 수 있다

Google은 2025-10-29 노트북 채팅에 목표·말투·역할을 지정하는 기능을 더했다. 원문의 '시스템 지시' 단계는 이 기능으로 할 수 있다.

Google 블로그 — NotebookLM 목표 설정

✅

원문이 링크한 Coursera 'Google People Management Essentials'는 Google이 만든 관리자 기초 과정이다

Coursera 페이지는 제공자를 Google로 적는다. 과정은 Google School for Leaders가 설계한 4개 강좌 묶음이다. 다루는 기술에 위임(Delegation Skills)이 있다.

Coursera — Google People Management Essentials

AI 모델의 한계

🟡

원문: 아첨(sycophancy)은 모델에 '친절하고 도움이 되라'고 지시한 데서 오는 피할 수 없는 결과다 → 확인: 연구는 사람 선호 피드백으로 학습한 데서 원인을 찾는다. 학습 조정으로 정도가 달라진다.

샤르마 외(2023)는 사람 피드백으로 미세조정한 AI 비서 5종에서 아첨을 관찰했다. 이들은 아첨이 사람 선호 판단에 일부 기인할 가능성이 높다고 결론지었다.

OpenAI는 2025-04-29 아첨이 심해진 GPT-4o 업데이트를 되돌렸다. 후속 글(2025-05-02)은 사용자 엄지 피드백 보상 신호가 아첨을 억제하던 기존 보상 신호를 약하게 만들었다고 설명한다. OpenAI도 '유용하고 지지하려는' 성향의 부작용을 인정한다. 원문의 인과 방향은 일부 맞는다. '피할 수 없다'는 단정은 이 출처들과 맞지 않는다.

샤르마 외(2023) · OpenAI — GPT-4o 아첨 롤백 · OpenAI — 아첨 후속 설명

✅

맥락이 길어지면 모델이 맥락을 놓치고 헷갈린다

리우 외(2023)는 관련 정보가 긴 입력의 가운데 있을 때 성능이 크게 떨어진다고 보고했다. Chroma의 2025-07-14 보고서는 Gemini 2.5를 포함한 18개 모델에서 입력이 길수록 성능이 불안정해진다고 적는다.

리우 외(2023) · Chroma — Context Rot

✅

AI가 구현 중 존재하지 않는 API를 지어낸다(hallucinating APIs)

자인 외(2024)는 클라우드 API 벤치마크(CloudAPIBench)에서 GPT-4o의 저빈도 API 호출 가운데 유효한 것이 38.58%라고 보고했다. 스프래클런 외(2024)는 코드 생성 모델 16종의 코드 표본 576,000개를 분석했다. 존재하지 않는 패키지 비율은 상용 모델 평균 5.2% 이상, 오픈소스 모델 평균 21.7% 이상이었다.

자인 외(2024) · 스프래클런 외(2024)

⚠️

AI 모델을 쓰는 엔지니어는 10배 생산성 향상을 얻는다(Part 1 첫 문장의 전제)

통제 실험 수치는 10배와 거리가 멀다. METR의 무작위 대조 실험(2025-07)에서 숙련 오픈소스 개발자의 작업 시간은 AI를 허용하자 19% 늘었다. Google 엔지니어 96명 대상 실험(2024-10)은 작업 시간이 약 21% 줄었다고 보고했다. GitHub Copilot 실험(2023-02)에서 사용 집단은 과제를 55.8% 빨리 끝냈다. 원문은 10배의 측정 근거를 대지 않는다.

METR 무작위 대조 실험(2025) · Google 사내 무작위 대조 실험(2024) · GitHub Copilot 실험(2023)

은유와 인용

✅

'An elephant never forgets'는 영어권 속담이다

사키(H. H. 먼로)의 단편집 『Reginald』(1904-09 초판)에 'Women and elephants never forget an injury.'라는 문장이 있다. 속담 사전들은 낙타가 상처를 잊지 않는다는 그리스 속담이 앞선다고 적는다. 사전 내용은 PhraseFinder 게시판의 2차 인용으로만 확인했다.

사키 『Reginald』 · PhraseFinder 게시판

✅

은유의 전제: 코끼리는 기억이 오래 간다

암컷 코끼리는 가족·유대 집단 구성원의 접촉 울음을 다른 집단의 울음과 구별해 기억한다. 렌슈(1957)의 실험 코끼리는 1년 반 뒤에도 배운 음을 알아봤다. '결코 잊지 않는다'는 과장이다. 기억이 길다는 전제는 연구와 맞는다.

위키백과 — Elephant cognition

❌

은유의 전제: 금붕어는 기억이 거의 없다(원문은 기억 0 세션을 금붕어라 부른다) → 확인: 금붕어 기억은 적어도 3개월 간다.

'금붕어 기억은 3초'는 통념이다. 기 외(1994, 플리머스대학교)의 금붕어는 하루 1시간만 먹이가 나오는 레버를 4주 동안 익혔다. 이 금붕어들은 급식 시각을 예상해 레버를 눌렀다. 은유는 통념으로 통한다. 생물학 사실로는 틀렸다.

위키백과 — Goldfish · 기 외(1994)

❌

원문: "It’s tough to make predictions, especially about the future." ― 요기 베라 → 확인: 작자 미상의 덴마크 말이다. 최초 기록은 1948년 덴마크 정치인의 회고록이다.

Quote Investigator에 따르면 가장 이른 기록은 덴마크 정치인 카를 크리스티안 스테인케(Karl Kristian Steincke)의 회고록 4권 『Farvel Og Tak』(작별과 감사, 1948)이다. 이 책은 1937~1938년 덴마크 의회 회기에 나온 말로 'Det er vanskeligt at spaa, især naar det gælder Fremtiden.'을 싣는다. 발화자는 적혀 있지 않다.

닐스 보어 귀속은 1971년에 처음 나온다. QI는 보어가 1962년 이전에 이 말을 썼을 가능성은 인정한다. QI가 찾은 베라 귀속 가운데 가장 이른 것은 1991년 신문 기사다. 그 기사 속 문장도 'I never make predictions, especially about the future.'로 원문 인용과 다르다. 예측은 어렵다는 경구의 출처는 1948년 덴마크 기록이다.

Quote Investigator

관리·집중·노동

⚠️

처음 관리자가 되면 보통 3~5명 팀을 맡는다

Gallup 자료는 첫 관리자를 따로 나누지 않는다. Gallup(2026-01-13)은 전체 관리자의 팀 규모 중앙값을 5~6명으로 적는다. 관리자의 37%가 5명 미만을 맡는다. 원문 수치는 저자의 경험칙이다.

Gallup — Span of Control

✅

집중 훈련 일정: 하루 30~45분에서 매주 5~10분씩 늘리면 몇 달 안에 2시간에 이른다(산술 정합)

45분에서 매주 10분씩 늘리면 8주째에 2시간을 넘는다. 30분에서 매주 5분씩 늘리면 18주가 걸린다. 약 2~4개월이므로 '몇 달'과 맞는다.

원문

⚠️

지친 뇌는 지친 이두근처럼 성장 신호를 보낸다

원문은 근거를 대지 않는다. 빌러 외(2022)는 하루 내내 고강도 인지 작업을 한 사람의 외측 전전두엽에 글루탐산이 쌓인다고 보고했다. 이들은 이 축적을 인지 통제 비용을 높이는 조절 장치로 해석한다.

자기통제를 근육에 빗댄 '강도 모형'의 핵심 효과인 자아 고갈은 대규모 재현에서 나오지 않았다. 23개 실험실 재현(2016)의 효과 크기는 d = 0.04였다. 36개 실험실 재현(2021)은 d = 0.06이었다. 피로가 성장을 알린다는 비유를 받칠 결과는 이 연구들에 없다.

빌러 외(2022) · 해거 외(2016) · 보스 외(2021)

✅

제번스 역설은 오래 관찰된 현상이다(윌리엄 제번스)

영국 경제학자 윌리엄 스탠리 제번스가 1865년 『The Coal Question』에서 기술했다. 석탄 사용 효율이 오르자 석탄 총소비가 늘었다는 관찰이다.

위키백과 — Jevons paradox

🟡

원문: 도구가 일을 쉽게 만들면 사람은 덜 일하지 않는다. 더 많은 일을 한다(제번스 역설) → 확인: 제번스 역설은 자원 총소비에 관한 개념이다. 평균 노동자의 노동시간은 150년 동안 크게 줄었다.

제번스 역설은 수요가 가격에 탄력적일 때 일어난다. 경제학자 에릭 브리뇰프슨은 이 조건이 맞는 직종에서 고용이 늘 수 있다고 본다. 그가 든 예는 영상의학과 의사·번역가·코더다. 일의 총량이 늘 수 있다는 확장은 이 논의와 맞는다.

개인이 덜 일하지 않는다는 역사 서술은 Our World in Data 자료와 어긋난다. 평균 노동자의 노동시간은 지난 150년 동안 크게 줄었다.

위키백과 — Jevons paradox · Our World in Data — Working Hours

저자 자기 보고 수치

아래 다섯 수치는 저자 한 사람의 경험치다. 측정 방법·표본·기간이 원문에 없다. 외부 자료로 확인할 수 없다. 수치는 모두 원문에 있다.

⚠️

금붕어 비평 세션(Step 6)의 제안 중 약 30%가 가치 있다(저자 경험)

원문도 '일화로(Anecdotally)'라고 밝힌다.

⚠️

말단 디렉터리 README를 AI가 쓰면 약 50%가 틀린다(저자 경험)

'틀림'의 기준이 원문에 없다. 사람이 고치는 데 5~10분이 걸린다는 수치도 같은 성격이다.

⚠️

비개발자가 노트북으로 쓴 설계 문서는 대개 70~80% 맞다(저자 경험)

검토자가 저자 본인이다. 표본 수가 원문에 없다.

⚠️

Gemini와의 설계 세션이 2~3일 이어진 적이 있다(저자 경험)

세션 길이 기록이 공개되지 않았다.

⚠️

수백만 줄 코드베이스도 README 계층을 만드는 데 약 일주일이면 된다(저자 경험)

원문도 '(거의) 코드베이스 크기와 무관하게'라고 단서를 단다. 팀 규모·디렉터리 수 조건이 없다.

맥락: 같은 생각의 선행 사례

설계 문서를 코드보다 앞세우는 생각은 원문 발행(2026-04-27) 전에 제품으로 나와 있었다. AI IDE Kiro는 2025-07-14 발표에서 요구사항·설계 문서·작업 목록을 차례로 만든 뒤 에이전트가 구현하는 '스펙 주도 개발'을 내세웠다. GitHub는 2025-09-02 오픈소스 도구 Spec Kit을 내놓았다. Spec Kit은 스펙을 도구와 에이전트가 쓰는 진실의 원천으로 둔다.

원문이 EGM 고유의 단계로 내세우는 것은 맥락 0 세션(금붕어)으로 문서를 시험하는 절차다.

Kiro 발표 글 · GitHub 블로그 — Spec Kit

판정하지 않은 의견·예측


원본 (완역)

Elephants, Goldfish and the New Golden Age of Software Engineering
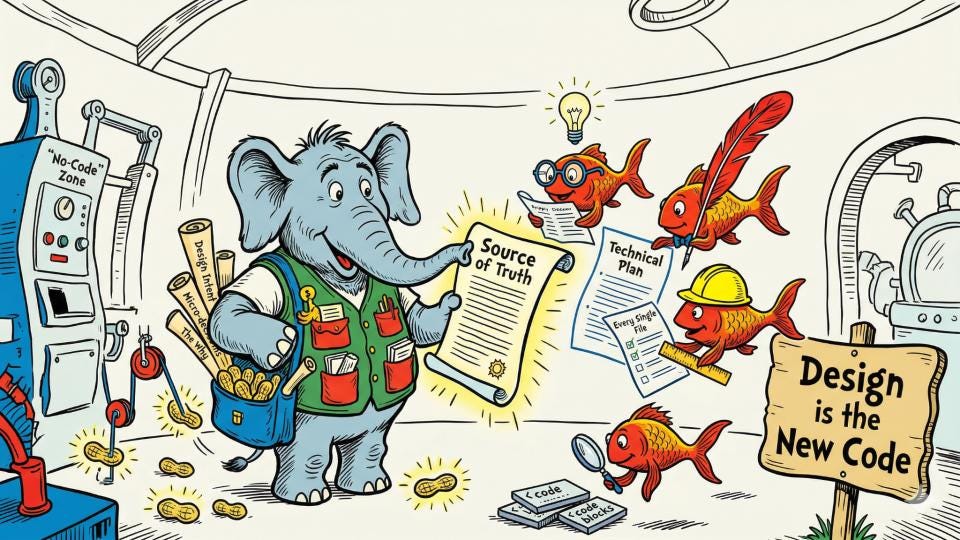
코끼리가 'Source of Truth' 두루마리를 들고 조끼 주머니에 'Design Intent'·'Micro-decisions'·'The Why' 두루마리와 땅콩을 넣었다. 금붕어 넷이 'Technical Plan'과 'Every Single File' 체크리스트를 검사한다. 왼쪽 'No-Code Zone' 기계, 오른쪽 'Design is the New Code' 표지판

업데이트: 2026-10-21 — Google이 나와 우리 팀에게, 이 방법론을 따르려고 사내에서 쓰는 AI 코딩 어시스턴트 플러그인을 오픈소스로 공개하도록 허락했다. 자세한 내용은 여기서 볼 수 있다: https://egm.dev

들어가며

2026년 4월 이 글을 쓰는 지금, 생성형 AI 도구, 특히 대규모 언어 모델(Large Language Models, LLM)이 우리가 일을 생각하고 해내는 방식을 송두리째 바꾸고 있다는 것은 이미 분명하다. 이것은 소프트웨어 엔지니어링만의 변화가 아니다. 모든 직업 하나하나에 닿는 변화다. 이 글은 지난 한 해에 대한 내 기록이다 — 나와 우리 팀들이 걸어온 여정, 우리가 얻은 쓰라린 교훈, 그리고 다음에 올 것에 대한 내 개인적인 견해.

이미 AI 코딩 도구로 일하고 있든, 이제 막 AI 챗봇을 이리저리 건드려 보기 시작했든, 이 글에서 무언가를 얻어 가기를 바란다. 일에서 AI가 맡는 역할을 생각하는 데, 그리고 AI를 써서 자신을 더 생산적이고 가치 있는 사람으로 만드는 방법을 생각하는 데 도움이 될 무언가를.

출발점이 어디든, 두 가지를 크고 분명한 목소리로 말해 두겠다:

  1. 이 관찰들은 내 개인적인 관점을 반영한다. 이 도구들로 성공하는 길은 여럿이니, 폭넓게 탐색하고 자신에게 가장 잘 맞는 방법을 찾아야 한다. 사람마다 결과는 다를 수 있다.
  2. 변화의 속도가 이토록 무섭다 보니, 한 해만 더 지나도 이 말들은 낡은 것이 될 수 있다. 건강한 회의심을 품고 읽어 주기 바란다.

이 글의 구성

이 글은 크게 세 부분으로 되어 있다.

1부에서는 우리 대부분이 AI 도구를 — 기본적인 챗봇까지 포함해 — 잘못 쓰고 있다고 주장한다. 그리고 당신이 누구든, 무엇으로 먹고살든 가치가 있기를 바라는 다른 접근법을 제안한다. 이 부분은 모두를 위한 것이고, 뒤에 이어지는 내용의 토대가 된다.

2부에서는 1부의 기본 원칙을 소프트웨어 작성이라는 작업에 성공적으로 적용하는 방법을 더 자세히 다룬다. 특히 우리가 코끼리-금붕어 모델(Elephant-Goldfish Model, EGM)이라고 부르는 작업 모델을 소개한다. 이미 AI 코딩 도구를 쓰고 있다면 이 부분의 많은 내용이 익숙하겠지만, 그래도 처음 접하는 알맹이가 몇 개는 있으리라고 생각한다. 2부를 읽는 데 소프트웨어 엔지니어일 필요는 없지만, 거기서 설명하는 작업 방식은 소프트웨어를 써 온 내 경험에서 곧바로 나온 것이다.

마지막으로 3부에서는 (변화 속도를 생각하면 아마 현명하지 못하게도) 예언의 영역에 발을 들인다. 업계는 무서운 속도로 진화하고 있지만, 우리가 결국 살게 될 미래가 구체적으로 어떤 것이든 그에 대비하는 데 쓸 수 있는 패턴이 이미 몇 가지 떠오르고 있다고 생각한다.

1부: 장난감이 아니라 도구다

10배의 생산성 향상은 AI 모델을 쓰는 엔지니어만의 것이 아니다. 당신의 것이기도 하다. 지금 도구를 쓰는 방식을 간단히 바꾸기만 해도 오늘은 더 빨리, 내일은 훨씬, 훨씬 더 빨리 갈 수 있고, 결과물의 품질도 좋아진다. 이것은 낚시성 제목이 아니다. 단순한 진실이다

차를 사 보자!

새 차를 사고 싶다고 해 보자. 이 문제에 어떻게 접근하겠는가?

우리 대부분은(얼마 전까지의 나를 포함해) 이 차에 대해 자기에게 중요해 보이는 것들을 곰곰이 생각한 다음, 가장 좋아하는 LLM 도구를 리서치 모드로 열고 이렇게 말할 것이다:

“새 차를 사고 싶다. 내가 사고 싶은 차에 대해 생각해 둔 것을 전부 여기 적는다. <여기에 생각해 둔 것을 무엇이든 넣기> 인터넷을 샅샅이 뒤져서, 내가 고려해야 할 차와 사야 할 차에 대해 세상에서 가장 포괄적이고 인상적인 보고서를 만들어라. 시간은 얼마든지 써도 된다.”

20분 뒤면 꽤 인상적으로 보이는 보고서가 나오고, 거기에는 그럴듯하게 들리는 추천이 담겨 있을 것이다. 우리는 스스로 얼마나 영리한지 흐뭇하게 고개를 끄덕이고는, AI가 승인한 새 차를 가장 좋은 조건에 살 곳을 찾아 인터넷을 뒤지기 시작할 것이다.

그리고 우리는 잘못했다.

아주 강력한 도구를 장난감처럼 썼고, 장난감 같은 결과를 얻었다. 그러면.. 차를 사는 데 AI를 어떻게 써야 할까?

1단계: 승리는 준비를 사랑한다

올바른 차를 사려던 우리의 가상 원정이 실패할 운명이었던 것은, 기계가 우리를 대신해 성공할 수 있도록 제대로 준비시키지 않았기 때문이다. 우리는 기계에게 심문관이 아니라 연구원 역할을 시켰다.

고생하는 우리 AI 어시스턴트에게 원래 줬어야 했던 프롬프트는 이것이다:

“새 차를 사고 싶습니다. 큰돈이 드는 일이라 충분히 알아보고 잘 따져 본 결정을 내리는 것이 아주 중요합니다. 새 차에 무엇이 필요한지 생각해 봤지만, 중요한 측면을 놓치고 있다고 확신합니다. 지금까지 생각해 낸 것을 말씀드릴 테니, 당신이 할 일은 제가 그만하라고 할 때까지 계속 명확히 하는 질문을 던지는 것입니다. 우리가 함께 할 일은 이 결정의 중요한 가장자리를 빠짐없이 탐색하는 것입니다. 끝났다고 제가 말할 때까지 계속 제 가정을 의심하고, 중요한 점을 명확히 하도록 저를 몰아붙여 주세요. 지금까지 생각해 낸 것은 이렇습니다: <여기에 앞의 문단 넣기>”

이어지는 15~20분 동안 AI가 던지는 질문과 반박에 답하라. 가끔은 모델에게 “네 생각은 어떤가?”라고 물어라. 동의하지 않으면 논쟁하라. 다만 반드시 이기려고가 아니라 배우려고 논쟁하라.

참고: 모델이 “정말 좋은 지적이야! 넌 천재야!” 같은 쓸모없는 말을 하기 시작하면, 아첨의 소용돌이에 빠진 것이다. (이 모델들이 모두 “친절하고 도움이 되라”는 지시를 받는 데서 오는 피할 수 없는 결과다.) 대개는 진짜로 도움이 된다는 게 무슨 뜻인지 상기시키면 모델을 이 고리에서 끌어낼 수 있다:

“네가 내게 동의할 때 너는 도움이 되고 있지 않다. 너는 내 생각에 도전하고 내 문제의 가장자리를 생각하도록 나를 몰아붙일 때 가장 도움이 된다”

모델이 지나치게 맞장구를 치기 시작할 때마다 내가 꺼내는 단골 대답이 이것이다.

15~20분이 지나면 사고 싶은 이상적인 차에 대해 훨씬 풍부한 설명을 갖게 된다. 처음의 한 문단이 2~3쪽으로 불어나 있을 것이다. 여기서 멈추고 이 새 설명을 AI에게 줘도 이미 훨씬 나은 결과를 얻는다. 하지만 우리는 더 잘할 수 있다.

이제 2단계로 갈 준비가 됐다.

2단계: 신뢰하되 검증하라

문제를 철저히 설명하는 것은 훌륭한 답을 얻는 레시피의 앞쪽 절반일 뿐이다. 다음 단계는 모델이 알려 주는 것이 쓸모 있으면서 검증 가능하게 참인지 확인하는 것이다.

지금 채팅 세션을 이어 가면서 이 프롬프트를 줘라:

“질문 고맙다. 하지만 이제 우리의 설명은 완성됐다고 생각한다. 나는 이 설명을 한 번도 같이 일해 본 적 없는 연구원에게 넘길 것이다. 그가 보고서를 만든 뒤에 그 품질을 믿을 수 있다는 걸 알아야 한다. 이제 네가 회의적인 전문 팩트체커의 페르소나를 맡아 주면 좋겠다. 그의 보고서에서 무엇을 찾을 수 있어야 그의 작업이 철저하고 정확했다고 확신할 수 있을지, 그 모든 것에 대해 너와 대화하고 싶다. 어떤 종류의 링크? 인용? 등등.. 그에게 이 리서치를 부탁할 기회는 단 한 번뿐이고 후속 질문을 할 기회도 없으니, 내가 그의 작업을 어떻게 평가할지 아주 분명하게 전해야 한다. 지금 이것을 논의하자. 합격 기준 만들기가 끝나면 알려 주겠다.”

이제 앞 단계의 인터뷰 과정을 똑같이 되풀이하되, 이번에는 최종 결과물의 품질을 어떻게 채점할지에만 집중한다. 앞에서처럼 이 단계에도 15~20분쯤 쓸 거라고 예상하라.

끝나면 보고서의 채점 기준표에 해당하는 텍스트가 2~3쪽 더 생겨 있을 것이다. 이제 질문과 평가 기준 양쪽에 대해 더 완전한 설명을 갖췄으니 마지막 단계로 갈 준비가 됐다.

3단계: 이득

LLM으로 새 세션을 열고 딥 리서치 모드 같은 것으로 설정하라. 그리고 이렇게 말하라:

“깊이 생각해 주었으면 하는 주제가 하나 있다. 쓸 수 있는 도구는 무엇이든 써서 이 질문에 철저히 답하라. 리서치 주제와 함께 내가 네 최종 보고서의 품질을 평가할 때 쓸 구체적인 기준도 주겠다. 네 목표는 질문에 철저히 답하고 모든 평가 기준을 너끈히 통과하는 최종 결과물을 만드는 것이다.

내가 리서치해 주기를 바라는 주제에 대한 설명은 이렇다:

— — — — — — -

<여기에 1단계의 텍스트 넣기>

— — — — — — -

네 결과물의 품질을 평가할 기준은 이렇다:

— — — — — — —

<여기에 2단계의 텍스트 넣기>

— — — — — — -”

이제 모델이 필요한 만큼 오래 딥 리서치를 돌리게 두면 된다. 그리고 한 번에 끝내는(one-shot) 프롬프트로 하려 할 때보다 훨씬 나은 결과물을 얻으리라고 자신해도 좋다.

판단력에 관한 한마디

우리 중 누구도 평소 하는 일이 차를 사는 것은 아니다(물론 그게 정말 당신의 본업이라면 아주 멋진 직업을 가진 것이다!). 직무가 무엇이든(영업, 마케팅, 재무 등) 우리는 모두 같은 일을 하라고 고용됐다 — 사업을 위해 더 많은 가치를 만들어 내도록 탁월한 판단력을 발휘하는 것.

회사는 우리가 꾸준히 보여 주는 판단의 질과 영향력으로 우리의 가치를 정한다.

경력 초기라면, 고용주는 우리가 자기 업무 영역에서 좋은 판단력을 빠르게 익힐 능력이 있다는 데 돈을 건 것이다. 경력 후반이라면, 회사는 우리가 이미 쌓아 온 판단력을 회사를 위해 발휘하고 다른 사람들이 각자의 판단력을 익히도록 도우라고 우리를 고용한 것이다.

이 모델들은 (적어도 이 글을 쓰는 시점에는) 이런 종류의 판단을 할 수 없다 — 겉보기에 판단을 닮은 단어 열을 만들어 내는 데는 탁월하지만. 판단을 기계에 외주 주는 실수를 하지 마라.

미래의 나를 가속하기

이 절의 단계들은 판단력을 아주 빠르게 훨씬 큰 생산성으로 바꾸는 데 도움이 된다. 하지만… 진짜 가치는 사실 시간이 지나면서 복리로 쌓인다..

이 단계들에서 만든 전체 설명, 합격 기준, 최종 결과물을 쉽게 찾을 수 있는 곳에 저장하라. (공유 드라이브, NotebookLM 등.) 시간이 지나면 엄청난 양의 추론과 이력이 쌓이고, 다른 문제를 두고 모델과 나눌 미래의 대화에서 그것을 지렛대로 쓸 수 있다.

참고: 대화 전체를 저장할 필요는 없다. 이 세 가지 산출물이면 충분하고, 나머지는 대부분 토큰 잡음으로 드러난다

왜 이렇게 하는가? 이제 과거의 내 판단, 혹은 팀의 집단 지혜와 대화할 수 있기 때문이다!

“우리는 왜 이 결정을 이런 식으로 내렸나? X에 대한 우리의 사고 과정은 어땠나?” 등등..

새 팀원을 온보딩하거나 미래의 결과물을 과거의 추론에 비춰 시험하는 일이 얼마나 쉬워질까? 프로젝트나 팀, 오래 이어지는 프로그램의 궤적을 재구성하는 일은 얼마나 쉬워질까?

오늘 이렇게 하기 시작하면 속도와 품질은 앞으로 빠르게 복리로 불어난다. 미래의 나는 지금의 나와는 알아볼 수 없을 만큼 더 생산적이 된다.

2부: 코끼리와 금붕어

2025년 여름, 나는 회사에서 업무상 문제를 하나 안고 있었고, 그것을 푸는 데 도움이 될 작은 도구를 (AI의 도움을 잔뜩 받아) 만들었다. 그 작은 도구는 팀 동료들에게 쓸모가 있었고 — 나로서는 놀랍게도 — 다른 많은 사람에게도 쓸모가 있었다. 다른 엔지니어들이 찾아와 이 도구에 새 기능을 기여하고 싶다고 했고(나는 고맙게 받아들였다), 몇 달 만에 10만 명이 넘는 구글러가 비슷한 모양의 자기 문제를 풀려고 이 도구를 정기적으로 쓰게 됐다.

AI 코딩 어시스턴트 없이도 이렇게 빨리 가면서 수십 명의 기여를 안전하게 받아들이고, 그러면서도 보안·프라이버시·신뢰 기준을 지키는 일이 가능했으리라고는 생각하지 않는다. (내 경우에는 Google Antigravity와 Gemini를 쓴다.)

이렇게 일하는 것은 놀랍지만, 머지않아 무서운 사실 하나를 금세 깨닫게 된다.

조심하지 않으면, 우리는 그저 코드를 더 빨리 쓰는 게 아니다. 우리는 실수를 대량 생산하고 있다.

AI를 써서 빨리 가는데 신호 대 잡음비를 높게 유지하지 못한다면, 생산성은 사실 뒷걸음질하고 있는 것이다. 나쁜 코드가 생성되는 속도가 생산적인 코드가 생성되는 속도보다 크면, 프로젝트는 결국 읽을 수도 유지보수할 수도 없는 자기 슬롭(slop)의 무게에 짓눌려 무너진다.

그 뒤 몇 주, 몇 달에 걸쳐 우리는 더 나은 방법을 찾았다. 하지만 먼저 사람만으로 이뤄지는 “코더”의 시대가 빠르게 끝나 가고 있다는 사실을 받아들여야 했다.

세 번의 “아하” 순간

문제의 크기가 정말로 와닿은 것은 유난히 답답했던 어느 오후였다. 나는 AI로 새 기능을 구현하고 있었다. 세션에 들어간 지 한 시간, 세부 사항 깊숙이 파묻혀 있을 때 모델이 그냥 뻗어 버렸다.

새 세션을 시작하자 백지 상태였다. 앞선 한 시간의 작업을 전혀 기억하지 못했다. 수백 줄의 코드를 먹여 가며 이 몹시 복잡한 작업에 기계를 다시 부트스트랩하는 일은 지루하고, 토큰을 많이 잡아먹고, 엄청나게 짜증 나는 일이었다.

그것이 아하 순간 #1이었다. 만약 내가 그저 내 의도와 현재 진행 상태를 설명하는, 명확하게 쓴 문서 하나를 유지했다면, 다시 부트스트랩하는 데 30초면 됐을 것이다. (“이 문서를 읽어라. 문서가 가리키는 코드를 읽어라. 우리가 어디까지 왔는지 말하고, 계속하자.”)

그래서 그렇게 해 봤다. 맥락을 되찾았다. 그런 다음 AI에게 구현을 마무리하라고 했다.

문제 해결! 그런데.. AI는 곧바로 궤도를 벗어나, 내가 요청한 적 없는 방향으로 질주하고, 있지도 않은 API를 환각으로 지어내고, 우리 시스템에서는 전혀 말이 안 되는 아키텍처 선택을 했다.

그것이 아하 순간 #2였다. AI 모델은 비위를 맞추고 싶어 안달이라서, 아주 엄격한 가드레일을 세워 두지 않으면 신이 나서 절벽 너머로 질주한다.

하지만 진짜 깨달음은 몇 주 뒤, 완전히 새로운 기능을 시작할 때 찾아왔다. AI가 시스템을 이해하게 하려고 소스 코드를 먹일 필요가 없다는 걸 깨달았다. 설계 문서만 먹이면 됐다.

그것이 아하 순간 #3으로 이어졌고, 그것은 간단히 이렇다:

sizeof(docs) << sizeof(code)

수만(혹은 수십만) 줄의 날것 그대로의 코드를 억지로 읽고 해석하게 하는 것보다, 평이한 영어로 쓴 설계 문서로 AI에게 맥락을 주는 편이 훨씬 훨씬 싸고, 빠르고, 믿을 만하다.

사라지는 코드

이것이 왜 그렇게 중요한지 이해하려면, 오늘날 우리가 소프트웨어를 만드는 방식을 들여다봐야 한다.

역사적으로 설계 판단 — 시스템의 “왜”와 “어떻게” — 은 두 곳에 놓인다. 설계 문서, 그리고 코드 자체. 사람이 코드를 쓸 때는 로직 안에 미세한 결정들의 흔적을 남긴다.

하지만 AI가 코드를 쓴다면, 사람은 더 이상 그 미세한 결정들을 내리지 않는다. 코드가 쓰이기 전에 그 설계 판단들을 모두 설계 문서 쪽으로 “왼쪽 이동(shift left)”하도록 강제하지 않으면, 그렇게 나온 시스템은 최종적으로 그것을 책임지는 사람에게 전혀 이해할 수 없는 것이 된다.

우리는 지금 문턱에 걸친(liminal) 상태에 있다. 여전히 엄밀함이 필요하기 때문에 여전히 코드가 필요하다. 하지만 사람이 100% 검토하는 코드는 사라져 가는 중간 단계다.

내가 보기에 우리는 둘 중 한 곳에 도착할 것이다. (1) 모델이 너무 많은 코드를 만들어 내서 사람이 그것을 전부 검토하는 일이 현실적으로 불가능해지거나, (2) 모델이 아예 바이너리를 직접 만들어 내기 시작해 코드를 통째로 건너뛰거나. 하지만 어느 쪽이 맞든 상관없다. 눈보라처럼 쏟아지든 바이너리로 나오든, 코드는 우리에게 불투명해질 것이고, 코드가 불투명해지면 의미 있는 산출물은 설계뿐이다.

설계가 새로운 코드다.

코끼리-금붕어 모델(EGM) 소개

시간이 지나며 팀은 간단하면서도 아주 효과적인 운영 틀을 만들어 냈다. 나는 그것을 코끼리-금붕어 모델이라고 부른다.

이 모델은 우리가 맥락을 어떻게 쌓고 어떻게 시험하는지에 관한 아주 단순한 비유에 바탕을 둔다:

  • 코끼리: “코끼리는 절대 잊지 않는다.” 프롬프트를 듬뿍 받아 맥락이 풍부한 AI 세션, 그리고 그 세션이 작성을 도와 나온 설계 문서가 코끼리다. 코끼리는 조직의 모든 지식, 미세한 결정, 모델과 벌인 논쟁, 그 기능의 전체 이력을 품고 있다.
  • 금붕어: 기억이 전혀 없는, 완전히 새롭고 깨끗한 AI 세션. 금붕어는 바로 눈앞에 놓인 것만 정확히 안다.

새 기능마다 따르는 우리의 단순한 프로세스는 이렇다: 코끼리를 먹이고, 금붕어로 시험하라.

페이즈 1: 코끼리 키우기(아직 코드는 없다)

여기서 목표는 코드를 한 줄이라도 쓰기 전에 기능과 평가 기준을 함께 설계하는 것이다.

1단계: 맥락 불러오기

AI 도구로 새 세션을 열고 관련 설계 문서나 소스 트리를 가리켜라. 무엇을 배웠는지 상위 수준에서 설명해 달라고 하라.

왜? 1분 차에 시스템을 잘못 이해하면, 10분 차에 끔찍한 코드를 쓸 것이기 때문이다. 이해가 틀렸으면 즉시 바로잡아라.

완전히 새 프로젝트를 처음부터 시작한다면 이 단계는 필요 없다. AI를 부트스트랩해 넣을 이력도 맥락도 없기 때문이다.

2단계: “코드 금지” 규칙

엔지니어는 코드 쓰기를 좋아한다. AI도 코드 쓰기를 좋아한다. 이 충동과 적극적으로 싸워야 한다. AI에게 이 프롬프트를 줘라:

“나는 네가 코드를 만들기를 원하지 않는다. 우리는 코드를 만들지 않을 것이다. 코드를 만들고 싶은 충동을 참아라. 대신 우리는 설계 토론을 할 것이다. 지금부터 기능 하나를 설명하겠다. 나에게 명확히 하는 질문을 던지고 내 가정에 도전하라. 내 말을 그냥 받아들이지 마라.”

이루려는 것을 AI에게 설명한 다음, 사람에게 하듯 말을 걸어라. 20~30분 동안 주거니 받거니 대화하라. AI가 환각을 일으키면 그것을 바로잡아 줄 파일을 가리켜라. AI와 제대로 논쟁하라. 이 모델들은 탁월한 심문관이니, 풀려는 문제의 설명과 가장자리에 대해 당신의 생각을 정말로 밀어붙이게 하라.

이 단계는 기능상 앞에서 가상의 차를 살 때 설명한 주거니 받거니 인터뷰 과정과 같다. 이 단계의 요점은 풀려는 문제에 대한 철저한 설명을 만드는 것이다.

이루려는 것을 선명하게 말할수록 결국 나오는 결과물도 좋아진다.

3단계: 아첨꾼 다잡기

AI 모델은 도움이 되도록 훈련받는데, 그 탓에 참을 수 없는 아첨꾼이 되는 일이 잦다. AI가 어려운 질문을 멈추고 그냥 “좋은 생각이야, 데이브!”라고만 한다면, 억지로라도 비평가 모드로 되돌려야 한다. 이렇게 말하라: “너는 도움이 되고 있지 않다. 네 최고이자 최선의 쓰임은 내 생각에 도전하는 것이다.”

프로 팁: AI에게 그냥 “왜 그렇게 생각하나?”라고 묻는 것이 가장 좋은 친구다. 모델이 환각 고리에서 번쩍 빠져나오는 경우가 많다.

4단계: 기술 제안 초안

문제를 완전히 설명했다는 만족이 들면, 이제 가능한 해법을 놓고 토론을 시작할 때다.

AI에게 산문과 블록 다이어그램으로 구현을 제안하라고 하라. 짧은 의사코드 블록은 괜찮지만, 글로 쓴 텍스트를 요구하라. 탄탄한 접근법에 정착할 때까지 AI와 논쟁하라.

첫 설계를 AI에게 제안하게 하는 것이 아주 중요하다. 그래야 AI가 당신의 문제를 잘 이해하는지 알 수 있다.

반대로 당신이 첫 설계를 제안하고 AI에게 반응하게 하면, 거의 틀림없이 사각지대를 몇 군데 놓친다. 모델에게 이것을 시키는 방법은 많지만, 내가 가장 자주 쓰는 프롬프트는 이것이다:

“코드베이스에 대한 네 이해와 우리가 논의한 내용을 바탕으로, 이 기능을 실제로 구현할 기술적 방안의 초안 제안을 내게 줬으면 한다. 코드를 원하는 게 아니다. 내 시스템을 이해하고 있음을 보여 주는 산문을 원한다. 도움이 된다고 생각하면 짧은 의사코드 블록은 괜찮지만, 명확하게 쓴 텍스트와 블록 다이어그램을 훨씬 선호한다.”

초안은 (적어도 조금은) 틀릴 것이다. 명확히 하는 질문을 던져라(예: “왜 그 패턴을 골랐나? 나는 시스템이 X처럼 동작한다고 생각했는데…”). 탄탄한 기술적 접근법에 정착할 때까지 AI와 논쟁하라.

모델이 시스템에 대해 무언가를 환각하면, 그 이해를 바로잡아 줄 파일을 가리켜라. “아니요. 그렇게 동작하지 않는 것 같아요. auth.py를 읽어 주세요. (또는 AUTH.md든 뭐든)”

기술 제안을 만드는 이 주거니 받거니는 몇 시간이 걸릴 수도 있다. Gemini와 중요한 결정을 두고 토론하느라 2~3일씩 이어진 세션도 있었다.

이 주거니 받거니를 서두르지 마라. 서두르면 후회한다.

페이즈 2: 코끼리 가르치기

이제 코드의 절대적인 진실 공급원(source of truth)이자 가드레일 역할을 할 마크다운 문서를 만든다. AI에게 문서 전체를 한 번에 쓰라고 하지 마라. 현재 모델들은 한 번에 내놓는 출력에 토큰 한도가 있기 때문이다. 같은 채팅 세션 안에서 반복하며 쌓아 올려라.

우리가 가장 쓸모 있다고 찾아낸 절들의 구조와 순서는 이렇다. 이 문서를 한 번에 끝내려고(one-shot) 하지 마라. 각 절을 따로 써라.

  1. 문제: AI에게 사업상 문제를 평이한 영어로 설명하게 하라. 아마 3~5문장이면 충분할 것이다. 지나가며 읽는 사람이 무엇을 이루려는지 이해할 수 있을 만큼이면 된다.
  2. 기술 계획: 큰 구성 요소들과 그것들이 어떻게 맞물리는지를 전문 용어를 줄여 설명하게 하라. 말이 된다면 주요 구성 요소의 블록 다이어그램을 넣어라. 이 절의 목표는 설명하는 산문이다.
  3. 대안: 페이즈 1에서 고려했지만 배제한 아이디어를 기록하라. 고려했다가 기각한 주요 결정이 이 절에서 빠짐없이 다뤄지도록 하라. 이것들은 앞으로의 환각과 논쟁을 막는 중요한 가드레일이 된다.
  4. 상세 구현: 이 문서에서 가장 긴 절이 된다. 아주 상세한 단계별 구현 계획을 담아야 한다. 새로 만들거나 바꿀 파일 하나하나 전부와 그 이유를 AI가 열거하도록 요구하라. 이것이 결정적이다. 이렇게 하면 구현에 들어갔을 때 AI가 궤도를 벗어나지 않도록 붙잡아 두는 데 도움이 된다.

이 파일을 트리에 저장하라. 이것이 새 기능의 첫 산출물이고, 이제 당신의 새 소스 코드다.

페이즈 3: 금붕어 프로토콜

설계 문서가 정말로 좋은지, 아니면 “코끼리” AI 세션에 쌓인 맥락에 기대고 있을 뿐인지 어떻게 알 수 있을까?

금붕어로 시험한다.

5단계: 이해도 시험

완전히 새로운 빈 AI 세션(금붕어)을 시작하라. 마크다운 문서를 주고 이렇게 말하라:

“이 문서와 문서가 가리키는 파일들을 읽어라. 이 문서가 무엇을 이루려 하는지, 그리고 이 기능과 관련해 내 시스템이 현재 어떻게 동작하는지 말하라.”

금붕어가 오직 그 문서와 문서가 가리키는 파일만으로 시스템을 설명하지 못한다면, 문서에 맥락이 빠져 있는 것이다. 세부 사항을 보태고 통과할 때까지 되풀이하라. 이 고리를 건너뛰지 마라. 금붕어 시험을 통과한 문서는 슬롭을 막는 중요한 방어막이 된다.

6단계: 비평가 리뷰

금붕어 세션을 하나 더 시작하라:

“전문 기술 리뷰어 역할을 맡아라. 이 설계 문서와 문서가 가리키는 모든 파일을 읽어라. 내가 놓친 것, 잘못된 가정, 빠뜨린 엣지 케이스, 고려했어야 하는데 하지 않은 것을 전부 말하라. 네가 찾아내는 실수와 모호함 하나하나가 너를 더 도움이 되고 쓸모 있게 만든다.”

경험상, 제안의 약 30%가 아주 가치 있다 — 이것만으로도 할 가치는 충분하다. 그에 맞게 파일을 고쳐라.

권고와 질문이 꾸준히 “트집 잡기” 범주에 들어가기 시작할 때까지 같은 과정을 되풀이하라.

7단계: 구현 준비도 점검

새 금붕어를 시작하고 이렇게 물어라:

“너는 우리 코드베이스에 익숙한 숙련된 소프트웨어 엔지니어다. 이 문서와 문서가 가리키는 파일들을 읽고 말하라: 이 기능을 첫 시도에 성공적으로 구현하는 데 필요한 정보가 이 문서에 정말로 전부 들어 있는가?”

질문을 하면 문서 안에서 답하라. 중요한 누락이나 풀리지 않은 모호함이 없다고 만족할 때까지 같은 과정을 되풀이하라.

마지막으로, 진짜 사람에게 보여 주고 리뷰와 승인을 받아라. (혼자 일한다면 이 선택지가 없을 수도 있다. 최선의 판단을 따르라.)

페이즈 4: 구현

8단계: 가드레일 안에서 코딩하기

이제야, 그리고 오직 지금에야 코드를 쓴다. 완성된 설계 문서를 AI에게 건네고 이렇게 말한다:

“이 설계 문서와 문서가 가리키는 파일들을 읽어라. 설명된 대로 기능을 구현하라. 계획을 정확히 따르라.”

문서가 모든 파일과 모든 변경을 명시적으로 나열하기 때문에, AI는 훨씬 높은 품질의 코드를 만들어 낸다. 구현 세션 도중에 AI가 헛돌거나 뻗어 버려도, 새 세션을 열어 설계 문서를 건네고 문서와 문서가 가리키는 모든 파일을 읽으라고 하면 곧바로 다시 일할 수 있다.

9단계: “독한” 코드 리뷰

코드가 다 되면 그것을 다시 AI에게 먹여라. 코드가 형편없는 구석을 모조리 찾으라고 하라. 나는 실제로 이렇게 말한다:

“이 코드의 품질이 형편없다는 강한 직감이 들어요. 갈기갈기 찢어발기고, 이 코드가 구린 점을 전부 말해 주세요.” (그렇다, 이게 내 실제 프롬프트다)

주석 없이 10줄을 넘긴 곳은 전부 표시하라고 하라. 엄격한 가독성을 요구하라.

비평이 사소해질 때까지(혹은 사라질 때까지) 같은 과정을 되풀이하라.

지금의 현실에서 부트스트랩하기(또는, “코끼리에게 땅콩과 건초 먹이기”)

이 이야기를 다른 엔지니어들에게 하면 그들이 맨 먼저 하는 말은 이렇다. “데이브, 새 프로젝트라면 그거 좋지. 그런데 내 코드베이스는 수백만 줄이야. 그 전부에 대해 설계 문서를 쓸 시간은 없어. 모놀리스를 위해 코끼리를 훈련시킬 수는 없다고.”

사실은 할 수 있다. 그리고 코드베이스가 아무리 크든 (거의) 상관없이 일주일쯤 걸린다.

요령은 코끼리를 먹이는 법을 이해하는 것이다. 비유를 좀 더 억지로 늘려 보자면, 소스 코드라는 정글 전체를 한꺼번에 AI에게 먹이려 하면 AI는 목이 막힌다. 맥락을 잃고, 헷갈리고, 환각을 일으킨다. 대신 땅콩과 건초를 먹여야 한다 — 작고, 영양가 높고, 압축된 맥락 조각들. (그렇다. 여전히 엔지니어다. 끔찍한 말장난까지 다 포함해서.. 하지만 적어도 이걸 보면 이 글을 사람이 썼다는 건 알 수 있다.)

그 “땅콩과 건초”가 README.md 파일이다. 재귀적 요약 과정을 통해 그것들을 거둬들이는 힘든 일은 AI에게 시키기만 하면 된다:

  1. 소스 트리의 잎에서 시작하라. 개발자마다 디렉터리 묶음을 하나씩 맡겨라.
  2. 땅콩 만들기: 각자 AI에게 디렉터리를 가리키고 이렇게 말하게 하라: “이 디렉터리의 파일들을 읽고 README.md라는 새 파일을 만들어라. 이 파일은 (a) 이 디렉터리와 그 안에 든 파일들의 목적을 설명하고 (b) 디렉터리 안의 파일을 하나씩 열거하며 각 파일의 기능을 짧게 설명해야 한다”
  3. 사람의 검증: 잎 디렉터리에서는 AI가 기댈 것이 코드뿐이라 약 50%는 틀린다. 맡은 엔지니어가 5~10분을 들여 파일 내용을 고친다.
  4. 건초 말아 올리기: 잎이 끝나면 한 단계 위로 올라간다:
    “내 아래 모든 하위 디렉터리에 있는 README.md 파일을 전부 읽고, 그다음 이 디렉터리에 있는 코드만 읽은 뒤, 여기에 README.md라는 파일을 만들어 주세요. 그 정보를 바탕으로 이 파일은 (a) 이 디렉터리와 그 안에 든 파일들의 목적을 설명하고 (b) 디렉터리 안의 파일을 하나씩 열거하며 각 파일의 기능을 짧게 설명해야 합니다”
  5. 계속 위로 올라가라 — 한 단계씩 — 프로젝트 루트에 닿을 때까지.

다 끝나면 훌륭한 맥락의 위계가 생긴다 — 그것이 “땅콩과 건초”다. 프로젝트 루트에서 새 세션을 열고 트리 안의 README만 코끼리에게 먹이면, 코끼리는 코드베이스를 (거의) 즉시 이해하고, 소스 파일을 하나하나 읽어야 할 때보다 컨텍스트 윈도를 훨씬 적게 쓴다.

완벽하지는 않겠지만, 놀랄 만큼 잘 이해한다. 주요 서브시스템과 설계 패턴을 믿을 만하게 짚어 낼 수 있을 것이고 — 변경을 하러 들어갈 때 그것은 엄청난 도움이 된다.

README는 얼마나 오래 필요한가?: README는 모든 코드 파일이 적어도 하나의 문서에서 언급(그리고 가볍게 설명)될 만큼 설계 문서가 쌓일 때까지만 있으면 된다. 파일 커버리지가 100%가 되면 README는 지워도 된다(안 지워도 된다. 당신 마음이다). 새 애플리케이션에 코끼리-금붕어 모델 프로세스를 쓰고 있고 설계 문서를 엄격하게 관리한다면, 이 README들은 아예 필요 없을 것이다.

거기서부터는 위의 코끼리-금붕어 프로세스로 새 기능의 설계 문서를 쓰기 시작하면 된다.

보너스 기능: 즉시 온보딩

소스 트리 전체가 README.md 파일의 위계 그리고/또는 탄탄한 설계 문서로 문서화되어 있으면 놀라운 부수 효과가 하나 있다. 새 엔지니어를 온보딩할 때 마찰이 아주 적어진다.

새 엔지니어가 팀에 합류한다면, 새 온보딩 절차는 이렇다:

  1. 새 NotebookLM 노트북(또는 원하는 비슷한 도구)을 만든다.
  2. README.md 파일의 위계 전체와 기존 설계 문서를 거기에 쏟아 넣는다.
  3. 시스템 지침에, 새 팀원이 시스템의 구체적으로 어느 부분에 집중할지 노트북에 알려 준다.
  4. 노트북을 엔지니어에게 건넨다.

첫 번째 일은 그 노트북을 써서 시스템을 충분히 배운 다음, 자기 첫 기능에 대한 훌륭한 설계 문서를 (위의 프로세스로) 쓰는 것이라고 말해 준다.

금붕어 시험을 통과하는 좋은 문서를 쓸 수 있게 되면, 그 사람이 코드베이스에 생산적으로 기여할 만큼 — 아니면 적어도 코드 리뷰에서 당신 시간을 낭비하지 않을 만큼 — 알고 있다고 안심해도 된다. 몇 주씩 선배 뒤를 따라다니거나 불투명한 레거시 코드를 역공학하려 애쓰는 일은 이제 없다.

누군가 내 받은편지함에 나타나 우리 도구에 새 기능을 제안하는 일은 흔하다. 2025년 이전이라면 그냥 백로그에 넣고 언젠가 처리했을 것이다. 하지만 이 접근법으로는 그냥 이렇게 묻는다. “코드를 짜 본 경험이 좀 있어?”

제품 관리자, 프로그램 관리자, 그 밖에 많은 사람이 적어도 약간의 코딩 경험은 있다. 그런 사람들에게는 새 노트북을 준비해 주고, 그것을 써서 원하는 기능의 설계 문서를 써 보라고 한다.

(보통) 며칠 뒤면 새 설계 문서가 내 리뷰 대기열에 올라온다. 대개 약 70~80%는 맞아서, 나는 그것을 리뷰하고 개선 방법을 제안한다. 한두 번 더 주고받으면 우리 품질 기준을 충족하게 된다.

그 기준을 충족하고 나면, 그들이 AI로 만드는 코드가 결국 우리 소스 트리에 들어가리라고 안심할 수 있다. 물론 전부 평소처럼 리뷰를 거치지만, 슬롭은 아닐 것이다 — 그러니 시간 낭비가 아니라는 뜻이다.

속도 때문에 와서, 이해 때문에 머문다

우리는 IDE에 문법을 타이핑하는 일이 더 이상 소프트웨어 엔지니어의 주된 일이 아닌 세상으로 들어가고 있다. 일은 의도다. 일은 아키텍처다. 일은 설계 판단이다.

사람이 읽을 수 있고 엄격하게 시험한 문서 안으로 그 설계 판단들을 밀어 넣지 않은 채 코드 작성을 전적으로 AI에 기댄다면, 우리가 책임지고 서야 할 작업에 자신 있게 이름을 걸 능력을 잃게 된다. 결국 에이전트가 한 모든 행동의 책임은 사람이 지게 되는데, 우리 지시로 에이전트가 만든 시스템을 우리가 제대로 이해하지 못한다면 그 위험을 떠안으라고 기대하는 것은 합리적이지 않다.

하지만 설계를 새로운 코드로 대하면, 이해를 바라는 인간의 필요와 AI의 속도 역량이 한 줄로 맞춰진다. 이것이야말로 궁극의 위험 줄이기 작업이다.

3부: 아마 틀릴 몇 가지 예측

“예측은 어렵다. 특히 미래에 관한 예측은.”

― 요기 베라(Yogi Berra)

이 분야는 너무 빨리 움직이고 있어서 어떤 예측이든 하는 것 자체가 아마 실수일 테지만, 그래도 나는 예측을 하려 한다. 무엇이 오든 헤쳐 나가는 데 쓸 수 있는 오래가는 패턴의 윤곽이 몇 가지 보인다고 생각하지만, 틀릴 수도 있으니 아주 건강한 회의심을 품고 읽어 주기 바란다.

이제 우리는 모두 관리자다

지금의 질서에서는 직원을 관리하면 “피플 매니저”, 그렇지 않으면 “개인 기여자(individual contributor, IC)”라고 불린다. 내가 보기에 이 구분은 올해 몹시 흐릿해질 것이다.

도구와 모델이 더 유능해지면서, 우리는 모두 우리 대신 일하는 에이전트를 몇이든 관리하기 시작할 것이다. 이미 경험 많은 피플 매니저라면 꽤 쉽게 적응할 것이다. 하지만 다른 사람을 관리해 본 적이 없다면, 새로운 (그리고 아주 쓸모 있는) 기술을 몇 가지 배워야 한다.

겉보기에는 사람을 관리하는 일과 AI 에이전트를 관리하는 일이 아주 다를 것 같다. 하지만 나는 둘이 생각보다 훨씬 많이 겹친다고 주장하고 싶다.

AI 에이전트는 사람이 아니다 — 하지만 가끔은 운이 맞는다

관리의 목적은 자신의 판단력과 전문성을, 혼자 해낼 수 있는 일을 훨씬 넘어서는 곳까지 지렛대로 늘리는 것이다.

나쁜 관리자라면 직원에게 자잘한 일 하나하나를 할 때 밟아야 할 단계를 정확히 지시한다. 우리는 이것을 마이크로매니징이라 부르고, 겪어 본 사람이라면 누구나 이것이 규모를 키울 수 없고 원하는 결과를 내는 일도 드물다는 것을 안다.

반면 좋은 관리자는 직원에게 자기가 바라는 결과가 무엇인지 말하고, 가드레일과 지침을 준다. 직원이 움직일 수 있는 권한의 범위와 자유도를 분명히 설명하고, 어떤 조건에서는 멈추고 지침을 구하기를 바라는지도 분명히 설명한다.

직원에게서 한동안 눈을 뗐다가 다시 봤을 때 일이 제대로 굴러가고 있다면, 관리자로서 잘하고 있는 것이다. 눈을 뗄 수 있는 시간이 길수록 직원을 더 잘 키우고 있는 것이다. 그 시간이 길어질수록 한 사람당 드는 간접비가 줄어드니 사람을 더 늘릴 수 있다.

이것이 AI 에이전트 관리에 어떻게 들어맞는지는 눈을 가늘게 뜨고 애써 볼 필요도 없다고 생각한다. 물론 경력 계획까지 세워 줄 필요는 없지만, 다른 점보다 비슷한 점이 훨씬 많다고 말하고 싶다.

몇 가지 실용적인 조언

이 전제가 완전히 정신 나간 소리는 아니라고 생각하고 지금 IC라면, 무엇을 해야 할까?

기본적인 피플 매니지먼트 강좌를 들어라. 지금 당장. 진짜로.

이상한 조언처럼 보일 수 있지만, 내 말을 들어 보라…

관리의 목적은 당신 판단의 영향력을 하루에 혼자 해낼 수 있는 일 너머로 확대하는 것이다. 직원에게서 한동안 눈을 떼고도 다시 들여다볼 때 일이 제대로 굴러가 있으리라고 확신할 수 있다면 좋은 관리자다.

직원들이 성공하도록 잘 준비시키고 있다는 증거는, 성공적으로 눈을 뗄 수 있는 시간이 갈수록 늘어난다는 것이다. 그렇게 되면 직원 한 명당 당신에게 지워지는 개인적인 간접비가 줄어든다. 즉 인터럽트에 잡아먹혀 번아웃되지 않고도 더 많은 직원을 성공적으로 맡을 수 있다는 뜻이다.

당신 대신 행동하는 독립된 주체들 전반으로 판단을 성공적으로 확장하는 법을 배우는 것은 훈련과 연습이 필요한 기술이다. AI 에이전트 관리의 시대가 이미 와 있고, 지금 이 능력을 쌓기 시작해야 한다.

많은 회사가 처음 관리자가 된 사람을 위한 사내 교육을 두고 있고, 거기서는 위임·조율·오케스트레이션을 구체적으로 다룬다. 그런 강좌에 등록하라. 지금 고용주가 그런 강좌를 제공하지 않는다면 책을 사든, 유튜브 영상을 보든, 온라인 강좌를 듣든, 어쨌든 무언가를 하라.

내가 줄 또 하나의 조언은 한 번에 관리하려는 에이전트 수를 천천히 늘려 가라는 것이다.

처음 피플 매니저가 되면 보통 3~5명짜리 작은 팀을 맡는다. 그 이유는 사람을 관리한다는 것이, 인터럽트에 압도당하지 않도록 목표와 인센티브와 기본 규칙을 정하는 법을 배우는 일이기 때문이다.

이 경험칙은 에이전트를 통해 판단을 매끄럽게 확장하는 법을 배울 때 처음 겨냥할 좋은 목표로 보인다. 새 운동을 시작할 때와 조금 비슷하다. 천천히 시작하고, 올바른 자세를 몸에 익힌 다음, 거기서부터 늘려 가라.

지속적인 집중은 길러야 하는 근육이다

AI는 상태 보고서나 진행 상황 회의 같은, 일의 고된 잡무 일부를 꾸준히 흡수하고 있다. 정말로 좋은 소식이다. 하지만 이것은 질문을 낳는다. 되찾은 시간으로 무엇을 할 것인가?

답은 우리가 늘 시간이 모자라 하지 못했던 일이다. 깊이 생각하기. 진짜 설계. 동료에게도 모델에게도 위임할 수 없는 종류의 판단.

문제는 지속적인 집중이 우리 대부분이 기를 기회가 없었던 기술이라는 점이다. 역량이 모자라서가 아니라, 현대 사회가 우리 주의를 차지하려고 경쟁하는 것들로 우리를 방해하기를 좋아하기 때문이다.

집중력을 기르는 것은 다른 어떤 지구력을 기르는 것과도 같다. 오래 집중해서 생각하는 데 익숙하지 않다면, 두 시간으로 시작하는 것은 첫날 10킬로미터를 달리는 것과 같다. 더 나은 출발점은 근무일마다 30~45분 동안 한 문제에 세게 집중하는 것이다. 매주 초에 5~10분씩 늘려라. 몇 달이면 한 번에 2시간(그 이상)씩 집중할 수 있는 정신적 지구력이 생긴다.

이것은 모두가 길러야 하는 근육이다. 수도원 같은 침묵 속에 앉아 있을 필요는 없다. 그 시간에 작업 중인 문제를 놓고 AI 도구와 토론해도 좋다. 요점은 생각하고 토론해서 어느 정도의 정신적 피로에 이르는 것이다. 지친 뇌는 지친 이두근과 똑같이 성장의 신호다.

AI가 우리 잡무를 잔뜩 가져가면, 그냥 다 같이 덜 일하게 된다는 뜻 아닌가? 아니다.

AI가 일을 아주 효율적으로 만들어 줘서 하루 몇 시간만 일하면 될 거라고 바랄지도 모른다. 하지만 역사가 보여 주듯, 도구가 일을 쉽게 만들어도 우리가 꼭 덜 일하지는 않는다 — 그 노력의 비용이 떨어졌기 때문에 결국 더 많이 하게 될 뿐이다. 이것은 제번스의 역설이라고 알려진, 오래전부터 관찰된 현상이다.

마지막 생각

윌리엄 제번스(William Jevons)와 그의 유명한 역설 이야기가 나온 김에, 나는 가끔 학생들과 젊은 동료들에게서 AI 때문에 길고 보람 있는 경력을 가질 수 없게 될까 걱정하는 소리를 듣는다. 일상의 업무가 어느 정도 바뀌는 것은 사실일 수 있지만, 그렇다고 우리가 목적도 가치도 없어진다는 뜻은 아니다. 이런 종류의 변화는 내가 일을 해 온 내내 늘 있었다.

당신의 가치는 당신이 익히고 성공적으로 적용하는 판단에 있다. 자기 영역에서 더 나은 안목을 기르고 그것을 확장하는 법을 더 많이 배울수록, 당신을 찾는 수요는 커진다. 이것은 언제나 사실이었고, 앞으로도 언제나 사실일 것이라고 생각한다.

이 AI들은 이미 아주 강력한 도구다. 장인처럼 쓰는 법을 배우면 당신의 기술을 찾는 수요가 모자랄 일은 없을 것이다. 어려울까? 물론이다. 하지만 그것은 산처럼 어려운 게 아니라 언덕처럼 어려운 것이다. 그러니 그냥 걷기 시작하라.

이 글이 세상에 나오도록 귀중한 도움을 준 동료들에게 감사를 전하고 싶다. 애초에 이런 것들을 글로 적으라고 나를 떠민 엘리스 유잉(Elise Ewing), 그리고 초고를 끈기 있게 읽고 사려 깊은 편집 제안을 해 준 앰버 허프먼(Amber Huffman)과 파사 랑가나탄(Partha Ranganathan)에게.


원본 링크·인용

원문과 원문이 가리키는 곳

  1. Elephants, Goldfish and the New Golden Age of Software Engineering — 원문. 데이브 렌신, Medium, 2026-04-27 발행. 2026-10-21에 글머리 업데이트 문단이 붙었다.
  2. Dave Rensin — Medium — 저자 페이지. 자기소개는 Google Distinguished Engineer다.
  3. egm.dev — 원문 업데이트 문단의 링크. 이 방법론을 따르는 오픈소스 플러그인 사이트다.
  4. Google People Management Essentials — 3부 「몇 가지 실용적인 조언」의 링크. 저자가 첫 관리자 교육의 예로 든 온라인 강좌다.
  5. Jevons paradox — Wikipedia — 3부 「지속적인 집중은 길러야 하는 근육이다」의 링크. 저자가 노동량 논증에 빌려 쓴 개념이다.

원문에 붙은 Medium 주제 태그는 AI · Generative Ai Tools · Future Of Work다.

원문이 인용한 말


기타

수록 범위와 용어

원본 블록은 원문 본문 전량을 싣는다. 2026-10-21에 붙은 업데이트 문단과 글머리 삽화도 원문 자리에 있다. Medium 페이지의 박수 수, 구독 안내, 공유·저장 버튼은 글의 일부가 아니라서 싣지 않는다.

원본 블록의 형광 표시는 원문 Medium 페이지의 하이라이트 표시와 같은 자리다. 저자가 LLM에 주는 프롬프트도 한국어로 옮겼다. 영어 원문 프롬프트는 원문 링크에서 볼 수 있다.

용어 대역

원문이 문서의 번역어원문에서 가리키는 것
Elephant코끼리프롬프트를 많이 받아 맥락이 쌓인 AI 세션과, 그 세션이 함께 쓴 설계 문서
Goldfish금붕어기억 없이 새로 연 AI 세션. 앞에 놓인 문서와 문서가 가리키는 파일만 안다
Elephant-Goldfish Model (EGM)코끼리-금붕어 모델코끼리로 설계 문서를 쓰고 금붕어로 그 문서를 시험한 뒤 구현하는 절차
design doc설계 문서문제·기술 계획·대안·상세 구현 네 절로 된 마크다운 문서
Phase / Step페이즈 / 단계EGM의 큰 구간 4개와 그 안의 작업 9개
guardrails가드레일AI가 요청 밖으로 벗어나지 않게 문서에 적어 둔 범위와 제약
sycophantic spiral아첨 소용돌이모델이 사용자 말에 동의만 되풀이하는 상태
slop슬롭읽을 수도 유지할 수도 없는 저품질 생성물
shift left왼쪽 이동설계 판단을 코드 작성보다 앞 단계인 설계 문서로 옮기는 일
peanuts and hay땅콩과 건초디렉터리마다 쓴 README.md 계층. 작게 압축한 맥락 조각
individual contributor (IC)개인 기여자사람을 관리하지 않는 실무자
toil잡무현황 보고나 업데이트 회의처럼 반복되는 일
judgment판단력저자가 직업적 가치의 핵심으로 드는 능력