데카당스 (MJ Kim)(@decadence_in_london)가 2026-11-07 09:35 KST Threads에 올린 5부 스레드다. 저자는 AI 에이전트 다섯에게 문헌 조사·수치 조사·조사 관리·검증·총괄을 나눠 맡기고, 사람은 총괄 연구원하고만 대화한다. 7분 뒤 저자는 같은 스레드를 인용해, 상위 모델 하나에 조사를 맡길 때와 결과 차이는 크지 않고 이득은 정리와 검증 쪽이라고 덧붙였다.
데카당스는 AI 에이전트 다섯에게 자료 조사를 어떻게 나눠 맡기고, 그 구성이 상위 모델 하나에 바로 조사를 시킬 때보다 무엇을 더 준다고 말하나?
데카당스(MJ Kim, @decadence_in_london)는 2026-11-07 09:35 KST(00:35 UTC) Threads에 5부 스레드 「영업기밀 공개함」을 올렸다. 자기소개에 미국 은행 런던 오피스 15년차 Director라고 적은 저자는 이 구성을 회사의 산업·매크로 분석과 Threads 글감 조사에 쓴다고 밝힌다. 저자는 AI 에이전트 다섯에게 연구소 직책을 하나씩 준다. 직책은 문헌·맥락 조사원, 수치·도표 조사원, 리서치 매니저, 검증 위원, 총괄 연구원이다.
저자는 이 구성의 이득을 결과의 질보다 과정 쪽에 둔다. 2026-11-07 09:42 KST 인용 게시물에서 저자는 상위 모델 하나에 조사를 시킬 때와 결과 면에서 "어마어마한 차이는 안남"이라고 쓴다. 저자가 꼽는 이득은 분야별 누락 방지, 검증 에이전트의 팩트 체크와 보완, 정리된 자료 덕분에 쉬워지는 최종 검수다. 이 셋은 저자의 사용 경험에서 나온 진술이다. 같은 질문을 두 방식으로 조사해 결과를 나란히 비교한 자료는 스레드에 없다.
멘탈 모델
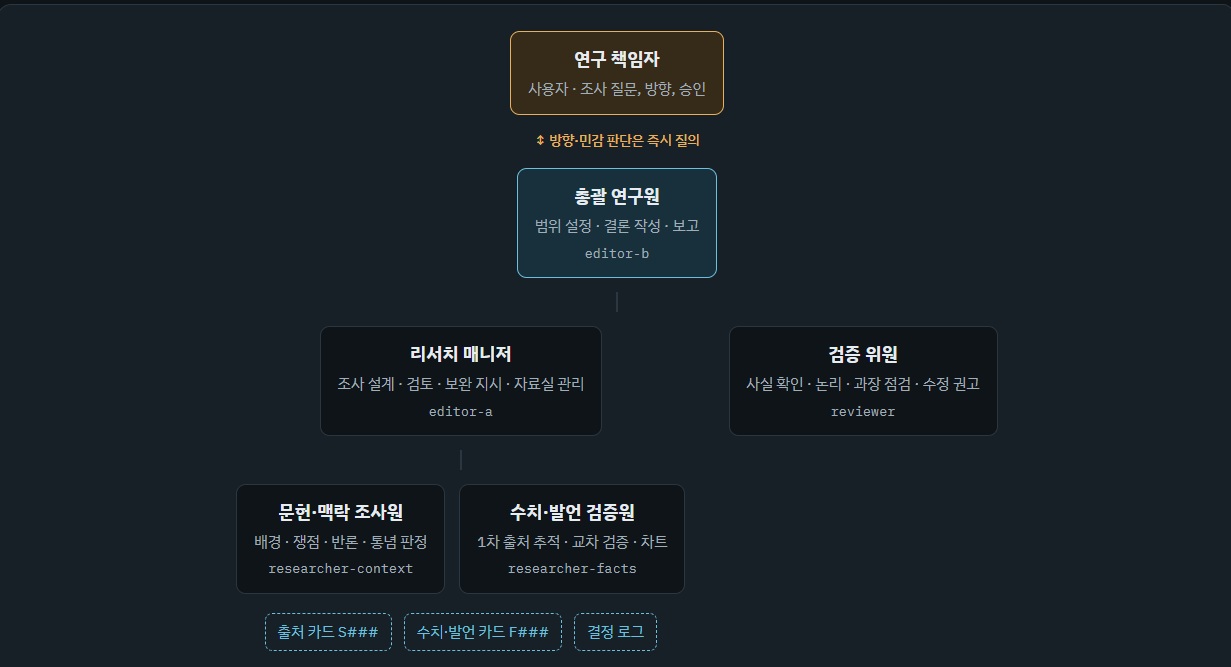
구성의 뼈대는 연구소 직제다. 사람이 맨 위 연구 책임자 자리에서 조사 질문과 방향을 정한다. 총괄 연구원(에이전트 5)이 그 아래에서 범위를 정한 뒤 결론을 쓴다. 리서치 매니저(에이전트 3)는 조사원 두 에이전트(에이전트 1·2)의 조사를 설계한다. 검증 위원(에이전트 4)은 조사원 줄과 갈라져 총괄 연구원 바로 아래에 선다.
사람과 에이전트 사이의 창구는 총괄 연구원 하나다. 저자는 지시도 에이전트 5에게만 준다. 에이전트 5가 그 지시를 나머지 에이전트에게 나눈다. 저자는 답글에서 이유를 질문 수로 설명한다. 다섯 모두와 대화하면 질문이 너무 많아져 피곤하다는 것이다. 방향과 민감한 판단은 조직도의 화살표대로 곧바로 저자에게 올라온다.
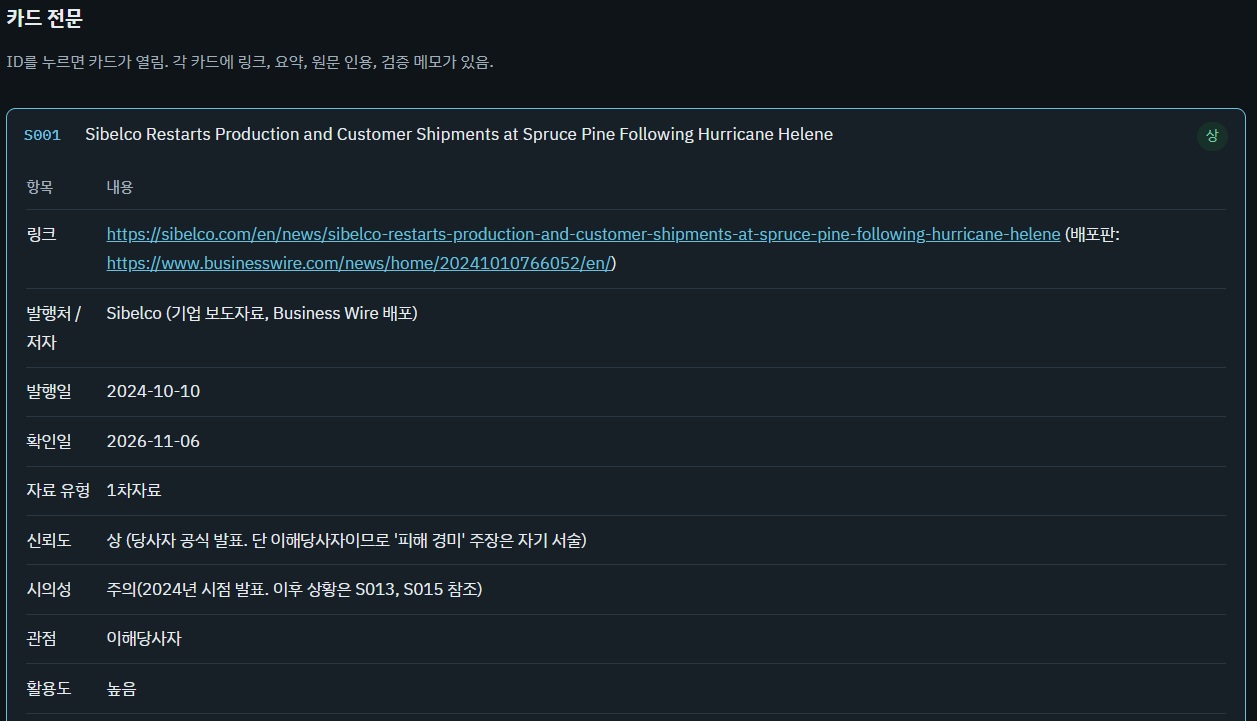
자료실은 사람의 검수를 받치는 자리다. 조사에 쓴 자료마다 원문 링크·발행일·신뢰도가 카드로 남는다. 저자는 보고서를 읽다 의문이 생기면 자료실에서 원문을 찾는다고 쓴다. 최종 검수와 방향 결정은 5/5에서 저자가 사람 몫으로 남긴다.
먼저 알아 둘 것
Claude Code의 하위 에이전트 — Claude Code는 Anthropic의 명령줄 코딩 도구다. Claude Code 문서는 하위 에이전트(subagent)를 특정 종류의 일을 맡는 전문 AI 작업자로 정의한다. 하위 에이전트는 자기 지시문과 도구 권한을 따로 가진다. 상위 대화의 기록을 보지 않은 채 새 컨텍스트에서 일한 뒤 요약만 돌려준다. 하나를 정의하는 데 YAML 머리말을 단 Markdown 파일 한 장이면 된다. 저자는 다른 답글에서 Claude Opus 5.5로 만들었다고 쓴다.
오케스트레이터–워커 분담 — 한 에이전트가 일을 쪼개 다른 에이전트에게 맡긴 뒤 결과를 합치는 구조다. Anthropic이 2024-12-19 낸 글 「Building effective agents」은 이 구조를 orchestrator-workers 패턴이라 부른다. 저자의 에이전트 5가 이 중앙 자리다. 같은 글은 한 대규모 언어 모델(large language model, LLM)이 답을 만들면 다른 LLM이 평가와 피드백을 돌려주는 반복을 evaluator-optimizer 패턴이라 부른다. 검증 위원이 평가자 자리에 해당한다. 4/5의 조사 순서 그림은 이 반복을 6단계 '독립 검증'에서 최대 2라운드로 묶는다.
출처 카드 S###와 수치·발언 카드 F### — 2/5·3/5 그림의 S001·F005 같은 번호는 자료실 카드 ID다. 조직도 맨 아래 점선 상자가 두 종류를 적는다. S###은 출처 카드다. F###은 수치·발언 카드다. 통념 판정 표의 근거 칸은 판정마다 이 번호를 단다. 그림 속 보고서는 저자의 구성이 만든 예시다. 주제는 2024-09 허리케인 헬렌 이후 미국 노스캐롤라이나 스프루스 파인(Spruce Pine) 광산의 고순도 석영 공급이다.
읽는 순서
원본 (전문)의 1/5를 조직도 그림과 함께 읽는다. 그림의 상자마다 본문에 없는 업무 목록이 붙어 있다.
2/5~4/5는 본문보다 그림에 정보가 많다. 2/5와 3/5의 그림 5장은 이 구성이 낸 보고서의 화면이다. 4/5 본문은 한 문장이다. 0~7단계 조사 순서는 그림에만 있다. 3/5의 Devil's Advocate는 일부러 반대편에 서서 주장을 시험하는 역할을 가리킨다.
5/5와 저자의 인용 게시물을 이어 읽는다. 5/5에서 저자는 밑의 애널리스트들이 AI로 조사해 온 결과물에 질 낮은 'AI 슬랍'이 많아 직접 만들었다고 쓴다. 인용 게시물은 이 구성의 한계를 저자가 직접 적은 글이다.
다섯 글과 저자 인용 게시물의 본문은 줄바꿈을 빼고 공백을 넣어 1,472자다. 분당 500자로 잡으면 3분 안팎이다. 그림 7장을 보는 시간은 이 값에 들지 않는다.
읽으며 확인할 것
1/5 본문은 에이전트 2를 '수치/도표(정량적) 조사원'이라 부른다. 조직도는 같은 자리를 '수치·발언 검증원'으로 적는다. 그 상자의 업무는 '1차 출처 추적·교차 검증·차트'다. 교차 검증은 검증 위원 한 자리에서만 일어나나, 조사 단계에서도 일어나나?
5/5의 '생산성이 차원이 달라진다'는 문장은 무엇을 재는 말인가? 결과의 질을 두고 저자가 인용 게시물에 쓴 진술과 같은 것을 재나?
4/5의 조사 순서에서 연구 책임자에게 묻는 단계는 어디인가? 각 단계는 무엇을 묻나? 7단계 '최종 보고'가 보고서와 함께 내는 원문 대조 체크리스트는 그 뒤 사람의 검수에서 어떤 몫을 맡나?
Executive Summary
저자는 다섯 AI 에이전트 조사 체계의 이득을 결과 품질보다 정리·검증 편의로 좁힌다
원문은 데카당스(MJ Kim, @decadence_in_london)가 2026-11-07 09:35 한국 표준시(Korea Standard Time, KST)에 Threads에 올린 5개 게시물 스레드 「영업기밀 공개함」이다. 첫 게시물의 반응은 같은 날 19:33 KST 기준 좋아요 340, 답글 83, 리포스트 134, 공유 297, 인용 3이다. 스레드는 AI 에이전트 다섯에게 조사 역할을 나눠 맡기는 체계를 설명한다. 마지막 게시물은 조사하는 업종이라면 “생산성이 차원이 달라진다”고 맺는다. 저자는 7분 뒤 이 스레드를 인용한 덧붙임 글에서 상위 모델 하나에 조사시키는 것과 결과 차이가 크지 않다고 적었다. 그가 남긴 이득은 정리와 검증의 편의다.
신뢰도 B — 구조 설명과 예시 보고서의 사실 10건 중 9건은 1차 출처와 맞는다. ‘검증 위원이 없으면 엉터리’는 연구가 받치는 폭보다 세다. ‘아무나’와 ‘계정 하나로’에는 Claude 유료 요금제 조건이 빠졌다. 판정 26건(의견·경험 진술 4건 포함)은 팩트체크 블록에 있다.
저자의 7분 뒤 덧붙임은 결과 품질 대신 정리 편의를 이득으로 남긴다
스레드는 이 체계를 “영업기밀”로 소개한다. 같은 첫 게시물은 “아무나 할 수 있는거라서” 공개한다는 이유를 붙인다. 마지막 게시물(5/5)은 생산성 주장 뒤에 “어차피 알려줘도 안하겠지만 난 알랴줬음”이라는 농담으로 끝난다.
덧붙임의 첫 문장은 “이렇게 거창하게 말했지만”이다. 저자는 이어 “사실 그냥 상위모델 써서 조사시키는거랑 결과면에서 어마어마한 차이는 안남”이라고 쓴다. 그가 드는 이득은 셋이다. 역할을 나눠 두어 분야별로 빼먹지 않는다. 총괄·검증 에이전트가 팩트체크와 보완을 알아서 한다. 자료가 정리돼 최종 검수가 수월하다.
같은 글은 “에이전트 사무실” 같은 보여주기용 구성을 만들지 말라고 권한다. 이 정도로만 만들어도 “토큰대비 결과물 매우 훌륭하게 나온다”는 것이 이유다. 무엇에 견준 토큰 대비인지는 적혀 있지 않다. 글은 “괜히 멀리가지마라”로 끝난다.
저자는 답글에서도 같은 양보를 되풀이했다.
저자가 결과물을 낮춰 말한 답글. 시각은 2026-11-07 KST다. 시각을 누르면 답글 원문이 열린다.
첫 게시물은 “AI로 에이전트 5개”를 만들라고 쓴다. 에이전시를 차리라는 말이 아니라는 단서가 붙는다. 다섯인 이유로 저자는 홀수를 좋아하는 취향을 든다. 홀수가 “뭔가 안정적”이라는 것이다. 저자는 16:00 KST 답글에서 체계 전체를 “역할을 나눠서 일을 시킨다”는 말로 줄였다.
1/5 게시물 글과 같은 게시물 조직도 그림의 역할 표기. 그림의 ID는 상자 안 고정폭 글씨다. 연구 책임자 상자에는 ID가 없다.
역할
게시물 글의 이름·설명
그림의 이름
그림의 업무
그림의 ID
에이전트 1
문헌/맥락(정성적) 조사원
문헌·맥락 조사원
배경·쟁점·반론·통념 판정
researcher-context
에이전트 2
수치/도표(정량적) 조사원
수치·발언 검증원
1차 출처 추적·교차 검증·차트
researcher-facts
에이전트 3
리서치 매니저: 조사원 관리, 피드백, 방향성 제시
리서치 매니저
조사 설계·검토·보완 지시·자료실 관리
editor-a
에이전트 4
검증 위원: 조사 내용 검증
검증 위원
사실 확인·논리·과장 점검·수정 권고
reviewer
에이전트 5
총괄 연구원: 모든 프로세스 오케스트레이션
총괄 연구원
범위 설정·결론 작성·보고
editor-b
사람(저자)
연구 책임자: 에이전트 5하고만 이야기한다
연구 책임자
사용자·조사 질문, 방향, 승인
—
게시물 글과 그림의 이름이 다른 역할은 에이전트 2 하나다(표 둘째 줄).
1/5 게시물에 붙은 역할 조직도(데카당스, Threads, 2026-11-07). 연구 책임자와 이어진 상자는 총괄 연구원 하나다. 그 사이에 ‘방향·민감 판단은 즉시 질의’가 적혀 있다. 검증 위원은 리서치 매니저와 같은 층에 따로 있다. 두 조사원은 리서치 매니저 아래에 있다. 맨 아래 점선 상자 셋은 출처 카드 S###, 수치·발언 카드 F###, 결정 로그다.
저자의 역할은 연구 책임자다. 그는 다른 에이전트와 말하지 않는다. 대화 상대는 총괄 연구원인 에이전트 5 하나다. 가이던스도 에이전트 5에게 준다. 다른 에이전트에게 나눠 주는 일은 에이전트 5의 몫이다. 반대 방향으로는 어느 에이전트든 궁금한 점이나 결정할 일이 생기면 저자에게 묻게 지시한다.
왜 에이전트 5하고만 말하느냐는 질문(@reindeer.log, 11:43 KST)에 저자는 11:56 KST 답글로 답했다. 다른 에이전트와 말해도 상관은 없다고 한다. 에이전트 5가 총괄이어서 중요하지 않은 사항은 저자 대신 다른 에이전트와 이야기한다. 저자는 중요한 사항만 자기에게 가져오게 한다. 그렇게 하지 않으면 질문이 너무 많아져 피곤하다는 것이 이유다.
저자가 가장 무겁게 다루는 역할은 반대 논증까지 맡는 검증 위원이다
2/5 게시물은 검증 위원(에이전트 4)의 역할이 “매우 중요”하다고 쓴다. 검증 위원은 조사원의 결과를 “독립적으로 크로스체크”해 정확도를 높인다. 저자는 검증 위원이 없으면 “엉터리 조사결과”가 나온다고 주장한다.
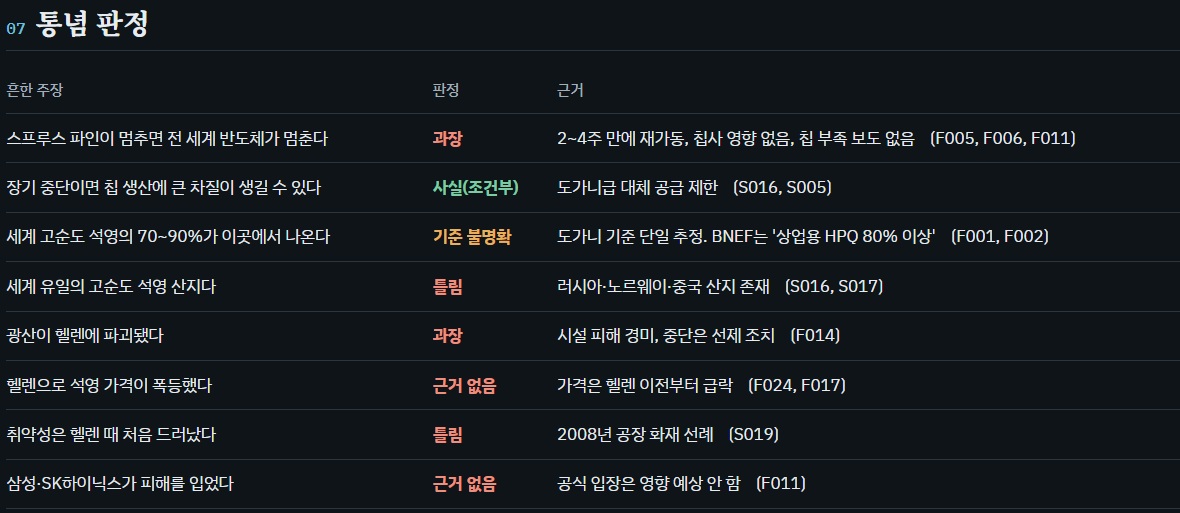
3/5 게시물은 검증 위원에게 반대 논증 담당(Devil's Advocate)을 맡긴다. 대상은 조사 중 발견한 주장과 속설이다. 내용을 잘못 이해하면 나올 수 있는 주장도 대상이다. 저자는 그 결과물인 “통념 판정”을 읽으면 내용 이해에 도움이 많이 된다고 쓴다.
같은 게시물의 첫 그림이 그 통념 판정이다. 그림은 저자의 체계가 만든 예시 보고서의 한 쪽이다. 보고서 주제는 2024년 허리케인 헬렌(Helene) 뒤 스프루스 파인(Spruce Pine)의 고순도 석영 공급이다. 2/5·3/5 게시물의 그림 다섯 장은 모두 이 주제의 보고서 화면이다.
예시 보고서의 ‘07 통념 판정’ 쪽(3/5 게시물 첫 그림)을 옮긴 표. 판정의 주체는 예시 보고서다. 판정 칸 낱말 다섯(과장, 사실(조건부), 기준 불명확, 틀림, 근거 없음)은 보고서 어휘 그대로다. 보고서는 이 낱말의 범례를 따로 두지 않는다. 낱말이 가리키는 바는 같은 줄의 근거 칸이 보여 준다. 근거 카드 칸의 F 번호는 수치·발언 카드, S 번호는 출처 카드다.
흔한 주장
판정
보고서가 든 근거
근거 카드
스프루스 파인이 멈추면 전 세계 반도체가 멈춘다
과장
2~4주 만에 재가동, 칩사 영향 없음, 칩 부족 보도 없음
F005, F006, F011
장기 중단이면 칩 생산에 큰 차질이 생길 수 있다
사실(조건부)
도가니급 대체 공급 제한
S016, S005
세계 고순도 석영의 70~90%가 이곳에서 나온다
기준 불명확
도가니 기준 단일 추정. 블룸버그NEF(BloombergNEF, BNEF) 수치는 ‘상업용 고순도 석영(High-Purity Quartz, HPQ) 80% 이상’
F001, F002
세계 유일의 고순도 석영 산지다
틀림
러시아·노르웨이·중국 산지 존재
S016, S017
광산이 헬렌에 파괴됐다
과장
시설 피해 경미, 중단은 선제 조치
F014
헬렌으로 석영 가격이 폭등했다
근거 없음
가격은 헬렌 이전부터 급락
F024, F017
취약성은 헬렌 때 처음 드러났다
틀림
2008년 공장 화재 선례
S019
삼성·SK하이닉스가 피해를 입었다
근거 없음
공식 입장은 영향 예상 안 함
F011
자료실은 조사에 쓴 자료마다 링크·발행일·신뢰도를 카드로 남긴다
2/5 게시물은 자료실을 만들어 달라고 요청하라고 쓴다. 자료실은 조사에 쓴 자료의 원문 링크·발행일자·신뢰도를 모은다. 저자가 드는 이유는 읽다가 의문이 생기면 원문을 찾기 쉽다는 점이다.
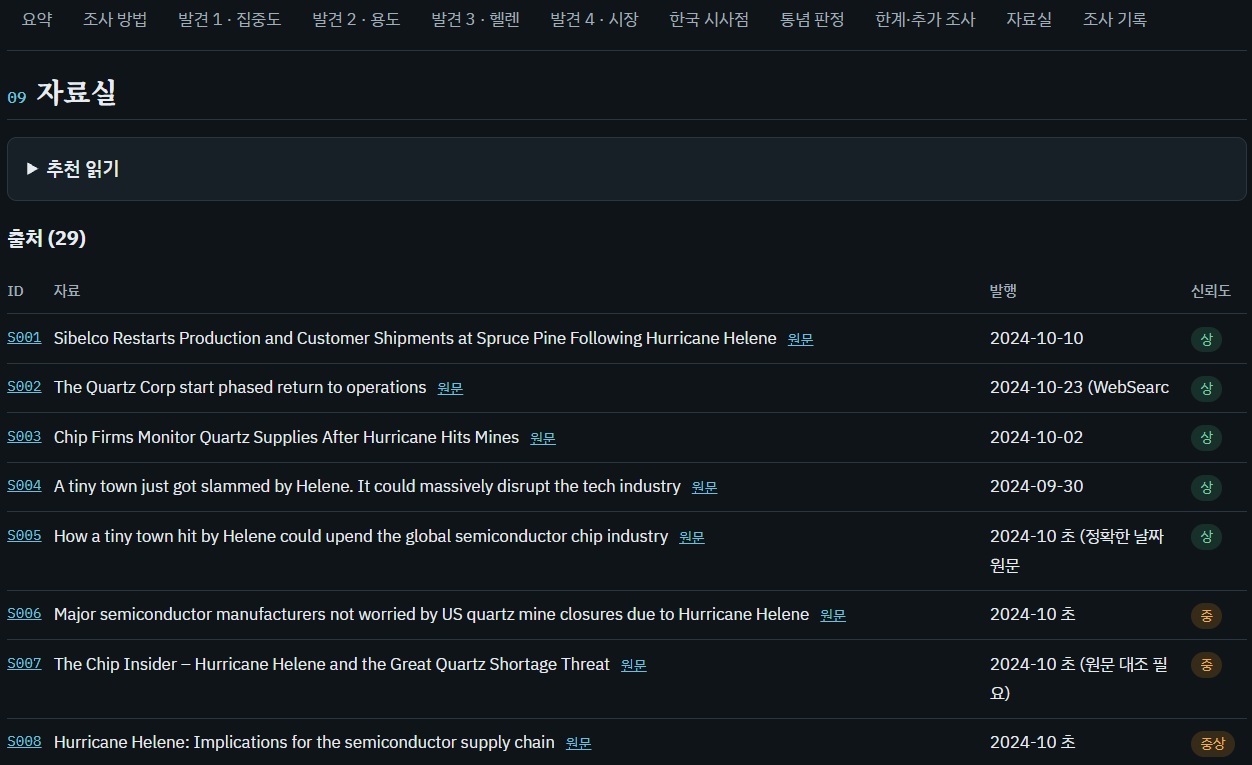
같은 게시물에 붙은 그림 세 장은 예시 보고서의 자료실 화면이다. 첫 장은 ‘09 자료실’ 쪽이다. 보고서 위쪽 탭은 요약, 조사 방법, 발견 1~4(집중도·용도·헬렌·시장), 한국 시사점, 통념 판정, 한계·추가 조사, 자료실, 조사 기록이다. 출처 표는 ID·자료·발행·신뢰도 네 칸에 29건을 싣는다. 화면에 보이는 S001~S008의 신뢰도는 상 다섯, 중상 하나, 중 둘이다. 발행 칸 일부는 ‘2024-10 초 (원문 대조 필요)’처럼 날짜가 불확실하다는 표시를 단다.
둘째 장은 ID를 누르면 열리는 출처 카드 S001의 전문이다. 화면 설명은 카드마다 링크·요약·원문 인용·검증 메모가 있다고 적는다. S001 카드의 자료는 Sibelco 보도자료(Business Wire 배포)다. 발행일은 2024-10-10, 확인일은 2026-11-06, 자료 유형은 1차자료, 관점은 ‘이해당사자’, 활용도는 ‘높음’이다. 신뢰도 ‘상’에는 이해당사자의 ‘피해 경미’ 주장은 자기 서술이라는 단서가 붙는다. 시의성 칸은 ‘주의’와 함께 이후 상황을 S013·S015에서 보라고 적는다.
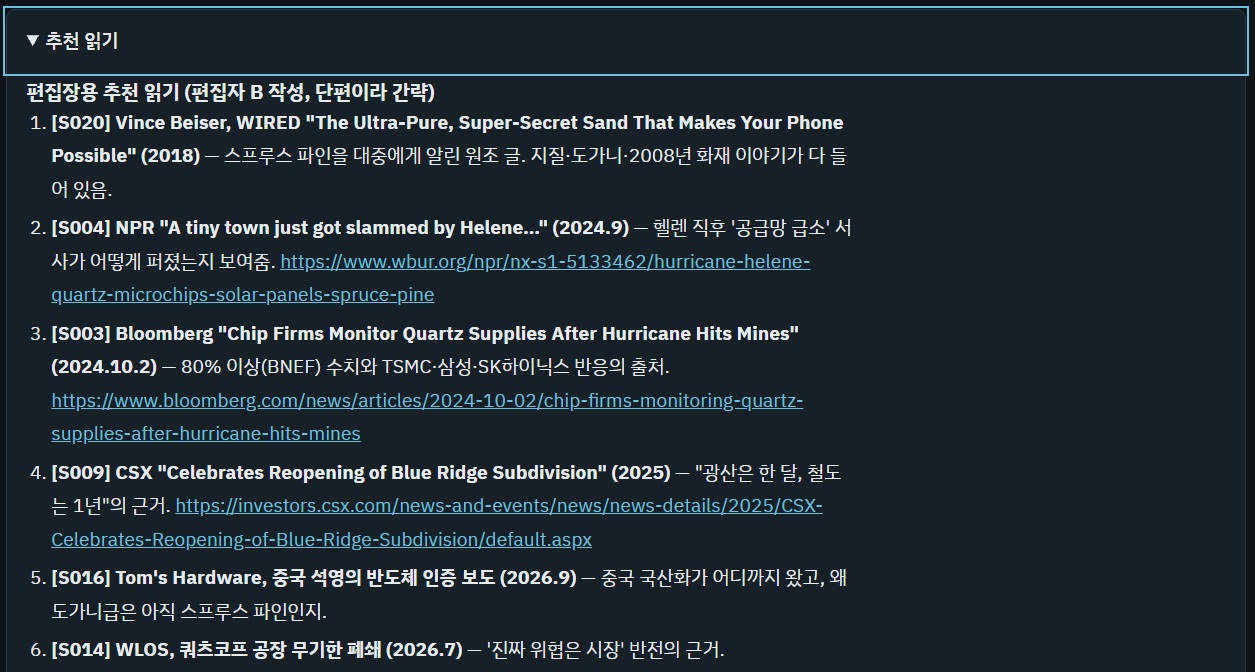
셋째 장은 자료실의 ‘추천 읽기’를 펼친 화면이다. 제목은 ‘편집장용 추천 읽기 (편집자 B 작성, 단편이라 간략)’이다. ‘편집자 B’는 조직도의 editor-b(총괄 연구원)와 이름이 겹친다. 목록 여섯 건은 WIRED의 2018년 Vince Beiser 글, NPR의 2024년 9월 보도, Bloomberg의 2024-10-02 보도, CSX의 2025년 발표, Tom's Hardware의 2026년 9월 보도, WLOS의 2026년 7월 보도다. 항목마다 출처 카드 번호와 읽을 이유 한 줄이 붙는다.
조사 순서 여덟 단계에는 묻는 지점 셋과 반복 상한 둘이 있다
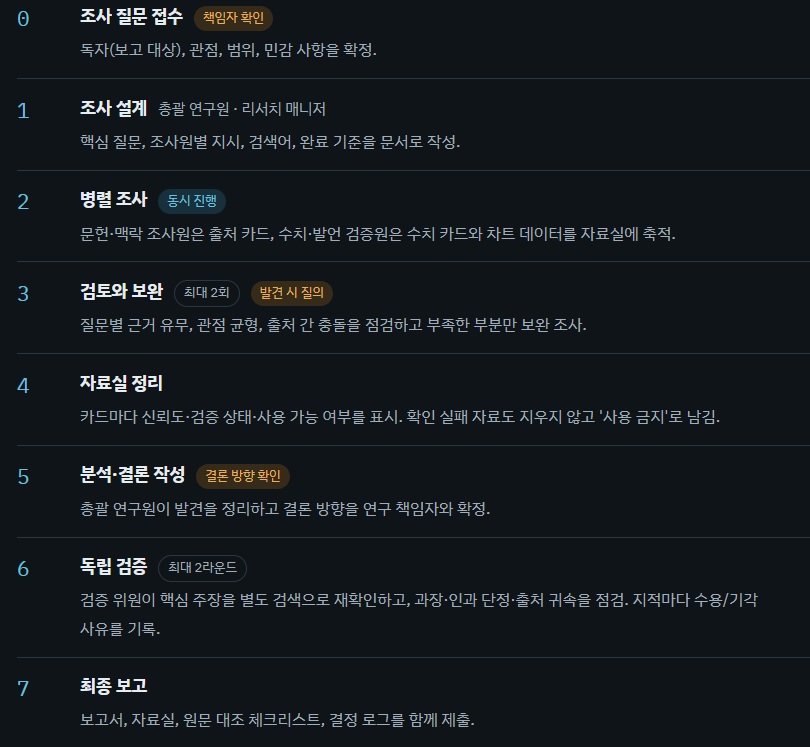
4/5 게시물은 저자가 설계한 조사 순서를 그림으로 싣는다. 저자는 용도에 맞게 고쳐 쓰라고 다시 적는다. 순서는 0~7의 여덟 단계다. 0단계 ‘책임자 확인’과 5단계 ‘결론 방향 확인’은 연구 책임자를 명시한다. 3단계 ‘발견 시 질의’는 묻는 상대를 적지 않는다. 반복 상한은 3단계(최대 2회)와 6단계(최대 2라운드)에 붙는다.
4/5 게시물 그림의 조사 순서를 옮긴 표. ‘맡는 역할’ 칸은 그림에 이름이 적힌 역할만 적는다. 그림에 이름이 없는 칸은 —다. ‘꼬리표’ 칸은 단계 이름 옆 표시다. 그림에서 주황색 꼬리표(책임자 확인, 발견 시 질의, 결론 방향 확인)는 질의·확인 지점이다. 회색 꼬리표(최대 2회, 최대 2라운드)는 반복 상한이다. 파란색 꼬리표(동시 진행)는 두 조사원이 한꺼번에 일한다는 표시다.
단계
이름
맡는 역할
하는 일
꼬리표
0
조사 질문 접수
—
독자(보고 대상)·관점·범위·민감 사항을 확정한다.
책임자 확인
1
조사 설계
총괄 연구원·리서치 매니저
핵심 질문·조사원별 지시·검색어·완료 기준을 문서로 쓴다.
—
2
병렬 조사
문헌·맥락 조사원, 수치·발언 검증원
문헌·맥락 조사원은 출처 카드를, 수치·발언 검증원은 수치 카드와 차트 데이터를 자료실에 쌓는다.
동시 진행
3
검토와 보완
—
질문별 근거 유무·관점 균형·출처 간 충돌을 점검한다. 부족한 부분만 보완 조사한다.
최대 2회, 발견 시 질의
4
자료실 정리
—
카드마다 신뢰도·검증 상태·사용 가능 여부를 표시한다. 확인에 실패한 자료도 지우지 않고 ‘사용 금지’로 남긴다.
—
5
분석·결론 작성
총괄 연구원
발견을 정리한다. 결론 방향을 연구 책임자와 확정한다.
결론 방향 확인
6
독립 검증
검증 위원
핵심 주장을 별도 검색으로 다시 확인한다. 과장·인과 단정·출처 귀속을 점검한다. 지적마다 수용·기각 사유를 기록한다.
최대 2라운드
7
최종 보고
—
보고서·자료실·원문 대조 체크리스트·결정 로그를 함께 낸다.
—
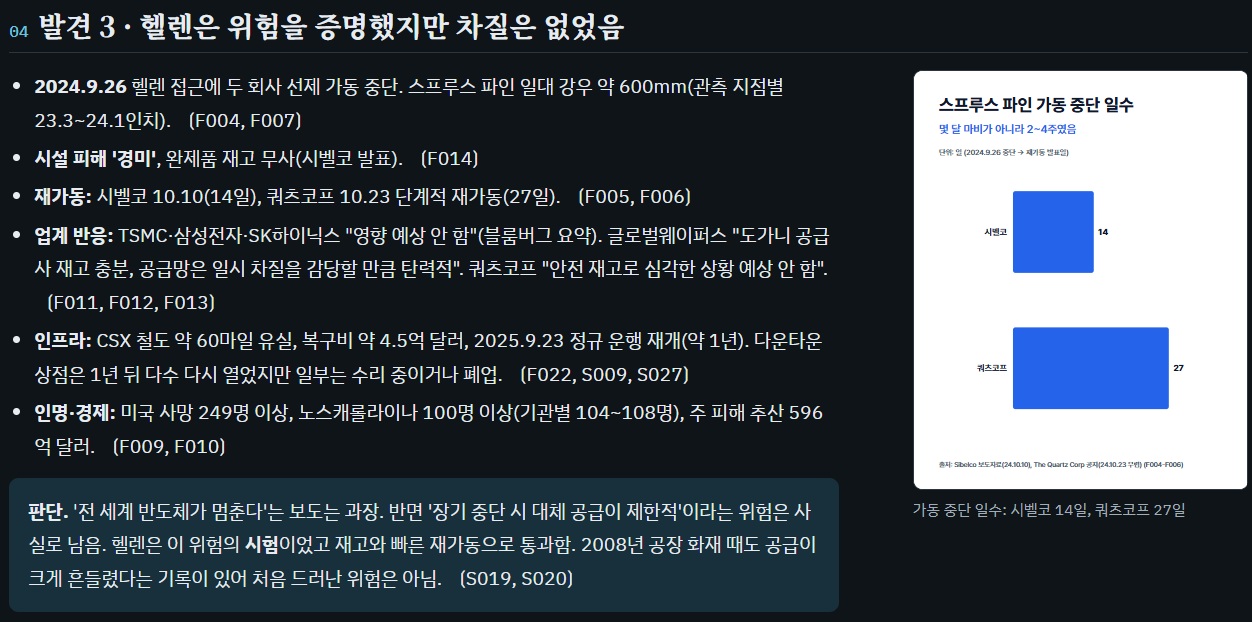
3/5 게시물은 총괄 연구원이 조사원들이 가져온 내용을 요약해 결론을 낸다고 쓴다. 표의 5단계가 그 자리다. 같은 게시물의 둘째 그림이 그 결과물의 예다. 예시 보고서의 ‘04 발견 3’ 쪽은 항목마다 근거 카드 번호를 단다. 쪽 끝의 ‘판단’ 상자가 결론을 적는다.
3/5 게시물 둘째 그림. 예시 보고서의 발견 3 쪽이다. 항목마다 날짜·수치와 근거 카드 번호(F·S)가 붙는다. 막대그래프는 가동 중단 일수를 시벨코 14일, 쿼츠코프 27일로 그린다. ‘판단’ 상자는 ‘전 세계 반도체가 멈춘다’는 보도를 과장으로 본다. 장기 중단 때 대체 공급이 제한된다는 위험은 사실로 남는다고 적는다.
저자는 애널리스트 대신 이 체계에 조사를 맡기되 최종 검수는 사람에게 남긴다
저자는 자기소개란에 4개국 거주, 미국 은행 런던 오피스 15년차 Director, 『얼음별로 떠나는 아이슬란드 여행』 저자라고 적는다. 3/5 게시물은 목적에 맞게 쓰면 된다는 단서를 먼저 단다. 저자 자신의 용도는 회사의 산업·매크로 분석 업무와 Threads 글쓰기 자료 조사다. 09:50 KST 답글에서는 이 체계를 “업무 보조용”으로 만들었다고 적는다.
5/5 게시물은 만든 계기를 적는다. 저자는 이 체계를 만든 뒤 자기 밑 애널리스트에게 조사를 시키지 않는다. 그 애널리스트들도 요즘은 AI로 조사한다. 저자는 그들이 “AI 슬랍”을 하도 가져와 답답해서 직접 만들었다고 쓴다.
같은 게시물에서 저자는 업무나 글쓰기에 쓸 때 최종 검수는 사람이 해야 한다고 쓴다. 어떤 방향으로 쓸지도 사람이 정한다는 것이다.
역할을 나누면 느려지지 않느냐는 질문도 있었다. @hyung.dds(13:37 KST)는 역할별 팀으로 ‘비둘기 산책 메타버스’를 만들다 답답해 다 뜯어냈다고 썼다. 저자는 15:58 KST 답글에서 자료 조사용이라 빠를 필요가 없다고 답했다. 코딩용이 아니어서 좀 느려도 괜찮다는 것이다.
저자는 프롬프트 대신 이 스레드를 Claude Code에 넣으라고 안내한다
스레드는 프롬프트를 싣지 않는다. 5/5 게시물은 프롬프트가 궁금하면 스레드 글과 사진을 Claude Code에 넣어 똑같이 만들어 달라고 하라고 쓴다. 저자가 답글에서 밝힌 제작 도구와 조건은 아래 표와 같다.
만드는 법을 묻는 댓글과 저자의 답. 시각은 2026-11-07 KST다. 따옴표 안은 저자의 원문이다.
시각
댓글의 질문
저자의 답
09:50
@samgakgimbap_in_us: 이것을 Claude로 했느냐
Claude Opus 5.5로 만들었다. 만든 지는 꽤 됐다. 필요할 때마다 조금씩 덧붙여 지금 모습이 됐다.
따라 만든 결과를 적은 댓글로 @mine.love.sun(10:23 KST)의 글이 있다. 그는 Claude Code에 지시했더니 할 수 있는 부분과 없는 부분을 구분해 고쳐 만들어 줬다고 썼다. 다음 주 연구원 대상 1박 2일 교육에 응용하겠다는 말도 붙였다. 이 밖의 저자 답글은 감사·응원 댓글에 대한 인사다.
비판 댓글 둘은 이 구성을 비효율과 ‘느낌’으로 본다
@itemcurator_threads(13:52 KST)는 이 구성을 “가장 있어보이는 쓰잘데기 없는”, “가장 비효율적인 구성”이라 부른다. 그는 “언제적 멀티에이전트야”라고 덧붙인다.
@ai.rusk(17:43 KST)는 ‘장점’이라는 머리말 아래 쓴다. 그에 따르면 실제 결과물은 그냥 “이거해줘”라고 시킨 것과 똑같다. 남는 것은 복잡하고 체계적으로 진행되는 느낌이다. 그는 여기서 “에이전트”가 마크다운(md) 파일로 준 지침일 뿐이라고 덧붙인다.
저자는 두 댓글 모두에 결과물이 크게 뛰어나지 않다고 답했다(첫 표의 15:57·17:55 줄). 비효율 지적과 md 파일 지적에는 답하지 않았다. 효율을 두고는 덧붙임의 ‘토큰 대비’ 문장이 저자 쪽 말로 남는다.
규모를 키운 사례도 댓글에 올라왔다. @eugenekim.photo(13:34 KST)는 Grok 봇의 에이전트 22개를 ChatGPT가 총괄한다고 썼다. 저자는 16:00 KST 답글에서 “총괄 지피티가 머리가 터지겠군요”라고 답했다.
@ai.rusk와 저자는 결과물이 상위 모델 하나에 맡긴 것과 크게 다르지 않다는 데서 만난다. 갈리는 곳은 정리·검증 편의다. 저자는 그 편의를 계속 쓰는 이유로 든다. @ai.rusk에게 그것은 체계적으로 진행되는 ‘느낌’이다.
팩트체크
총괄·검증 에이전트 구조와 예시 보고서의 사실은 공개 자료와 맞지만 ‘검증 위원이 없으면 엉터리’와 ‘아무나 할 수 있다’는 조건이 빠진 주장이다
B
구조 설명과 예시 보고서의 사실 10건 중 9건은 1차 출처와 맞는다. ‘검증 위원이 없으면 엉터리’는 연구가 받치는 폭보다 세다. ‘아무나’와 ‘계정 하나로’에는 Claude 유료 요금제 조건이 빠졌다.
판정 기호와 건수
✅ 사실
🟡 부분 사실
⚠️ 불확실
❌ 거짓
💬 의견·예측
1차 출처와 일치한다
일부만 맞거나 수치·범위가 다르다
원문 근거가 없거나 1차 자료로 판정할 수 없다
1차 출처와 어긋난다
의견·예측·경험 진술이라 참거짓을 가리지 않는다
12건
7건
3건
0건
4건
등급: A 1차 출처와 일치, 차이는 표기 수준 · B 세부 오류 일부 · C 핵심 주장 일부 오류 · D 핵심 주장 다수 오류 · F 핵심 주장이 거짓.
방법론 주장
✅
원문 주장(1/5 ③④): “나는 다른 에이전트랑 얘기하지 않고 총괄연구원인 에이전트 5랑만 얘기함” · “가이던스를 줄 때도 에이전트 5한테 주고 알아서 에이전트들에게 뿌리라고 해야함”
이 배치는 Anthropic이 2025-06-13 공개한 Research 기능의 orchestrator-worker 패턴과 같다. 리드 에이전트가 질문을 쪼개 하위 에이전트에게 맡긴다. 하위 에이전트는 각자 검색한 결과를 리드에게 돌려준다. 마지막 단계의 CitationAgent는 주장마다 출처 위치를 붙인다. 원문의 자료실이 이 자리를 맡는다.
차이는 역할 고정 여부다. Anthropic의 하위 에이전트는 질문마다 개수와 과제가 바뀐다. 원문은 다섯 역할을 미리 정한다.
원문 주장(2/5 ⑤): “조사원들이 조사한 내용을 독립적으로 크로스체크 하면서 정확도를 높여주는 역할을 함. 없으면 엉터리 조사결과가 나옴”
검증 단계가 실패를 줄인다는 측정은 있다. Cemri 외(2025)는 멀티 에이전트 프레임워크 7종의 실행 기록 1,600건 이상을 분류했다. ChatDev에 과제 목표 검증 단계를 더하자 과제 성공률이 +15.6% 나아졌다. 같은 논문은 검증 에이전트 다수가 컴파일 여부 같은 겉핥기 점검에 그친다고 적는다. Kim 외(2025)의 비교에서 검증 병목이 없는 독립형 구조는 오류를 17.2배로 키웠다. 중앙 조정 구조는 4.4배였다.
검증 방식도 결과를 가른다. Huang 외(2023)는 외부 피드백 없이 같은 모델이 답을 고치면 추론 성능이 오히려 떨어지기도 한다고 보고한다. Chain-of-Verification(Dhuliawala 외 2023)은 검증 질문에 초안과 따로 답하게 해 환각을 줄였다. 원문의 조사 순서 6단계는 검증 위원에게 핵심 주장을 별도 검색으로 다시 확인하게 한다. 외부 근거를 쓰는 쪽이다.
원문 ‘없으면 엉터리’ → 확인 ‘검증 단계가 있으면 실패가 줄어든다, 검증자 자신도 겉핥기에 그치기 쉽다’.
원문 주장(3/5 ⑦): “Devil's Advocate 역할을 하는 검증 위원의 역할이 중요함. 아래 통념 판정을 읽어보면 내용을 이해하는데 도움이 많이 됨”
작성자의 사용 경험이라 참거짓을 가리지 않는다. 가까운 실험은 Chiang 외(IUI 2024, Purdue University)다. 연구진은 사람 집단이 AI 추천을 받아 결정하는 과제에 LLM 반론자를 넣었다. 대화에 맞춰 AI 추천을 반박하는 반론자가 AI에 대한 적절한 의존을 높였다. 효과는 주로 학습 분포 안의 문제에서 나왔다. 보고서 독자의 이해도를 잰 연구는 아니다.
원문 주장(5/5 ⑩): “프롬프트가 궁금하다면, 그냥 위에 내용이랑 사진 드레그해서 클로드 코드한테 넣고 똑같이 만들어달라고 하면돼” — Claude Code로 이 구조를 만들 수 있다는 부분
Claude Code 공식 문서가 필요한 기능을 모두 적는다. 하위 에이전트는 .claude/agents/ 폴더의 마크다운 파일 하나로 정의한다. Claude에게 부탁해 그 파일을 만들게 할 수 있다. 하위 에이전트는 기본값으로 본 대화 아래 세 층까지 자기 하위 에이전트를 띄운다. 총괄 → 매니저 → 조사원 위계가 이 한도 안에 든다. 이미지는 Ctrl+V로 프롬프트에 붙여 넣는다.
작성자는 에이전트 정의 파일과 프롬프트를 공개하지 않는다. 결과물을 원본과 대조한 사례도 원문과 답글에 없다. 답글 하나(@mine.love.sun, 2026-11-07 10:23 KST)는 Claude Code가 ‘할 수 있는 부분 없는 부분’을 나눈 뒤 고쳐서 만들었다고 적는다. 같은 구조가 나오는지 판정할 근거가 없다.
🟡
원문 주장(1/5 도입): “사실 아무나 할 수 있는거라서 그냥 공개할게”
원문의 방법은 Claude Code를 전제로 한다. Claude Code는 Pro·Max·Ultra·Team·Enterprise 또는 Console 계정이 있어야 쓴다. 무료 claude.ai 요금제에는 Claude Code가 없다. 원문 ‘아무나’ → 확인 ‘Claude 유료 요금제나 Console 계정 사용자’.
작성자 소개 ‘미국은행 런던 오피스 15년차 Director’는 Threads 프로필의 자기소개라 판정하지 않는다.
⚠️
원문 주장(덧붙임, 2026-11-07 09:42 KST): “사실 그냥 상위모델 써서 조사시키는거랑 결과면에서 어마어마한 차이는 안남” — 같은 취지의 답글 5건
작성자는 비교 측정을 내지 않는다. 공개 측정은 과제 유형에 따라 갈린다. Anthropic 내부 리서치 평가에서 Claude Opus 4 리드와 Claude Sonnet 4 하위 에이전트 구성은 Claude Opus 4 단독보다 90.2% 높았다. Anthropic은 이 구성이 여러 방향을 동시에 찾는 넓은 질문에서 특히 강하다고 적는다. Kim 외(2025)는 도구·프롬프트·계산량을 같게 놓고 260개 구성을 비교했다. 단독 대비 상대 성능은 분해 가능한 금융 추론 +80.8%에서 순차 계획 −70.0%까지 퍼졌다.
같은 논문에서 단독 에이전트 정확도가 45%를 넘는 과제는 에이전트를 더하자 성능이 떨어졌다. 작성자의 경험은 이 상한 효과와 같은 방향이다. Cognition의 Walden Yan(2025-06-12)은 2025년의 협업형 멀티 에이전트를 깨지기 쉬운 구조로 본다. 하위 에이전트끼리 맥락을 못 봐 결정이 충돌한다는 이유다. 작성자 시스템의 수치가 없어 판정할 수 없다.
작성자는 토큰 사용량을 내지 않는다. Anthropic 측정으로 에이전트는 채팅의 약 4배, 멀티 에이전트 시스템은 약 15배 토큰을 쓴다. Anthropic은 과제 가치가 이 비용을 감당할 때만 경제성이 있다고 적는다. 작성자 말대로 결과가 상위 모델 단독과 비슷하다면 더 쓴 토큰만큼 효율이 떨어진다. 비교 대상이 ‘에이전트 사무실’ 같은 더 큰 구성이라면 판정할 자료가 없다.
역할 분담이 빈틈을 막으려면 과제 경계가 필요하다. Anthropic은 하위 에이전트마다 목표·출력 형식·도구와 출처 지침·과제 경계를 주라고 적는다. 지시가 짧았던 초기 버전에서는 하위 에이전트들이 같은 검색을 되풀이했다. 한 에이전트가 2021년 차량용 반도체 위기를 조사하는 동안 다른 둘은 2025년 공급망을 겹쳐 조사했다. 원문 ‘역할을 나누면 빼먹지 않는다’ → 확인 ‘역할마다 과제 경계를 적어야 빈틈과 중복이 준다’.
원문 주장(답글, 2026-11-07 15:55 KST): 질문 “클로드 계정 하나로 별도의 로컬 PC 없이도 오퍼스만으로 5개 에이전트들 만들고 협업을 시킬 수가 있는 건가요?”에 “넹넹 맞습니다”
로컬 PC 없이 도는 Claude Code 클라우드 세션이 있다. Pro·Max·Ultra·Team 요금제와 Enterprise 프리미엄 좌석에서 쓸 수 있다. 클라우드 세션은 GitHub를 연결해 저장소를 복제한다. 저장소의 .claude/agents/ 정의도 그대로 불러 하위 에이전트를 띄운다. 하위 에이전트 요청은 본 대화와 같은 사용 한도에서 차감된다. Pro 이상 요금제에서 Claude Code 기본 모델은 Opus 5.5다.
원문 주장(답글, 2026-11-07 15:55 KST): “제미나이는 구글 AI studio나 안티그래비티로 구현이 가능한데 사실 구글 아르곤 쓰시면 결과면에선 비슷해요”
답글이 든 제품은 모두 있다. ‘구글 아르곤’은 Google이 2026-10-13 전 세계에 출시한 Gemini 4 Argon이다. 개발자는 AI Studio에서 Gemini API 유료 등급으로 Argon을 쓴다. Antigravity는 Google의 에이전트 개발 플랫폼이다. 개인 사용자가 Antigravity에서 Argon을 쓰려면 Google AI Ultra 구독이 필요하다. Google 발표문은 Antigravity에서 커스텀 스킬과 멀티 에이전트 루프로 만든 사례를 싣는다.
예시 보고서(자료실 S003, 통념 판정): Bloomberg 2024-10-02 “Chip Firms Monitor Quartz Supplies After Hurricane Hits Mines” · “BNEF는 ‘상업용 HPQ 80% 이상’” · 삼성·SK하이닉스 “공식 입장은 영향 예상 안 함”
Bloomberg 기사는 2024-10-02 게재됐다. 공유용 제목은 ‘Chip Firms Monitoring Quartz Supplies After Hurricane Hits Mines’다. 본문 제목은 ‘Chip Firms Watching Quartz Supply After Hurricane Shut Mines’로 바뀌었다. 보고서 표기와는 동사 형태만 다르다.
Taipei Times 2024-10-04 전재본에서 BloombergNEF는 2023년 보고서를 근거로 두 광산을 상업용 고순도 석영 공급의 80% 이상으로 본다. TSMC·Samsung Electronics·SK Hynix는 영향을 예상하지 않는다고 밝혔다. Sibelco와 The Quartz Corp의 가동 중단일은 2024-09-26(목)이다. 보고서의 가동 중단 일수 14일·27일은 이 날짜에서 센 값과 맞다.
예시 보고서(발견 3): “미국 사망 249명 이상, 노스캐롤라이나 100명 이상(기관별 104~108명)”
원문 249명 이상 → 확인 250명 이상. WRAL이 2025-09-24 기사에서 낸 집계다. 같은 기사는 국립허리케인센터(NHC) 자료로 노스캐롤라이나 사망자를 107명으로 적는다. 보고서의 104~108명 범위 안이다. 2026-02-17 개정 NHC 보고서는 노스캐롤라이나를 직접 사망 85명과 간접 사망 22명으로 나눈다. 2025-03-19 공개된 첫 보고서는 노스캐롤라이나를 105명으로 적었다.
WLOS 2026-07-01 기사와 The Quartz Corp 2026-06-30 공지가 같은 내용을 싣는다. 폐쇄 대상은 스프루스 파인 Altapass Highway의 생산 시설 1곳이다. 감원 규모는 20–30명이다. 회사는 배경으로 태양광 산업의 지속 손실을 든다. 회사 대변인은 헬렌과 관련이 없다고 밝혔다.
예시 보고서(추천 읽기 S016): “Tom's Hardware, 중국 석영의 반도체 인증 보도 (2026.9)”
Anton Shilov의 Tom's Hardware 기사는 2026-09-10 게재됐다. 중국 Jiangsu Pacific Quartz의 석영 제품이 중국 DRAM 제조사의 인증을 통과했다는 내용이다. 기사는 실리콘 잉곳용 도가니 등급 석영을 대량으로 내는 곳을 스프루스 파인의 Sibelco와 The Quartz Corp로 적는다. 소량은 Russian Quartz LLC가 만든다. 보고서 통념 판정의 ‘세계 유일 산지 → 틀림’도 이 서술과 맞는다.
원문 ‘수치/도표(정량적) 조사원’ → 조직도 ‘수치·발언 검증원’(researcher-facts). 조직도의 업무 칸은 ‘1차 출처 추적 · 교차 검증 · 차트’다. 조사 순서 사진(4/5)의 2단계도 이 역할을 ‘수치·발언 검증원’으로 부른다. 조직도 기준으로 에이전트 2는 수치 수집과 발언 검증을 함께 맡는다. 교차 검증은 검증 위원의 ‘사실 확인’과 겹치는 업무다.
💬
원문(5/5 ⑩) “특히 나같이 뭔가 조사해야하는 업종은 진짜 생산성이 차원이 달라진다”와 덧붙임 “결과면에서 어마어마한 차이는 안남”
두 문장은 서로 다른 것을 잰다. 작성자가 답글에서 드는 이점은 정리와 검증의 편의다. 결과 품질에도 생산성에도 측정은 없다. 경험 진술이라 참거짓을 가리지 않는다.
7. 목적이나 원하는 용도에 맞게 사용하면되는데, 나는 회사에서 하는 산업/매크로 분석 업무랑 스레드 글쓰기를 위한 자료 조사 용도로 만들었거든. 특히 조사하다 발견한 주장이나 속설, 아니면 내용을 제대로 이해하지 못할 경우 나올 수 있는 주장에 대해 Devil's Advocate 역할을 하는 검증 위원의 역할이 중요함. 아래 통념 판정을 읽어보면 내용을 이해하는데 도움이 많이 됨
8. 총괄 연구원이 조사자들이 가져온걸가지고 중요 내용들을 요약해주고 결론을 내려줌
게시물 3 첨부 그림 1 — 통념 판정 표게시물 3 첨부 그림 2 — 보고서 '발견 3' 절과 가동 중단 일수 차트