1,000
지난달 머지한 PR 수. 본인 표현으로 "ridiculous".
SpaceXAI 로런 탠의 55분 3초 워크숍 완역 — 신뢰 곡선, 검증 스킬, CI로 강제한 아키텍처
에이전트를 믿을 수 있게 만드는 일은 태도의 문제인가, 기계의 문제인가.
동시에 돌릴 수 있는 에이전트 수는 의지가 아니라 신뢰의 함수다. 그리고 신뢰는 규칙을 말해서 생기지 않는다. 컴파일러·린트·CI가 실패로 되돌려줄 때 생긴다. 발표자가 55분 동안 하는 말은 결국 이 한 문장의 증명이다.
CDP는 그 브라우저 엔진을 외부에서 조종하는 프로토콜이다.예상 소요 — 요약과 팩트체크만 6분. 완역까지 읽으면 55분 발화 분량이라 40분 안팎.
문제는 에이전트를 몇 개 돌리느냐가 아니라 에이전트를 얼마나 믿느냐이고, 그 신뢰는 태도가 아니라 기계 강제 — 검증 스킬 · eval · 린트/컴파일러/CI — 로만 만들어진다.
로런 탠(Lauren Tan)의 55분 3초 워크숍. 진행자는 콜린(Colin). 발화자는 Cursor 합류 5개월 차이며, 자기 에이전트가 자동 머지한 PR을 아침에 사후 리뷰하는 지점까지 올라왔다고 말한다. 아래는 이 영상에서 실제로 말해진 주장의 목록이다.
지난달 머지한 PR 수. 본인 표현으로 "ridiculous".
이번 달 12일까지 이미 랜딩한 PR 수.
오늘 아침 일어나 보니 에이전트가 자동 머지해 둔 PR. main에서 사후 리뷰했다.
GrokBot 전체를 Dune 아키텍처로 리팩터링하는 데 쓴 PR 수.
슬라이드 GitHub 카드에 찍힌 commits 수 (poteto · #6).
슬라이드 손글씨 자막 "i shipped 3000+ PRs in 5 months".
60 FPS를 지키려면 프레임 하나에 허용되는 시간. 이걸 넘기면 long task, 프레임 드롭.
영상 총 길이. 무대 발표 + 화면 공유 + 원격 Q&A 하이브리드.
control-glass는 Cursor에서 만든 첫 스킬 중 하나다. Glass는 agents window의 사내 코드명이다.control-glass에서 시작해 스킬이 하나씩 쌓였을 뿐이다.how는 관찰에서 나왔다. 툴 콜을 열어 보니 에이전트가 원인이라고 단정한 코드를 실제로는 읽지도 않았다.slash loop로 10/10까지 반복). 편향 방지용으로 다른 모델의 judge 에이전트를 교차 배치한다.useEffect는 금지다. 쓰면 CI가 실패한다.electron-main/electron-renderer 디렉터리를 두고 dependency graph를 CI에서 검사해 교차 import를 막는다. 격리가 부실하면 렌더러 스레드에 무거운 코드가 딸려 들어와 16 ms 예산을 넘긴다.영상 안에서 화자가 한 기술적 주장은 대체로 확인되지만, 이 영상을 실어 나른 X 글이 큰따옴표로 화자에게 귀속시킨 핵심 인용문은 55분 전사 어디에도 없다 — 검증 대상이 두 층으로 갈린다.
"99% of people using GrokBot just for 1% of its real power … I have a Chief of Staff agent, a PM agent and 20+ workers - that's the new stack" — X 글이 큰따옴표로 화자에게 붙인 문장.
55분 3초 전사 전문을 기계 대조한 결과 "Chief of Staff"·"PM agent"·"fully autonomous"·"new stack"·"1% of"는 등장 횟수 0이다. "20+"도 0이며, 실제 발화는 에이전트 수가 아니라 "I woke up today and I had like 20 PRs merged"로 PR 건수다. "99%"는 한 번 나오지만 [38:52]에서 "99% of the time agents just write code comments"로 코드 주석 금지 이야기이지 사용자 비율이 아니다. 조직 비유도 Chief of Staff가 아니라 주방(head chef / sous chef / line cooks)이다. 영상의 실제 권고는 오히려 반대에 가깝다 — [26:22] "I would definitely encourage you not to try to jump … spawn a hundred or thousands of cloud agents right now, because you're just going to waste a lot of tokens." 문장 골격은 같고 숫자만 다른 변형이 2026-09-02판("3 managers and 11 workers"), 2주 전 @0xCodez판("15+ agents"), 이 글(20+)로 이어져 재유통 과정에서 불어난 정황이 있다. 저자가 지지하려 한 논지의 1차 출처는 이 인용문이 아니라 화자 본인 계정의 pstack 연재다 — "verification is the foundation of everything I do with agents".
"1시간 세션에서 처음부터 효과적인 AI 에이전트 팀을 구축하는 방법을 보여줬다."
분량은 맞다 — 55분 3초이고 형식도 워크숍이다. 내용이 다르다. 세션의 축은 에이전트 팀의 편성·역할 분담·오케스트레이션 구성이 아니라 검증과 강제 체계를 짓는 일이다: 검증 스킬, eval, CI/린트/컴파일러 강제, 피처 맵, 리팩터링 판단. 화자는 Dune 다섯 계층(코드베이스 / 정적 분석 / 룰·Bugbot / 스킬 / 스타일 가이드)을 들고 신뢰 곡선을 먼저 올리라고 말하며, 에이전트 수를 늘리는 구성법은 다루지 않는다. "팀 구축"이라는 요약은 결과(에이전트 여러 대가 돌아간다)를 방법(그 팀을 어떻게 짜는가)으로 바꿔 읽은 것이다.
"$500짜리 에이전틱 엔지니어링 코스보다 가치 있다."
검증 가능한 명제가 아니다 — 비교 대상 코스가 특정되지 않고 가치 척도도 없는 마케팅 수사다. 다만 정황 하나는 기록해 둘 만하다. 커뮤니티(Skool) 게시물이 본인의 pstack 문서 연재를 소개하며 "This is not the Maven recording"이라고 구분하는데, 이는 이 영상이 Maven에서 진행된 유료·등록형 세션의 녹화라는 쪽을 가리킨다. 그렇다면 "무료로 이만한 것"이라는 함의는 원본의 배포 조건과 어긋날 수 있다. 확정은 못 한다.
답글 @toha_volovuk: "SpaceX 직원이 아니다 / 브랜드를 사칭하고 있다."
관찰은 맞고 결론이 틀렸다. 그가 본 것 — 썸네일의 SPACEX 백드롭, 그리고 노란 가라오케 자막이 구워진 화면 — 은 실재한다. 이 영상이 원본 녹화 그대로가 아니라 소셜용으로 재편집된 컷이라는 점도 사실이다. 그러나 화자의 소속은 반증된다. 본인 X 계정 @poteto는 SpaceXAI 소속으로 Grok Bot·Cursor 관련 게시를 이어 가고 있고, LinkedIn 프로필은 "Building Grok Bot and Cursor @ SpaceXAI", Principal Engineer로 적고 있으며, 영상 슬라이드의 로어서드 자체가 "Lauren Tan | Software Engineer, SpaceXAI"다. 사칭이 아니라 재편집이며, 재편집 흔적을 사칭의 증거로 읽은 것이 오류다.
"오늘 이 워크숍을 시청하세요" — 게시 글은 녹화 시점을 밝히지 않는다.
녹화일은 2026-08-12로 좁혀진다. 영상 안의 세 신호가 같은 날을 가리킨다 — [49:23] "we actually announced Grok 4.6 today", [31:xx] Grok Bot이 "we just launched yesterday", [04:18] "this month, we're only on the 12th". 게시일은 2026-09-17이므로 36일 시차다. 시차 자체가 오류는 아니지만, 글이 그 사실을 적지 않은 채 현재형으로 권하면 "오늘 발표했다"는 발화가 게시 시점의 사실처럼 읽힌다. 게시 시점에 Grok 4.6은 한 달 넘은 모델이다.
"아래 기사에서 GrokBot 에이전트 함대를 구축하는 방법을 읽어보세요."
2026-09-18에 해당 스레드를 스크롤까지 포함해 실측했을 때 DOM에 그런 링크가 없다. 독자가 안내대로 따라갈 대상이 존재하지 않는다. 이후 추가되었거나 이전에 삭제되었을 가능성은 이 확인의 범위 밖이며, 판정은 실측 시점 기준이다.
"지난달 1,000 PR, 이번 달 12일까지 약 800 PR, 5개월간 3000+ PRs."
근거는 화면에 띄운 GitHub 기여 카드("poteto · 3,159 commits · #6")와 본인 슬라이드 손글씨뿐이다. 둘 다 자기보고이고, 사내 저장소 활동이라 외부에서 독립 검증할 방법이 없다. PR과 커밋은 같은 단위도 아니다. 다만 자릿수는 다른 경로의 보도와 같은 계열이다 — 뉴스레터 한 곳은 같은 인물을 "2,000 PRs a month"로 소개한다. 수치를 부정할 근거도, 확인할 근거도 없으므로 자기보고로 표기해 두는 것이 정확하다.
"Grok 4.6은 4.5와 토큰당 비용이 같은데 더 똑똑하다." (화자 본인이 "hopefully I'm not saying this incorrectly"라고 단서를 달았다)
표시가격 기준으로는 맞다. 공개 당일자 정리 기사는 4.6이 4.5와 같은 100만 토큰당 $2 입력 / $6 출력을 유지했다고 적는다. 단서가 둘 있다. 프롬프트가 20만 토큰을 넘어가면 요청 전체가 입력 $4 / 출력 $12로 두 배가 되고, 캐시된 입력 단가는 이전 버전보다 소폭 올랐다는 정리가 있다. 즉 짧은 컨텍스트에서는 발화대로이고 긴 컨텍스트에서는 조건이 붙는다. 본인의 유보와 같은 방향이다.
"Gary Tan은 Y Combinator CEO이고 GStack이라는 플러그인을 만들었다. pstack은 그걸 흉내 낸 내 버전이다."
둘 다 확인된다. gstack은 Y Combinator CEO Garry Tan이 공개한 저장소로 실재하며, 저장소 설명은 "Garry Tan's exact Claude Code setup: 23 opinionated tools that serve as CEO, Designer, Eng Manager, Release Manager, Doc Engineer, and QA"다. 표기는 Gary가 아니라 Garry Tan이고, 엄밀히는 플러그인이라기보다 슬래시 커맨드·스킬 묶음이다. 성이 같지만 혈연이 없다는 본인 설명도 별도 반증 근거가 없다.
"React의 가장 큰 foot gun은 useEffect다. 그래서 Dune과 GrokBot에서는 금지하고 CI가 막는다."
업계 통설과 어긋나지 않고, React 공식 문서 자체가 같은 방향을 권한다 — "You Might Not Need an Effect"는 이펙트가 불필요한 곳에 쓰이면 버그와 성능 문제를 만든다며 제거 패턴을 열거한다. 다만 "가장 큰"이라는 최상급은 순위 주장이라 측정 대상이 아니다. 전면 금지는 이 코드베이스의 정책 선택이지 React의 권고는 아니라는 구분도 남는다.
"60 FPS를 원하면 매 프레임을 16 ms 안에 그려야 한다."
산술이 맞다. 1000 ÷ 60 ≈ 16.67 ms이고, 화자는 이어서 "16 ms를 넘기는 long task"를 프레임 드롭의 원인으로 지목한다. 렌더러 스레드와 메인 스레드 격리가 나쁘면 무거운 연산이 렌더러로 끌려 들어와 이 예산을 먹는다는 설명도 Electron의 스레드 모델과 일치한다.
"GrokBot은 어제 출시된 새 애플리케이션이다." (녹화 시점 기준)
영상 내부 신호 셋이 서로 맞물린다 — [04:18]의 "we're only on the 12th", [49:23]의 "Grok 4.6 announced today"(공개일 2026-08-12), 그리고 이 발화의 "yesterday". 세 개를 겹치면 출시일은 2026-08-11이 된다. 주의할 점 하나를 남긴다: 제조사 뉴스 페이지의 해당 주소는 이번 확인 시점(2026-09-18)에 404를 반환해 1차 페이지로 재현하지 못했고, 판정은 영상 내부 정합성과 2026-08-12자 외부 기사에 기댄다.
영어 음성의 한국어 완역이다. 전사는 로컬 Apple Silicon, mlx-community/whisper-large-v3-turbo, 2026-09-18, 1분 50초 소요. 반복·잡음으로 제거한 구간은 없다. 화자 라벨은 내용 추정이다. <time>은 발화 시작 시각이다.
개인적으로 AI의 가장 좋은 쓰임새는 페어 프로그래밍 상대에 가깝다고 생각한다. 코드를 쓰는 행위 자체를 대체하는 도구가 아니고, 더 나쁘게는 사고를 외주 주는 도구도 아니다. 그리고 AI가 워낙 흥미롭다 보니 어디에나 AI를 집어넣고 싶어지고, AI에 밝은 사람으로 보이고 싶어지는 경향이 있다고 본다. 그래서 생산성을 올려야 한다, 이번 주에 100 PR은 쳐야 한다는 압박을 느끼고, 자기가 뭘 하는지도 거의 모르는 채로 바이브 코딩해서 100만 ARR까지 가겠다는 식이 된다.
그런데 내가 직접 겪은 것 중 하나는, AI를 쓰면 코드 쓰는 시간은 좀 아끼지만 정작 AI가 한 일을 리뷰하고 고치는 데 더 많은 시간을 쓰게 된다는 점이다. 그래서 많은 사람이 말하는 방식도 해봤다. AI에게 기능을 바로 만들라고 프롬프트하는 대신 먼저 스펙을 쓰게 하고, 그 스펙을 리뷰하고, 그다음에 진행하는 식이다. 그러면… 아, 제 화면 보이시죠?
콜린네, 보입니다. 잘 나와요.
네, 그래서 오늘 제게 큰 주제는 이거다. 에이전트로 코드를 쓰면서 — 여기 계신 많은 분들도 같은 경험을 하셨을 텐데 — 이걸 어떻게 신뢰할 것인가.
특히 아주 오랫동안 코드를 써온 엔지니어라면 좋은 엔지니어링에 대한 의견과 교훈이 많이 쌓여 있다. 그런데 에이전트가 그냥 감으로 밀어붙이고, 추측하고, 환각을 일으키고, 백 번째로 "결정적 원인을 찾았다"고 자신 있게 단정하는데 실제 문제는 그게 아닌 걸 보면 신뢰가 크게 깎인다. 그리고 에이전트를 별로 신뢰하지 않는 상태에서는 에이전트에서 최대치를 뽑아낼 수 없다고 느낀다. 나한테 이건 관리와 평행하다. 내가 팀의 엔지니어링 매니저이고 팀에 엔지니어들이 있는데 그들을 신뢰하지 않는다면, 내가 들어가게 되는 운영 모드는 마이크로매니지먼트다. 보고하는 사람들 어깨 너머로 일을 제대로 하고 있는지, 프로덕션에 버그를 내보내지는 않는지 확인하는 데 시간을 많이 써야 한다.
그래서 이 차트를 그렸다. 아주 과학적인 차트는 전혀 아니지만, 내가 에이전트를 쓰면서 지나온 여정이 이렇다고 스스로 상상한 그림이다. 1년쯤 앞으로, 아니 뒤로 돌려보면 — 에이전트로 코딩하는 사람이 없거나 많지 않던 때다. 그때는 하나 또는 몇 개, 한 줌 정도의 에이전트에 아주 깊이 붙어 있는 모드가 된다. 에이전트가 뭘 하고 있는지 계속 이해하려고 애쓰게 되고, 완전히 루프 안에 들어가 있다. 출력 하나하나를 다 지켜보고, 앉아서 계속 프롬프트를 넣는다. 그리고 그 이상으로는 병렬화가 되지 않는다. 다시 말하지만 신뢰가 없기 때문이다. 에이전트 하나의 출력도 믿지 못하는데 에이전트 100개를 띄울 수는 없다. 그런데 지난 5개월 동안 이 신뢰 곡선을 꽤 올라올 수 있었다고 느낀다. 지금은 — 이렇게 말하면 좀 무섭게 들리고 내가 슬롭 아티스트처럼 보이겠지만 절대 아니다 — 에이전트가 PR을 자동 머지하게 두고 있다. 말하고 보니 정말 이상한 얘기다. 오늘 아침에 일어나 보니 PR 20건이 이미 랜딩돼 있었고, 나는 그걸 main에서 사후에 리뷰했다. 이미 들어간 상태였고, 괜찮았다. 그래서 어떻게 거기까지 갔는지가 오늘 얘기하려던 것이다.
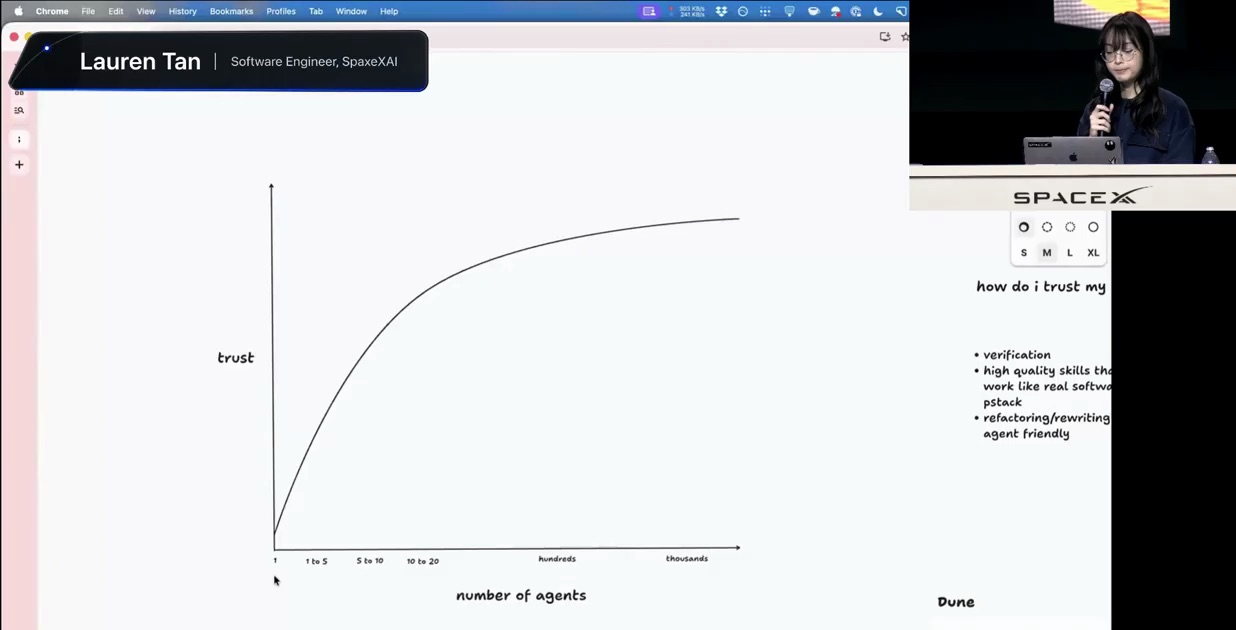
number of agents로 1 → 1 to 5 → 5 to 10 → 10 to 20 → hundreds → thousands, 세로축은 trust다. 오른쪽에는 "how do i trust my …"로 시작하는 아젠다와 verification / high quality skills … pstack / refactoring-rewriting … agent friendly 항목이 적혀 있고, 좌상단 로어서드에 "Lauren Tan | Software Engineer, SpaceXAI"가 붙어 있다.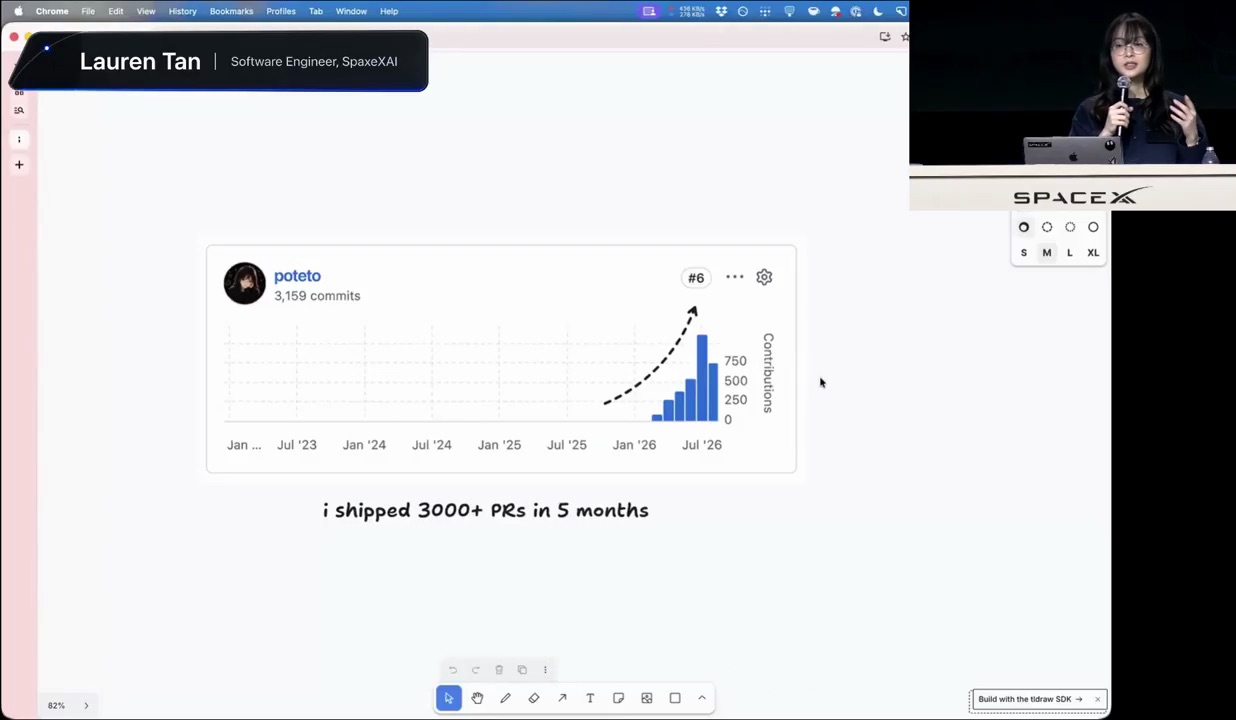
그리고 콜린, 질문 있으면 언제든 끊고 들어오셔도 된다. 아, 물론 이 차트를 보여드려야 하는데… 아니, 신뢰하면 안 되고… 누가 제 컴퓨터 제어 권한을 요청했다. 그건 아마 안 할 거다. 아무튼 이 차트는 자랑하려고 공유하는 게 아니라 여정을 보여주려고 공유하는 것이다. 보시면 곡선이 내가 Cursor에서 랜딩시킨 기여 수와 거의 반대로 대응한다. 나는 5개월 전에 합류했는데, 첫 달은 별로 생산적이지 않았다. 코드베이스를 배우는 중이었고 도대체 무슨 일이 벌어지는지 몰랐다. 그러다 에이전트에 대한 확신이 커지면서 생산성을 정말 끌어올릴 수 있었다. 지난달에는 1,000 PR을 쳤는데, 말도 안 되는 숫자다. 그리고 이번 달은 아직 12일밖에 안 됐는데 벌써 거의 800 PR을 랜딩시켰다. 속도는 확실히 높다. 그리고 많은 분들이 이 코드가 실제로 좋은 코드인지 의심하실 것이다.
그건 충분히 의심할 만하다고 생각한다. 하지만 에이전트를 잘 세팅하면 여러분도 아주 비슷한 수준까지 확실히 갈 수 있다고 본다. 그래서 그걸 어떻게 하는지 얘기하겠다. 콜린의 경험도 궁금하지만, 나한테 에이전트와 일할 때 도구함에 있어야 할 가장 중요한 스킬은 검증(verification)이다. 검증이란 에이전트가 실제로 코드를 실행하고, CPU 트레이스를 뜨고, 힙 스냅샷을 찍고, iOS 시뮬레이터를 열고 — 여러분의 애플리케이션이 사용자에게 노출되는 방식이 무엇이든 에이전트도 똑같이 해서 실제로 돌려보고 자기 작업을 테스트하고 검증하는 능력이다. 그게 루프를 닫아주는 것이기 때문이다. 그게 에이전트가 좋은 코드를 쓴다고 보장해주지는 않지만, 최소한 올바른 코드를 쓰게는 해준다. 에이전트를 신뢰할 수 있게 되는 데에는 정말 큰 진전이다. Cursor 안에서 쓰는 예시를 하나 공유하겠다… 앗, 이걸 좀 열어보면…
전체 화면으로. 자, 됐다. Cursor의 에이전트 윈도우 얘기인데, 사실 이건 재미있는 이야기다. 5개월 전 Cursor에 합류했을 때 나는 원래 다른 팀에 갈 예정이었다. 클라우드 에이전트 팀에 합류하기로 돼 있었다. 그런데 내가 React 경험이 많고 에이전트 윈도우가 React 애플리케이션이다 보니, 에이전트 윈도우 작업을 도와달라는 요청을 받았다. 그런데 나를 도와줄 스킬 같은 건 별로 없었다.
그래서 내가 처한 상황은 이랬다. 에이전트 윈도우가 일주일 뒤에 출시되고 마감이 아주 빡빡하다. 그래서 그냥 앉아서 Chrome 개발자 도구의 퍼포먼스 탭을 열고 트레이스를 떠서 이 플레임 그래프를 직접 들여다보며 이해해보려 했다. 게다가 나는 입사 첫 주였다. 내가 뭘 보고 있는지 전혀 몰랐다. 어느 정도 감은 있었지만 코드베이스는 완전히 처음이었다. 그리고 내 에이전트도 전혀 모른다는 걸 알게 됐다. 트레이스를 스크린샷으로 찍거나 트레이스를 내려받아 보내주면 "대충 이렇게 보이네요" 하고, 자신 있게 "이겁니다"라고 단정한다. 그래서 그걸 고쳐보면 실제 원인이 아니다. 아주아주 느린 과정이었다. 퍼포먼스 작업을 해본 적이 있거나, 검증 스킬 없이 에이전트와 개발해본 적이 있다면 아실 텐데, 그때는 여러분 자신이 검증자다. 즉 여러분이 병목이다. 에이전트에게 뭘 시키면 가서 코드를 쓴다. 그러면 로컬 개발 빌드를 열어보고 "어, 안 되는데" 하게 된다. 그러면 스크린샷이나 콘솔 에러 같은 걸 복사해서 붙여넣고, 에이전트가 그걸 가지고 천천히 이해하고 고치려 한다. 그러는 동안 여러분은 계속 루프 안에 있고 병목이다. 병렬화할 방법이 전혀 없다.
control-glass 스킬은 내가 Cursor에서 처음 만든 스킬 중 하나다. 참고로 Glass는 우리가 내부에서 에이전트 윈도우를 부르는 코드명인데, 결국 그냥 Cursor다. 이 스킬 자체는 코드가 딱히 흥미롭지는 않다. 여러분의 에이전트가 아주 쉽게 하나 만들어줄 수 있다. Electron 앱이든 웹 앱이든, 심지어 iOS 애플리케이션이든, 에이전트에게 CDP, 즉 Chrome DevTools Protocol을 쓰는 법을 가르치면 된다. Apple도 시뮬레이터를 돌리고 트레이스를 뜨고 프로그램으로 제어할 수 있는 유틸리티를 제공한다. 그래서 정말 유용하다. 그런데 내가 진짜 얘기하고 싶은 건 이거다.
README가 어디 있지? 이 스킬에는 피처 맵(feature map)이라는 아주 독특한 기능, 아니 독특한 파일이 딸려 있다. 이야기는 이렇다. 스킬을 만들었더니 에이전트가 실제로 에이전트 윈도우를 띄우고 트레이스를 뜰 수 있게 됐다. 그런데 에이전트 윈도우가 무엇인지는 전혀 몰랐다. 누가 "왼쪽 사이드바가 버벅인다"거나 "오른쪽 PR 탭이 작동하지 않는다"고 하면 에이전트는 그냥 허우적거렸다. 코드를 찾느라 시간을 많이 쓰고, 이 기능이 어디 있는지, UI에서 거기까지 어떻게 도달하는지를 몰라서 사실상 완전히 쓸모가 없었다. 로컬에서 이 스킬을 돌리면 개발 빌드가 뜨긴 하는데 계속 헛돌았다. 여기를 클릭해볼까 하면서 아무 데도 도달하지 못했다. 정말 끔찍한 경험이었다. 그런데 누가 제 화면에 화살표를 그리고 있죠? 아무튼 이 피처 맵은 에이전트에게 우리가 가진 모든 기능에 어떻게 도달하는지를 가르쳐주기 때문에 정말 유용했다. 그리고 내가 만든 플러그인 pstack에서 — Google에 "PStack cursor"로 검색하면 나온다 — create verification skill이라는 게 들어 있는데, 이게 피처 맵을 포함해서 이런 걸 직접 세팅하도록 도와준다. 실제로 코드를 탐색해서, 여러분이 가진 모든 기능에 에이전트가 어떻게 도달하는지 알려주는 초기 피처 맵을 만들어준다. 이게 엄청나게 강력한 이유는, 사용자 제보가 들어왔을 때 모호한 제보나 스크린샷 한 장까지도 매핑할 수 있기 때문이다. Cursor 내부에도 에이전트 윈도우나 그록봇 같은 것에 대해 많은 사람이 피드백을 주는 Slack 채널이 있다. 그리고 그 제보는 품질이 아주 낮은 경우가 많다. 누가 그냥…
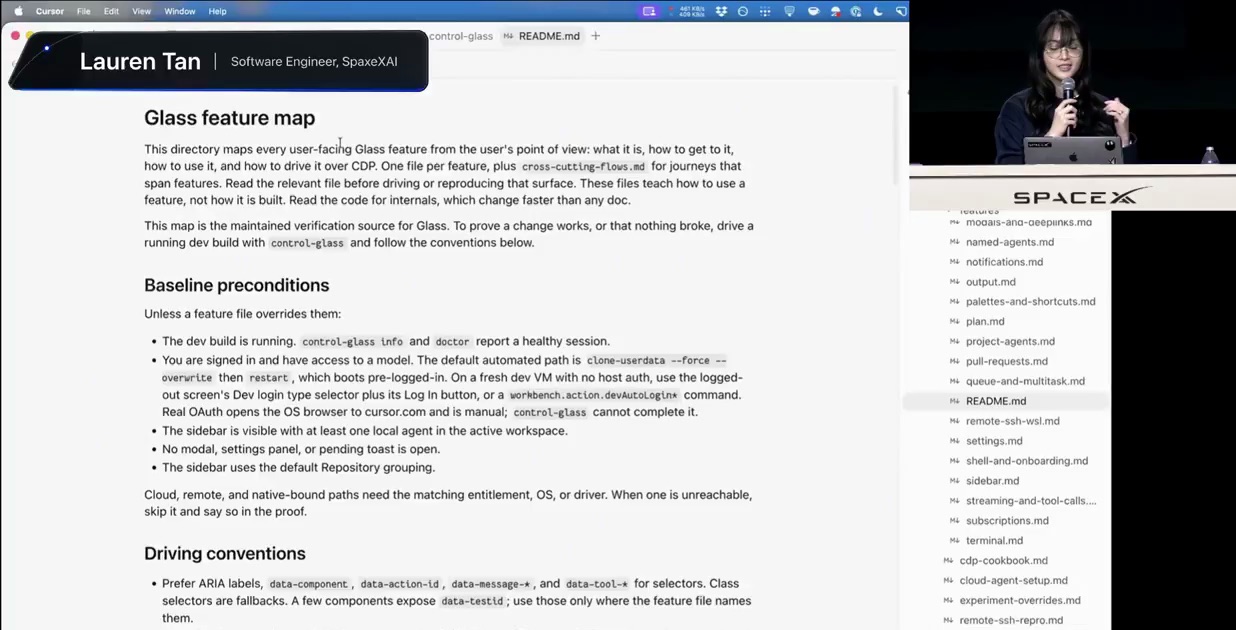
README.md. "Glass feature map" 문서 본문과 오른쪽 파일 목록(named-agents.md, pull-requests.md, sidebar.md, terminal.md 등)이 보인다. 화면 아래쪽에는 노란 가라오케 자막이 구워져 있는데, 지금 도는 영상이 원본 녹화가 아니라 재편집된 소셜용 컷이라는 표시다.아주 자주, 스크린샷 하나만 올리고 "???"라고만 적는다. 이게 뭐냐는 것이다. 이런 게 없으면 에이전트는 "전혀 모르겠다"가 된다. 그런데 이런 피처 맵이 있으면 훨씬 많은 맥락과 이해를 갖고, 어디로 어떻게 이동해야 모든 기능에 도달하는지를 안다. 예를 들어 사이드바가 무엇인지, 그 안에 어떤 하위 기능들이 있는지, 사용자 관점에서 거기에 어떻게 도달하는지, 키보드 단축키는 무엇인지. 심지어 CDP로 요소를 선택할 때 쓰는 DOM 요소나 속성까지 다 들어 있다. 그래서 에이전트에게 정말정말 강력하다. 그리고 pstack은 create verification skill뿐 아니라 maintain verification skill도 함께 제공해서, 이걸 계속 최신 상태로 유지할 수 있다.
콜린좋습니다. 그걸 어떻게 만드셨는지 여쭤보려던 참이었다. PStack이라는 맥락에서 그 과정을 조금 더 공유해주실 수 있나? 그리고 PStack이 뭔지 잘 모르는 분들을 위해 그게 무엇인지도 같이 설명해주시면 좋겠다.
네. PStack은 꽤 재미있는데, 우선 이름부터 좀 우스꽝스럽다. PStack의 P는 potato, 감자 스낵에서 왔다. 왜냐하면 — Y Combinator CEO인 게리 탠(Garry Tan)이라는 꽤 유명한 사람이 있는데, 그가 GStack, 즉 GarryStack이라는 플러그인을 만들었다. 재미있게도 우리는 성이 같다. 아무 관계도 없다. 그래서 게리를 살짝 놀리는 의미로 내 버전의 플러그인을 PStack이라고 만들면 재밌겠다 싶었고, 내 엔지니어링 관행에 맞게 손봤다. 그런데 솔직히 처음부터 PStack을 만들겠다고 시작한 건 전혀 아니었다.
그냥 스킬 몇 개로 시작한 것이다. control-glass 스킬로 시작했고, 그다음에는 how라는 스킬을 만들었다. 이것도 에이전트를 관찰하다가 발견한 것이다. 이 사다리를 오르려고 애쓰던 초기에 나는 루프 안에 완전히 들어가 있었고, 에이전트를 극단적으로 시시콜콜 따지고 있었다. "이 기능이 작동을 멈췄다, 여기 버그 리포트가 있다, 왜 안 되느냐"고 묻는다. 그러면 에이전트는 아주 자주 "이것 때문임에 틀림없다"고 자신 있게 단정한다. 그런데 실제 툴 콜을 들여다보니, 영향을 받았어야 할 코드를 실제로는 읽지도 않고 있었다.
그게 나를 극도로 의심스럽게 만들었다. 그 시점에 나는 이 에이전트를 더 이상 못 믿겠다고 생각했다. 완전히 환각을 일으키고 있으니까. 그리고 그런 불신은 쌓이기 쉽고, 무력감을 느끼기도 쉽다고 생각한다. 에이전트가 성공하도록 어떻게 도와야 할지 모르니까. 하지만 여기서도 관리 비유가 아주 도움이 된다. 여러분이 엔지니어링 팀의 매니저이고, 팀에 코딩은 정말 잘하지만 비즈니스 맥락은 전혀 없는 엔지니어가 있다고 해보자. 방금 채용해서 5초 전에 온보딩을 마친 사람이다. 그 사람을 어떻게 유능하게 만들 것인가? 그 방법이 스킬이다. 스킬이라고 해봐야 그냥 마크다운이다. 하지만 거기에는 많은 정보와 지시가 인코딩된다. 에이전트에서 지능을 꽤 많이 끌어낼 수 있다. 트위터에서 어떤 사람들은 이걸 "에이전트를 다른 잠재 공간(latent space)으로 끌어당긴다"고 부르는데, 좀 멋을 부린 표현이다. LLM은 다음 토큰을 예측하는 물건이니, 처음부터 품질 높은 토큰을 주면 더 똑똑한 공간에서 패턴 매칭을 하게 된다는 뜻이다. 아주 흥미로운 모델이다. 아무튼 나는 PStack을 정말 아주 점진적으로 만들었다. 에이전트가 겪는 온갖 실패 모드를 관찰하는 데서 시작했고, 그런 걸 볼 때마다 "이건 스킬로 만들자"고 했다. 환각 그만해라, 실제로 가서 코드를 찾아 읽어라, 서브에이전트를 많이 써라, 추측하지 마라.
콜린이해가 된다. 후속 질문이 하나 있는데, 나도 궁금하고 채팅에서도 많은 분이 물어보신다. 두 부분이다. 하나는, 이 스킬들을 어떻게 유지하느냐다. 제품은 시간이 지나면서 바뀌고, 코드베이스를 건드리는 사람도 많다. 그럼 이 스킬들은 어떻게 유지되나? 그리고 두 번째는, 검증이 충분히 좋아졌다는 걸 어떻게 아느냐다. 그러니까 여러분이 만든 검증 루프를 믿을 수 있다는 것, 그 루프가 끝났을 때 나온 결과를 신뢰할 수 있다는 걸 어떻게 아는가?
네, 두 질문이 어느 정도 연결돼 있다고 생각한다. 첫 번째부터 시작하겠다. 스킬을 어떻게 유지하느냐. 이 개념이 익숙하지 않은 분들을 위해 말하면, eval은 본질적으로 — 내가 가진 멘탈 모델로는 에이전트를 위한 유닛 테스트다. 그리고 eval은 직접 만들 수 있다. 특별한 프레임워크가 필요 없다. 얼마나 과학적이고 얼마나 엄밀하게 하고 싶은지에 따라 하나 만들면 된다. 제 화면이 빨개요.
콜린네, 작은 버튼이 있어요. 죄송합니다.
아, 드로잉을 꺼주시면 좋겠는데, 제 화면이 안 보여요.
콜린네, 죄송합니다. 여러분, 화면에 그림 그리지 말아주시면 감사하겠습니다. 아무튼 작은 버튼이 있어요.
이거 트롤인가요?
콜린네, 그 작은 드롭다운이요. "지우기". 네. 좋아요. 네. 됐네요. 완벽합니다.
네. 그래서 eval은 기본적으로 스킬을 유닛 테스트하는 방법이다. 그리고 실제로 pstack에는 potato mode 아래에 eval playbook이라는 플레이북이 들어 있다. 검색해보면 나온다. 이건 꽤, 실제로 상당히 엄밀하게 짜여 있다. 핵심은 이렇다. 서로 다른 서브에이전트를 아주 많이 띄운다. 메인 코디네이터 에이전트에게 이 스킬이 무엇을 해야 하는지에 대한 루브릭을 만들게 한다. 그러면 그게 서브에이전트들을 띄우고, 각자를 위한 개별 디렉터리를 만드는데, 이름을 영리하게 지어서 서브에이전트가 자기가 평가받는 중이라는 걸 모르게 한다. 에이전트는 그걸 실제로 알아챌 수 있고, 알아채면 행동을 바꾸기 때문이다. 이런 장치를 여러 개 넣어서, 내가 만들거나 수정하는 스킬이 내가 생각하는 대로 실제로 동작하는지를 테스트한다. 그리고 Cursor의 정말 좋은 점 하나는 우리가 아주 많은 모델을 지원한다는 것이다. 그래서 온갖 모델에 걸쳐 스킬을 eval할 수 있고, 그 매트릭스 전반에서, 특히 여러분이 실제로 쓰는 모델에서 얼마나 잘 작동하는지 감을 잡을 수 있다. 나는 이걸 많이 한다. 스킬을 수정할 때마다 eval playbook 같은 걸 한 번 돌려서 내가 원하는 결과로 이어지는지 확인한다. 다만 스킬을 유지하는 건 꽤 어렵다고 말하고 싶다. 취향과 관찰이 많이 필요하다. 뒷자리 운전자(backseat driver) 노릇을 아주 잘해야 한다. 무슨 말이냐면, 페어 프로그래밍을 해본 적이 있다면 동료가 코딩하는 걸 보면서 "나라면 이거 더 잘할 수 있는데" 싶었던 경험이 있을 것이다.
"이렇게 할 수도 있잖아, 왜 이렇게 안 했지?" 하면서 동료에게 질문을 많이 하게 된다. 여기서도 비슷하다. 에이전트의 수동적인 관찰자가 되고 싶지는 않을 것이다. 자기만의 스킬 세트를 만들어가는 초기 단계에서는 운전석에 아주 깊이 앉아 있어야 한다. 물론 pstack 같은 걸 쓸 수도 있지만, 직접 스킬 세트를 만든다면 툴 콜을 전부 열어보고 코드를 읽고 에이전트의 행동과 사고 블록을 읽는 것이 어디서 실패하는지 보는 정말 좋은 방법이다. 어디서 막히는지 보이면, 가서 그걸 위한 스킬을 만들면 된다. 그리고 검증을 어떻게 신뢰하느냐도 아주 비슷한 반복 루프라고 생각한다. 나도 검증 스킬 자체를 검증할 때 같은 과정을 거쳤다. eval의 흥미로운 점 하나는 힐 클라이밍이 된다는 것이다. 즉 eval이 점수를 낼 수 있다. 코디네이터가 그 점수를 만들게 할 수도 있고, 다른 모델의 판정자(judge) 에이전트를 두어 첫 번째 모델이 편향되지 않았는지 교차 확인하게 할 수도 있다. 서브에이전트들이 돌린 결과를 판정하는 그 모델 말이다. 그리고 힐 클라이밍도 가능하다. 즉 Cursor의 slash loop 같은 걸 써서 "이 eval을 계속 돌려라"라고 할 수 있다.
예를 들면 "전부 10점 만점에 10점이 될 때까지 계속 돌려라" 같은 것이다. control-glass 스킬도 기본적으로 같은 방식으로 만들었다. 실제로 손이 아주 덜 갔다. CLI와 그 스킬을 그렇게 만들었고, 시간이 지나면서 정말 좋아졌다. 다만 처음부터 매끄러웠던 건 절대 아니다. 반복이 아주 많이 필요했다. 여기에 내가 쓰는 비유가 하나 있는데, 뒤쪽 다른 슬라이드에서 다시 하겠지만, 지금의 엔지니어는 매니저에 더 가깝다는 것이다. 내가 더 좋아하는 비유는 식당의 주방장이다. 당신은 헤드 셰프다.
음식을 전부 직접 만들지 않는다. 요리사 팀이 있다. 라인 쿡이 있고, 수 셰프가 있고, 각 스테이션이 있다. 그리고 환경을 설계하는 게 당신의 일이다. 주방을 세팅하는 책임이 당신에게 있고, 각자에게 작업을 배분하는 책임도 당신에게 있다. 아주 흥미로운 일하는 방식이다. 어쨌든 그게 내가 이 검증 스킬들을 만든 방식이다.
콜린여기서 한 층만 더 깊이 들어가고 싶다. 어떤 것에 대한 eval이나 스킬을 만들고, 그게 스스로 좋아지게 하고 싶다고 하자. 지금 제안하는 게 그거라고 이해했다. 그걸 워크트리 같은 데서, 서브에이전트와 리뷰어 에이전트를 붙여서 격리된 채로 돌리는 건가, 아니면 클라우드 호스팅 환경 같은 데서 일어나는 건가. 실무 절차가 궁금하다. 내가 이걸 직접 해서 어떤 것에 대한 검증 시스템을 세팅하려면 무엇부터, 어디서 시작해야 하나.
시작하기 가장 좋은 곳은 로컬이라고 본다. 에이전트가 무엇을 하는지 직접 관찰할 수 있기 때문이다. 자기 자신을 위한 검증 루프를 만드는 거라면 나는 무조건 로컬에서 시작하겠다. 에이전트에게 애플리케이션을 띄우게 하라. CLI든 데스크톱 앱이든 상관없다. 그러면 실제로 관찰할 수 있다. 에이전트가 애플리케이션과 어떻게 상호작용하는지 볼 수 있고, 애플리케이션을 조작하게 해주는 여러 API를 어떻게 호출하는지 볼 수 있다.
다만 개인적으로 나는 거의 전부를 클라우드 에이전트에 걸고 있다. 극도로 강력하기 때문이다. Cursor에서 정말 강력한 건 클라우드 에이전트다. 환경 세팅에 시간을 조금만 쓰면 이 control 스킬과 검증 스킬이 엄청난 배당을 준다. 엔지니어 개인을 더 낫게 만드는 데서 끝나는 게 아니라 팀 전체, 나아가 회사 전체의 수준을 올려주기 때문이다. 클라우드 에이전트를 생각하기 시작할 수 있고, 자동으로 일을 처리하는 자동화를 생각하기 시작할 수 있다. 뒤에서 얘기하려 했지만 그냥 지금 하겠다. 예를 들어 내가 자주 얘기하는 Benny라는 에이전트가 있다. 우리에게 들어온 버그 리포트를 전부 받아서, 자동으로 클라우드로 나가 클라우드 데스크톱을 띄운다.
자기 컴퓨터에서 Cursor를 실행하고, 같은 control 스킬을 써서 애플리케이션을 조작하며 버그나 사용자 리포트를 재현하려 시도한다. 이게 정말 강력하다. 한 번에, 그것도 자동으로 엄청난 정보를 얻기 때문이다. 이 예를 보면 Benny가 실제로 버그를 재현했는데, main에서는 이미 고쳐져 있다. 즉 우리가 이 문제를 이미 해결했다는 걸 확인해 준 것이다. 내가 할 일은 Cursor 빌드를 한 번 더 릴리즈하는 것뿐이다. 이건 엄청난 정보다. 내가 직접 에이전트를 붙들고 앉아서 "이게 고쳐진 건가, 아닌가"를 한 시간씩 따질 필요가 없었다. 시간을 아주 많이 되돌려받는다. 게다가 우리 팀 전원이 이 혜택을 본다.
회사 전체가 이 혜택을 본다. 그래서 클라우드 에이전트를 쓰는 건 정말 강력하다고 본다. 다만 이건 여정이다. 이 지점에 오려면 먼저 신뢰해야 한다. 앞에서 말한 지점으로 돌아가는데, 그게 아주 어렵고 거의 불가능하다. 그리고 나는 건너뛰지 말라고 강하게 권하고 싶다. 아직 이 구간에 있다면 "지금 당장 클라우드 에이전트를 수백, 수천 개 띄우겠다"로 점프하지 마라. 토큰만 엄청나게 낭비하게 된다. 비용도 극도로 비싸진다.
콜린여기까지 요약하자면, 당신이 걸어온 여정을 따라가려면 먼저 검증부터 시작하는 것이다. 스킬을 만들고, 에이전트가 최소한 올바른 코드를 내놓고 있는지 판정하는 방법을 만드는 것. 좋은 코드인가는 별개의 질문이라 해도, 스택 트레이스를 보고 앱의 실제 동작을 보면서 기술적으로 문제를 풀고 있는지는 확인하는 것.
콜린그리고 로컬에서 그걸 신뢰하게 되면, 클라우드로 확장해서 더 많은 에이전트를 돌리는 걸 생각하기 시작할 수 있다. 에이전트가 스스로 신호를 주워 가는 것이다. 버그 리포트가 들어오면 그걸 집어 들고 문제를 풀어서 PR로 돌려주는 식으로. 그리고 마지막 단계가 PR 자동 머지인데, 그게 지금 당신이 있는 자리고 모두가 있는 자리는 아닐 것이다. 그다음 main에서 사후 리뷰를 하는 것. 이게 맞나.
맞다, 정확하다. 그래서 이 곡선을 그린 것이다. 이게 기본적으로 내 여정을 기술한다. 처음엔 에이전트 두어 개도 겨우 썼고, 모든 걸 하나하나 관찰했다. 여기서 저기로 가는 데 지름길은 정말 없다고 본다. 이건 결국 에이전트에 대한 개인의 신뢰 수준 문제이기 때문이다. 당연히 엔지니어라면 슬롭 코드를 프로덕션에 그냥 쏟아붓고 싶지는 않을 것이다.
그럼 그 신뢰를 어떻게 쌓느냐인데, 취향과 판단이 많이 든다. 다만 pstack 같은 플러그인이 훨씬 빨리 따라잡게 도와줄 수는 있다고 본다. 나를 믿고 pstack을 믿는다면, 그 연장선에서 당신의 에이전트도 믿을 수 있을지 모른다. 반대로 나를 믿지 않는다면 — 그리고 나는 사람들이 나를 맹목적으로 믿는 걸 절대 권하지 않는다 — 자기만의 스킬 세트를 쌓으면 된다. pstack을 보고 포크해서 자기 것으로 만들고 스킬을 개선하는 것도 물론 권장한다. 하지만 나에게 이건 결국 전부 신뢰 문제로 되돌아온다. 이 채팅에 있는 우리 각자는 엔지니어링 기준이 다르고, 각자의 코드베이스에서 중요하게 여기는 것이 다르다. 그 모든 걸 스킬로 인코딩하고 에이전트가 실제로 그걸 지키는지 검증할 수 있게 되면, 이 곡선을 올라가서 자동화를 시작할 수 있다. 얘기하고 싶은 조각이 하나 더 있는데, 혹시…
콜린네, 진행하시라. 질문은 중간중간 내가 더 주워 오겠다.
아직 얘기하지 않은 세 번째 부분이 있다. 흥미로운 주제인데, 리팩터링과 재작성이다. 업계에서 가장 논쟁적인 주제 중 하나가 "앱을 재작성해야 하는가"라고 본다. 엔지니어는 특히 이 충동에 잘 빠진다. 회사에 새로 들어가서 코드베이스를 보면 "이거 완전 엉망이네, 누가 이런 코드를 썼지, 전부 다시 쓰고 싶다"는 마음이 든다. 아주 흔한 성향이다. 에이전트 이전에도, 그리고 지금도 사람들은 대체로 재작성을 말린다. 그런데 나는 재작성을 고려해 볼 만한 이유를 변호하려고 한다. 경우에 따라 다르기 때문이다. 브라운필드 애플리케이션은 사실 꽤 좋은 위치에 있다. 특히 이미 세팅이 잘 되어 있다면 그렇다. 최근에 사람들과 얘기하다가 평행선을 하나 발견했는데, 빅테크 회사의 문제가 이제 모두의 문제가 되었다는 것이다. 빅테크의 문제라는 게 뭐냐면, 내가 메타에서 일할 때 거대한 모노레포가 있었고 수만 명의 엔지니어가 키보드를 두드리며 코드를 밀어 넣고 있었다. 메타에는 정말 훌륭한 엔지니어가 많다. 그런데 놀랍게도 코드 품질은 그렇게 좋지 않다. 그래서 나는 종종 "AI 슬롭 이전에 인간 슬롭이 있었다"고 농담한다. 메타나 구글 같은 정말 큰 회사의 인프라는 사실 그걸 전제로 설계돼 있다. 말하기 좀 그렇지만, 팀에서 가장 역량이 낮은 엔지니어에 맞춰 설계하는 것이다. 프레임워크를 만들고, 컨벤션을 만들고, 가드레일을 만들고, 인턴이 프로덕션 데이터베이스를 날리지 못하도록 자격증명을 제한한다. 그 수준의 인프라가 이미 있다면 에이전트도 이미 꽤 견실하게 일할 수 있다고 본다. 에이전트가 코드베이스에 난장판을, 적어도 심한 난장판을 만들지 못하게 하는 가드레일이 이미 깔려 있기 때문이다. 물론 가드레일은 더 추가할 수 있다. 반대로 그린필드, 즉 완전히 새로운 애플리케이션이야말로 내 생각엔 가장 큰 리스크이자 가장 큰 기회다. 프로젝트나 프로토타입을 바이브 코딩으로 만들면 그렇게 된다. 우리가 GrokBot을 그렇게 만들었다. GrokBot은 아주아주 빠르게 띄웠다. GrokBot을 모른다면, 우리가 어제 막 출시한 새 애플리케이션이다. 정말 멋지다.
각자 고유한 정체성을 가진 개별 에이전트를 만들고 오케스트레이션할 수 있게 해준다. 정말 멋지니 꼭 한번 써보시라. 어쨌든 그건 아주 전형적인 그린필드 애플리케이션이었다. 대부분의 프로토타입이 그렇듯 아주 빠르게 바이브 코딩으로 만들어졌다. 사람이 코드를 전혀 읽지 않았다. 최근에 "유기적 아키텍처(organic architecture)"에 대해 트윗을 하나 썼다. 찾아보겠다. 요지는 이렇다. 완전히 바이브 코딩된 애플리케이션에는 가드레일이 하나도 없다. 그래서 에이전트에게 작업을 주면 가장 편한 방법으로 풀어버린다. 그리고 시간이 지나면 코드베이스가 통제를 벗어나 소용돌이치는 상황이 된다. 당신은 그 코드를 이해하지 못한다. 에이전트는 어떤 의미에서는 이해하고 있겠지만, 그들이 만들어 놓은 건 지름길에 최적화된 것이다.
그리고 결국 고생하게 된다. 그 애플리케이션에서 문제를 아주 많이 겪게 된다. 그래서 코드베이스를 아주 강한 끈으로 시작하는 게 꼭 필요하다고 본다. 믿을 수 있는 코드베이스가 있고, 에이전트가 좋은 코드를 쓰도록 실제로 도와주는 가드레일이 있으면, 곡선의 이 구간까지 올라갈 수 있다. 앞에서 말했듯 나는 오늘 아침에 일어났더니 에이전트가 머지한 PR이 20건 있었다. 그건 내가 시간을 아주 많이 투자했기 때문이다. 어제 계산해 보니, GrokBot 전체를 내가 만들어 온 새 아키텍처로 리팩터링하는 데 600 PR 이상이 들었다. 그리고 지금은 코드를 거의 들여다보지 않는 지점까지 왔다. 이건 토큰을 팔려고 하는 말이 아니라, 그 지점까지 가는 데 정말 많은 작업이 필요했기 때문에 하는 말이다. 더 이상 코드를 볼 필요가 없는 상태로 코드베이스를 만드는 데 토큰을 아주 많이 썼다.
그런데 나는 아주 신이 나 있다. 이게 나에게만 이득이 아니기 때문이다. GrokBot에 기여하는 모두에게 이득이다. 디자이너, 프로덕트 매니저, 심지어 GTM 인력까지 GrokBot에 기능을 추가할 수 있게 해준다. 그리고 나는 한밤중에 깨서 "누가 성능 리그레션을 머지했으면 어쩌지" 하고 걱정하지 않아도 된다. 제약이 엄청나게 많고, CI 때문에 GrokBot에서 코드를 쓰는 건 사실 아주 짜증난다. 그런데 그 짜증을 에이전트가 전부 흡수한다. 그게 정확히 무엇인지 얘기해도 좋다.
콜린이 부분으로 들어가기 전에 질문 하나 하겠다. CI가 어떻게 생겼는지, 제약이 어떤 것들인지, 그리고 평균 PR 크기가 어느 정도인지. 아까 그 질문이 올라왔다. 수학적으로 정확한 평균일 필요는 없고, 대체로 PR 크기가 몇 줄 수준인지만 알려달라.
경우에 따라 다르다. 좀 조심스럽게 말하려는 중인데…
콜린실제 숫자를, 진짜 평균을 공개하지 않아도 된다. 괜찮다.
다만 우리는 — 이건 그렇게 흥미로운 건 아니지만, 재미있는 사실 하나는 GrokBot과 Cursor의 가상화가 실제로는 pretext라는 라이브러리로 돌아간다는 것이다. 누군가 새로 만든 라이브러리인데 꽤 흥미로우니 한번 보시라. 그게 그렇게 중요하진 않고. 평균 PR 크기는 사실 나도 모른다. 이걸 클릭해도 되는지 모르겠다. 아마 할 수는 있겠지만. 대략 몇백 줄, 50줄에서 1,000줄까지 무엇을 하느냐에 따라 다르다. 예를 들어 여기서는 파일을 잔뜩 지우고 있으니 대부분 삭제일 것이다. 편차가 있다. 딱히 정해진 건 없다.
콜린하드캡이나 하드리밋 같은 건 없는 거다. 전부 50줄짜리 PR이라거나 그런 것도 아니고.
하드캡은 없다. 하드캡은 확실히 없다. 다만 에이전트에게 작업을 여러 PR로 쪼개라고 권장하기는 한다. 주로 그렇게 하는 이유는, 커밋이 워낙 많아지는 에이전트 세상에서는 지금 더 어려운 일일 수도 있지만, Git 히스토리가 아주 풍부한 컨텍스트 소스라는 생각을 좋아하기 때문이다. 각 PR이 그 작은 조각이 무엇을 하는지 원자적으로 기술하는 걸 좋아한다. 그러면 변경을 되돌리기도 쉽고, "버그를 하나 냈는데 바로 여기 있다"고 짚어내기도 쉽다. 40,000줄짜리 PR 안에 뭐가 들어갔는지 아무도 모르는 상황이 아니라. 어쨌든 PR 크기에 하드캡은 두지 않는다.
콜린좋다. 그리고 CI에 대해서도 간단한 질문. 역시 CI 화면을 공유할 필요까진 없고, 대체로 CI가 어떤 모습인지, 얼마나 빡센지만 말해달라.
GrokBot에 한정해서 말하겠다. Dune은 우리가 GrokBot을 위해 만든 아키텍처에 붙인 장난스러운 코드명이다. CI는 꽤 짜증나 보인다. 모든 것에 대한 체크가 있기 때문이다. 예를 들어 React를 써봤다면 React의 가장 큰 지뢰 중 하나가 useEffect라는 걸 알 것이다. 그래서 Dune과 GrokBot에서는 useEffect를 금지했다. Dune이 무엇인지 머릿속 모델로 말하자면, Electron 앱을 위한 Next.js 같은 것이고 에이전트가 쓰도록 설계되었다. 우리 에이전트 기반 애플리케이션에 맞춘 커스텀이다. 그래서 CI 체크도 거기에 아주 특화돼 있다. useEffect를 쓰지 마라, 금지다. CI가 실패하고 소리를 지른다.
사람들이 눈썹을 치켜올릴 만한 좀 더 흥미로운 것 중 하나는 코드 주석도 금지했다는 것이다. 아주 흥미로운데, 내가 관찰해 보니 99%의 경우 에이전트는 코드와 전혀 상관없는 역사적 사연 같은 것을 주석으로 쓴다. 예를 들어 "로런이 이건 절대 하지 말라고 했다" 같은 게 코드 주석에 들어간다. 뭐라고? 왜? 나는 그걸 지속적인 전역 규칙으로 말한 게 아니었다. 그냥 "이 PR은 별로고 그 부분을 고쳐라"는 뜻이었다. 놀랍게도 에이전트는 우리를 그렇게 잘 이해하지 못한다. 아니면 너무 많이 가정하고 아주 멍청한 방식으로 일을 처리한다. 그래서 우리는 상상할 수 있는 건 전부 금지한다. 에이전트가 잘 못하는 건 금지한다. 실제로 agents window에서 우리가 많이 겪는 예가 하나 있는데, agents window를 써봤다면 성능 문제를 분명히 봤을 것이고 우리는 계속 고치고 있다. 그런데 끝없는 싸움이다. 머지되는 풀리퀘스트가 너무 많고, 그중 어느 하나라도 성능이나 안정성, 신뢰성을 퇴행시킬 수 있기 때문이다. agents window에는 아직 이 아키텍처가 없다. 여기서 배운 것을 거기로 가져가서 전부 리팩터링할 계획이다.
그런데 정말 자주 퇴행한다. 한 가지 예는 프로세스 간 격리가 아주 부실하다는 것이다. Electron에는 UI를 그리는 렌더러 스레드가 있고, 렌더러를 블로킹할 필요가 없는 다른 코드를 돌릴 수 있는 메인 스레드가 있다. 그런데 우리는 그 둘을 분리하는 일을 잘 못하고 있다. 그래서 종종 실수로 렌더러 스레드에서 도는 코드가 딸려 들어온다. 그러면 갑자기 렌더러와 경쟁하게 된다. 60 FPS를 원한다면 그려지는 매 프레임이 16 밀리초 안에 끝나야 한다. 프레임당 마감이 아주아주 짧다. 아주 부드러운 제품을 원한다면 그렇다. 그런데 계산이 아주 무겁거나 IO가 많은 것들이 실수로 끌려 들어오면 잔뜩 버벅이고 FPS가 크게 떨어진다. 프레임을 잃기 시작하고, 16 밀리초를 넘기는 롱 태스크가 생긴다.
그러면 아주 끊기는 경험이 된다. 그래서 Electron 앱을 만들며 배운 그 모든 패턴을 이 프레임워크에 인코딩했고, 그건 하드 실패가 된다. GrokBot에는 말 그대로 electron-main, electron-renderer라는 디렉터리가 있고, 임포트 CI가 있어서 의존성 그래프를 검사해 한 디렉터리에서 다른 디렉터리의 코드를 실수로 임포트하지 않는지 확인한다. 그건 CI가 강제한다. 그리고 Bugbot도 있는데, CI에서 도는 Cursor의 코드리뷰 도구다. agents.md에도 들어 있고, 사방에 있다. 그래서 여기서 나는 좋은 코드베이스를 만드는 데 여러 층위가 있다는 얘기를 한다. 당연히 코드베이스 자체가 한 층인데, 이렇게 극도로 엄격한 아키텍처가 있으면 기능을 만드는 방식이 아주 관습적으로 정해진다. 그게 가장 강한 강제 수준이다. 에이전트는 기존 패턴을 복사하는 걸 정말 좋아하기 때문이다. GrokBot에서의 예를 들면 feature라는 개념이 있고, entry point와 transcript card 같은 것들이 있다. 채팅에서 보이는 카드 같은 것들이다. 이것들은 프레임워크 안에서 일종의 명사다. 그리고 그것들을 만드는 아주 관습적인 방법이 정해져 있다.
예를 들어 feature 하나는 전부 단일 디렉터리 안에 있다. 그 기능에 기여하는 모든 코드가 한 디렉터리에 산다. 한곳에 같이 놓이니 아주 쉬워진다. 에이전트가 여기저기 더듬으며 어디에 무엇이 있는지 찾을 필요가 없다. feature만 보고 "아, GrokBot 온보딩 기능 작업이구나, 이 디렉터리에서만 작업하면 되겠다" 하면 된다. 작업의 80%는 대체로 거기에 캡슐화돼 있다. 이건 다시 말하지만 가장 멍청한 에이전트를 위해 설계된 것이다. 생각할 필요가 없게 만든 것이다. 이 프레임워크의 핵심 원칙 하나는 가장 짧은 경로가 가장 좋은 경로라는 것이다.
그게 에이전트가 코드를 쓰는 방식과 정확히 맞아떨어지기 때문이다. 에이전트는 지름길을 좋아한다. 문제를 푸는 가장 빠른 길을 찾는다. 그렇다면 그 길을 가장 좋은 길로 만들면 되지 않겠나. 세부 사항까지 전부 들어가지는 않겠다. 이 프레임워크는 오픈소스로 낼 무언가라기보다 아이디어와 원칙의 모음에 가깝다. 원하면 이 화면을 스크린샷으로 찍어서 에이전트에게 이런 걸 만들어 달라고 해도 된다. 어쨌든 핵심은 층위다. 코드베이스가 한 부분이다. feature와 디렉터리, 그리고 임포트하면 안 되는 의존성을 막는 것. 그리고 그걸 전부 강제하는 정적 분석이 있다. CI 체크가 있고, 우리가 관찰한 나쁜 패턴에 대한 린트가 많고, 컴파일러 진단이 있다. 그리고 rules와 Bugbot이 있는데, 3, 4, 5번 층위는 더 소프트하다. 앞의 두 개는 실제로 CI를 빨갛게 만든다. 에이전트가 형편없는 코드를 그냥 쓰지 못하게 하는 하드 제약이 있는 것이다. rules와 skills, Bugbot은 에이전트가 잊어버릴 수 있다. 항상 일관되게 적용되지 않을 수도 있다. 그래서 나는 이것들을 층으로 쌓되, 유일한 강제 수단으로 의존하지는 않는다. 아주 소프트하기 때문이다. rules와 Bugbot, skills, 그리고 코드 스타일 가이드만 있다면 코드베이스가 완전히 쓰레기가 되는 건 시간문제다. 이렇게 말해서 미안하지만 그렇다. 그래서 하드하게 강제할 수 있는 것에 투자하기를 권한다. 그리고 이래서 어떤 기술 스택을 고르는지도 아주 중요하다. 예를 들어 Rust가 다시 엄청나게 인기를 끌고 있는데, 컴파일러가 아주 엄격하기 때문이다. 컴파일러가 정말 많은 것을 강제한다. 달래야 하는 borrow checker가 있다. 그리고 에이전트가 unsafe 코드 블록을 쓰지 않게만 하면, 코드가 컴파일된다면 대체로 동작하고 괜찮다고 어느 정도 확신할 수 있다. 그게 인간 엔지니어가 직접 확인하러 갈 필요를 없애주는 신뢰와 확신의 수준이다. 코드와 정적 분석에 의존해서 그 과정을 훨씬 매끄럽게 만드는 것이다. 그리고 가장 최악의 자리는 코드리뷰 랜드에 갇히는 것이다. 코드베이스의 모든 제약과 불변식을 말 그대로 사람이 코드를 읽으면서 "이렇게 하면 안 된다"고 말해서 강제하는 상태다. 그걸 해야 할 때마다 코드 스멜, 안티패턴으로 여겨야 한다. 그리고 이렇게 물어야 한다. PR에 댓글을 다는 대신 이걸 어떻게 하드 룰로 바꿀까? 어떻게 린트 규칙으로 바꿀까?
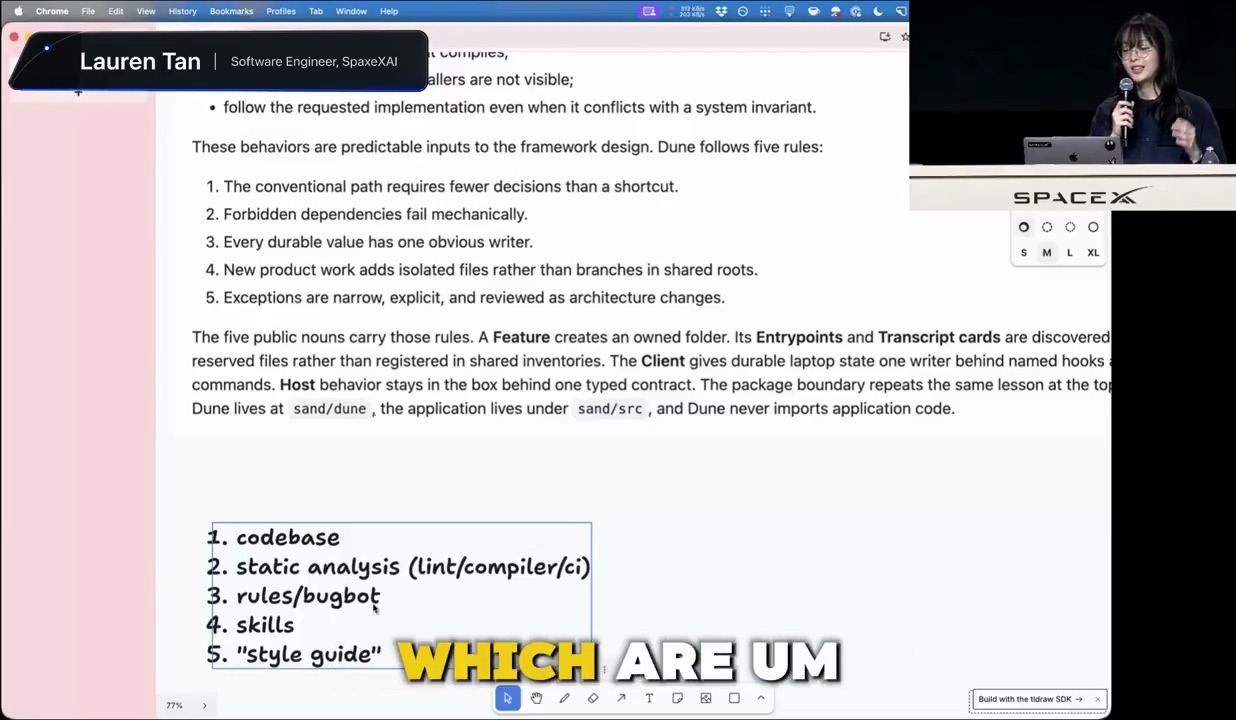
이걸 어떻게 CI 실패로 바꿀까? 아니면 이 문제를 아예 범주적으로 없앨 수는 없을까? 내가 했던 다른 마이그레이션 얘기도 할 수 있지만 여기서 일단 멈추겠다.
콜린좋다. 솔직히 지금 당신이 묘사한 그 자리가 바로 내가 있는 자리다. 나에게는 그런 규칙들이 다 없다. 그래서 이 세션이 끝나면 할 일이 생겼다. 에이전트를 확장하려면 말이다. 나는 로컬에서 두세 개 정도 병렬로 돌리는 수준이다. 여기 계신 대부분도 비슷할 것 같다. 몇 분 안 남았는데, 로런, 더 강조하고 싶은 게 있나. 질문이 많아서 더 받을 수도 있지만 몇 분은 드리고 싶다.
꽤 오래 떠든 것 같다. 그냥 질문을 받자.
콜린좋다. 여러 번 올라온 질문 하나는 토큰 사용량이다. 지금 설명한 것이, 사실상 무제한 토큰이 아니라 평범한 수준의 토큰을 쓰는 사람들에게도 현실적인 얘기인가.
정말 좋은 지적이다. 나는 당연히 무제한 토큰이 있는 AI 랩에서 일한다. 그래서 내가 한 것과 똑같은 방식으로 모두가 해야 한다고는 결코 말할 수 없다. 은행을 털지 않고도 이 지점까지 갈 수는 있다고 본다. 다만 엔지니어링 리더거나 스타트업을 이끌고 있다면, 나에게 이건 ROI의 문제다.
앞단에서 토큰에 돈을 많이 쓰게 되는 건 맞다. 코드베이스를 리팩터링하는 데 토큰이 많이 든다. 이런 것들을 추가하는 데도 토큰이 꽤 든다. 그런데 에이전트가 모든 코드를 쓰는 세상으로 가고 있고, 아주 린하게 가고 싶다면, 사람을 더 뽑고 싶지 않다면, 메타처럼 되고 싶지 않다면 — 1만 명 규모의 엔지니어링 조직이 되고 싶지는 않을 것이다. 그런 문제를 갖는 것 자체는 멋진 일이지만 오버헤드가 엄청나다. 계획 수립 같은 것들이 따라붙는다. 개인적으로 나는 그게 별로 재미없다. 아주 민첩하게 남고 싶을 것이다. 에이전트는 결국 전에는 할 수 없던 일을 할 수 있게 해주는 것이다.
그게 나에게는 에이전트의 진짜 가치다. 모든 자잘한 일에서 토큰을 아끼는 게 아니다. 내가 전에 할 수 없었던 일은, 코드베이스에 이 수준의 제약을 혼자서 강제하는 것이다. 나는 한 사람일 뿐이다. 이 프레임워크를 만들고 리팩터링을 전부 하고 직접 테스트하고 검증하는 데 몇 년이 걸렸을 것이다. 에이전트 이전 시대에 나 혼자 이걸 돌리고 있었다고 상상해 보라. 정말 오래 걸렸을 것이다. 그리고 내 연봉은 꽤 높다. 그래서 엔지니어링 리더가 할 질문은 이런 트레이드오프다. 이걸 할 사람을 뽑을 것인가, 아니면 토큰을 써서 가장 순진하고 가장 멍청한 에이전트조차 잘 해내는 코드베이스를 만들 것인가. 실제로 이 지점에 도달하면 fable 급이 아닌 에이전트도 코드를 훌륭하게 쓴다. 이건 나 개인에게도 큰 배당을 준다. 나뿐 아니라 PM, 디자이너, GrokBot을 잘 모르는 엔지니어까지 지속 가능한 방식으로 기여할 수 있게 만들었다. 그러니 확실히 트레이드오프다. 공짜인 건 없다. 토큰은 꽤 비싸다. 아, 그리고 얼마나 보셨는지 모르겠지만 우리가 오늘 Grok 4.6을 발표했다. 아주 신난다, 드디어 나왔다. Grok 4.6은 아주아주 똑똑하다. 벤치마크에서 정말 좋다. 그리고 토큰 비용은, 내가 틀리게 말하는 게 아니길 바라지만, 토큰당 비용이 4.5와 같은 것으로 알고 있다. 즉 같은 비용에 더 높은 지능을 얻는 것이다. Cursor와 SpaceXAI가 정말로 최적화하려는 영역이 바로 비용 대 지능의 파레토 프런티어다. 우리는 굳이 역사상 가장 큰 모델을 만들고 싶지는 않다. 돌리는 비용이 극도로 비싸기 때문이다. 핵심은 스위트 스팟을 찾는 것이다. 거대할 필요는 없지만 아주 똑똑하고, 추론 비용은 아주 비싸지 않은 지점. 정리하자면, 직접 분석해 보면 꽤 긍정적으로 나올 것이라고 본다. 이런 데 투자해서 얻는 ROI가 자신뿐 아니라 팀 전체를 훨씬 생산적으로 만든다. 나 같은 엔지니어 군단이 매일 그만큼의 개선과 버그 수정을 내놓는다고 상상해 보라. 꽤 신나는 일이다.
콜린좋다. 마무리 전 마지막 질문 하나. 이 콜에 계신 프로덕트 쪽 분들을 위한 질문이다. 로런처럼 출하하는 엔지니어 군단이 있다고 하자. 그러면 프로덕트 팀이나 회사의 다른 기능 조직은 그 속도를 어떻게 따라가고 있나. 그들도 AI를 더 많이 써서 일을 하고 있나. 당신이 그 역할은 아니니 말할 수 있는 만큼만 답해달라.
GrokBot이 정말 강력했던 지점이 바로 여기다. GrokBot 이전에 Cursor에는 Cursor뿐이었다. agents window가 있었고, CLI가 있었고, IDE가 있었다. 전부 파워 유저 도구다. 개발자를 위해 설계된, 아주 개발자 중심적인 것들이다.
그 안에서 지식 노동을 할 수는 있지만 UI가 거기에 최적화돼 있지는 않다. 그래서 우리에게는 그런 도구가 없었다. GTM이나 프로덕트 쪽 사람들도 Cursor로 일을 했을 수는 있지만 그들에게 즐거운 경험은 아니었다. 이제 GrokBot이 생겼고, 내 생각에 GrokBot은 기술 업계 밖 사람들에게 "Cursor의 순간"이다. 아주 접근하기 쉽고, 아주 편안하고 익숙한 인터페이스로 에이전트를 쓰게 해준다. iMessage처럼 생겼다. 재미도 있다. 에이전트에게 재미있는 이름을 붙일 수 있다. 오케스트레이션도 아주 자연스러운 방식으로 할 수 있다. 각 에이전트가 한 사람 같고, 이제 함께 일하는 에이전트 팀이 생긴 셈이다. 예를 들어 관리하는 계정 하나당 에이전트 하나를 둘 수 있다. PM이라면 로런이 밤새 한 작업을 전부 요약해 주는 에이전트를 둘 수 있고, 그러면 내가 뭘 했는지 알 수 있다. 우리 PM들이 그걸 많이 활용하고 있고, 코드도 낸다. 그래서 종종 "여기 버그가 있었는데 내가 고쳤다, 봐줄 수 있나" 한다. 그러면 내가 리뷰한다. 그리고 실제로 완벽하다.
"좋다, 승인" 하고 끝난다. 그건 Dune 아키텍처가 버텨주고 있다는 걸 보여준다고 본다. 아주 엄격한 제약들이 엔지니어링 전문가가 아닌 사람도 높은 수준으로 기여할 수 있게 해준다. 그 효과가 이미 크게 나타나고 있다고 느낀다. 디자이너와 PM이 직접 기능을 낼 수 있다. 그래서 GrokBot 팀이 아주 빠르다. 정말 빠르게 출하할 수 있다. 계획된 것도 많아서 더 많은 걸 출하하는 게 아주 기대된다.
이 문서의 본문은 영상이다. 영상의 저자는 Lauren Tan(로런 탠, SpaceXAI Principal Engineer)이고, 아래 X 글은 2026-09-17에 그 영상을 유통한 경로다. 게시자 @ajitcodes(Ajit Kumar)는 엔지니어가 아니라 마케팅·AI 콘텐츠 크리에이터다 — X 팔로어 2.4만, LinkedIn 36만. 같은 워크숍은 Instagram·YouTube·Facebook·LinkedIn 등 여러 계정으로도 재유통되고 있고, 이 글은 그중 하나다. 원 글은 x.com/ajitcodes/status/2100419472477519907에 있다.
게시자가 큰따옴표로 Lauren Tan에게 귀속시킨 단락은 다음과 같다(영어 원문).
"99% of people using GrokBot just for 1% of its real power. They run 1 agent without 'loop' & 'graph'. I'm running a team of 20+ GrokBot agents, fully autonomous. I have a Chief of Staff agent, a PM agent and 20+ workers - that's the new stack."
이 인용은 게시자가 Lauren Tan의 발화로 제시한 것이며, 55분 전사 전문 대조 결과 영상에는 이 문장이 없다 — 판정 근거는 팩트체크 블록에 있다.
아래는 X가 이 글 전체에 붙인 자동 번역이다(X UI 문구 제거).
SpaceXAI 엔지니어, Lauren Tan:
"99%의 사람들이 GrokBot을 그 실제 힘의 1%만을 위해 사용하고 있어요. 그들은 'loop'와 'graph' 없이 1개의 에이전트만 실행하죠.
나는 20+개의 GrokBot 에이전트로 구성된 팀을 운영하고 있어요, 완전히 자율적으로. 나는 Chief of Staff 에이전트, PM 에이전트, 그리고 20+개의 워커를 두고 있어요 - 이게 엔지니어의 새로운 스택이에요."
1시간 세션에서 SpaceXAI 엔지니어가 처음부터 효과적인 AI 에이전트 팀을 구축하는 방법을 보여줬어요.
이건 $500짜리 에이전틱 엔지니어링 코스보다 더 가치 있어요.
오늘 이 워크숍을 시청하세요, 그 다음 아래 기사에서 GrokBot 에이전트 함대를 구축하는 방법을 읽어보세요.
글에 달린 답글 중 캡처된 11개다. 적대적인 것도 원문 그대로 옮긴다.
@Jeff_64_58 · 1분 전 · 조회 16
나는 각자 자기 전문 영역을 맡은 Grok Bot 6개 팀을 두고 있고, 그것들이 내 시스템의 로컬 LLM(작은 모델)에 지시를 주게 한다. 이 방식이 잘 돌아가고 토큰도 엄청나게 태우지 않는다.
@Benjaminscartel · 50분 전 · 조회 438
우리가 필요로 하는 것은 더 많은 제한이다.
@toha_volovuk · 7시간 전 · 조회 1.7천
그 썸네일은 진짜 SpaceX 로고다 — 이건 완전 브랜드 사칭이고, SpaceX 직원이 아니다. 똑같은 'Lauren Tan', 다른 'SpaceXAI' 포스트들과 똑같은 스크립트다. 단순한 회의감이 아니라 신고할 가치가 있다.
[Lauren Tan은 SpaceXAI 소속 실존 엔지니어이며, 이 주장은 팩트체크 블록에서 거짓으로 판정됐다.]
@Wilquison_filho · 6시간 전 · 조회 1.3천
그래, 근데 그녀는 토큰이 무제한이고 나는 아니다.
@jiwenji1 · 5시간 전 · 조회 1.3천
이걸 공유하는 건 쓸모없는 스팸이다. 에이전트가 많다고 더 나은 게 아니다. 뭐가 최선인지 아나? 빠른 에이전트 하나다. 멍청하게 굴고 멍청한 기업 선전을 리포스트해서 당신을 뮤트했다.
@AiromaticAI · 3시간 전 · 조회 1.1천
차라리 'Lauren Tran'이겠지.
@aiseomastery · 1시간 전 · 조회 441
에이전트 20개면 회사 하나다.
@ZenHookah · 5시간 전 · 조회 1.3천
AI에는 여전히 비전이 없다. 시력 얘기가 아니다.
@berkerdev · 4시간 전 · 조회 957
만약 그녀가 20명 이상의 직원들에게 비용을 지불하고 있다면, 물론 그렇겠지. 이런 '인플루언서' 엔지니어들이 얼마나 현실과 동떨어져 있는지 믿을 수가 없다.
@CRHRNN · 4시간 전 · 조회 1.8천
그래서 내 주간 사용량을 다 태우라고? 시도는 좋았다, 사양한다.
@Stray_Yids · 4시간 전 · 조회 1천
여러 '페르소나' 에이전트를 쓰는 이런 시스템은 AI 버블에서 더 헛소리에 가까운 축에 든다. 물론 멀티 에이전트 시스템에 기회가 있는 경우도 가끔 있다(대규모 리서치 작업 가속, 복잡한 테스트 워크플로). 하지만 대부분은 유치한 과장이다.
11개 중 내용을 두고 말한 것은 사실상 두 개뿐이다 — 자기 구성을 밝힌 @Jeff_64_58과, 멀티 에이전트의 적용 범위를 한정한 @Stray_Yids다. 나머지는 영상이 아니라 글이 앞세운 전제를 친다. 토큰 비용(@Wilquison_filho, @CRHRNN), 에이전트 수 자체(@aiseomastery, @jiwenji1), 발표자와의 거리감(@berkerdev), 그리고 신원 의심(@toha_volovuk, @AiromaticAI). 영상의 논지는 에이전트를 몇 개 돌리느냐가 아니라 신뢰를 어떻게 검증으로 만드느냐인데, 글이 맨 앞에 세운 숫자는 '20+ 에이전트'였다. 반응은 그 앞줄에 붙었다.
본문 안에 인라인으로 살아 있는 링크의 보조 목록이다. 이 목록이 본문 링크를 대체하지 않는다.
pstack. 발화자가 P는 potato라고 밝힌 그 플러그인.useEffect가 foot gun이라는 진술의 배경.이 영상은 한 계정의 독점 자료가 아니다. 같은 세션이 여러 경로로 동시에 돌고 있고, 경로마다 붙는 문구와 숫자가 다르다.
r/ClaudeAI — 같은 세션을 59분 41초 길이로 소개하며 “신뢰 체계를 만든 뒤 에이전트 작업을 더 이상 확인하지 않게 된 이야기”로 요약한다. 이 문서가 받은 파일(55분 3초)과 길이가 다르다.@techorginals, @quantumfield.ai · YouTube Life Of Ankit(4.8만 조회) · Facebook · LinkedIn 다수 — 대부분 “넷플릭스 보지 말고 이걸 보라”는 같은 구호를 쓴다.mlx-community/whisper-large-v3-turbo, 언어 영어 고정, 2026-09-18, 소요 1분 50초. 원본 길이 55분 3.87초, 분절 546개.<time>은 발화 시작 시각이다.WebSearch 도구가 빈 결과만 반환해, 모든 웹 확인은 로그인 브라우저를 통한 검색으로 대체했다. 그 사실을 팩트체크 블록의 출처 표기에 반영했다.control-glass 스킬의 대상이다.음성 전사·한국어 완역 2026-09-18 · 디자인 레퍼런스 openai