youtube.com · 3Blue1Brown · 2026-11-17
이 알고리즘이 압축에 대한 내 생각을 바꿨다 | 정보이론 3부
그랜트 샌더슨이 2026-11-17 3Blue1Brown 유튜브 채널에 올린 37분 25초 영상으로, 정보이론 3부작의 마지막 편이다. 같은 언어 모델을 나눠 가진 송신자와 수신자는 산술 부호화로 텍스트 한 편을 0과 1 사이의 실수 하나로 주고받는다. 미국 헌법 전문 327자는 ASCII로 2,616비트, 허프먼 부호화로 1,461비트, Qwen(파라미터 4억 9,400만)과 산술 부호화로는 45비트다. 영상은 이 장치로 ‘압축은 지능이다’를 지능의 수학적 정의 후보로 따진다. 원리와 측정은 1차 문헌과 맞는다. 뉴턴이 ‘에너지’를 정의했다는 비유와 ‘두 자릿수 개선’이라는 표현은 사실과 다르다.
읽기 전에
다음 글자를 맞히는 언어 모델을 어떻게 무손실 압축기로 바꾸는가? 산술 부호화가 그 다리다. 송신자와 수신자는 같은 언어 모델을 하나씩 갖는다(05:40). 송신자는 텍스트를 단위 구간 위의 좁은 칸으로 바꾼 뒤, 그 칸 안의 실수 하나를 메시지 길이와 함께 보낸다. 칸의 폭은 모델이 그 텍스트에 준 확률이다. ASCII로 2,616비트인 미국 헌법 전문(Preamble) 327자가 Qwen(파라미터 494M)으로는 45비트, 길이 헤더 8비트다(03:58·24:00 화면). 영상은 이 결과를 근거로 ‘압축은 지능이다’를 지능의 수학적 정의 후보로 따진다. 그랜트 샌더슨(Grant Sanderson)이 2026-11-17(한국 시각 11-18 01:43) 3Blue1Brown 유튜브 채널에 올린 37분 25초 영상으로, 정보이론 3부작 ‘Compression is Intelligence’의 3편이다.
텍스트 하나는 단위 구간(0에서 1) 위의 칸 하나다. 언어 모델이 글자마다 지금 칸을 다음 글자 확률대로 쪼갠다. 실제로 온 글자의 조각이 새 칸이다. 마지막 칸의 폭 p가 모델이 매긴 그 텍스트의 확률이다. 칸 안의 2진 소수 하나를 적는 데 ⌈−log2 p⌉비트면 충분하다.
먼저 알아 둘 것
- 섀넌 정보량. 확률 p인 메시지의 정보량은 −log2 p비트다. 확률 (1/2)k인 메시지는 정확히 k비트다(02:20). 클로드 섀넌(Claude Shannon)은 최적 압축의 길이가 이 값에 가깝다고 보였다(01:46).
- 2진 소수가 고르는 칸. 소수점 뒤 비트 하나가 지금 칸을 반으로 잘라 한쪽을 고른다. .01은 1/4에서 1/2까지다(14:11 화면). k비트 이하로 적는 수는 2−k 간격으로 늘어선다(17:15).
- 언어 모델의 출력. 언어 모델은 앞 텍스트를 받아 다음 선택지 전체에 대한 확률분포를 낸다(05:17). 두 글자의 확률은 연쇄 법칙대로 곱한다. P(“ma”) = P(“m”) · P(“a” | “m”)(09:28 화면).
- 교차 엔트로피. 모델이 정답 토큰에 준 확률로 매긴 비용 −log2 p의 평균이다(21:36). 정답에 높은 확률을 준 예측은 비용이 0에 가깝다(21:14). 사전학습은 이 값을 손실 함수로 삼아 줄인다(21:25).
읽는 순서
- Executive Summary에서 결론과 숫자를 먼저 본다.
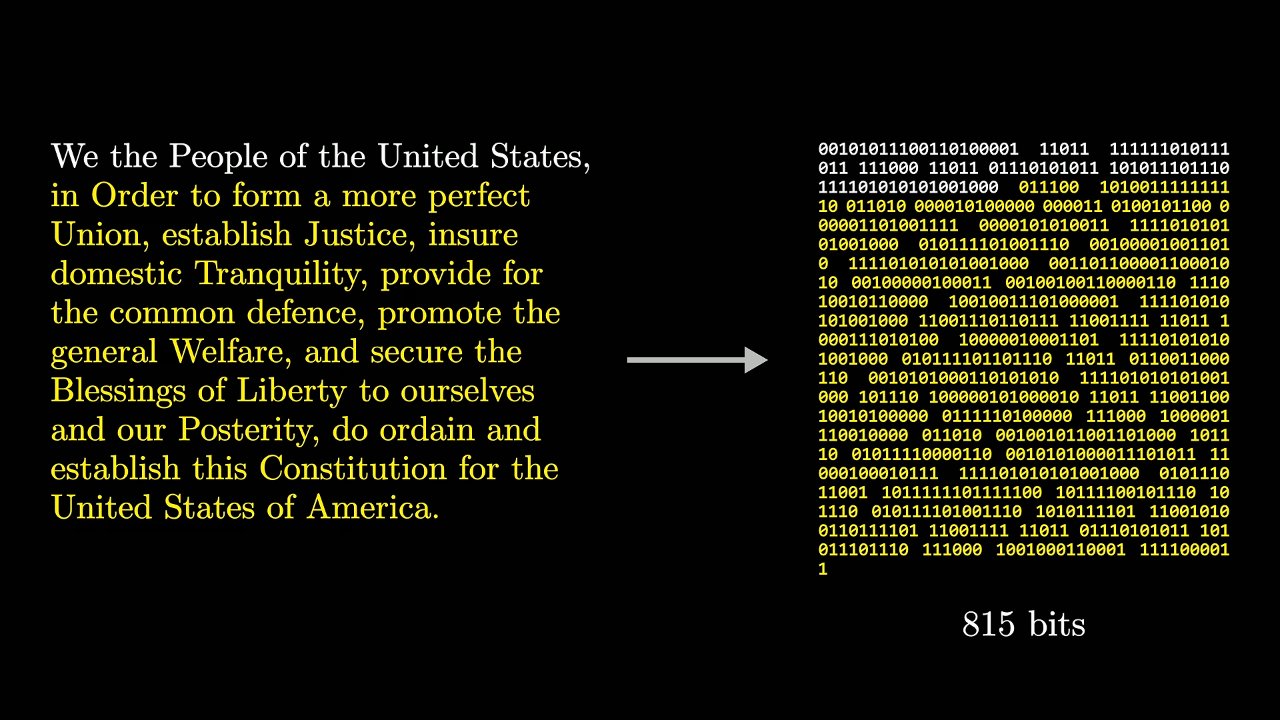
- 섀넌 추정치의 터무니없음(00:00)이 문제를 세운다. 헌법 전문의 첫 구절 뒤를 50% 확률로 맞히면 나머지는 1비트다(03:15). 문맥과 무관하게 글자마다 고정 비트열을 주는 허프먼 부호화는 1,461비트, 토큰 단위로도 815비트다(04:14–04:38).
- 중심 챕터 텍스트에서 실수로(06:27)는 키프레임 그림이 곧 본문이다. 확률을 폭으로 쌓은 막대(07:32) → m 아래에 다음 글자 막대를 맞춘 연쇄 법칙 그림(09:28) → P(“math”) 칸(10:06) → math를 10비트 .0111111101로 적는 장면(14:50)을 차례로 따라간다. 복호화는 같은 모델을 같은 순서로 돌려 칸을 되짚는다(11:47).
- 이것이 섀넌의 한계인가(16:57)는 비트 수 공식 k ≥ −log2 p를 유도한다(17:49 화면).
- 사전학습을 다시 보기(20:26)는 손실 함수인 교차 엔트로피가 훈련 예제 하나를 압축한 비트 수와 같은 양임을 보인다(22:28 화면).
- 산술 부호화의 실제 동작(22:41)은 NanoGPT와 Qwen의 실측 비트 수(23:18–24:00), 실수 정밀도 문제와 구간 재정규화(25:21), 비대칭 수 체계(ANS, 26:42)를 다룬다.
- “압축은 지능이다”에 대한 생각(27:29)은 이 문구를 지능의 정의 후보로 놓고 세 근거를 든다. 예측과 압축의 등가(29:02), 작은 복호화 프로그램(30:46), 빠른 학습(33:00)이다. 35:12의 ‘learning rate’는 바로 앞 문장대로 모델이 새 문맥에 적응하는 속도다. 화면 검색어 순차 예측 부호화(prequential coding, 34:57)는 Yiding Jiang의 글이 잇는다.
- #t-6의 연도·개선 배율과 28:00 에너지 비유의 뉴턴 귀속은 그다음 팩트체크가 판정한다.
- 재정규화 구현은 영상 설명란의 Dr. Dobb's Journal 1991년 기사와 Nayuki의 참고 구현에 있다(26:23).
점검 질문
- mathematics를 10비트로 적은 것은 섀넌 한계를 깬 것인가? 깨지 않는다. 칸 폭이 약 2−18이라 18비트짜리 칸인데, 10비트 점 하나가 우연히 그 안에 들었다(#t-3 16:30). 섀넌의 정리는 평균에 대한 정리다. 운 좋은 경우는 정보량을 정수로 올려야 하는 더 흔한 경우와 상쇄된다(#t-4 19:34). 같은 10비트는 math 칸에도 든다. 둘을 가르는 것은 따로 보내는 메시지 길이다(16:05).
- 같은 127자 문장에 NanoGPT는 254비트, Qwen은 96비트를 썼다. 왜 다른가? 공식의 p가 꽂은 모델이 텍스트에 준 확률이라서다(#t-4 19:59, 20:05 화면 “Not Shannon information!”). 모델 예측이 실제 언어 통계에 가까울수록 비트 수가 준다(20:16). 수학사를 알면 뻔한 마지막 두 단어 “Euclid's Elements”가 Qwen에서는 5비트다(#t-6 23:36).
- ‘압축은 지능이다’는 ‘예측은 지능이다’에 무엇을 더 요구하는가? 작은 모델이다. 정직한 압축률은 모델을 포함한 복호화 프로그램의 크기까지 센다(#t-7 31:46). 허터 상(Hutter Prize)이 이렇게 채점한다(32:09). 예측력이 같으면 작은 모델이 더 좋은 압축이다(32:35). 영상은 이 차이 때문에 앞 문구가 더 생각할 거리를 준다고 본다(32:52).
Executive Summary
산술 부호화에서 압축 크기는 끼운 예측기의 품질이 정한다
예측하기 쉬운 텍스트를 실제로 적은 비트에 담는 방법은 산술 부호화다. 송신자와 수신자가 같은 언어 모델을 나눠 가지면, 산술 부호화는 텍스트를 0과 1 사이의 실수 하나로 바꾼다. 그 실수를 적는 비트 수는 모델이 텍스트에 준 확률 p에 대해 ⌈−log2 p⌉ 이하다. 압축 크기는 거의 전부 예측의 질로 정해진다. 출처는 그랜트 샌더슨(Grant Sanderson)이 2026-11-17(한국 시각 2026-11-18) 3Blue1Brown 채널에 공개한 37:25 길이의 영상으로, 정보이론 3부작 「Compression is Intelligence」의 3편이다(35:25 화면).
샌더슨은 이 등식으로 사전학습을 ‘최고의 텍스트 압축기 만들기’로 다시 읽는다. 복호기 크기와 학습 속도까지 세면 압축률이 예측만으로는 놓치는 지능의 면까지 잰다는 것이 그의 결론이다. 압축과 지능이 같다고 주장하지는 않는다. 그는 이 방법이 허터 상(Hutter Prize) 우승작 전부의 뼈대라고 말한다(00:28). 허터 상은 위키백과 1GB를 가장 작게 압축한 기록에 주는 공개 상금이다(00:09). 그는 이 방법을 이미지·비디오·오디오에도 쓰는 일반 기법으로 소개한다(00:35).
마지막 챕터(36:30)는 채널을 돕는 방법으로 협력 조직 채용 페이지, 후원자 페이지, 상점을 안내한다.
문자마다 고정 비트열을 주는 부호는 섀넌의 추정치에 닿지 못한다
섀넌이 1940년대에 보인 결과대로라면 예측하기 쉬운 문단은 몇 비트로 줄어야 한다. 최적 압축에 드는 비트 수가 메시지 확률 p에 대해 −log2 p에 가깝다는 결과다(01:46). 확률이 절반이 될 때마다 1비트가 는다(02:13). 미국 헌법 전문의 첫 구절 뒤에 올 문자 전체에 50% 확률을 주면 정보량은 1비트, 1/1000을 줘도 10비트다(03:15).
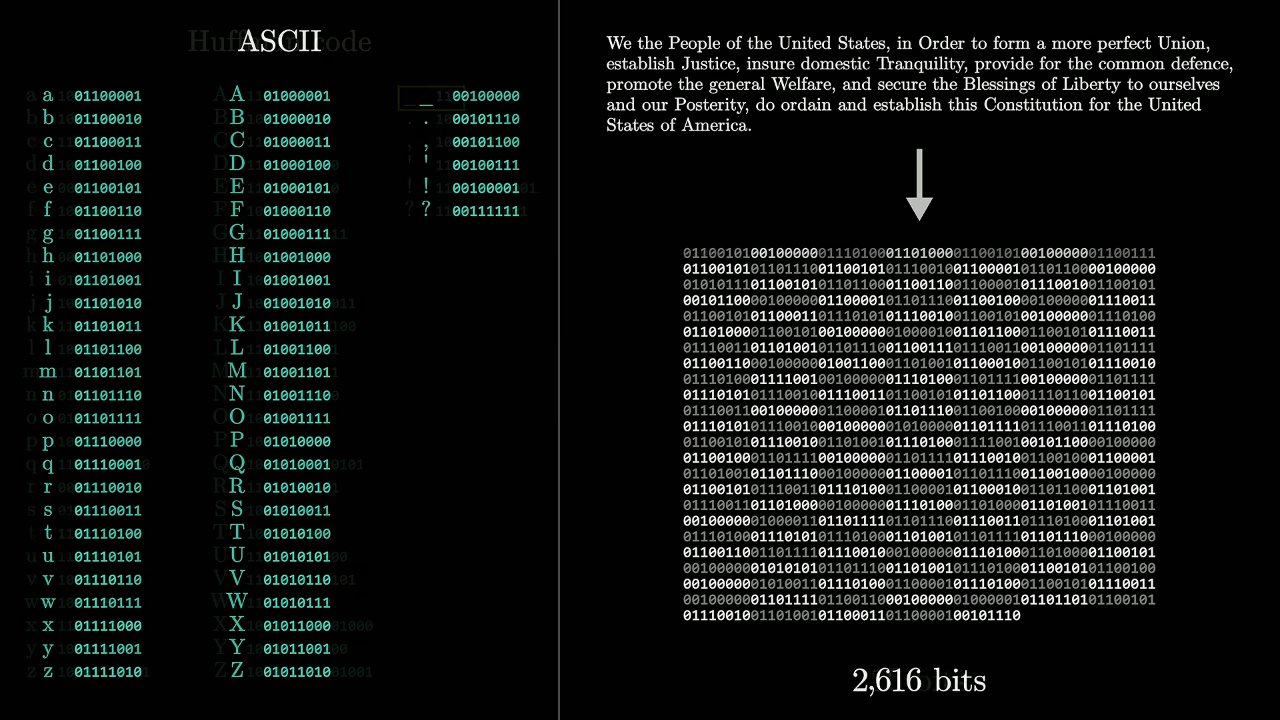
문자마다 고정 비트열을 주는 부호는 이 수치 근처에도 못 간다. 327자 전문에 ASCII와 허프먼 부호화는 수백에서 수천 비트를 쓴다(03:49, 아래 표). 원인은 문맥이다. 한 단어의 예측성은 앞에 온 글에 따라 크게 달라진다(04:38).
문맥을 쓰는 도구는 다음에 올 것의 확률분포를 내는 언어 모델이다(05:17). 영상의 핵심 가정은 송신자와 수신자가 똑같은 모델 사본을 하나씩 가진다는 것이다(05:40). 모델이 좋을수록 압축이 좋다(05:53). 샌더슨은 작은 모델에 오히려 실제 이점이 있다고 미리 말해 둔다(05:11).
텍스트를 단위 구간 위의 좁은 구간으로 바꾸면 필요한 비트 수는 ⌈−log2 p⌉ 이하다
산술 부호화에서 텍스트 하나는 단위 구간 위의 좁은 구간 하나에 대응한다. 확률분포를 이 구간 위의 막대로 그리면 막대 폭이 곧 확률이다(07:25). 설명용 모델은 알파벳 26자만 내는 문자 단위 모델이다. 토큰 어휘가 큰 모델에서도 알고리즘은 같다(07:01).
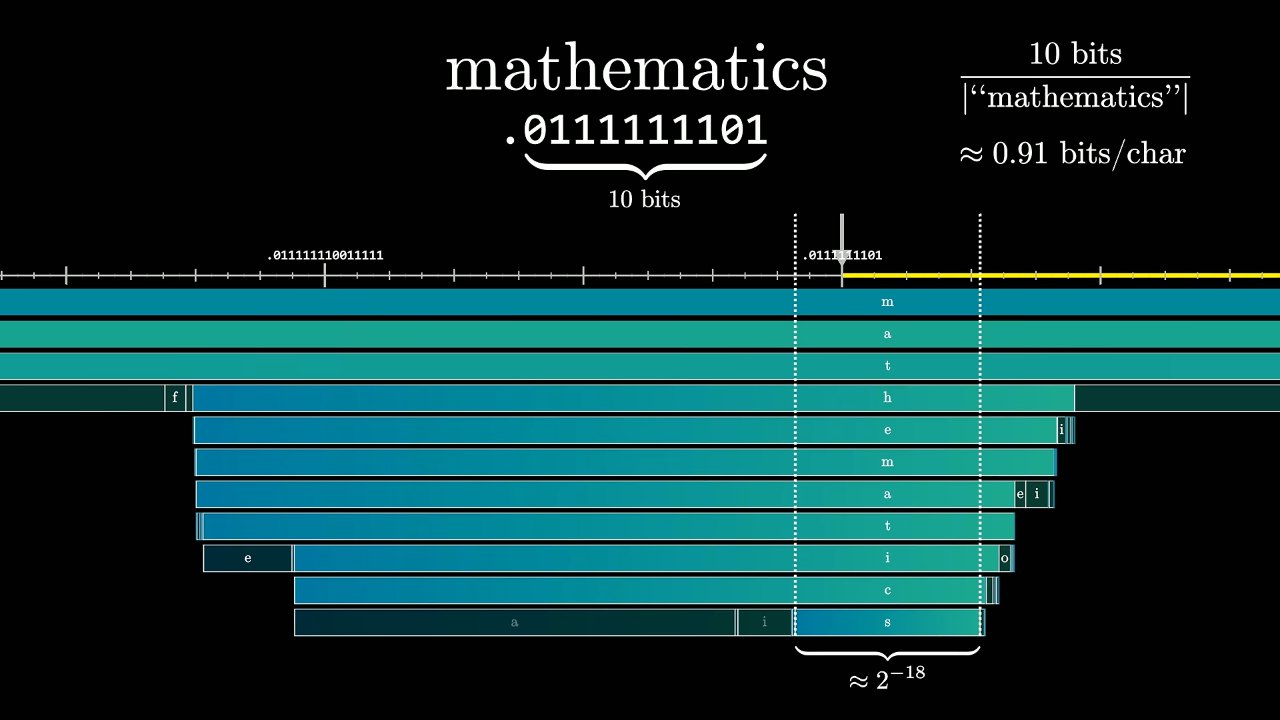
“math”를 예로 들면, m 구간 아래에 m 다음 글자의 분포를 다시 쌓는다. a가 38%, e가 16%를 받는다(08:47). 둘째 층의 막대 폭은 연쇄 법칙대로 P("ma") = P("m")·P("a"|"m")이다(09:30). 네 층을 내려가면 “math”의 확률만큼 좁은 구간이 남는다. 이 구간 안의 아무 수와 글자 수만 받으면 수신자는 단어를 복원한다(10:16).
복호화는 같은 모델을 한 층씩 다시 돌려 글자를 하나씩 읽는다. 첫 분포에서 받은 수가 m 구간에 있으면 다음에는 ‘m’을 문맥으로 넣는다(11:47). 수신자의 예측기는 송신자의 것과 똑같아야 한다(11:36). 글자 수 대신 ‘메시지 끝’ 기호를 쓰는 설계도 가능하다(12:19).
무작위로 고른 실수는 대부분 그럴듯한 영어 조각에 떨어진다(13:01). 샌더슨은 이를 완벽한 압축은 잡음과 구별되지 않는다는 섀넌의 생각과 잇는다(12:44). 언어 모델이 텍스트를 생성하는 방식도 이 그림과 같다(13:29).
이진수에서는 소수점 뒤 비트 하나가 구간을 반으로 가른다(13:47). k비트 이하로 적을 수 있는 수는 2−k 간격으로 놓인다. 폭 p인 구간에 위치와 상관없이 수 하나를 넣으려면 2−k ≤ p, 곧 k ≥ −log2 p여야 한다(17:19).
필요한 비트 수 ≤ ⌈−log2 p⌉
이 식은 섀넌의 정보량 정의와 같은 꼴이다(18:02). 섀넌은 평균적으로 이 값보다 짧은 압축은 불가능하다는 것을 보였다(18:12). 산술 부호화는 그 한계를 반올림 오차 안에서 구현한 방법처럼 보인다(18:23). 글자 수는 32비트 머리말이면 40억 자까지 적어서 무시할 만하다(18:47).
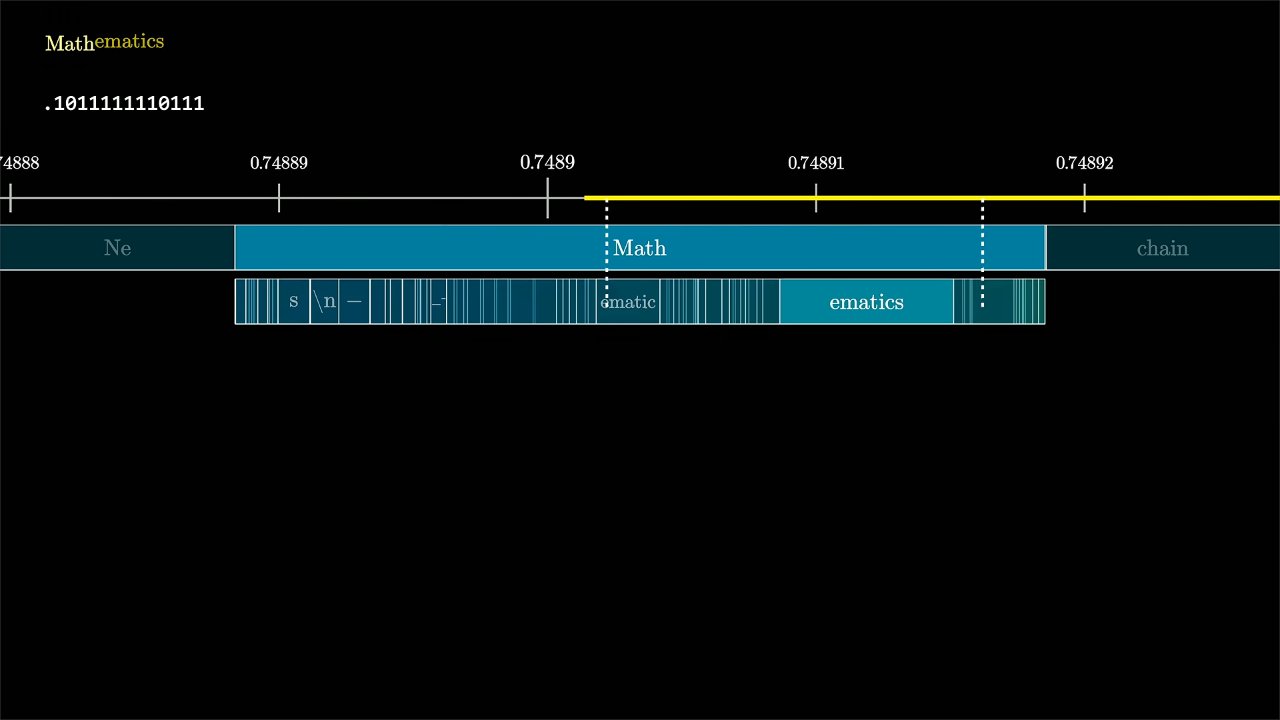
“mathematics”는 이 상한보다 훨씬 적게 들었다. “math”를 적은 10비트 수가 폭 약 2−18인 “mathematics”의 구간에도 떨어진다(15:55). 샌더슨은 18비트가 들 단어를 10비트로 적은 이 경우를 ‘극히 운이 좋다’고 부른다(16:27).
같은 문장도 더 나은 예측기를 끼우면 비트 수가 준다
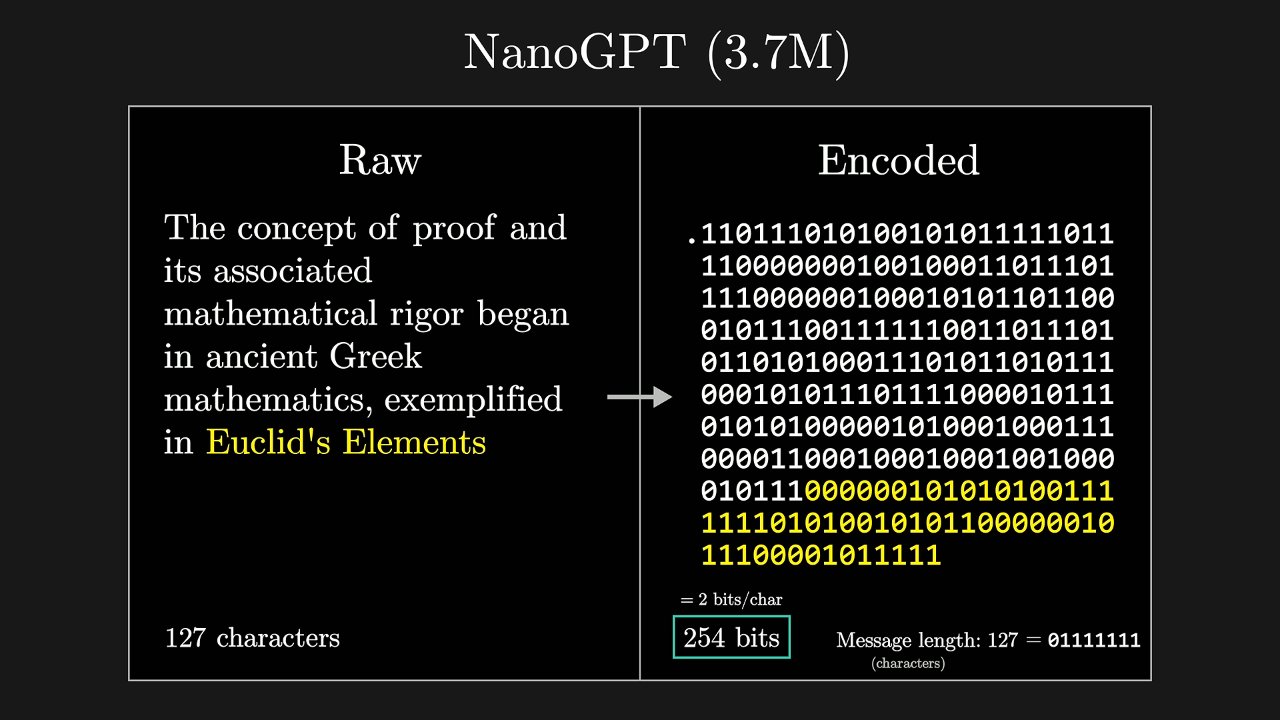
127자 수학사 문장에 영상 내내 예시로 쓴 매개변수 370만 개의 NanoGPT는 문자당 약 2비트를 쓴다(23:01). 샌더슨은 이 값이 섀넌이 가능하다고 추정한 수준의 두 배라고 말한다(23:15). 매개변수 약 5억 개의 Qwen은 문자당 1비트 아래로 내려간다(23:29). 허터 상의 기록 경신도 대개 더 나은 예측기를 끼운 데서 왔다고 샌더슨은 말한다(26:37).
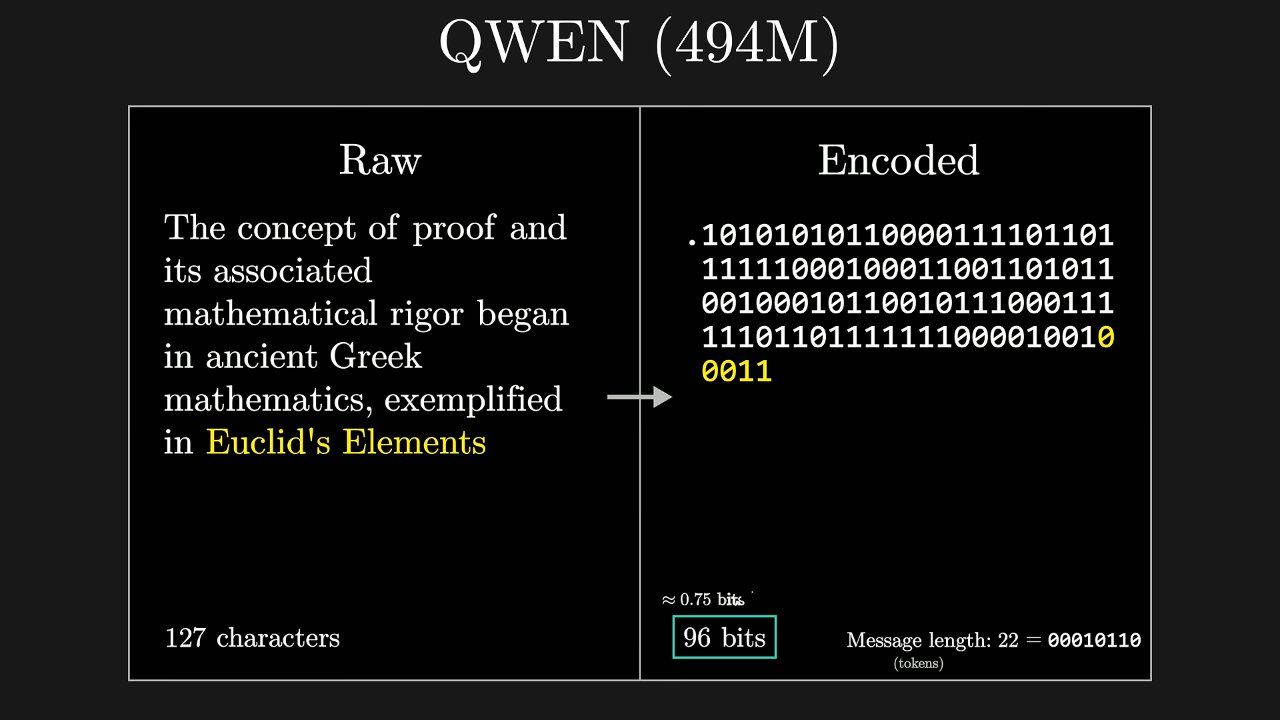
헌법 전문에서 Qwen은 첫 구절 35자에 약 35비트를 쓴다. 나머지 전부는 약 10비트만 더한다(23:49). 샌더슨은 이 결과를 허프먼 부호화 대비 ‘두 자릿수 개선’이라 부른다(24:00). 표의 1,461비트 대 45비트는 약 32배다(팩트체크).
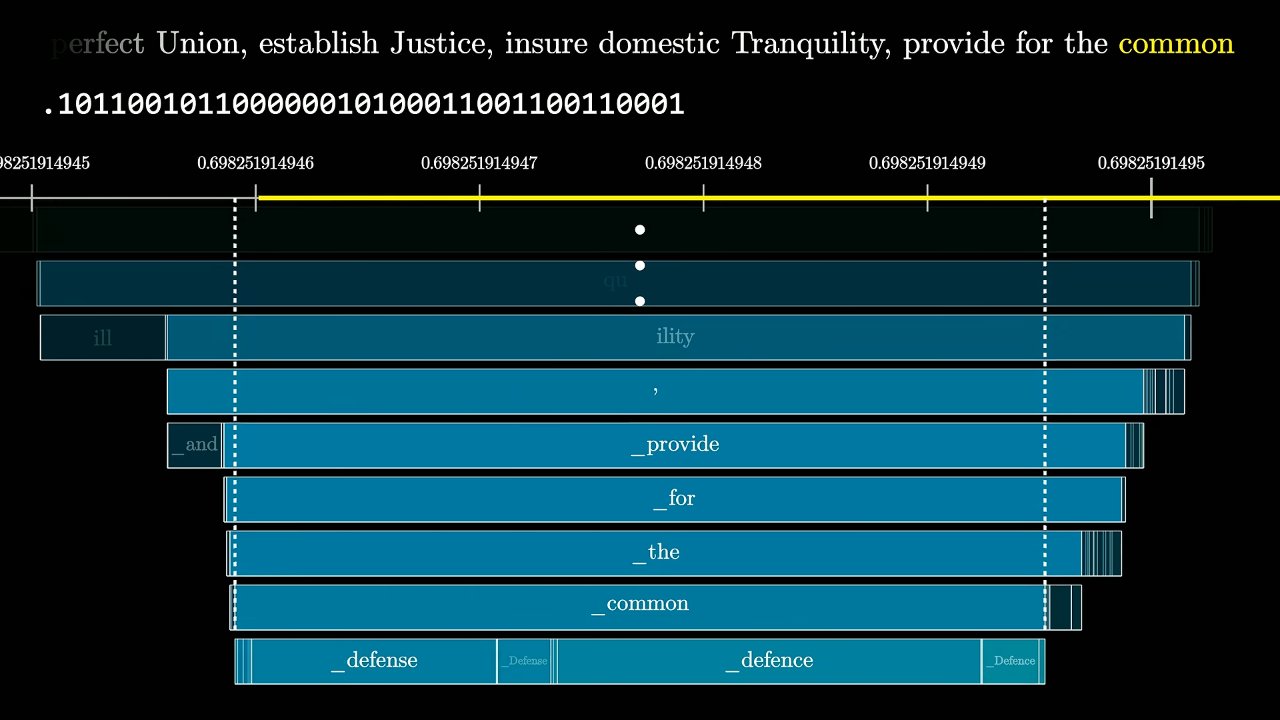
첫 구절 뒤로는 토큰마다 확률 공간 거의 전체를 차지해 실수를 갱신할 일이 드물다(24:33). 남은 결정은 대부분 대소문자와 철자다. defence를 s 대신 c로 쓰는 선택에 2비트쯤 든다(24:50).
| 텍스트 | 부호화 방식 | 크기(비트) | 문자당 비트 | 시각 |
|---|---|---|---|---|
| “math” 4자 | 산술 부호화 + 예시 모델 | 10 | 2.5 | 14:50 |
| “mathematics” 11자 | 산술 부호화 + 예시 모델 | 10 | ≈ 0.91 | 16:35 |
| 수학사 문장 127자 | 산술 부호화 + NanoGPT(3.7M) | 254 | ≈ 2 | 23:18 |
| 수학사 문장 127자 | 산술 부호화 + Qwen(494M) | 96 | ≈ 0.75 | 23:42 |
| 헌법 전문 327자 | ASCII | 2,616 | — | 03:58 |
| 헌법 전문 327자 | 허프먼 부호화(문자 단위) | 1,461 | — | 04:14 |
| 헌법 전문 327자 | 허프먼 부호화(토큰 단위) | 815 | — | 04:28 |
| 헌법 전문 327자 | 산술 부호화 + Qwen(494M) | 45 | — | 24:00 |
사전학습의 교차 엔트로피 손실은 학습 예제를 압축한 비트 수다
모델이 텍스트에 주는 확률 p는 예측 확률들의 곱이다. 로그를 씌우면 압축 크기는 예측마다 붙는 −log p 항의 합이 된다(20:38). 각 항은 예측 하나의 비용이다. 정답 문자에 낮은 확률을 줄수록 비용이 크다(21:05). 사전학습은 이 비용의 토큰 평균을 최소화한다. 그 평균이 모델 분포와 참 분포 사이의 교차 엔트로피다(21:36).
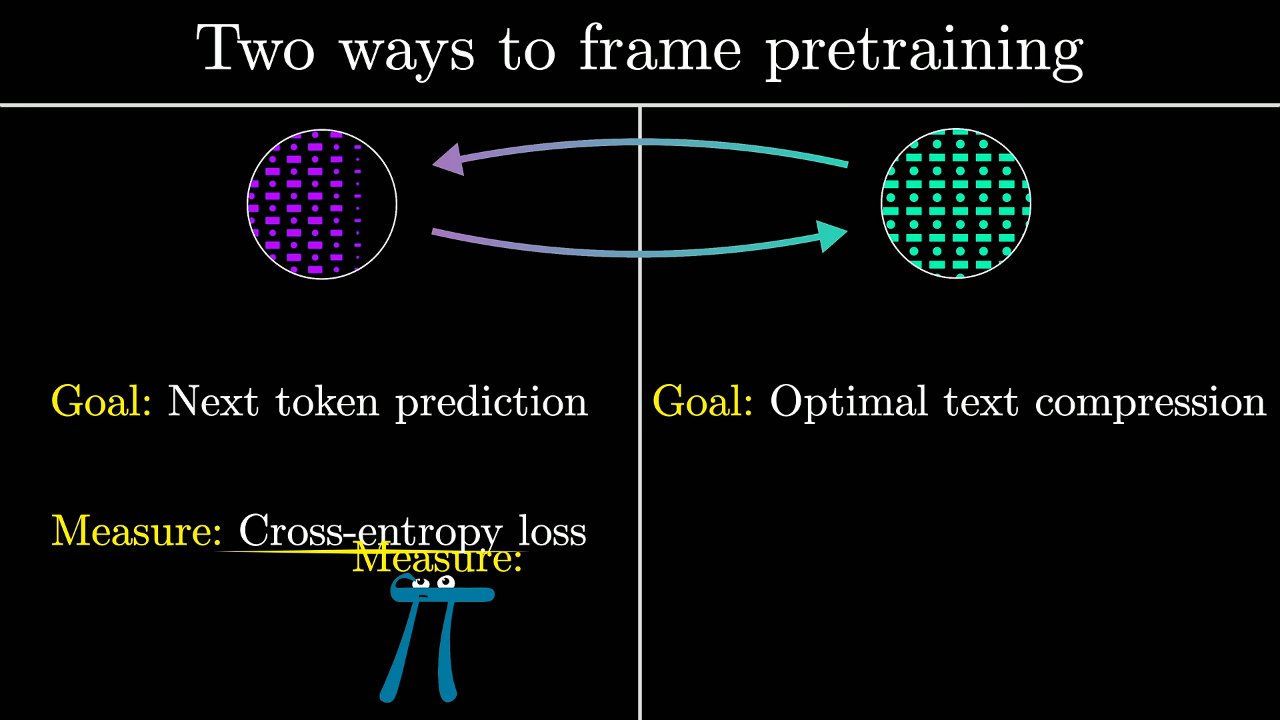
다음 토큰 예측이 목표라면 교차 엔트로피는 여러 후보 가운데 고른 손실 함수처럼 보인다(21:50, 22:18). 최고의 텍스트 압축기가 목표라면 최소화할 수는 학습 예제 하나를 압축한 비트 수로 처음부터 정해진다(22:26). 두 틀은 수학적으로 같다. 샌더슨에게는 둘째 틀이 사전학습을 이해하는 훨씬 나은 방식이다(22:35).
샌더슨은 압축이 예측보다 지능의 더 많은 면을 잰다고 본다
샌더슨은 ‘압축은 지능이다’를 지능의 정의 제안으로 다룬다(27:41). 그는 뉴턴이 ‘에너지’에 수학적 뜻을 준 일에 빗댄다. 일상어의 뜻을 놓친 정의였어도 서로 다른 현상을 묶었다는 것이다(27:56). 이 귀속은 사실과 다르다. ‘energy’를 지금의 뜻으로 처음 쓴 사람은 토머스 영(1807)이다. 운동 에너지는 코리올리(1829)가 기술했다(팩트체크). 말로 한 단위(kilogram meters per second squared)는 힘의 단위다. 화면의 kg(m/s)²가 에너지의 단위다. 샌더슨은 압축이 지능의 이질적인 면 세 가지를 묶는다고 본다(28:45).
- 압축과 예측은 동전의 양면이다. 샌더슨은 산술 부호를 예측기를 압축기로 바꾸는 거의 완벽한 방법이라 부른다(29:11). 압축기로도 예측할 수 있다. 후보 문자열을 붙여 늘어난 비트 수가 δ면 2−δ가 그 문자열의 확률 근사다(29:36). 좋은 예측에는 세계의 일관된 모형이 필요해 보이므로 압축률은 지능의 대리 지표가 될 수 있다고 그는 본다(30:07). 그는 신경과학의 예측 처리 이론도 같은 쪽을 가리킨다고 본다(30:18). 뇌가 감각 신호를 위에서 예측하고, 아래 단계는 예측과 실제의 오차만 위로 올려 보낸다는 이론이다. 영상은 오차를 올리는 쪽을 감각 기관이라고 말한다. 이론의 원전(Rao·Ballard 1999)에서는 피질 위계의 아래 영역이다(팩트체크).
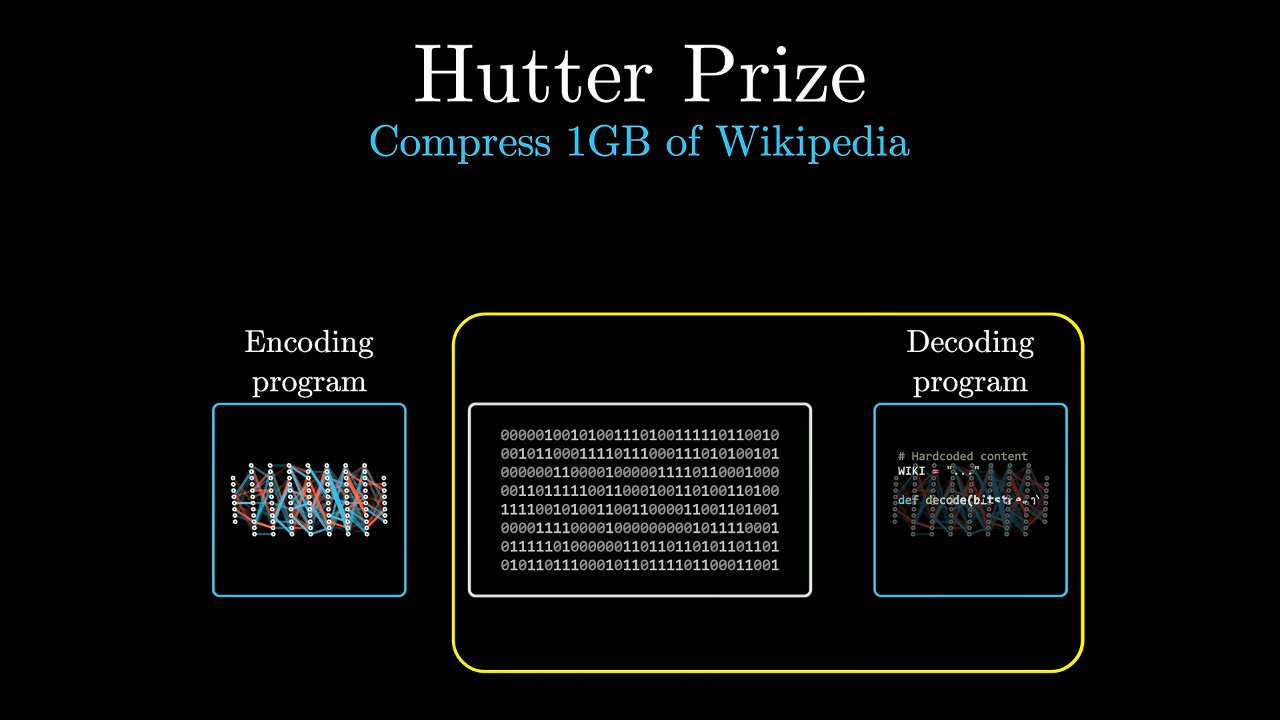
- 작은 모델이 더 나은 압축이다. 샌더슨은 사실 몇 개로 넓은 결과를 다시 유도할 수 있을 때 더 잘 이해했다고 느낀다(30:53). 예측력이 같다면 매개변수가 수조 개인 모델보다 작은 모델이 외운 가정에 덜 기댄다(31:13). 산술 부호화만 보면 두 모델의 압축 크기는 같다. 정직하게 세려면 모델을 포함한 복호 프로그램의 크기를 더해야 한다. 허터 상이 그렇게 채점한다(31:46). 샌더슨은 이 회계 때문에 ‘압축은 지능이다’가 ‘예측은 지능이다’보다 생각할 거리가 많다고 말한다(32:52).
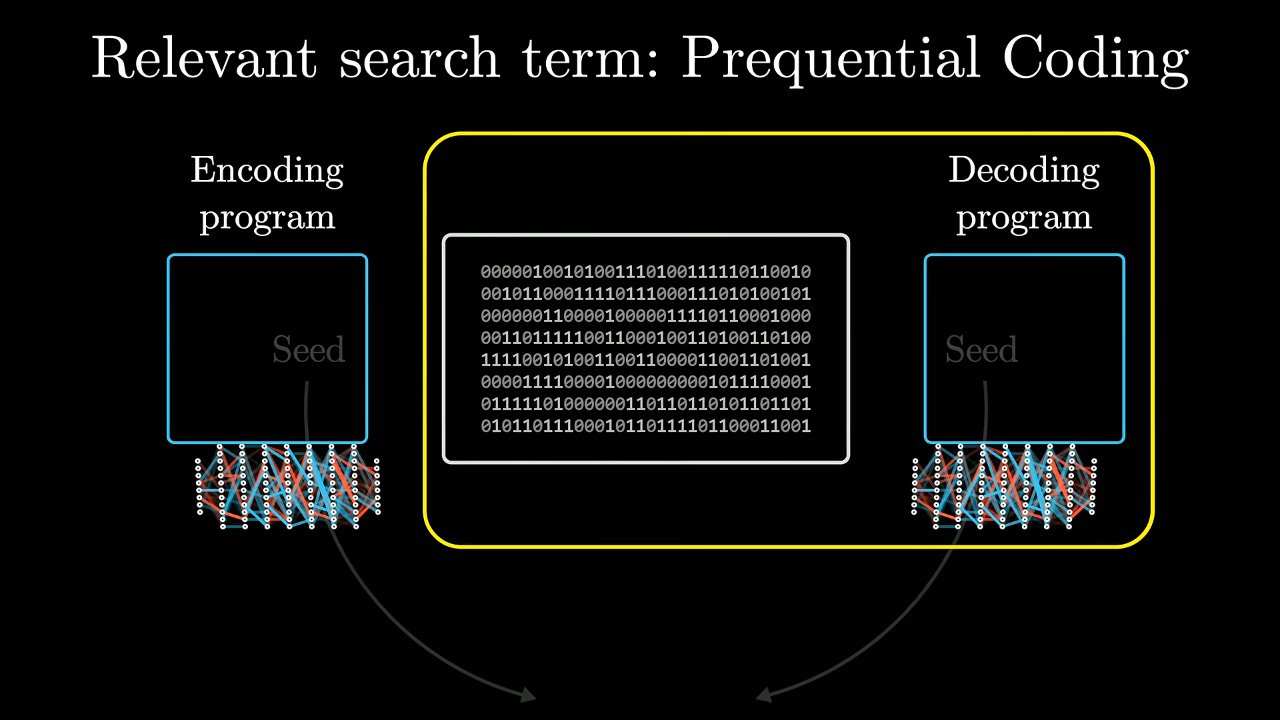
- 빨리 배우는 능력도 압축률에 들어간다(35:02). 정적 모델이면 학습 시간은 압축 크기와 무관하다(33:16). 위키백과로 학습한 모델로 셰익스피어를 압축하면서 토큰마다 역전파로 즉석 미세조정을 하면 모델이 새 문맥에 맞춰 간다(34:01). 갱신이 결정적이면 복호기가 같은 갱신을 재현한다(34:28). 샌더슨은 이 방식이 실무에 쓰인다고 말한다. 양쪽이 같은 시드의 무작위 모델에서 시작하면 매개변수를 보낼 필요도 없다(34:49). 화면이 띄운 검색어는 순차 예측 부호화(prequential coding)다.
설명란은 일리야 수츠케버(Ilya Sutskever)의 강연 「An Observation on Generalization」과 장이딩(Yiding Jiang)의 순차 예측 부호화 글도 건다.
3부작의 1편에서 섀넌은 영어의 압축성을 사람의 예측을 조사해서만 추정할 수 있었다(35:16). 2편에서 현대 인공지능 공학은 압축 연구에서 나온 수학 도구를 쓴다. 3편에서 허터 상 기준 최상위 압축은 예측을 잘하면서 작고 빨리 배우는 모델을 요구한다. 둘이 같지 않다는 답의 근거로 그는 뉴턴의 에너지가 웹스터 사전의 ‘에너지’와 다르다는 비유를 다시 꺼낸다(36:04). 지능의 수학적 정의로서 압축은 그의 예상보다 많은 칸을 채웠다(36:13).
영상이 직접 말하는 한계
- 앞의 “mathematics”처럼 섀넌 한계를 깨는 듯한 사례는 운이다. a만으로 된 메시지는 빈 비트열이 되어 정보가 전부 글자 수에 담긴다(19:17). 섀넌의 정리는 평균에 대한 것이다. 이런 행운은 올림이 필요한 더 흔한 경우와 상쇄된다(19:34). 샌더슨은 “mathematics”의 문자당 0.91비트도 글자 수 전송을 빼고 센 값이라고 덧붙인다(16:05).
- 식의 p는 모델이 준 확률이지 참 확률이 아니다. ⌈−log2 p⌉는 섀넌 정보량이 아니다(19:59). 산술 부호화가 섀넌 한계에 다가가는 정도는 모델이 언어의 참 통계에 다가간 정도와 같다(20:16).
- 헌법 전문의 45비트는 수억 개 가중치에 전문을 외운 거대 모델 덕일 수 있다. 샌더슨은 이 지적을 “전적으로 맞다”고 받는다(25:02). 그는 이 반론을 복호기 크기를 세는 회계로 처리한다(32:26).
- 그림을 그대로 구현하면 확대할수록 초정밀 실수가 필요해 실용 알고리즘이 되지 않는다(25:21). 샌더슨에 따르면 이 아이디어는 최소 1960년 피터 일라이어스(Peter Elias)의 미발표 작업까지 거슬러 간다. 문헌으로 확인되는 시점은 1963년 이전까지다(팩트체크). 1976년 요르마 리사넨(Jorma Rissanen)과 리처드 파스코(Richard Pasco)가 각자 구간을 매 단계 길이 1로 재정규화하는 실용 버전을 만들었다(25:51, 26:12). 구현 세부는 설명란의 Dr. Dobb's Journal 1991년 2월호 기사와 Nayuki의 참고 구현이 다룬다.
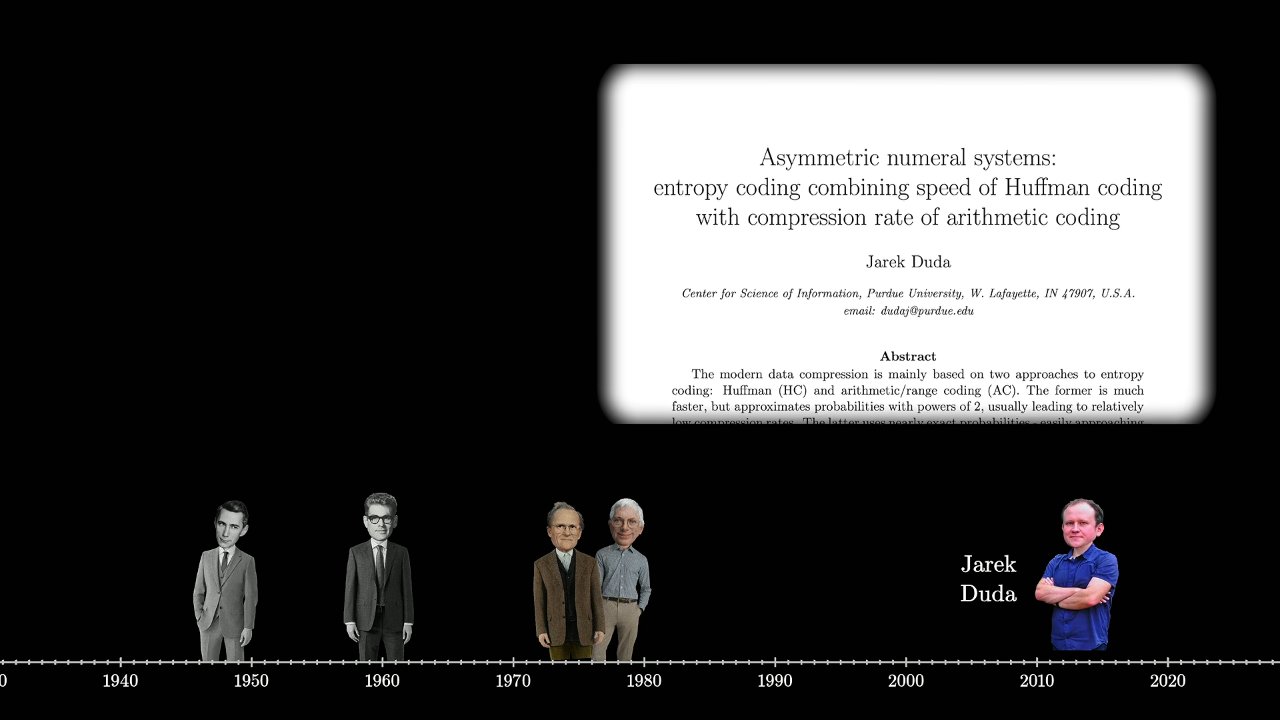
- 다른 길은 커지는 정수 하나로 부호화하는 비대칭 수 체계(asymmetric numeral systems, ANS)다. 샌더슨은 ANS가 더 빠르다고 말한다(26:42). 그는 야레크 두다(Jarek Duda)가 2013년에 ANS를 발표했다고 말한다. 설명란이 거는 두다의 논문은 arXiv 0902.0271이다. 2009-02-02에 나온 첫 프리프린트다. 26:51 화면의 논문 표지는 2013-11-11 프리프린트(arXiv 1311.2540)다(팩트체크).
산술 부호화가 보여 주는 것은 예측의 질이 그대로 비트 수가 된다는 등식이다. 샌더슨이 남기는 질문은 그 비트 수가 지능의 정의로 어디까지 버티느냐다. 그가 가리키는 시험대는 복호기 크기까지 세는 허터 상 방식의 채점이다.
팩트체크
신뢰도 A
정합성: 핵심은 맞다. 산술 부호화의 원리와 '압축 = 예측' 등가, 복호기 크기 논증이 1차 문헌과 맞는다. 틀린 곳은 역사 연도와 비율 표현, 에너지 비유 같은 곁가지다.
뒤집힌 주장은 하나다. 원문 '뉴턴이 에너지에 수학적 뜻을 줬다'(27:56) → 확인 '토머스 영(1807)과 코리올리(1829)'. 영은 'energy'를 현대적 뜻으로 처음 썼다. 코리올리는 운동 에너지를 현대적 뜻으로 기술했다. 말로 한 단위 kg·m/s²는 힘의 단위 뉴턴이다. 화면의 kg(m/s)²가 에너지 단위 줄이다.
나머지 부분사실 네 건은 핵심은 맞는데 세부가 어긋난다. 헌법 전문 45비트는 허프먼 부호화 1,461비트의 약 1/32이다. 원문 '두 자릿수 개선' → 확인 '1.5자릿수'. ANS의 첫 프리프린트는 2013년보다 이른 2009-02-02다. 일라이어스 작업의 문헌 근거는 '1960년'이 아닌 '1963년 이전'이다. 예측 처리 이론에서 오차를 올려 보내는 주체는 감각 기관이 아닌 피질 위계의 아래 영역이다.
허터 상 관련 수치는 공식 기록과 맞는다. 화면의 우승자 표 6행이 공식 기록표와 모두 일치한다. 현재 기록 100,424,672바이트(2026-07-24, 블라디미르 이바노프)는 글자당 약 0.80비트다.
기호: ✅사실 = 출처 본문이나 화면 숫자의 계산이 주장과 맞는다 · 🟡부분사실 = 연도·비율·주체·단위 같은 세부 일부만 출처와 다르다 · ⚠️불확실 = 접근한 출처로 확정하지 못했다 · ❌거짓 = 출처가 주장과 어긋난다. '화면 숫자끼리의 계산'으로 표시한 ✅는 영상 안 수치의 산수가 맞는다는 뜻이다. 모델을 다시 돌린 재현은 아니다. 판정 38건 = ✅32 · 🟡5 · ⚠️0 · ❌1.
등급 기준: A = 오류가 곁가지에만 있다 · B = 곁가지 오류가 결론 해석에 닿는다 · C = 핵심 주장 일부가 부분사실이다 · D = 핵심 주장 일부가 거짓이다 · F = 핵심 주장이 거짓이거나 근거가 없다. 따로 적지 않은 수치의 기준일은 2026-11-19다.
허터 상과 헌법 전문 비교 수치
허터 상(Hutter Prize)은 위키백과 1GB 압축 기록을 깨는 누구에게나 열린 현금 상이다. 화면은 '1% 개선마다 €5,000'이라고 적는다. 00:09 00:14
과제는 1GB(10⁹바이트) 파일 enwik9를 무손실 압축해 직전 기록보다 작게 만드는 것이다. 상금 공식은 500,000유로 × (1 − S/L)이다. 최소 청구액은 1% 개선에 해당하는 5,000유로다. 1% 개선마다 5,000유로라는 화면 표기와 맞는다. 2026-11-19 기준 누적 지급액은 85,485유로다.
근거: 허터 상 공식 페이지(The Task 절)
우승자는 압축 결과 크기만으로 정하지 않는다. 복원 프로그램의 크기도 함께 센다. 01:16 32:09
규정의 총크기는 압축기 크기와 스스로 풀리는 아카이브(archive9.exe) 크기의 합이다. 아카이브가 복원 프로그램을 품으므로 복원기 크기가 점수에 들어간다. 복원기를 따로 내는 변형에서는 복원기 크기를 두 번 센다. 영상은 복원기만 말했다. 실제 규정은 압축기 크기까지 더한다.
근거: 허터 상 규정(Rules·Relaxations 절)
화면의 우승자 표: V. Ivanov 100Mb €37,300 · D. Freelan 108Mb €5,240 · I. Marcouch & K. Orav 109Mb €5,050 · K. Orav & B. Knoll 110Mb €7,950 · K. Orav 112Mb €6,911 · S. Kumar 114Mb €5,187. 26:40
공식 기록표와 6행 모두 맞는다. 날짜와 총크기(바이트)는 블라디미르 이바노프 2026-07-24 100,424,672 · 데이비드 프리랜 2026-07-19 108,521,870 · 이브라힘 마르쿠슈와 카이도 오라브 2026-06-26 109,671,639 · 카이도 오라브와 바이런 놀 2024-09-03 110,793,128 · 카이도 오라브 2024-02-02 112,578,322 · 사우라브 쿠마르 2023-07-16 114,156,155다. 화면의 'Mb'는 메가바이트(MB)다. 이바노프의 7.46%는 기록표에서 가장 큰 개선 폭이다. 공식 페이지 연표도 2026년을 '역대 최대 개선'의 해로 적는다.
근거: 허터 상 공식 페이지(Current and Previous Records 표, History)
산술 부호화는 허터 상 우승작 몇 개가 아니라 전부의 뼈대다. 개선은 대개 더 나은 예측기를 끼운 데서 나왔다. 00:28 26:33
허터 상 공식 페이지는 이 영상을 소개하는 줄에서 '(온라인) 신경망 기반 산술 부호화'를 역대 우승작 전부의 바탕이라고 적는다. 역대 우승작은 paq8hp 계열에서 phda9, starlit, cmix 계열로 이어진다. PAQ 계열은 다음 비트의 확률을 예측한 뒤 그 확률로 산술 부호화한다.
근거: 허터 상 공식 페이지(머리말의 3Blue1Brown 소개 줄) · 위키백과 PAQ(Algorithm 절)
이 알고리즘은 큰 텍스트를 글자당 1비트 미만으로 압축한다. 00:00
허터 상 현재 기록은 enwik9를 100,424,672바이트로 줄였다(2026-07-24). 글자(바이트)당 100,424,672 × 8 / 10⁹ ≈ 0.80비트다. 영상 23:42의 Qwen 예시는 글자당 약 0.75비트다.
근거: 허터 상 공식 페이지(기록표 첫 행)
헌법 전문을 기본 ASCII로 쓰면 2,500비트가 넘는다. 화면 값은 2,616비트다. 03:49
국립문서보관소 전사본의 전문은 공백·문장부호를 포함해 327자다. 한 글자에 8비트를 쓰면 327 × 8 = 2,616비트로 화면 값과 같다. ASCII 부호표 자체는 7비트다. 화면 값은 한 글자를 8비트 바이트 하나로 저장하는 관행을 따른 계산이다.
근거: 미국 국립문서보관소 헌법 전사본(Preamble)
영상이 쓴 허프먼 부호화로는 이 구절이 약 1,500비트까지만 줄어든다. 04:06
화면 값은 1,461비트로 '약 1,500비트'와 맞는다. 글자당 1,461 / 327 ≈ 4.47비트다. 이 판정은 화면 숫자끼리의 계산이다.
근거: 영상 화면 04:14
섀넌의 한계와 비트 수 계산
1940년대에 클로드 섀넌은 최적 압축에 드는 비트 수가 메시지 확률의 음의 로그(밑 2)와 거의 같음을 보였다. 그는 이 양을 사건의 섀넌 정보량으로 정의했다. 01:46 01:58
섀넌의 1948년 논문은 좋은 부호에서 긴 메시지의 신호 길이가 확률 역수의 로그에 비례한다고 적는다. 개별 사건의 −log p는 오늘날 섀넌 정보량(self-information)이라 부른다. 위키백과 'Information content' 항목은 이 정의를 섀넌에게 귀속한다.
근거: 섀넌 1948(9절, 정리 9 뒤 문단) · 위키백과 Information content(Definition 절)
섀넌은 어떤 압축 알고리즘도 평균적으로 이 한계보다 적은 비트를 쓸 수 없음을 증명했다. 원리상 한계에 임의로 가까이 갈 수 있다는 것도 보였다. 18:12
1948년 논문의 정리 9(무잡음 채널 기본 정리)가 두 방향을 함께 담는다. 엔트로피가 H인 원천은 용량 C인 채널로 초당 C/H − ε개 기호를 보낼 수 있다. ε는 임의로 작게 잡는다. C/H보다 빠른 평균 속도는 불가능하다. 영상 19:34의 '정리는 평균에 관한 것'이라는 설명도 이 정리의 형태와 맞는다.
근거: 섀넌 1948(정리 9)
섀넌이 최적 압축을 설명할 때 핵심 착상 하나는 완벽히 압축된 메시지가 무작위 잡음과 구별되지 않아야 한다는 것이었다. 12:44
섀넌은 부호기가 원천을 채널에 통계적으로 맞춰야 한다고 썼다. 채널에서 본 원천은 채널 엔트로피를 최대로 만드는 원천과 같은 통계 구조를 가져야 한다. 제약 없는 이진 채널에서 엔트로피가 최대인 원천은 서로 독립인 공정한 동전 던지기다. '무작위 잡음과 구별되지 않는다'는 이 조건을 풀어 쓴 표현이다.
근거: 섀넌 1948(9절, 정리 9 뒤 변압기 비유 문단)
NanoGPT의 글자당 약 2비트는 섀넌이 가능하다고 추정한 값의 두 배다. 23:13
섀넌의 1951년 논문은 100글자 범위의 문맥을 쓰면 영어 엔트로피가 글자당 약 1비트라고 추정한다. 섀넌의 영어는 26글자와 공백만 쓴 27기호다. NanoGPT 예시 문장에는 대문자와 문장부호가 들어 있다. 비교 조건은 조금 다르다. '약 1비트의 두 배'라는 산수는 맞는다.
근거: 섀넌 1951(1절 서론)
3부작 1편의 결론: 섀넌은 순수한 데이터 분석만으로는 부족했다. 그는 사람의 예측을 조사해서만 영어의 압축 가능성을 추정할 수 있었다. 35:20
1951년 논문은 8글자까지의 통계로는 글자당 약 2.3비트(중복도 약 50%)에 그쳤다고 적는다. 섀넌은 사람이 앞 글자를 보고 다음 글자를 맞히는 실험으로 새 추정법을 세웠다. 장거리 문맥의 약 1비트 추정은 이 실험에서 나왔다.
근거: 섀넌 1951(초록, 1절)
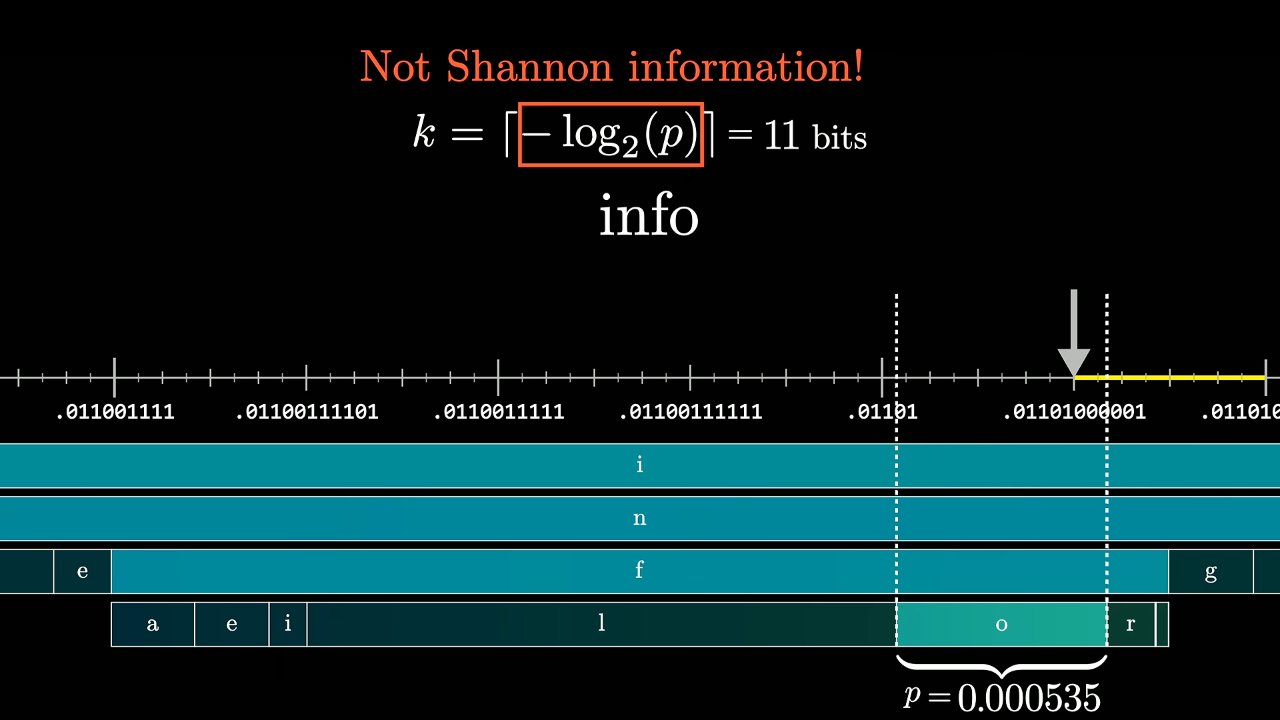
확률이 p인 텍스트는 −log₂ p를 올림한 비트 수로 반드시 표현할 수 있다. 화면 예는 p = 0.000535 → 11비트다. 17:49 20:05
k비트 이하로 쓰는 수의 간격은 2⁻ᵏ이다. 폭이 p인 구간에는 2⁻ᵏ ≤ p일 때 그런 수가 반드시 하나 들어간다. −log₂ 0.000535 ≈ 10.87을 올리면 11이다.
문헌의 산술 부호 길이 상한은 ⌈−log₂ p⌉ + 1비트다. 1비트 차이는 뒤에 어떤 비트가 붙어도 같은 텍스트로 풀리게 하는 접두 부호 조건에서 생긴다. 영상의 방식은 메시지 길이를 따로 보낸다. 비트열은 정확한 수로 읽는다. 그 방식에서는 영상의 식이 맞는다.
근거: 영상 화면 17:49 20:05 · 델레탕 외 2023(2절 Arithmetic Coding)
math는 10비트(글자당 2.5비트)로 표현된다. 같은 10비트 문자열이 mathematics 구간에도 들어가 글자당 0.91비트가 된다. mathematics 구간의 폭은 2⁻¹⁸이다. 15:25 16:35
10 / 4 = 2.5, 10 / 11 ≈ 0.909로 화면 값과 맞는다. 폭 2⁻¹⁸은 18비트의 섀넌 정보량에 해당한다. 10비트 표현은 영상이 말한 대로 운이 좋은 경우다. 이 비율에는 메시지 길이를 보내는 비용이 빠져 있다. 이 판정은 화면 숫자끼리의 계산이다.
근거: 영상 화면 14:50 16:35
메시지 길이에 32비트 고정 헤더를 쓰면 약 40억 글자까지 안전하게 부호화한다. 18:47
32비트로 쓸 수 있는 가장 큰 수는 2³² − 1 = 4,294,967,295다. 화면 예의 92도 32비트 이진수 00000000000000000000000001011100으로 바르게 적혀 있다. 이 판정은 화면 숫자끼리의 계산이다.
근거: 영상 화면 18:51
산술 부호화와 ANS의 역사
이 알고리즘은 임의의 텍스트를 0과 1 사이의 아주 특정한 실수 하나로 부호화한다. 06:10
설명란이 링크한 마크 넬슨의 Dr. Dobb's Journal 기사(1991-02)는 산술 부호화의 출력이 0 이상 1 미만의 수 하나라고 적는다. 기사는 이 수를 16비트 정수 레지스터로 조금씩 내보내는 구현도 보인다.
근거: Dr. Dobb's Journal 1991-02 기사(How Arithmetic Coding Works 절)
허프먼 부호화처럼 한 글자를 늘 같은 비트열로 바꾸는 방법은 문맥을 반영하지 못한다. 04:38
렐레워와 허시버그의 압축 서베이는 허프먼 부호화가 최적이라는 말이 '원천 메시지마다 고유한 부호어 하나를 대응시킨다'는 제약 아래에서만 참이라고 적는다. 그 제약 밖에 있는 방법이 산술 부호화다.
근거: Lelewer & Hirschberg, Data Compression(3절 머리)
이 방법은 텍스트 전용이 아니다. 이미지·동영상·오디오를 포함한 어떤 데이터 형식에도 쓰는 일반 기법이다. 00:35
델레탕 외(2023)는 텍스트로 주로 학습한 Chinchilla 70B를 산술 부호화에 끼워 ImageNet 이미지 조각을 원래 크기의 43.4%로, LibriSpeech 음성을 16.4%로 줄였다. 같은 조건에서 PNG는 58.5%, FLAC은 30.3%다. 동영상 표준 H.264/AVC와 HEVC의 엔트로피 부호화 CABAC도 산술 부호화를 바탕으로 한다. 설명란이 링크한 JPEG AI 표준은 같은 '예측 분포 + 엔트로피 부호화' 구조에 ANS 계열 부호기(me-tANS)를 쓴다.
근거: 델레탕 외 2023(초록) · 위키백과 CABAC(Algorithm 절) · JPEG AI 개관(Entropy coding pipeline 절)
이 착상은 적어도 1960년 피터 일라이어스의 미발표 작업까지 거슬러 올라간다. 25:51
원문 '적어도 1960년' → 확인 '1963년 이전'. 피비리와 벤투리니의 서베이는 일라이어스가 1963년 이전에 산술 부호화 개념을 냈다고 적는다. 근거는 노먼 에이브럼슨의 1963년 교재 61쪽 주석이다. 그 방법에 무한 정밀도가 필요했다는 점도 영상의 설명과 맞는다. 1960이라는 연도는 접근한 문헌에서 확인되지 않는다.
근거: Pibiri & Venturini(2절 Arithmetic) · Lelewer & Hirschberg(3.4절)
1976년 요르마 리사넨과 리처드 파스코가 계속 늘어나는 수치 정밀도가 필요 없는 실용판을 독립적으로 개발했다. 이것이 오늘날 산술 부호화로 알려진 방법이다. 25:58
리사넨(IBM 연구소)의 논문 'Generalized Kraft Inequality and Arithmetic Coding'(IBM Journal of Research and Development 20권 3호)과 파스코(스탠퍼드대 박사과정)의 박사논문 'Source coding algorithms for fast data compression'은 둘 다 1976-05에 나왔다. 파스코의 논문은 리사넨 논문의 출간 전 원고를 인용한다.
근거: 위키백과 Arithmetic coding(History and patents 절)
실용판의 핵심은 매 단계 보고 있는 구간을 길이 1로 다시 늘리는 재정규화다. 26:12
위키백과는 확정된 앞자리를 출력한 뒤 남은 자리를 왼쪽으로 밀어 범위를 다시 넓히는 과정을 재정규화라고 부른다. 이 과정 덕분에 유한 정밀도로도 기호 수 제한 없이 부호화한다. 넬슨의 1991년 기사도 같은 자리 밀어내기를 16비트 정수로 구현한다.
근거: 위키백과 Arithmetic coding(Precision and renormalization 절) · Dr. Dobb's Journal 1991-02 기사
예측기를 압축기로 바꾸는 다른 방법인 비대칭 수 체계(ANS)는 2013년 야레크 두다가 발표했다. 26:42
원문 '2013년 발표' → 확인 '첫 프리프린트 2009-02-02'. 설명란이 링크한 arXiv 0902.0271 'Asymmetric numeral systems'의 v1 제출일이 2009-02-02다. 26:51 화면의 논문 표지는 arXiv 1311.2540(v1 제출 2013-11-11)이다. 허프먼 수준 속도와 산술 부호화 수준 압축률을 함께 내세운 판이 이 2013년 논문이다. 위키백과는 ANS가 2014년부터 실제 압축에 쓰였다고 적는다. 야레크 두다가 제안자라는 점은 맞다.
근거: arXiv 0902.0271(제출 이력) · arXiv 1311.2540 · 위키백과 Asymmetric numeral systems
ANS는 실수 대신 계속 커지는 정수 하나로 메시지를 부호화해 정밀도 문제를 피한다. 몇 가지 기법을 더해 전체 부호화가 훨씬 빠르다. 26:55
두다의 2013년 논문 초록은 범위를 나타내는 두 수 대신 자연수 하나를 상태로 쓴다고 적는다. 당시 구현은 256기호 알파벳에서 허프먼 부호화보다 약 50% 빠른 복호를 냈다. 압축률은 산술 부호화와 비슷하다. ANS는 Facebook의 Zstandard, Apple의 LZFSE, JPEG XL에 들어갔다.
근거: arXiv 1311.2540(초록) · 위키백과 Asymmetric numeral systems(개요)
언어 모델 실험과 교차 엔트로피
−log p의 p는 참 확률이 아니라 모델이 텍스트에 준 확률이다. 그래서 부호 길이는 섀넌 정보량과 다르다. 모든 토큰에 걸친 이 값의 평균이 모델 분포와 참 분포의 교차 엔트로피다. 19:59 21:42
델레탕 외(2023) 2절은 참 분포 ρ 대신 매개변수 모형 ρ̂로 부호화하면 기대 비트 수가 교차 엔트로피 H(ρ, ρ̂)가 된다고 적는다. 압축률이 모델 품질에 달렸다는 영상의 결론(20:16)과 같은 식이다.
근거: 델레탕 외 2023(2절 Likelihood Maximization)
사전학습이 최소화하는 교차 엔트로피 손실은 최선의 텍스트 압축기를 만드는 목표와 수학적으로 같다. 21:50–22:34
델레탕 외(2023)는 기대 부호 길이 식이 현재 기반 모델 훈련에 쓰는 로그 손실과 같은 목표라고 적는다. 로그 손실을 줄이는 일은 그 모델을 산술 부호화에 끼운 무손실 압축기의 압축률을 줄이는 일과 같다.
근거: 델레탕 외 2023(2절)
NanoGPT로 만든 370만 매개변수 장난감 모델은 127자 예시 문장을 254비트, 글자당 약 2비트로 부호화한다. 23:01
254 / 127 = 2.0으로 화면 값과 맞는다. 예시 문장은 끝 마침표를 빼면 127자다. NanoGPT는 안드레이 카르파티가 공개한 GPT 훈련 코드 저장소다. 370만 매개변수는 영상 제작진이 쓴 모델의 크기다. 모델 파일은 설명란에 없다. 이 판정은 화면 숫자끼리의 계산이다.
근거: 영상 화면 23:18 · nanoGPT 저장소(README)
Qwen은 매개변수가 약 5억 개인 오픈소스 모델이다. 화면 제목은 'QWEN (494M)'이다. 23:29
Hugging Face의 Qwen2.5-0.5B 모델 카드는 매개변수 0.49B(임베딩 제외 0.36B)와 Apache 2.0 라이선스를 적는다. 같은 페이지의 가중치 파일 정보는 매개변수 494,032,768개로 화면의 494M과 맞는다. 영상은 Qwen의 버전을 밝히지 않는다.
Qwen으로 같은 문장을 부호화하면 마지막 두 단어가 5비트만 든다. 전체 평균은 글자당 1비트 미만이다. 23:36
화면 값은 96비트, 글자당 약 0.75비트다(96 / 127 ≈ 0.756). 23:42 프레임에서 'Euclid's Elements'에 해당하는 노란 비트는 00011로 5비트다. 메시지 길이 22토큰은 8비트 헤더(00010110)로 따로 붙는다. 이 판정은 화면 숫자끼리의 계산이다.
근거: 영상 화면 23:42
헌법 전문은 첫 구절에 약 35비트, 나머지 전부에 10비트가 든다. 처음의 허프먼 부호화와 비교하면 두 자릿수 개선이다. 23:49–24:04
35비트와 10비트는 화면 값(35자 → 35비트, 전문 327자 → 45비트)과 맞는다.
원문 '두 자릿수 개선' → 확인 '약 32배, 1.5자릿수'. 1,461 / 45 ≈ 32.5다. 상용로그로 log₁₀ 32.5 ≈ 1.51자릿수다. 8비트 메시지 길이 헤더를 더하면 1,461 / 53 ≈ 27.6배다. ASCII 2,616비트와 견줘도 약 58배로 100배에 닿지 않는다.
근거: 영상 화면 24:00 24:05
압축은 지능이다 논의
압축기를 예측기로도 바꿀 수 있다. 어떤 문자열을 덧붙였을 때 늘어난 압축 크기를 δ라 하면 2⁻ᵟ가 그 문자열 확률의 근사다. 29:19
델레탕 외(2023)는 예측과 압축의 등가로 gzip 같은 임의의 압축기에서 조건부 생성 모형을 만들 수 있다고 적는다. 3.4절의 식은 ρ̂(b | x<i) = 2ℓc(x<i) − ℓc(x<ib)이다. ℓc는 압축기 c의 출력 길이다. 지수가 영상의 −δ와 같다.
근거: 델레탕 외 2023(초록) · 같은 논문 본문(3.4절)
이 생각은 현대 신경과학의 영향력 있는 이론인 예측 처리와 닿는다. 뇌는 감각 신호를 계속 하향 예측한다. 감각 기관이 올려 보내는 것은 받은 정보 전부가 아니라 예측과 실제의 오차뿐이다. 30:18
이론의 뼈대는 맞다. 라오와 밸러드(Nature Neuroscience, 1999)의 예측 부호화 모형에서 상위 시각 피질은 하위 영역의 활동을 예측해 되먹임으로 내려보낸다. 피드포워드 연결은 예측과 실제 활동의 잔차만 나른다. 원문 '감각 기관이 오차를 올려 보낸다' → 확인 '피질 위계의 각 아래 영역이 오차를 올려 보낸다'. 앤디 클라크의 표적 논문(Behavioral and Brain Sciences, 2013)은 이 위계적 예측 기계 접근을 마음과 행동의 통합 과학에 가장 좋은 단서로 평가한다.
근거: Rao & Ballard 1999(초록) · Clark 2013(초록)
정직한 압축률은 모델 자체를 포함한 복호 프로그램 크기를 셈해야 한다. 그렇게 재면 예측력이 같은 두 모델 가운데 작은 쪽이 더 나은 압축기다. 31:46–32:40
델레탕 외(2023)는 매개변수당 2바이트로 모델 크기를 더한 '조정 압축률'을 쟀다. 대형 언어 모델은 크기 탓에 압축률을 크게 잃는다. 1GB 데이터로는 그 손실을 메우지 못한다. 데이터셋마다 최적 모델 크기가 따로 있다는 그림 2도 같은 논증이다. 허터 상이 복원기 크기를 세는 이유와도 같다.
근거: 델레탕 외 2023(그림 2와 그 앞 문단)
05:11의 '작은 모델이 실제로 유리하다'는 예고는 31:13–32:52의 복호기 크기 논증과 맞는다.
05:15의 예고는 설명을 뒤로 미뤘다. 32:35의 결론이 그 약속을 갚는다. 같은 예측력이면 작은 모델이 더 나은 압축으로 계산된다는 결론이다. 영상 안의 앞뒤가 맞는다.
근거: 영상 자막 05:15 32:35
압축하는 동안 모델을 즉석에서 미세조정하는 방식은 실제로 쓰인다. 부호기와 복호기가 같은 의사난수 모델로 시작하면 매개변수를 하나도 보내지 않아도 된다. 그러면 압축률이 학습 속도에도 달린다. 34:01–35:14
설명란이 링크한 이딩 장과 앨런 저우의 블로그 글(2025-05-06)은 이 방식을 순차 예측 부호화(prequential coding)로 설명한다. 송신자는 고정 난수 시드로 모델을 초기화하는 훈련 스크립트만 보낸다. 양쪽이 같은 모델을 따로 훈련하므로 매개변수는 오가지 않는다. 부호 길이는 훈련 손실 곡선 아래 넓이와 같다. 빨리 배우는 모델일수록 부호가 짧다. 파브리스 벨라르의 NNCP v2(2021-02-06)는 부호기와 복호기가 같은 계산 단계를 밟는 Transformer 압축기로 이 방식을 실제로 쓴다.
근거: Jiang & Zhou 블로그(Prequential coding 절) · NNCP v2(2.3 Training details)
뉴턴이 '에너지'라는 낱말에 수학적 뜻을 줬다. 그 정의는 축소적이었지만 서로 달라 보이는 현상들을 하나로 묶었다. 27:56 36:10
원문 '뉴턴' → 확인 '라이프니츠·영·코리올리'. 17세기 말 고트프리트 라이프니츠가 질량 곱하기 속도 제곱인 vis viva('살아 있는 힘')를 제안했다. 'energy'를 현대적 뜻으로 처음 쓴 사람은 토머스 영(1807)으로 꼽힌다. 코리올리는 1829년 운동 에너지를 현대적 뜻으로 기술했다. 열과 운동을 한 양으로 묶은 단계는 19세기 초의 에너지 보존 법칙과 1845년 제임스 줄이 밝힌 일과 열의 관계다. 36:10의 '뉴턴의 에너지 정의'도 같은 오류다.
화자의 비유는 인물을 영이나 코리올리로 바꾸면 그대로 성립한다.
근거: 위키백과 Energy(History 절)
에너지는 '킬로그램 미터 매 초 제곱' 단위의 측정 가능한 양이다. 화면은 같은 자리에 kg(m/s)²를 적는다. 28:01
화면 표기가 맞다. 말로 한 단위가 틀렸다. 원문 kg·m/s² → 확인 kg·m²/s². kg·m/s²는 힘의 단위 뉴턴(N)이다. 에너지 단위 줄(J)은 kg·m²·s⁻²로 화면의 kg(m/s)²와 같다.
근거: 위키백과 Newton (unit) · 위키백과 Joule
시리즈와 설명란 자료
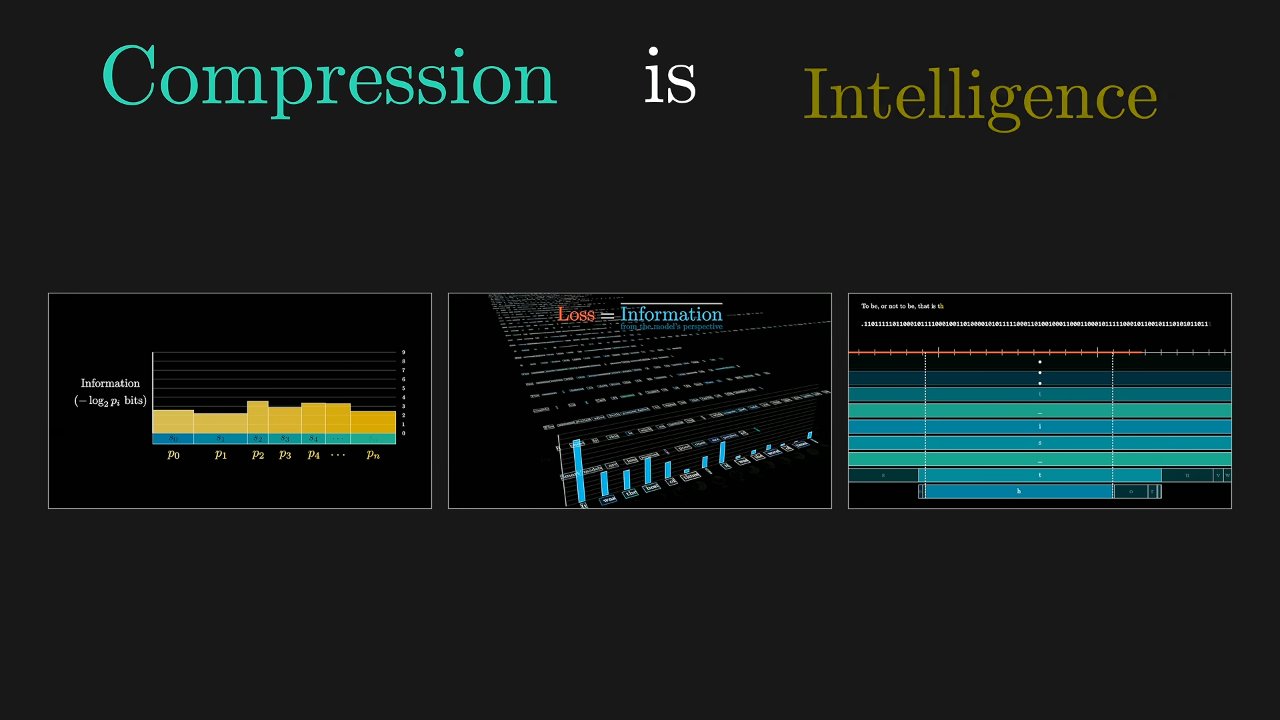
이 영상은 'Compression is Intelligence'라는 제목을 붙인 3부작의 3편이다. 화면은 1편 Reinventing Entropy, 2편 Cross Entropy, 3편 Arithmetic Coding으로 적는다. 27:22 35:25
3Blue1Brown 채널에 1편 'Reinventing Entropy | Information theory, part 1'(2026-06-07 공개)과 2편 'But what is cross-entropy? | Information theory, part 2'(2026-07-16 공개)가 있다. 1편 설명란은 섀넌의 1948년·1951년 논문을 원문 링크로 단다.
설명란은 일리야 수츠케버의 강연 'An Observation on Generalization'을 배경 자료로 링크한다.
Simons Institute for the Theory of Computing 채널이 2023-08-14에 올린 57분 21초짜리 강연이다. 영상 설명은 연사를 'Ilya Sutskever (OpenAI)'로 적는다.
원본 (완역)
영상 설명란
산술 부호, 그리고 산술 부호가 압축과 지능에 관해 보여 주는 것
채널 채용 박람회: https://3b1b.com/talent
상점에 새 상품이 들어왔다! https://3b1b.com/store
후원자 선공개: https://3b1b.com/support
산술 부호에 관해:
https://jacobfilipp.com/DrDobbs/articles/DDJ/1991/9102/9102a/9102a.htm
https://www.nayuki.io/page/reference-arithmetic-coding
비대칭 수 체계(ANS)에 관해:
https://arxiv.org/abs/0902.0271
https://demonstrations.wolfram.com/DataCompressionUsingAsymmetricNumeralSystems/
https://arxiv.org/pdf/2201.01741v2
https://arxiv.org/pdf/2510.13867
일리야 수츠케버(Ilya Sutskever), “An Observation on Generalization”(일반화에 관한 한 가지 관찰)
https://www.youtube.com/watch?v=AKMuA_TVz3A&t=24s
순차 예측 부호화(prequential coding)에 관한 짧은 글:
https://yidingjiang.github.io/blog/post/curriculum/
타임스탬프:
- 0:00 섀넌 추정치의 터무니없음(The absurdity of Shannon’s estimate) 완역
- 6:27 텍스트에서 실수로(From text to real numbers) 완역
- 16:57 이것이 섀넌의 한계인가(Is this Shannon’s limit?) 완역
- 20:26 사전학습을 다시 보기(Reframing pretraining) 완역
- 22:41 산술 부호화의 실제 동작(Arithmetic codes in action) 완역
- 27:29 “압축은 지능이다”에 대한 생각(Reflections on “Compression is Intelligence”) 완역
- 36:30 후원하는 세 가지 방법(Three ways to support) 완역
비밀 엔드스크린 브이로그: https://youtu.be/hoX3IiKXT-M
이 애니메이션은 대부분 자작 Python 라이브러리 manim으로 만든다. 자주 묻는 질문(FAQ)의 설명은 여기에 있다:
https://3b1b.co/faq#manim
음악: 빈센트 루비네티(Vincent Rubinetti).
https://vincerubinetti.bandcamp.com/album/the-music-of-3blue1brown
https://open.spotify.com/album/1dVyjwS8FBqXhRunaG5W5u
3blue1brown은 수학을 animate하는 채널이다. animate라는 낱말의 모든 뜻, 곧 움직이게 한다는 뜻과 생기를 불어넣는다는 뜻 모두에서 그렇다. 영상 설명란 맨 아래까지 읽고 있다면, 여러분은 아마 보통 시청자보다 이곳 강의에 관심이 더 많은 사람일 것이다. 새 강의 소식을 계속 받아 보기로 해 준다면 내게 큰 의미가 있다. 여기 YouTube에서 구독해도 좋고, 아래 플랫폼 가운데 가장 자주 확인하는 곳에서 팔로해도 좋다.
메일링 리스트: https://3blue1brown.substack.com
Twitter: https://twitter.com/3blue1brown
Bluesky: https://bsky.app/profile/3blue1brown.com
Instagram: https://www.instagram.com/3blue1brown
Reddit: https://www.reddit.com/r/3blue1brown
Facebook: https://www.facebook.com/3blue1brown
Patreon: https://patreon.com/3blue1brown
웹사이트: https://www.3blue1brown.com
섀넌 추정치의 터무니없음
00:00 이 애니메이션은 한 알고리즘을 미리 보여 준다. 이 알고리즘은 긴 텍스트를 글자당 1비트도 안 되는 크기로 압축한다. 곰곰이 생각해 보면 꽤 어안이 벙벙한 일이다.
00:09 텍스트 압축에는 실제로 누구나 도전할 수 있는 상금이 걸려 있다. 허터 상(Hutter Prize)이라는 상이다. 위키백과 1기가바이트를 최대한 작게 압축하는 현재 최고 기록을 깨는 사람이면 누구나 받을 수 있다.
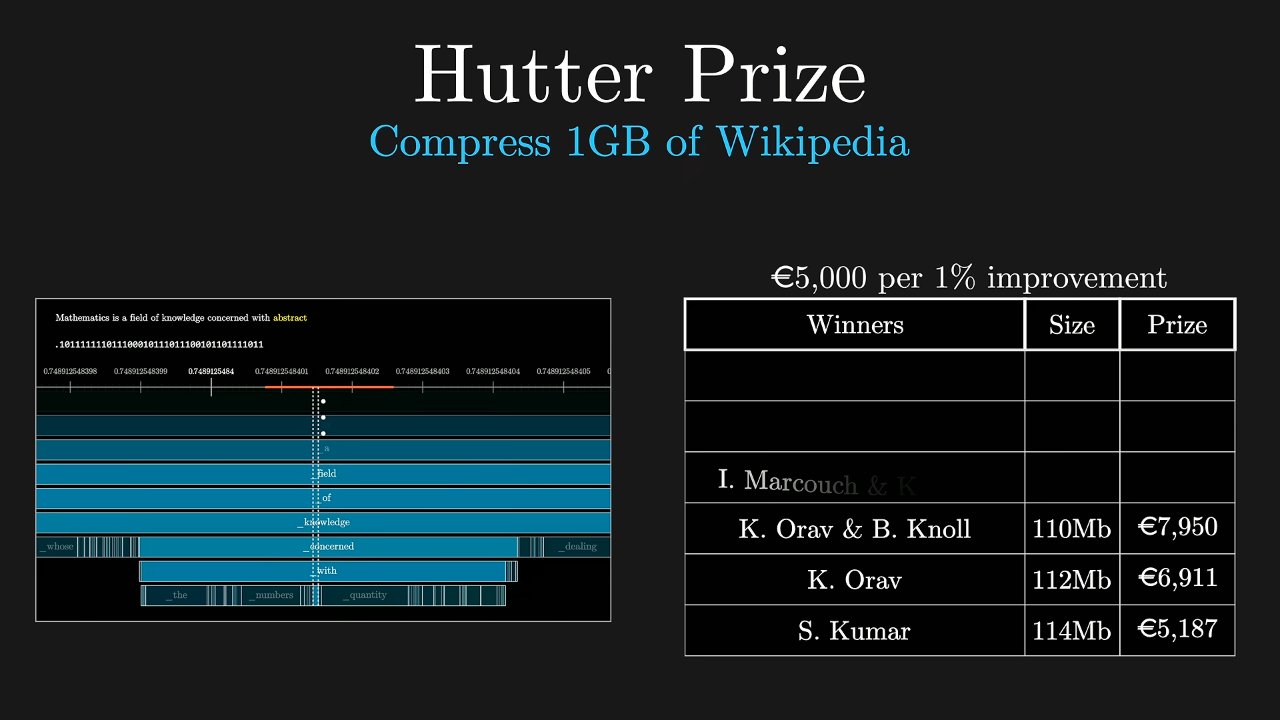
00:20 이 애니메이션이 정확히 무엇을 보여 주는지는 차근차근 쌓아 올려서 때가 되면 설명하겠다고 약속한다. 이 애니메이션이 전하는 핵심 아이디어를 두고 여기 우승작 몇 개의 바탕이라고 말하려 했는데, 그건 사실이 아니다. 실제로는 우승작 전부, 하나도 빠짐없이 모두의 뼈대다. 이 방법은 텍스트 전용도 아니다. 이미지나 동영상, 오디오, 사실상 어떤 데이터 종류든 압축할 수 있는 완전히 일반적인 기법이다. 이 알고리즘 덕분에 나는 “압축은 지능이다”라는 말도 다르게 생각하게 됐다. 그 이야기는 마지막까지 아껴 두겠다.
00:54 여느 압축 알고리즘처럼 이것도 서로 짝을 이루는 두 프로그램으로 생각할 수 있다. 하나는 송신자가 텍스트를 1과 0으로, 되도록 적은 수의 1과 0으로 부호화하는 데 쓴다. 다른 하나는 수신자가 그 비트열을 다시 텍스트로 복호화하는 데 쓴다. 여기서 목표는 무손실 압축이다. 출력이 원래 입력을 정확히 복제해야 한다는 뜻이다. 허터 상 우승자는 이 압축된 표현의 크기만으로 정하지 않고 복호화 프로그램의 크기도 함께 따진다.
01:25 지금 여러분이 이 상을 타려고 나섰다고 상상해 보라. 어디서부터 시작하겠는가? 그런 알고리즘을 꾸며 내는 일을 대체 어떻게 시작하겠는가? 한 가지 방법은 압축 가능성의 근본 한계를 깊이 생각해 보는 것이다. 어쨌든 그 한계의 본질을 이해하면 거기에 가까이 가는 방법이 보일 수도 있다. 이 내용은 앞 편에서 다뤘지만 짧게 되짚어 볼 만하다.
01:46 1940년대에 클로드 섀넌(Claude Shannon)은 한 메시지를 최적으로 압축할 때 쓰는 비트 수가 그 메시지를 볼 확률에 밑이 2인 로그를 취하고 음수를 붙인 값, 곧 −log2 P(message)와 대략 같아야 한다는 것을 보였다. 섀넌은 이 음의 로그 값을 한 사건의 정보량으로 정의했다.
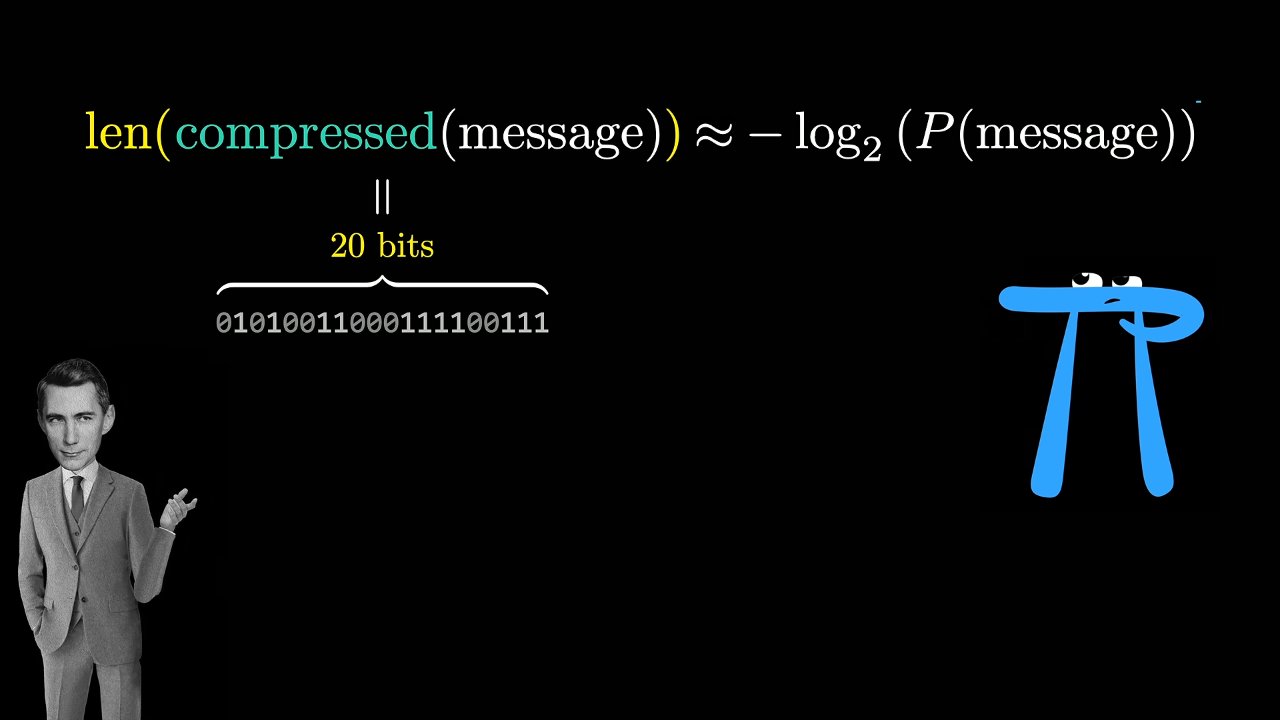
02:02 전에도 말했지만, 나는 이것을 차라리 p의 밑이 1/2인 로그, 곧 log1/2 p라고 부르는 관례를 우리가 받아들였으면 좋았겠다고 생각한다. 이 표현이 전하려는 핵심 성질을 그쪽이 더 잘 담는다고 보기 때문이다. 그 성질은 확률이 반으로 잘릴 때마다 정보량이 1비트씩 늘어난다는 것이다. 예를 들어 확률이 1/2의 k제곱, 곧 (1/2)k인 메시지의 정보량은 정확히 k비트다.
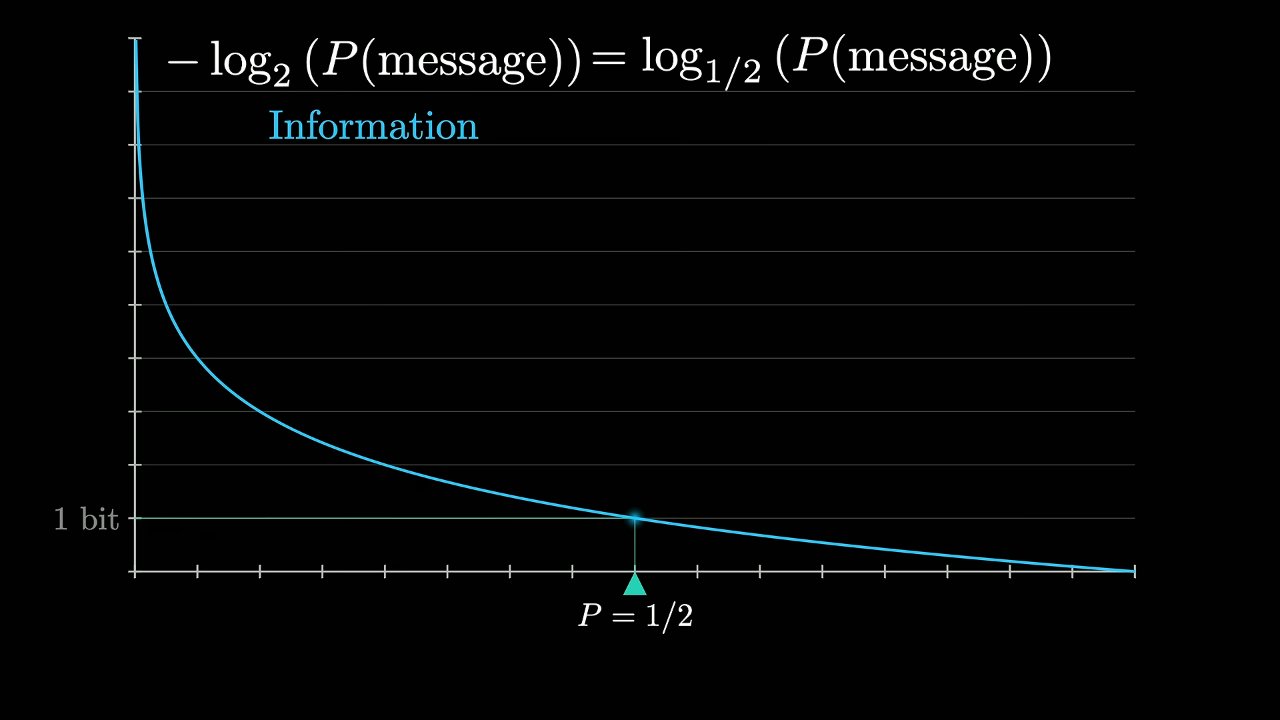
02:28 섀넌의 결과를 보면 한편으로는 아주 직관적이다. 가능성이 높은 메시지일수록 비트가 덜 필요하고, 가능성이 낮은 메시지일수록 비트가 더 필요하다. 더 정확한 진술 자체도 꽤 직관적이다. 비트가 하나 더 필요할 때마다 그 메시지는 가능성이 절반인 메시지에 해당한다. 하지만 다른 한편으로, 이 결과 전체가 무슨 말을 하는지 진지하게 따져 보면 완전히 터무니없어 보인다.
02:53 예측하기 쉬운 글자가 아주 많이 들어 있는 글 한 대목을 잠시 떠올려 보라. 내가 미국 헌법 전문(preamble)의 첫머리를 준다고 하자. 처음 몇 단어만 지나면, 유명한 역사 문서를 잘 아는 지적인 시청자인 여러분은 무엇을 인용하는지 맥락이 분명해지는 거의 그 순간부터 뒤에 무엇이 올지 아주 높은 확신으로 예측할 수 있다. 그 첫 구절 뒤에 오는 이 글자들 전체에 50% 확률을 준다고 하자.
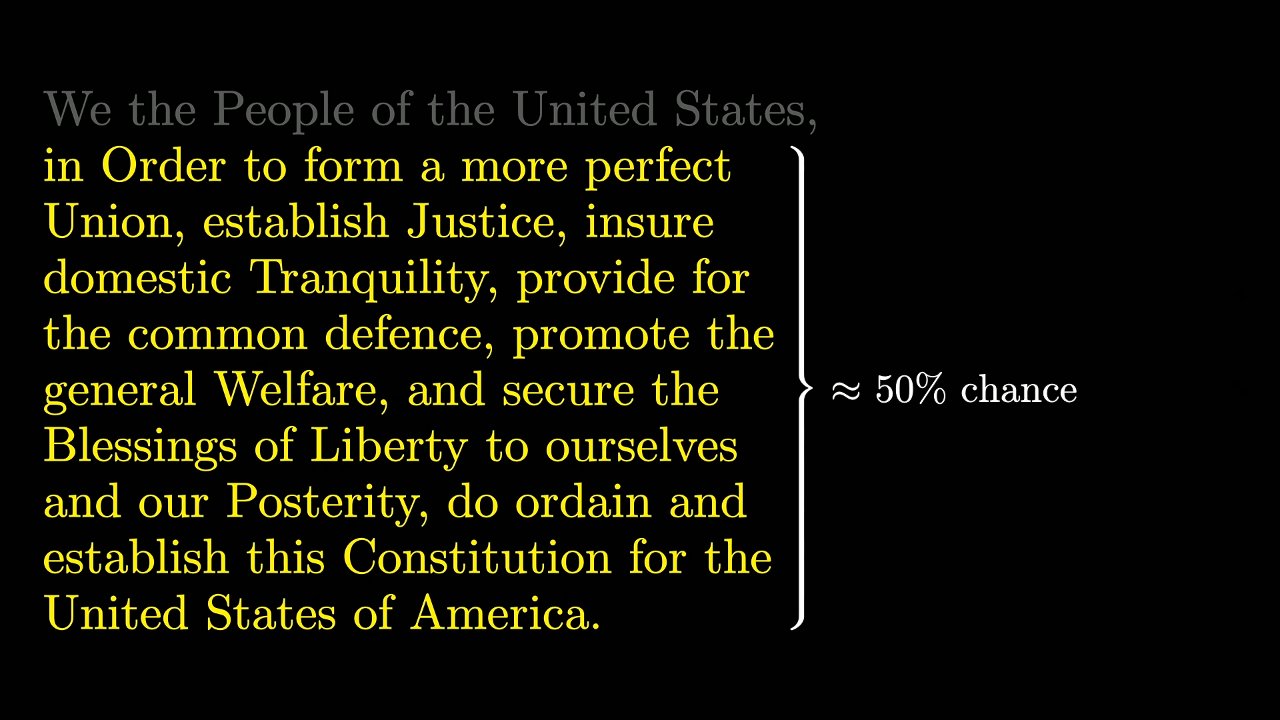
03:21 그러면 나머지 글자들의 섀넌 정보량은 겨우 1비트라는 뜻이 된다. 실제로 나오는 글자가 바로 이 글자들일 확률을 1,000분의 1로 준다 해도 섀넌 정보량은 10비트뿐이다. 그런데 텍스트를 1과 0으로 바꾸는 프로그램을 짠다고 상상해 보라. 한 문단 거의 전부를 어떻게든 1비트에, 아니 10비트에라도 욱여넣는다는 생각은, 글쎄, 말도 안 되게 느껴진다.
03:49 비교하자면 ASCII를 쓰는 기본 부호화는 이 단어들에 2,500비트 넘게 쓴다. 허프먼 부호화를 들어 본 사람도 있을 것이다. 허프먼 부호화는 글자 하나하나를 비트열과 더 효율적으로 짝짓는 방법이고, 더 흔한 글자일수록 더 짧은 비트열을 받는다.
04:06 왼쪽에 그려 둔 이 허프먼 부호화를 쓰면 이 대목은 1,500비트 남짓까지밖에 줄지 않는다. 더 영리하게 굴어서 글자 하나 대신 더 큰 글자 덩어리, 이를테면 현대 언어 모델이 쓰는 토큰 같은 것에 허프먼 부호화를 적용한다 해도, 이런 문단 거의 전부가 아무리 예측하기 쉽더라도 단 1비트에, 아니 몇 안 되는 비트에라도 들어가리라 기대하기는 도무지 가망 없어 보인다. 그런데 이 영상이 끝날 때쯤이면 여러분은 바로 그 일이 일어나는 것을 보게 된다.
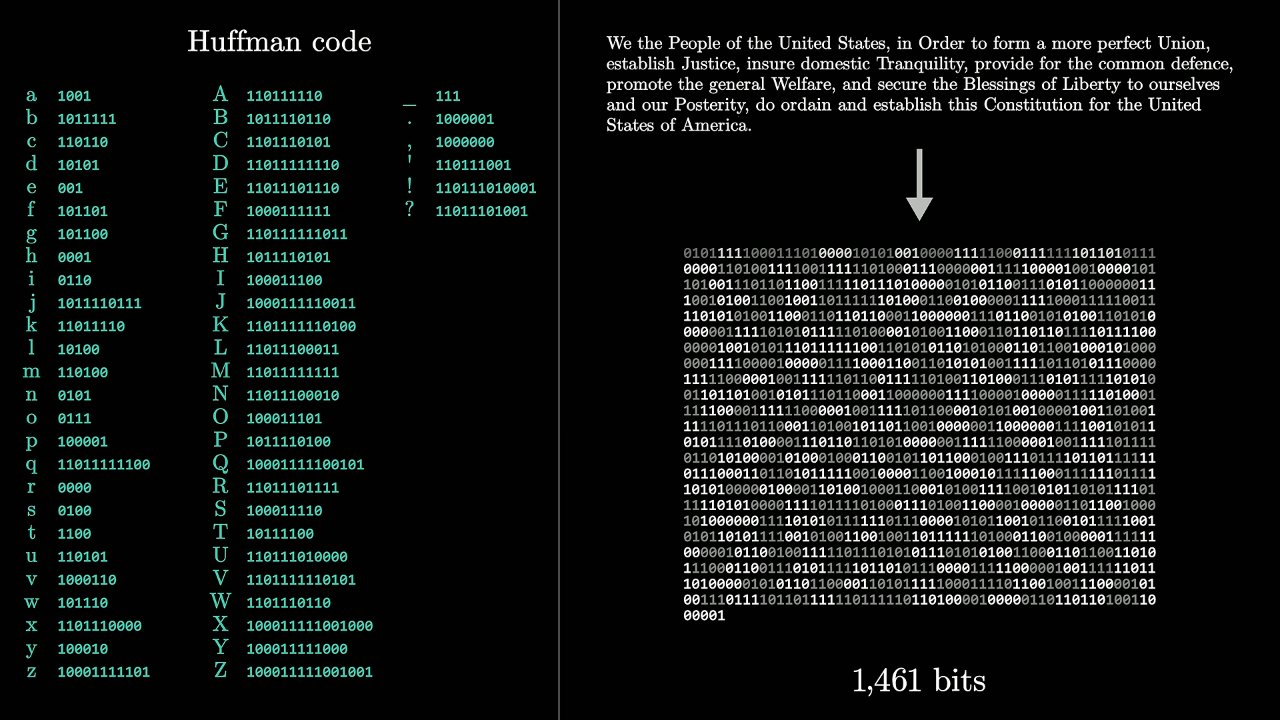
04:38 허프먼 부호화처럼 주어진 글자를 늘 고정된 비트열로 바꾸는 방법의 문제는 맥락을 전혀 반영하지 않는다는 데 있다. 클로드 섀넌의 결과는 압축 가능성이 전적으로 예측 가능성에 묶여 있다고 말한다. 그런데 어떤 단어의 예측 가능성은 그 앞에 무엇이 왔느냐에 따라 크게 달라질 수 있다.
04:58 2020년대를 사는 지금 내가 “이봐, 주변 맥락에 기댄 텍스트의 예측 가능성을 활용해야 해”라고 말한다면, 쓸 수 있는 도구는 아주 뻔하게 하나 있다. 바로 대형 언어 모델이다. 사실 여기서 ‘대형’은 중요하지 않다. 뒤에서 보겠지만 오히려 작은 모델에 실질적인 이점이 있다. 언어 모델은 임의의 텍스트를 받아 다음에 무엇이 올지 예측하도록 특별히 훈련된다. 그 예측은 다음에 올 수 있는 모든 선택지의 집합 위에 놓인 확률분포의 형태를 띤다.
05:32 하지만 내가 블랙박스 예측 기계 하나를 그냥 건네준다 해도, 그것을 압축 알고리즘으로 바꾸는 방법은 전혀 분명하지 않다. 송신자와 수신자가 있는 앞의 설정으로 돌아가 본다. 이 영상 전체에 걸쳐 결정적으로 덧붙일 가정은 둘 다 같은 언어 모델의 사본을 하나씩 갖고 있고, 그 모델을 부호화와 복호화 과정의 일부로 쓸 수 있다는 것이다.
05:53 이 알고리즘은 임의의 언어 모델을 끼워 넣을 수 있는 틀이라고 생각하는 것이 가장 좋다. 그 모델이 내놓는 예측은 부호화와 복호화 과정에서 여러 번 쓰인다. 기본적으로 더 좋은 모델을 쓸수록 최종 압축도 더 좋아진다.
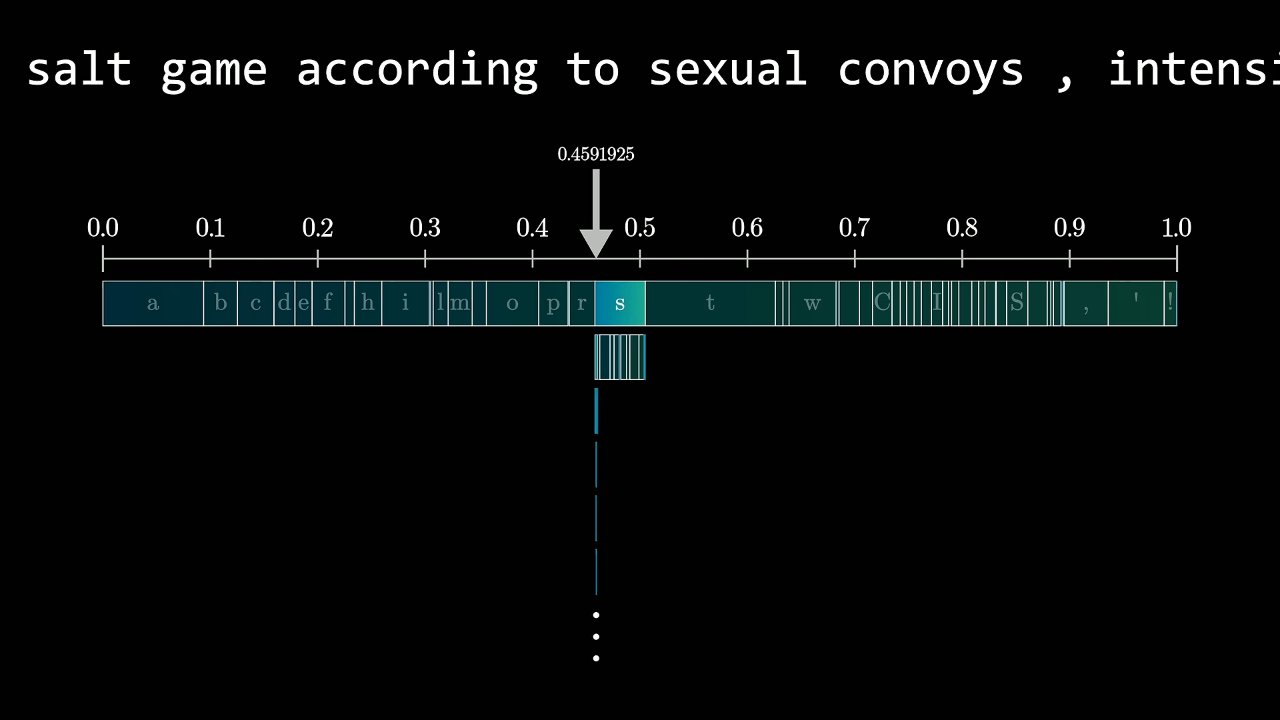
06:10 10,000피트 상공에서 본 큰 그림으로 말하면, 이 알고리즘이 실제로 하는 일은 임의의 텍스트를 0과 1 사이의 아주아주 특정한 실수 하나로 부호화하는 것이다. 처음에는 터무니없게 들릴 수 있다는 것을 안다. 하지만 실은 아주 아름답다. 어떻게 동작하는지 보여 주겠다.
텍스트에서 실수로
06:31 요즘 언어 모델은 대부분 텍스트를 토큰의 연속으로 처리한다. 토큰은 단어처럼 자주 나오는 글자 덩어리다. 그래도 이 알고리즘을 그림으로 보여 주기에는 텍스트를 한 글자씩 처리하는 모델을 쓰는 편이 훨씬 쉽다. 임의의 문자열을 넣으면 모든 글자에 대한 확률분포를 내놓는 모델이다. 사실 최대한 단순하게, 시각적 잡동사니를 줄이려고 출력을 알파벳 26자로 한정하겠다. 대소문자는 무시하고 구두점은 뺀다.
07:01 분명히 해 두면, 앞으로 설명할 실제 알고리즘은 토큰 어휘가 더 큰 모델을 써도 모든 면에서 똑같이 잘 동작한다. 사실 이 방법이 얼마나 효과적인지 보려면 뒤에서 그런 모델로 바꿔야 한다. 지금 이렇게 하는 것은 그림을 훨씬 따라가기 쉽게 하려는 것뿐이다.
07:16 완전히 빈 입력에서 시작한다. 그러면 반대쪽에서 나오는 분포는 임의의 텍스트가 어떤 글자로 시작할지에 대한 모델의 예측이다. 이 영상 내내 확률분포를 이런 막대그래프 대신 막대를 가로로 나란히 이어 붙인 띠로 그리겠다. 막대 하나의 너비가 그 글자가 나올 확률을 나타낸다. 그러면 이 그림의 전체 너비는 1이다. 가능한 모든 결과의 확률을 더하면 1이 되어야 하기 때문이다.
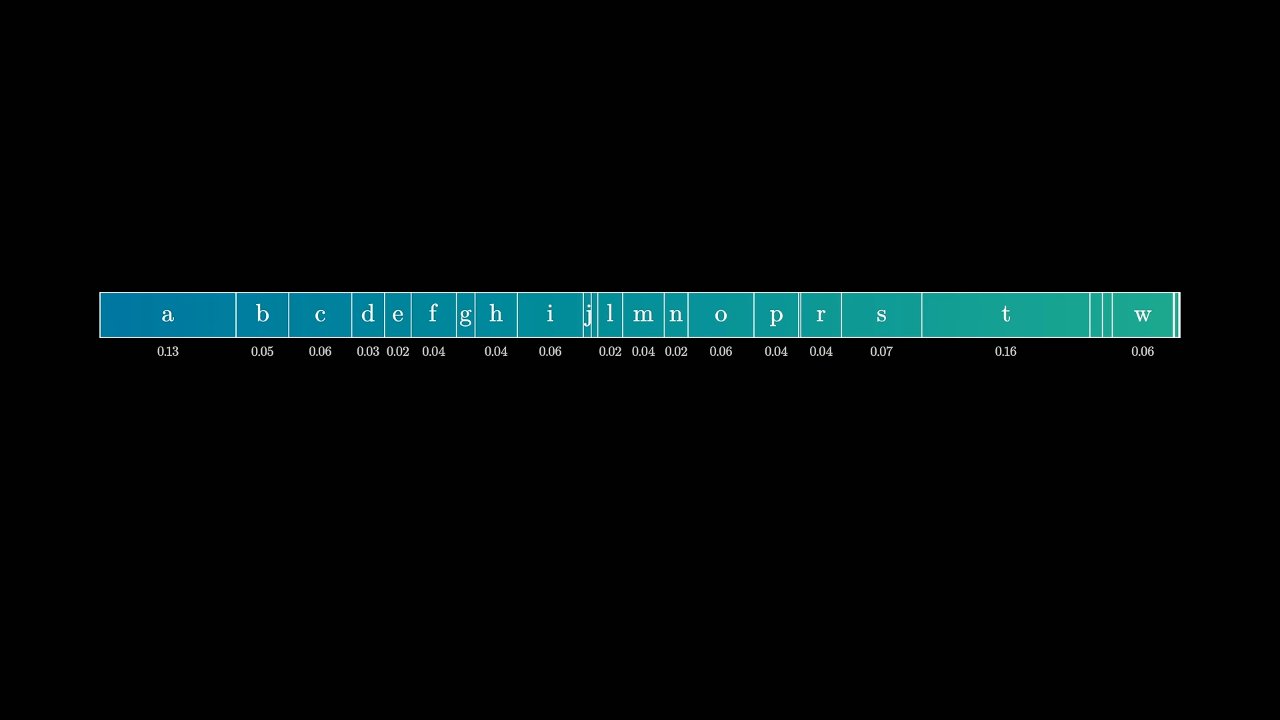
07:44 사실 이 알고리즘 전체의 핵심은 이 띠가 수직선의 0부터 1까지인 단위 구간 위에 놓여 있다고 상상하는 것이다. 그리고 가능한 첫 글자 하나하나가 그 구간에서 값의 범위를 하나씩 차지한다고 생각한다. t처럼 더 흔한 첫 글자는 더 큰 범위의 수를 차지한다는 점을 보라. 반면 p의 막대는 너비가 그 4분의 1쯤이다. 모델이 p를 첫 글자로 볼 가능성을 네 배 낮게 본다는 뜻이다. 그 이웃인 q는 비교도 안 되게 쥐꼬리만 한 구역을 받는다.
08:15 여기서 세우려는 것은 글자 하나만이 아니라 임의로 긴 문자열을 이 구간의 아주 좁은 구역과 짝짓는 방법이다. 그러면 텍스트를 부호화하는 일은 알맞은 작은 구역 안의 아주 특정한 실수 하나를 나타내서 수신자에게 보내는 일이 된다.
08:34 여기서 “math” 같은 짧은 특정 단어를 부호화하는 과정을 단계별로 따라가 본다. 빈 입력 대신 글자 m 하나를 모델에 넣으면 예측 결과는 이렇게 나온다. 모음이 대부분을 차지한다는 것이 눈에 띈다. a가 38%, e가 16%의 확률을 받는 식이다.
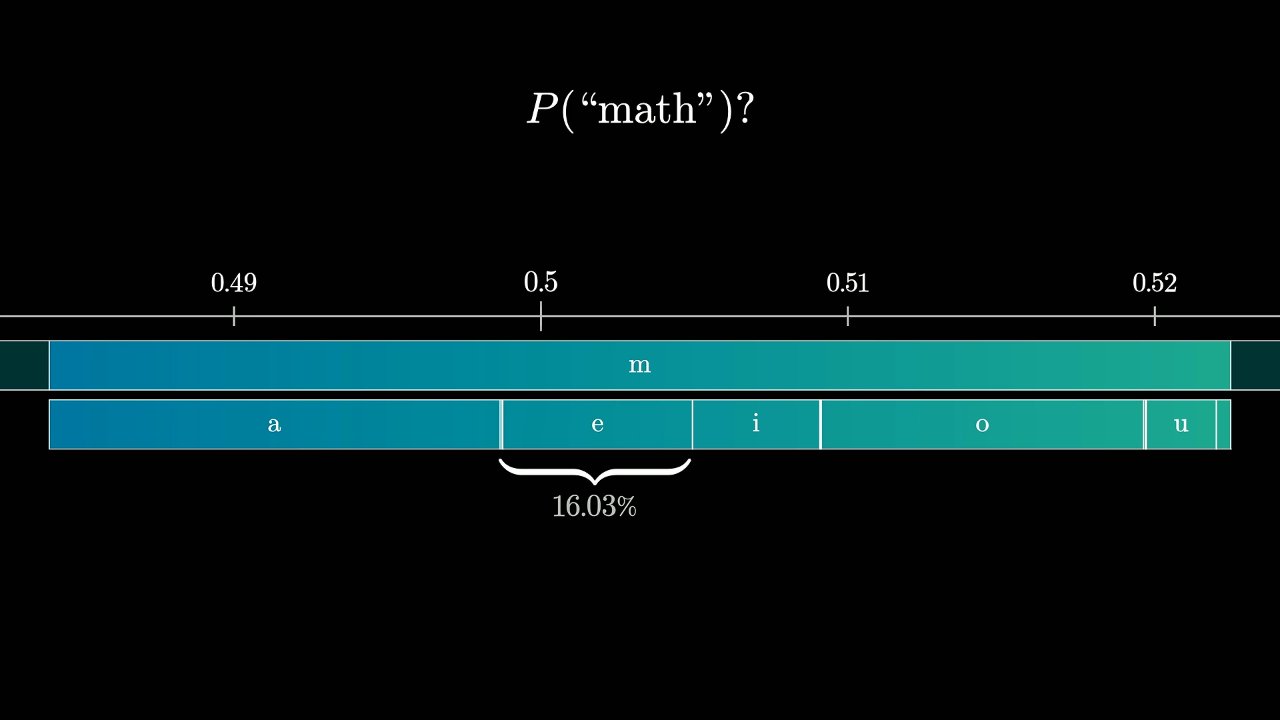
08:54 m 뒤에 자음이 올 가능성은 낮으니 말이 되는 결과다. 둘째 확률 띠를 그 m 바로 아래에 정확히 맞춰 그린 덕분에 둘째 층 각 막대의 너비에는 아주 멋진 해석이 생긴다. 그림 전체 너비에서 이 m의 너비로 내려가려면 m으로 시작할 확률을 곱해 줄여야 한다. 거기서 이 a의 너비로 더 줄이려면 m으로 시작했을 때 a가 나올 확률을 곱해야 한다. 바로 그 곱, P(“m”) · P(“a” | “m”)이 모델이 보는 m, a 두 글자로 시작할 확률이다. 이것이 확률의 연쇄 법칙이다.
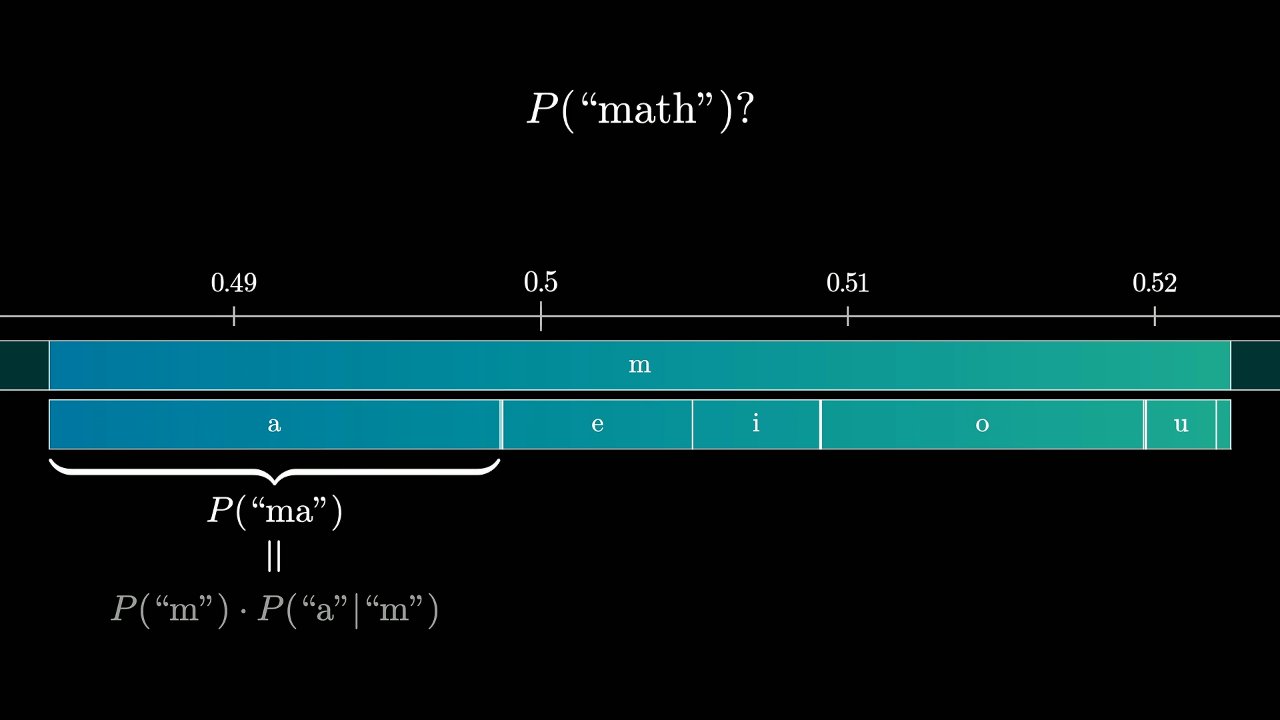
09:32 마찬가지로 다른 작은 너비들은 모델이 me나 mi처럼 나머지 두 글자 조합으로 시작할 확률을 나타낸다. 두 층에서 멈출 이유는 없다. 모델에 맥락 ma를 넣으면 다음에 올 글자에 대한 모델의 분포가 이렇게 나온다. 이번에도 셋째 층의 어느 막대든 그 너비는 모델이 해당 세 글자 열로 시작할 확률을 알려 준다.
09:56 접두사 mat에 같은 아이디어를 한 번 더 적용하면 가능한 모든 넷째 글자에 대한 분포가 나온다. 여기 이 작은 막대의 너비는 모델이 텍스트 전체가 math로 시작할 확률로 주는 값에 해당한다. 구간의 좁은 구역 하나가 주어진 텍스트 하나에 대응한다는 말은 바로 이런 뜻이다. 내가 이 범위 안의 수 하나를, 정말 아무 수나 하나 주고, 네 글자짜리 단어를 부호화하려 한다는 사실도 함께 알려 주면, 여러분은 내가 말하는 단어가 무엇인지 모호함 없이 복원할 수 있다.
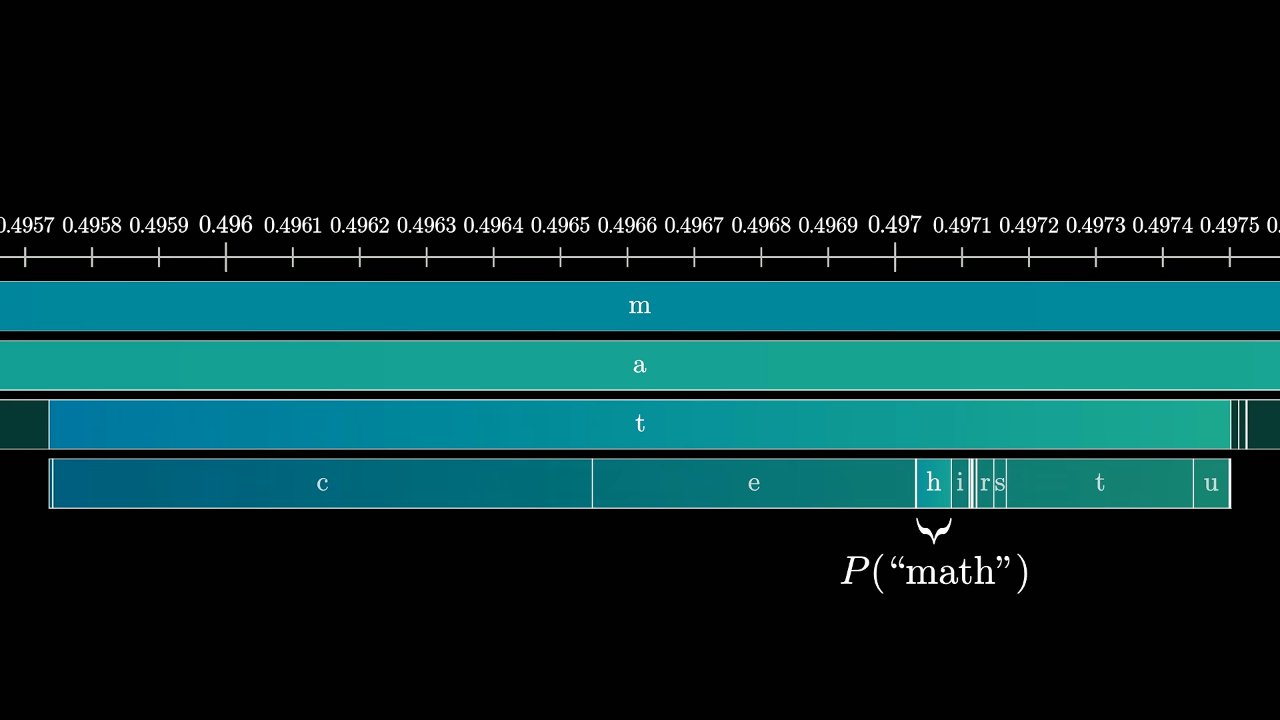
10:27 한 층 축소하면 다른 범위들이 mat로 시작하는 다른 문자열에 대응하는 것이 보인다. 거기서 더 축소하면 ma로 시작하는 문자열들에 대응하는 값의 범위가 보이고, 그 바깥도 마찬가지다. 이만큼 축소하면 확률이 워낙 작아서 두어 층 너머의 작은 범위는 실제로 보기 어렵다. 그래도 단위 구간 전체를 보는 이 높이에서는 가능한 모든 네 글자 문자열을 훑으면 어떤 모습인지 볼 수 있다. 물론 네 층을 보여 주는 것은 전적으로 임의의 선택이다. 원리상 무한히 긴 문자열 하나하나가 0과 1 사이의 고유한 실수 하나에 대응한다.
11:08 다시 송신자와 수신자로 돌아가면, 압축 알고리즘의 아이디어는 이렇다. 송신자인 내가 내 텍스트를 나타내는 실수 하나를 그 텍스트의 글자 수와 함께 묶어서 여러분에게 넘긴다. 그 실수를 2진수로 나타내는 방법과 필요한 정밀도 비트 수를 분석하는 방법은 곧 자세히 들여다본다. 그 전에 수신자인 여러분이 이 수와 공유된 언어 모델로 텍스트를 복호화하는 과정이 정확히 어떤 모습인지 분명히 해 둘 만하다.
11:36 압축 해제 알고리즘도 이 텍스트 예측기를 끼워 넣는 틀로 생각하면 된다. 이때 부호화에 쓴 것과 정확히 같은 텍스트 예측기여야 한다는 점이 결정적으로 중요하다. 첫 단계는 빈 맥락으로 언어 모델을 돌려 첫 글자의 분포를 얻는 것이다. 그 분포에서 여러분은 내가 준 수가 m의 구역 안에 떨어진다는 것을 알아낼 수 있다.
11:57 이제 여러분은 m을 맥락으로 모델을 한 번 더 돌려야 한다는 것을 안다. 그러면 새 분포가 나오고, 내 특별한 수가 둘째 층의 어디에 떨어지는지 보면 내 메시지의 둘째 글자가 a라는 것을 알아낼 수 있다. 그것이 다시 모델에 다음으로 무엇을 넣을지 알려 준다. 이 과정을 내가 알려 준 단어의 글자 수만큼 되풀이하면 된다.
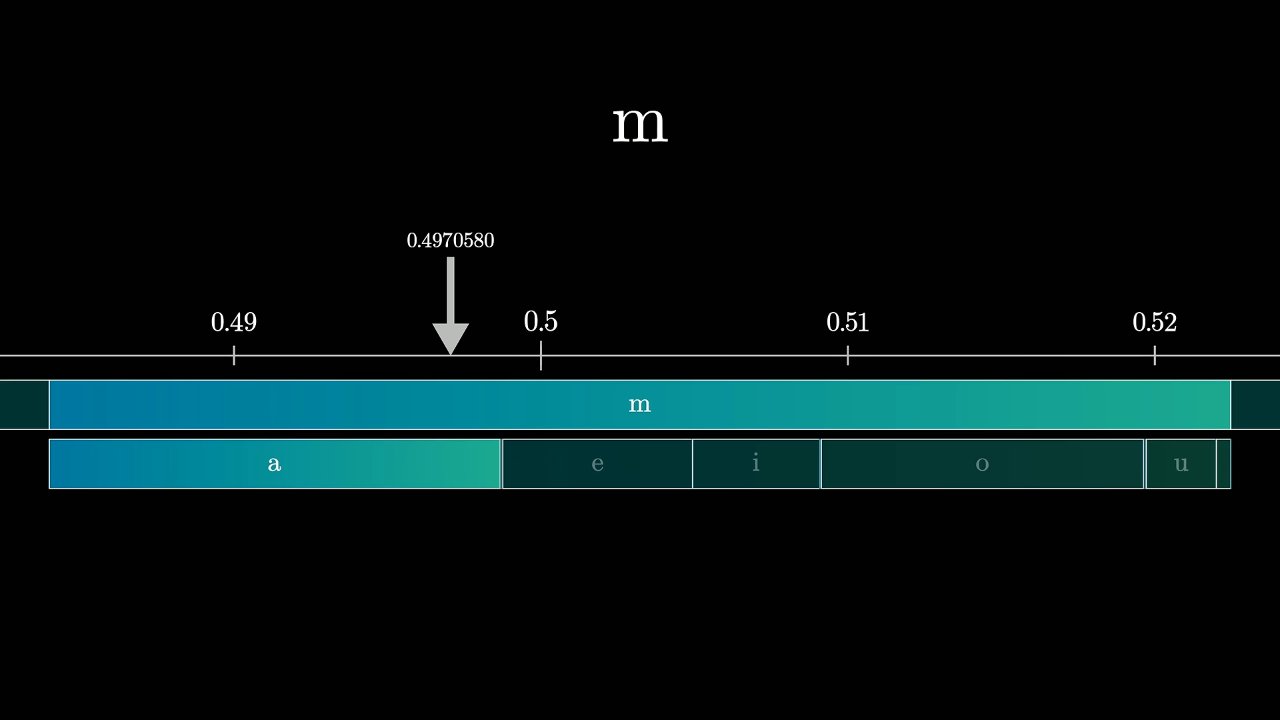
12:19 원한다면 메시지 끝을 나타내는 특별한 기호, 곧 메시지 끝 기호를 어휘에 넣어서 메시지 길이를 따로 보내지 않아도 된다. 그 경우 복호화 절차는 그 기호에 닿을 때까지 확대해 들어가는 모습이 된다. 이것은 설계상의 선택이고, 여러 면에서 그쪽이 더 우아하다. 하지만 여기서는 메시지 길이를 따로 떼어 보내겠다. 주된 이유는 입문용 예시가 순수한 텍스트만 다룰 때 더 깔끔해지기 때문이다.
12:44 섀넌이 최적 압축을 설명할 때 핵심 아이디어 하나는 완벽하게 압축된 메시지가 무작위 잡음과 구별할 수 없어 보여야 한다는 것이었다. 지금 쌓아 올리는 알고리즘이 이 성질에 어떻게 들어맞는지는 0과 1 사이의 실수를 균등하게 무작위로 골라 보면 감이 온다. 그러면 그 수들에 대응하는 문자열이 아무렇게나 생기지 않았다는 것이 눈에 띈다. 이 그림에는 가능한 모든 문자열이 들어 있는데도, 우리가 떨어지는 문자열은 거의 다 그럴듯해 보인다. 실제 영어 텍스트의 한 토막처럼 보인다.
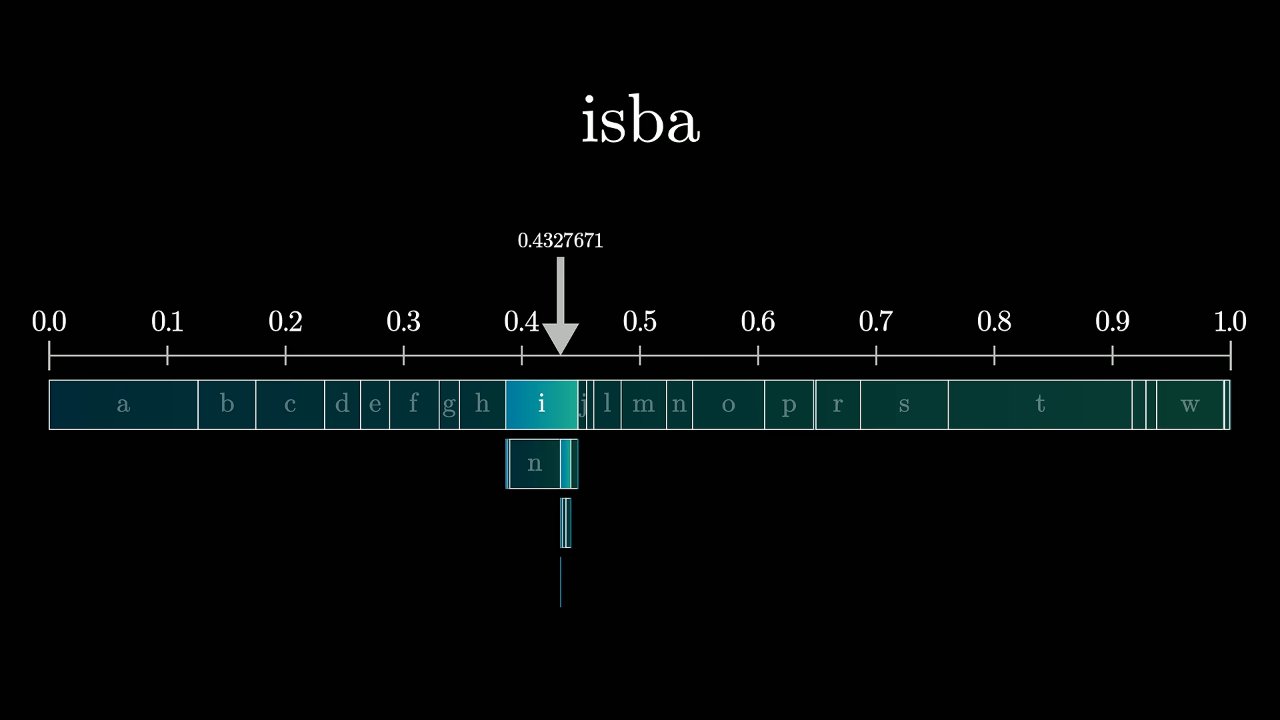
13:15 그 이유는 이 그림의 막대 너비를, 모델이 보기에 가능성이 높은 문자열일수록 수직선에서 더 큰 몫을 차지하도록 정했기 때문이다. 그래서 아무 지점이나 무작위로 고르면 그럴듯한 문자열에 떨어질 가능성이 아주 크다. 사실 이것은 언어 모델이 텍스트를 만들어 내는 방식을 시각화하는 한 방법일 뿐이다.
13:35 지금까지는 이 실수들을 10진 소수로 적었다. 하지만 이것을 실제 부호화로 보려면 2진수, 곧 1과 0으로 나타내야 한다. 텍스트 길이에 따라서는 1과 0이 아주 많이 필요할 수도 있다. 여기서 말하는 2진수가 무슨 뜻인지 분명히 해 둔다. 보통 쓰는 10진법에서 소수점 뒤 첫 자리가 구간의 몇 번째 10분의 1에 있는지 알려 주듯이, 2진 표현에서 소수점 뒤 첫 비트는 왼쪽 절반에 있는지 오른쪽 절반에 있는지 알려 준다.
14:04 그다음 비트는 그 부분의 왼쪽 절반인지 오른쪽 절반인지 알려 주고, 셋째 비트는 구간의 특정한 8분의 1 하나로 범위를 좁힌다. 그런 식으로 계속된다. 새 비트가 하나 붙을 때마다 가능성의 공간이 반으로 잘린다. 그래서 여기 강조된 부분은 이 비트들로 시작해서 지정할 수 있는 실수의 범위다. 다른 말로 하면 이 비트열 뒤에 이어질 수 있는 모든 경우다.
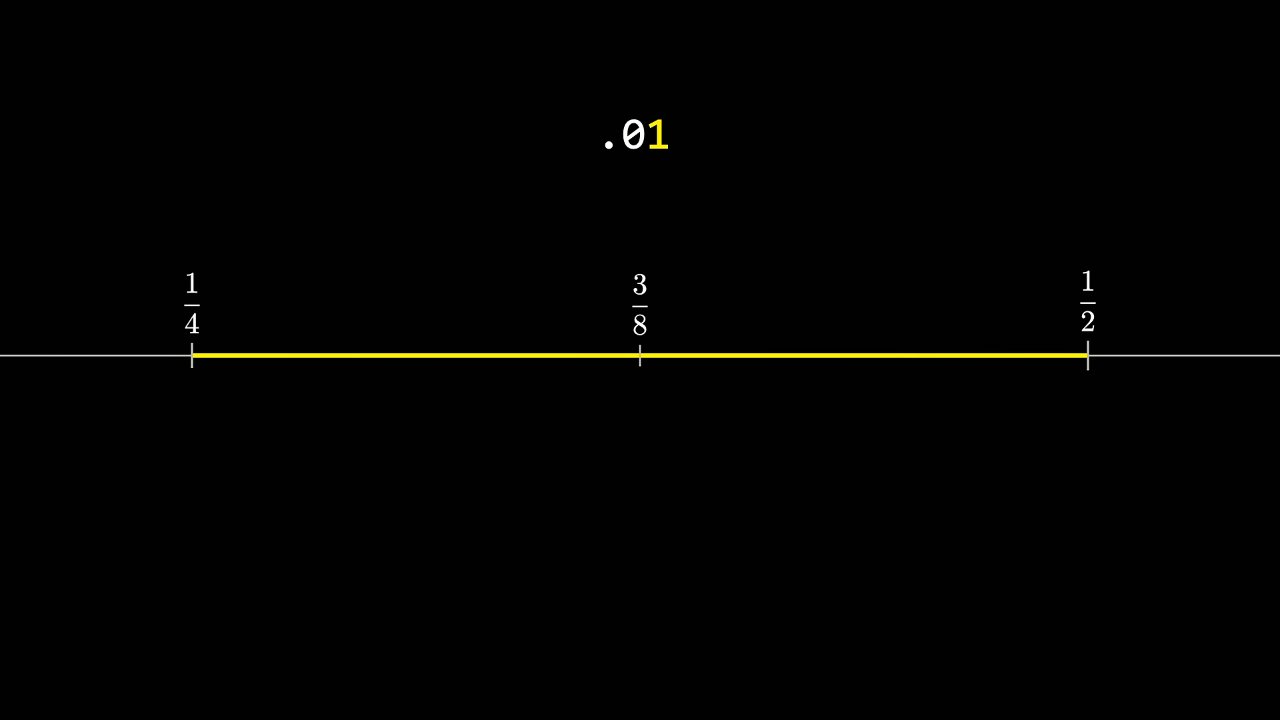
14:28 비트를 그만 붙이기로 하고 유한한 표현으로 멈출 때마다, 얻는 수는 이 강조된 구역의 왼쪽 끝점에 놓인 수다. 이제 아까 본 텍스트 조각들을 이 그림 아래로 다시 가져오면, 내가 여기 적어 둔 2진수는 문자열 MATH의 좁은 구역 안에 놓인 수다. 이 수는 정밀도 비트를 모두 10개 쓴다.
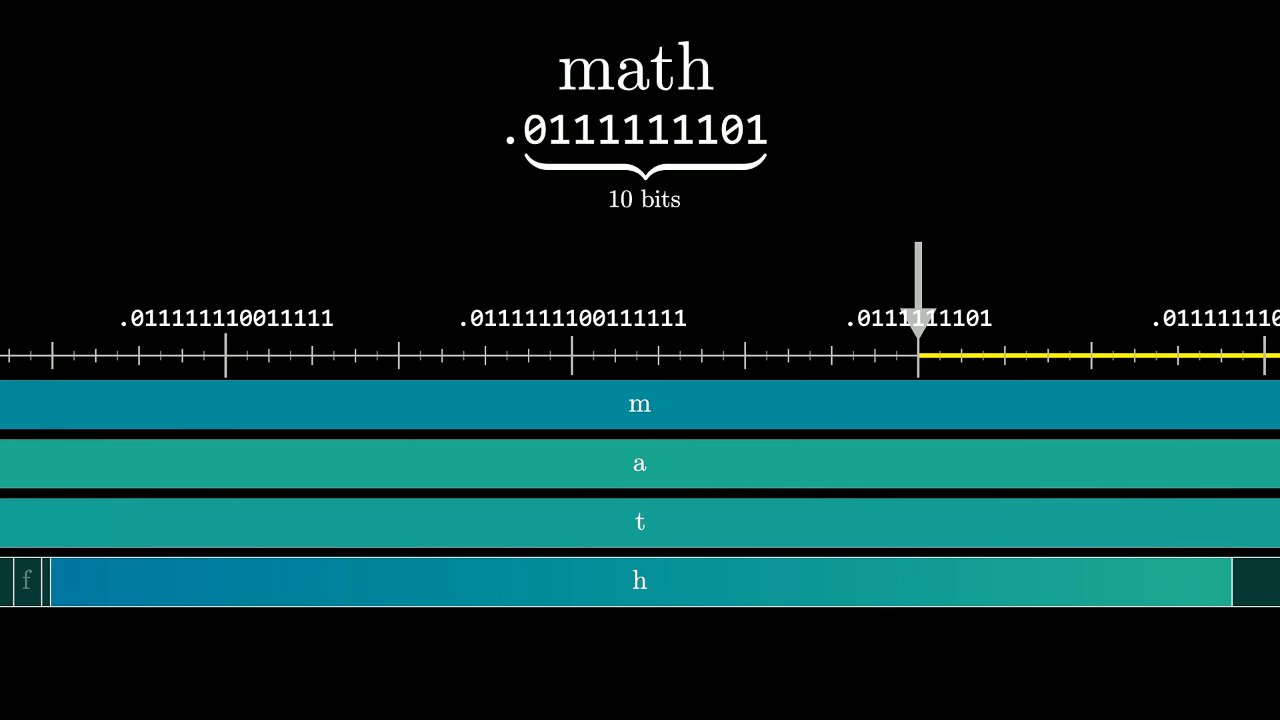
14:53 축소해 보면 이 단어를 부호화하기에 9비트로는 모자랐다는 것을 실제로 볼 수 있다. 왼쪽에서 가장 가까운 9비트 수는 여기, 목표 구역에서 한참 벗어난 곳에 있다. 그다음 9비트 수는 너무 멀리 넘어간다. 열 번째 비트를 하나 더 넣으면 강조된 구역이 충분히 좁아져서 이 두 수의 딱 가운데로 들어가 목표 범위에 떨어질 수 있다. 사실 이 관점에서 그 목표 구역의 크기를 10비트 수들 사이의 간격과 견주어 보면, 이번에 10비트만 쓸 수 있었던 것은 운이 좋았던 것처럼 느껴진다.
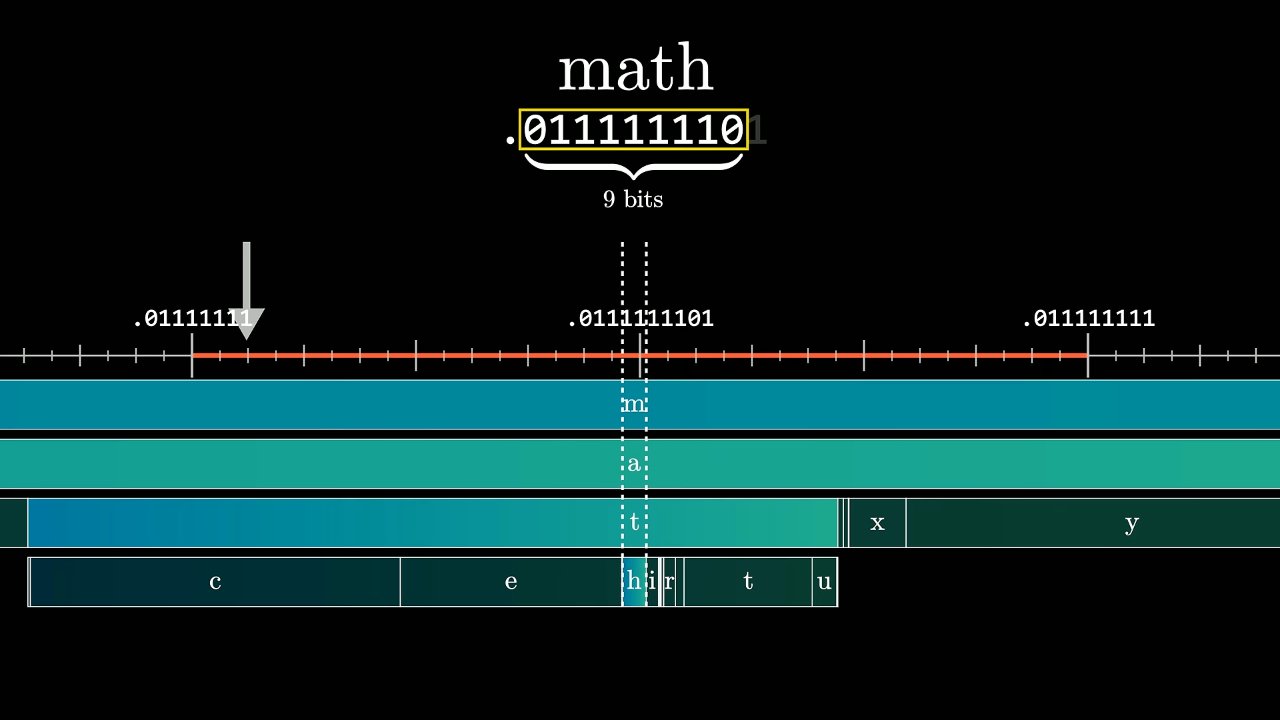
15:25 네 글자 단어에 10비트면 글자당 평균 2.5비트로, 나쁘지 않은 수치다. 하지만 진짜 이점은 이 방법을 점점 더 긴 텍스트에 적용할 때 드러난다. 이 과정이 단어 mathematics 전체에 걸쳐 펼쳐지는 모습을 보여 주겠다. 모델이 새로 보는 글자 e, m, a가 하나같이 예측하기 아주 쉽다는 것이 눈에 띈다. 그래서 목표 구역의 크기가 거의 줄지 않는다. 마지막 s에 이르러서야 실제로 무언가를 결정했다는 느낌이 든다.
15:55 사실 math를 나타낼 때 쓴 바로 그 10비트짜리 비트열이 mathematics의 구역 안에도 여전히 떨어진다. 그러면 글자당 비트 수가 0.91로 내려간다. 실은 이것은 조금 부정직한 말이다. 실수뿐 아니라 메시지 길이도 보내야 하기 때문이다. 어쨌든 math를 보내는지 mathematics를 보내는지 가르는 것이 바로 그 길이다. 그래도 이쯤이면 제법 괜찮은 압축처럼 보이기 시작한다.
16:19 나는 이 예시를 보고 정말 놀랐다. mathematics로는 좋은 결과가 나오리라는 것을 알고 있었다. 하지만 10비트만 쓴 것이 math에서 조금 운이 좋았다면, 더 긴 단어 mathematics에서는 엄청나게 운이 좋은 것이다. 이 단어의 작은 구역은 너비가 2−18인데, 수직선에서 10비트 이하로 나타낼 수 있는 점들은 2−10 간격으로 떨어져 있다. 요컨대 지금 보는 것은 이 단어가 원래 18비트의 정보량을 요구해야 했는데도 운 좋게 10비트로 나타낼 수 있었다는 사실이다.
16:49 사실 일반적으로 주어진 구역 안의 한 점을 나타내는 데 비트가 몇 개 필요해야 하는지 잠시 생각해 볼 만하다.
이것이 섀넌의 한계인가
17:01 눈금을 보면, 2비트 이하로 표현할 수 있는 값의 눈금은 모두 4분의 1 간격으로 떨어져 있고, 3비트 이하로 표현할 수 있는 값의 눈금은 8분의 1 간격으로 떨어져 있다. 일반적으로 k비트 이하로 표현할 수 있는 수는 모두 정확히 2−k 간격으로 떨어져 있다. 그러니 크기가 p인 목표 구역이 있는데 운에 기대고 싶지 않다고 하자. 이 구역이 어디에 놓이든 k비트(이하)로 표현할 수 있는 수로 목표 구역 안에 반드시 들어갈 수 있다는 보장을 원한다면, 2−k가 p보다 작다는 것을 확실히 해야 한다.
17:38 식을 조금 정리하면, 이는 −k가 log2 p 이하라는 말과 같다. 이는 다시 k가 −log2 p 이상이라는 말과 같다. 다시 말해 텍스트의 확률이 p일 때 그 확률의 밑이 2인 로그에 음수를 붙여 올림하면, 텍스트를 반드시 그 비트 수로 나타낼 수 있다. 운이 좋으면 더 적은 비트로도 된다.
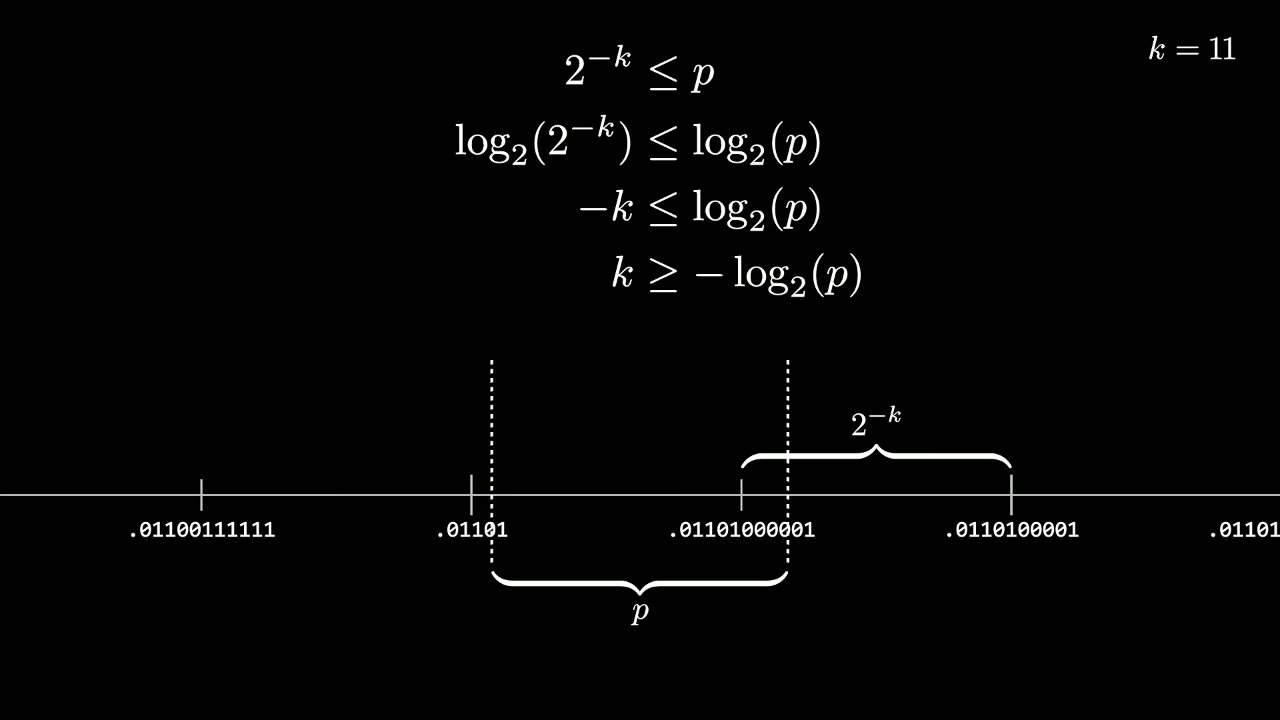
18:02 이 식은 아주 낯익게 느껴질 것이다. 주어진 메시지의 정보량에 대한 섀넌의 정의와 똑같아 보인다. 사실 이 모든 것의 아름다움이 바로 여기에 있다. 섀넌은 어떤 압축 알고리즘도 평균적으로 이보다 적은 비트로 텍스트를 부호화할 수 없는 이유를 원리적으로 증명했고, 원리적으로는 이 한계에 얼마든지 가까이 다가갈 수 있어야 하는 이유까지 보였다. 그런데 지금 보고 있는 방법은 적어도 언뜻 보기에는 섀넌의 꿈을 실현하는 것처럼 느껴진다. 압축한 메시지의 크기가 반올림 오차를 빼면 사실상 정보량과 같은, 구체적이고 구현할 수 있는 방법이기 때문이다.
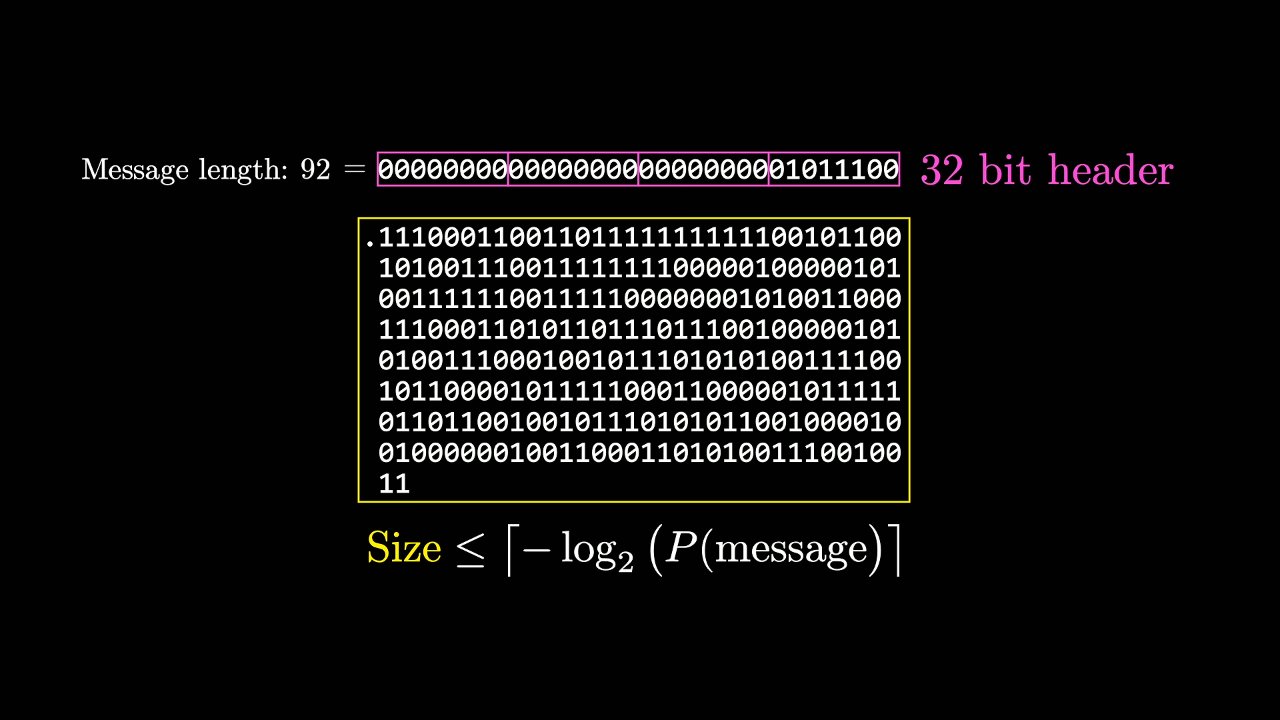
18:37 더 정확히 말하면, 이것은 부호화한 실수만 설명한다. 메시지 길이도 함께 보내야 한다는 점을 기억해야 한다. 하지만 그 메시지 길이는 상대적으로 아주 작다. 예를 들어 길이를 나타내는 데 32비트 고정 헤더를 할당하면, 최대 40억 자 길이의 메시지까지 안전하게 부호화할 수 있다. 그래서 규모가 커지면 부호화 크기의 사실상 전부가 그 실수의 정밀도 비트에 묶인다. 그리고 그 비트 수는 섀넌 한계에 바짝 붙는다.
19:06 사실 섀넌의 한계보다 조금 더 잘하는 것처럼 보이는 경우도 이미 보았다. 앞의 ‘mathematics’ 예는 정보량이 18비트였지만, 우연히 10비트 값과 겹쳤다. 훨씬 더 극단적인 경우로, 문자 A로만 이루어진 메시지는 그림의 맨 왼쪽 점에 대응한다. 우리 방식에서 그 점은 사실 빈 비트열이 나타내는 값이다. 그러니 이 극단적인 예에서는 실제 내용 전부가 순전히 메시지 길이에만 담긴다.
19:34 이런 예가 섀넌의 정리를 어기지 않는 이유는 그의 정리가 전적으로 평균에 관한 것이기 때문이다. 이 정리는 평균적으로 이 −log p 식보다 잘할 수 없다고 말한다. 이렇게 운이 좋은 경우는 모두, 더 흔하게는 정수가 아닌 정보량을 더 큰 정수로 올림해야 한다는 사실로 상쇄된다.
19:53 하지만 이 부호화 크기가 실제로는 섀넌의 한계에 이르지 못하는, 훨씬 더 근본적인 이유가 있다. 우리가 적은 이 양 −log p는 사실 메시지의 섀넌 정보량이 아니다. 이 값 p는 모델이 매긴 텍스트의 확률이지, 그 텍스트를 볼 진짜 확률이 아니기 때문이다. 진짜 확률이란 이를테면 전형적인 송신자가 보낼 법한 텍스트를 표본으로 뽑았을 때의 확률이다. 이런 의미에서 최종 압축률은 거의 전적으로 끼워 넣은 언어 모델의 품질, 그리고 그 예측이 언어의 실제 통계에 얼마나 가까운지에 달려 있다.
사전학습을 다시 보기
20:26 지금이 한 걸음 물러나 생각해 보기 좋은 때다. 이 알고리즘 전체를 배우면 얻는 이점 하나는, 언어 모델이 애초에 어떻게 학습되는지를 보는 흥미로운 관점을 준다는 것이다.
20:38 우리가 얻은 핵심 결론을 보자. 압축 크기는 모델이 주어진 텍스트에 매기는 확률의 음의 로그처럼 보인다. 그 확률은 곱으로 펼칠 수 있다. 모델이 잇달아 내놓는 예측 하나하나의 개별 확률을 모두 곱한 것이다. 이렇게 로그 안에 곱이 보이면 언제나 합으로 쪼개는 것이 좋다. 여기서는 그 개별 예측 하나하나의 확률에 음의 로그를 취해 모두 더한 합이 된다.
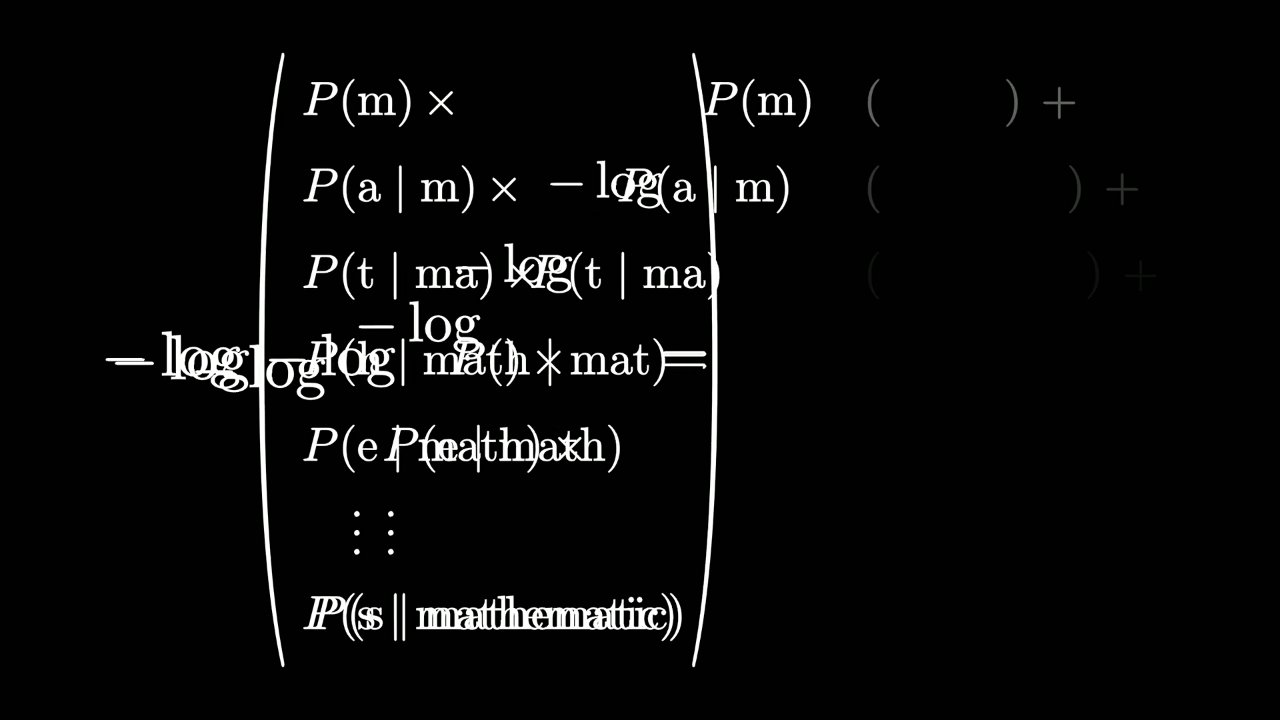
21:05 이제 이 항 하나하나를 모델의 예측 하나에 딸린 비용 같은 것으로 생각할 수 있다. 모델이 실제 다음 문자에 낮은 확률을 주면 비용이 아주 크다. 반대로 실제 다음 문자에 높은 확률을 주면 비용이 작아져 0에 가까워진다.
21:22 많은 시청자에게 아주 익숙하게 들릴 것이다. 지난 장에서 모델이 바로 이 값을, 정확히는 사전학습 과정에서 보는 모든 토큰에 대한 이 값의 평균을 최소화하도록 최적화된다는 이야기를 내내 했기 때문이다. 사실 언어에서 뽑은 모든 토큰에 대한 이 값의 평균에는 특별한 이름까지 있다. 교차 엔트로피다. 더 구체적으로는, 실제 분포에 대해 잰 모델의 언어 분포의 교차 엔트로피다.
21:50 내가 말하고 싶은 요점은 사전학습을 생각하는 방식이 두 가지라는 것이다. 흔한 설명은 목표가 다음 토큰 예측기를 만드는 것이고, 이 교차 엔트로피는 손실 함수 역할을 한다고 말한다. 교차 엔트로피는 그 목표를 최소화할 수 있는 수치 점수로 바꾸는 방법이다. 하지만 오늘 이야기하는 이 알고리즘의 렌즈로 보면, 수학적으로는 같지만 내가 보기에 심리적으로는 다른 설명이 가능하다. 목표가 예측 그 자체가 아니라 가능한 한 최고의 텍스트 압축기를 만드는 것이라고 보는 설명이다.
22:18 첫 번째 설명에서 교차 엔트로피를 쓰는 것은 처음에는 설계상의 선택처럼 느껴진다. 손실 함수를 뭔가 하나 골라야 하고, 교차 엔트로피는 많은 선택지 가운데 하나라는 식이다. 하지만 두 번째 설명에서는 무엇을 최소화해야 하는지가 훨씬 분명하다. 학습 예제 하나하나를 압축한 결과의 비트 수다. 그게 전부다. 다른 사람은 어떨지 모르겠지만, 나는 이쪽이 사전학습 동안 실제로 무슨 일이 일어나는지 생각하기에 훨씬 좋은 방식이라고 느꼈다.
산술 부호화의 실제 동작
22:41 이것이 압축 알고리즘 이야기에서 뜻하는 바는, 이 알고리즘이 거기에 끼워 넣는 예측 모델만큼만 좋다는 것이다. 그리고 여기서 실제로 재미있는 것을 해 볼 수 있다. 같은 예문을 두 가지로 부호화한 결과를 보여 주겠다. 예문은 “The concept of proof and its associated mathematical rigor began in ancient Greek mathematics, exemplified in Euclid's Elements”(증명이라는 개념과 그에 따르는 수학적 엄밀성은 고대 그리스 수학에서 시작되었고, 유클리드의 『원론』이 그 본보기다)이다. 첫 번째 부호화는 NanoGPT로 했다. 이 영상 내내 설명용으로 써 온, 매개변수 370만 개짜리 작은 장난감 모델이다.
23:10 모두 254비트를 쓰고, 평균하면 문자당 약 2비트다. 클로드 섀넌이 가능하다고 추정한 값의 두 배다. 여기서 특히 마지막 두 단어를 눈여겨보라. 문제는, 수학과 그 역사를 좀 아는 사람에게는 그 마지막 두 단어가 아주 예측하기 쉽다는 것이다.
23:29 이번에는 대조적으로, 매개변수가 5억 개인 오픈소스 모델 Qwen으로 부호화한 결과다. 마지막 두 단어가 이제 5비트밖에 들지 않고, 전체 평균은 문자당 1비트도 안 된다는 점을 보라.
23:44 더 극단적인 예로, 미국 헌법 전문을 다시 가져와 보겠다. 첫 구절 자체는 약 35비트를 쓴다. 그 뒤에 오는 것은 모두 너무 예측하기 쉬워서 거의 아무것도 보태지 않는다. 다 합쳐 10비트뿐이다. 영상 맨 처음에 보여 준 허프먼 부호화와 비교하면 크기 차수(order of magnitude)로 두 단계 개선이다.
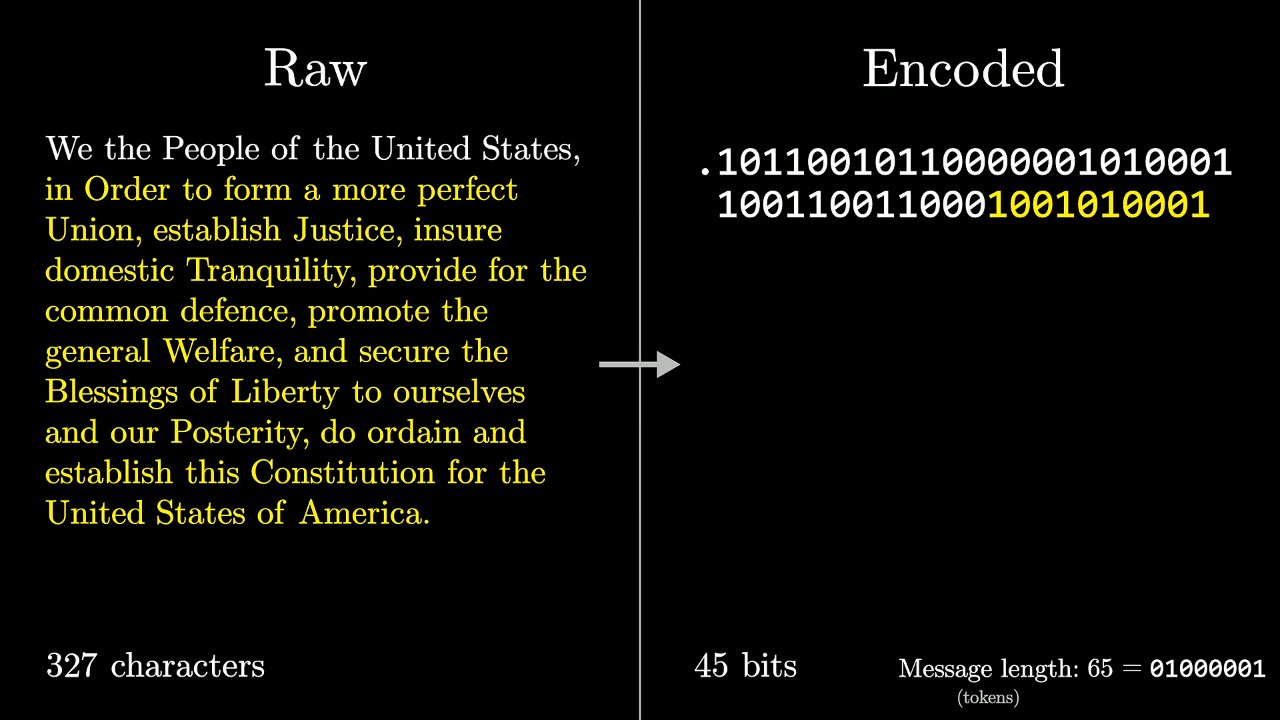
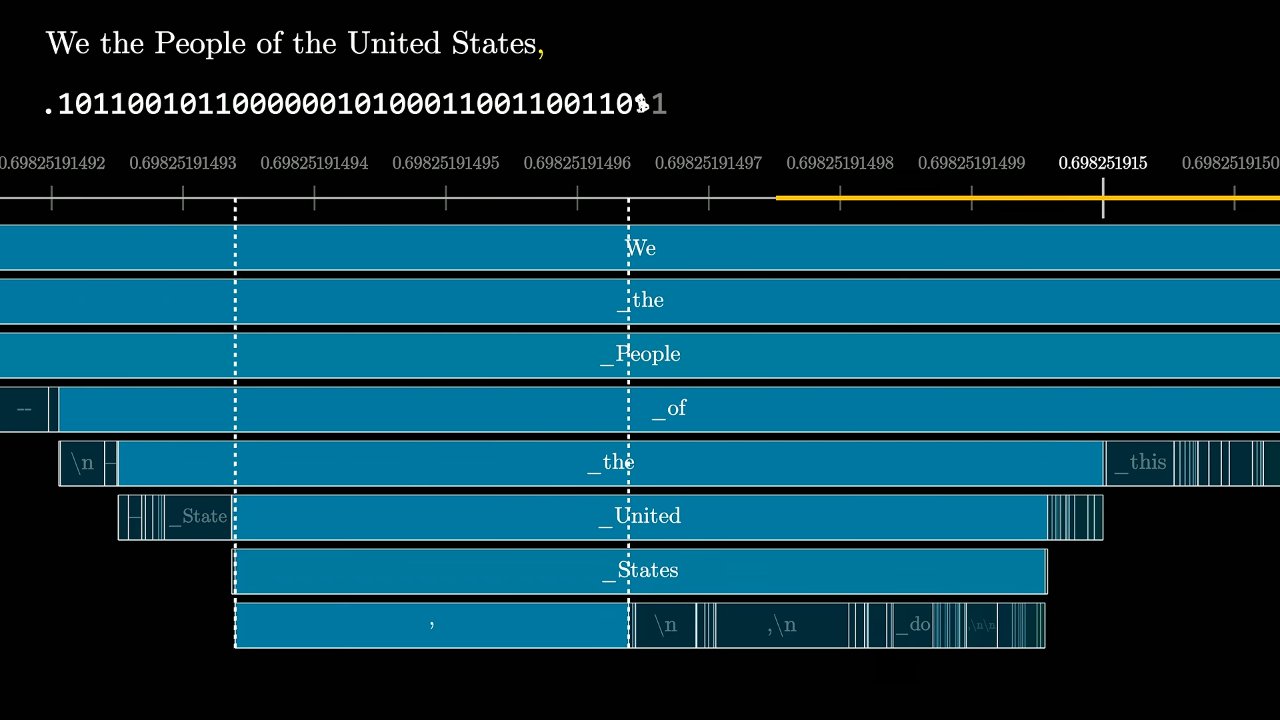
24:07 이 예는 우리 그림 속에서 보면 특히 재미있다. Qwen은 문자 대신 토큰을 처리한다. 그래서 확률분포마다 선택지가 훨씬, 훨씬 많다. 첫 토큰 ‘we’로 좁혀 들어가는 데 약 11비트가 드는 듯하고, 마찬가지로 둘째 토큰 ‘the’에 이르는 데 다시 십여 비트가 든다. ‘People’은 조금 더 예측하기 쉽고, ‘of the United States’를 채워 가는 동안 확대가 조금 더 이어진다. 하지만 그 첫 구절이 지나면, 새 토큰 하나하나가 확률 공간의 거의 전부를 차지한다는 점을 보라. 그래서 우리 위치를 부호화하는 실제 실수를 갱신해야 하는 일은 아주 드물다.
24:45 자세히 보면 결정 대부분은 대소문자와 철자 선택으로 귀결되는 것 같다. 예를 들어 defense를 S 대신 C로 써서 defence로 하는 선택에 두어 비트가 든다. 하지만 큰 그림에서 보면, 높은 예측 가능성이 정말로 높은 압축 가능성으로 바뀌었다.
25:02 “잠깐만요.” 몇몇 사람이 이렇게 말하는 소리가 들린다. “수억 개 가중치 어딘가에 그 구절을 사실상 외워 둔 거대한 모델을 불러다 쓰는 것뿐이라면, 이 구절을 이만큼 압축했다고 알고리즘을 칭찬하는 건 좀 부당하지 않나요?” 맞다, 전적으로 그렇다. 사실 그 생각을 잠시 간직해 두라. 곧 다시 다루겠다.
25:21 두 번째로, 일부 시청자의 머릿속을 맴돌고 있을 법한 실용적인 걱정이 있다. 이 과정을 정말 계속 이어 가며 확대를 거듭하면, 실수를 아주 정밀하게 표현해야 하는 순간 금세 문제가 된다. 부호화하는 실수 하나뿐 아니라, 잇따르는 확률분포 각각의 경계를 정하는 다른 모든 값도 그만큼 정밀해야 한다. 실제로 이 그림들이 보여 주는 것을 순진하게 문자 그대로 받아들이면 아직 실용적인 알고리즘이 아니다.
25:51 지금까지 보여 준 형태의 아이디어는 적어도 1960년 피터 일라이어스(Peter Elias)의 미발표 연구까지 거슬러 올라간다. 하지만 실용화된 것은 1976년이다. 그해 요르마 리사넨(Jorma Rissanen)과 리처드 파스코(Richard Pasco)가 각자 독립적으로 쓸 만한 버전을 개발했다. 수치 정밀도가 끝없이 늘어나야 하는 문제를 피하는 버전이고, 이것이 오늘날 산술 부호화라고 부르는 것이다.
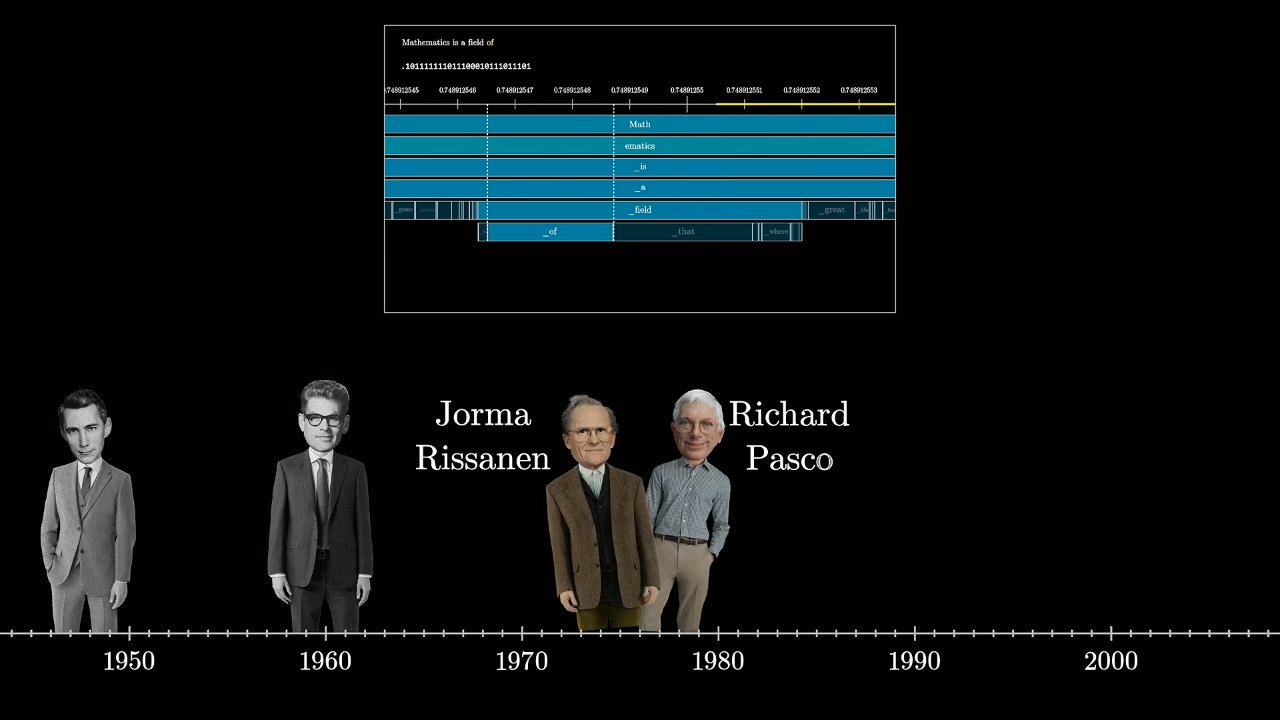
26:12 핵심 아이디어는 매 단계에서 보고 있는 구간을 재정규화해 길이가 언제나 1이 되게 하는 것이다. 영상 내내 구간이 늘 화면 폭을 채우도록 애니메이션을 만든 방식과 거의 같다. 구현 세부가 궁금한 사람을 위해 설명란에 링크를 남겨 두겠다. 결론은 산술 부호가 예측기를 압축기로 바꾸는 거의 완벽한 방법을 준다는 것이다. 앞에서 언급한 허터 상(Hutter Prize) 수상작은 모두 이 구조를 쓰고, 개선은 대체로 점점 더 나은 예측기를 끼워 넣는 데서 나왔다.
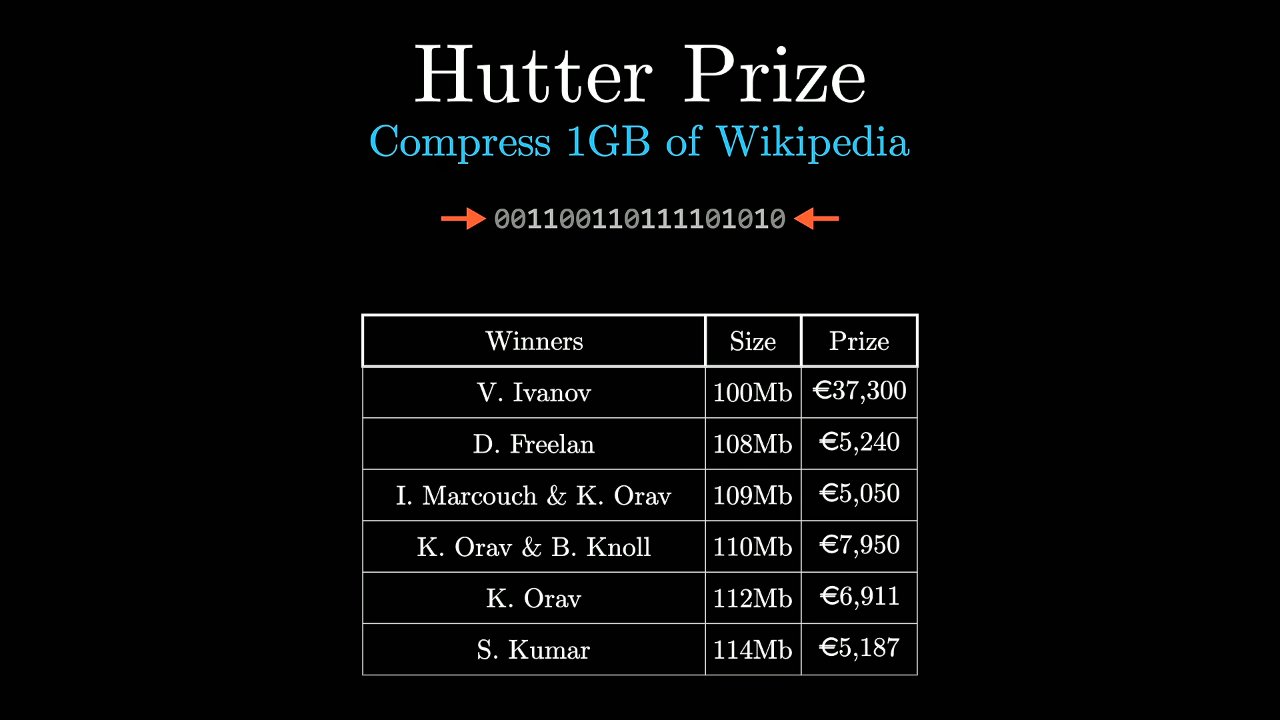
26:42 이처럼 예측기를 압축기로 바꾸는, 완전히 다른 접근법도 하나 있다는 것을 언급하지 않으면 소홀한 일이다. 2013년 야레크 두다(Jarek Duda)가 발표한 방법이다. 비대칭 수 체계(asymmetric numeral systems, ANS)라고 불리는데, 이것도 무척 아름답다. 이 방법은 실수 대신 계속 커지는 큰 정수 하나로 메시지를 부호화해서 실수의 정밀도 문제를 모두 피한다. 다른 요령 몇 가지도 더해서, 전체 부호화 과정이 훨씬 빠르다.
27:07 여기서 끝낸다 해도 괜찮은 교훈이라고 생각한다. 산술 부호는 그 자체로 무척 아름답다. 정보이론의 핵심 아이디어 하나를 훨씬 구체적으로 만들어 주고, 언어 모델을 추론과 학습 양쪽에서 어떻게 생각할지에 대한 다른 관점도 준다. 하지만 이 영상은 내가 “압축은 지능이다”라는 제목을 붙인 3부작의 3부다.
“압축은 지능이다”에 대한 생각
27:33 이 문구는 엄밀하게 분석하기 어렵다. 지능은 정의가 아주 모호하고, 그것이 정확히 무엇을 뜻하는지를 두고 많은 사람이 의견을 달리할 것이다. 나는 이 문구를 지능에 대한 하나의 정의 제안처럼 다루는 것이 더 나은 접근이라고 생각한다. 그대로 두면 몹시 흐릿하고 인간적인 이 개념에 수학적 토대를 주고 싶다고 하자. 압축 하나만으로 정말 그 짐을 감당할 수 있을까?
27:56 비유하자면, 나는 이것을 뉴턴이 “에너지”라는 낱말에 수학적 의미를 준 일과 비슷하게 생각한다. 단위가 킬로그램·미터 매 초 제곱인, 측정할 수 있는 양으로 만든 것이다. 그가 이 정의를 내렸을 때 그것은 환원적이었다. 사람들이 일상에서 “에너지”라는 말을 쓸 때 뜻하는 많은 것을 놓친다. 그런데도 범위가 이렇게 더 좁았는데도, 그 정의를 내린 것은 여전히 생산적이었다. 환원적이었을지언정 겉보기에 서로 무관한 여러 현상을 하나로 묶어 냈다.
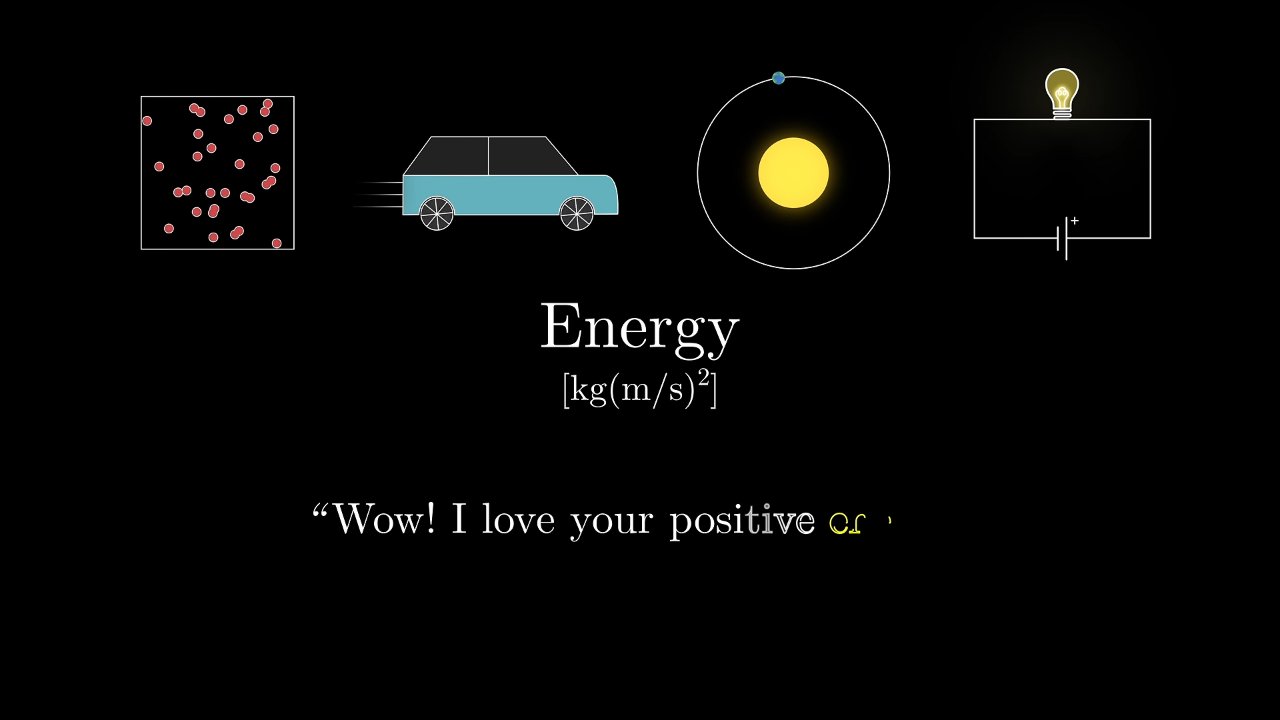
28:23 마찬가지로 “지능” 같은 낱말에 수학적 의미를 주려는 시도는 무엇이든, 우리가 일상에서 그 낱말에 담아 온 인간 특유의 미묘한 결 일부를 놓칠 수밖에 없어 보인다. 하지만 질문은 그런 정의가 환원적이더라도 여전히 생산적인지, 그리고 겉보기에 서로 무관한 지능의 여러 측면을 하나로 묶어 내는지다.
28:45 여기서 마무리로 이야기하고 싶은 것은, 내가 지능이라는 낱말을 쓸 때 뜻한다고 생각하는 것의 일부를 압축이 담아내는 구체적인 방식 세 가지다. 오늘 주제와 이어지는 지점은, 세 경우 모두 산술 부호화 같은 알고리즘이 머릿속에 생생하면 그 연결이 더 구체적으로 보인다는 것이다.
29:02 첫째, 압축과 예측은 사실 동전의 양면이다. 그리고 예측은 지능과 훨씬 더 분명하게 관련되어 보인다. 산술 부호는 이 동등성의 한쪽 절반을 보여 준다. 구체적으로는 임의의 예측기를 압축기로 바꾸는 거의 완벽한 방법을 준다.
29:19 반대 방향으로도 갈 수 있다. 임의의 텍스트 압축기가 있고, 그것으로 주어진 구절 뒤에 무엇이 올지 예측하고 싶다고 하자. 자세한 내용까지 들어가지는 않겠지만 기본 아이디어는 이렇다. 뒤에 올 수 있는 후보 문자열마다, 그 문자열을 덧붙였을 때 압축한 메시지가 덧붙이지 않았을 때보다 얼마나 커지는지 묻는다. 두 크기의 차이를 δ라고 하면, 2−δ는 그 압축기에 함축된 예측 모델이 다음 문자열의 확률을 얼마로 추측하는지에 대한 꽤 좋은 근사가 된다.
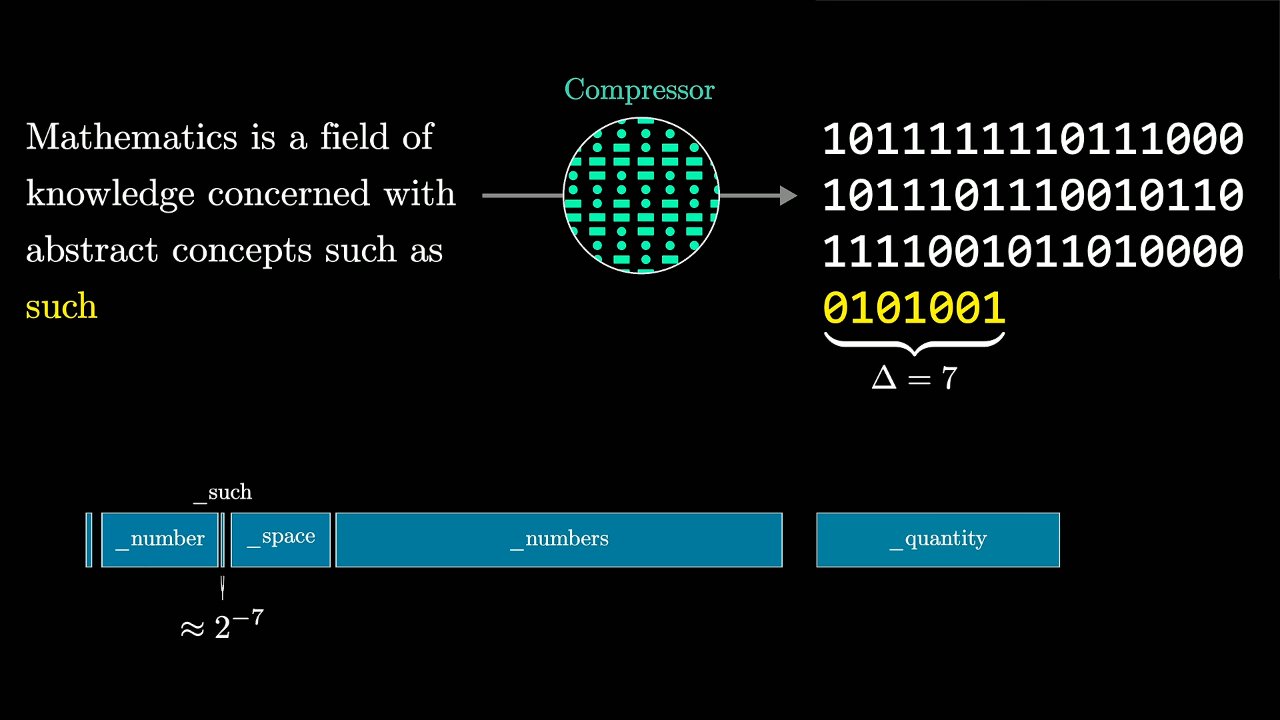
29:51 예를 들어 주어진 토큰 어휘의 모든 문자열에 대해 이렇게 하면, 현대 언어 모델이 내놓는 것과 비슷한 종류의 확률분포를 얻을 수 있다. 그러니 예측기를 압축기로, 압축기를 예측기로 바꿀 수 있다는 의미에서 압축과 예측은 정말로 동등하다. 그리고 좋은 예측에는 실제로 무슨 일이 벌어지는지에 대한 일관된 모델이 필요해 보이는 한, 이는 압축률이 지능의 좋은 대리 지표일 수 있다는 생각을 암시한다.
30:18 이것은 예측 처리(predictive processing)라는, 현대 신경과학에서 영향력 있는 이론과도 이어진다. 이 이론에 따르면 뇌는 감각 신호에 대한 하향식 예측을 끊임없이 만들어 낸다. 그리고 감각 기관에서 위로 다시 올라오는 것은 기관이 받은 정보 전체가 아니라, 예측과 감지된 현실 사이의 오차뿐이다. 이 이론의 결론은, 우리가 지능으로 경험하는 것의 상당 부분이 결국 신경의 예측과 압축으로 귀결될지도 모른다는 것이다.
30:46 하지만 지능에는, 적어도 내가 그 낱말을 쓸 때 뜻한다고 생각하는 것에는, 예측만으로는 놓치는 측면이 있다. 나는 개인적으로 무언가가 내 머릿속에서 작아질 때 그것을 더 잘 이해한다고 느낀다. 몇 가지 사실, 혹은 단 하나의 사실만 기억하면 폭넓은 결과를 떠올리거나 다시 유도할 수 있을 때다. 물리학 같은 분야의 진보도 이렇게 느껴진다. 법칙이 더 적고 더 짧아지면, 예측이 똑같더라도 한 걸음 나아간 것처럼 느껴진다.
31:13 기계학습 맥락에서는 이것을 더 잘 측정할 수 있다. 예측 능력이 같은 두 모델이 있는데 하나는 매개변수가 수조 개 필요하고 다른 하나는 작다면, 작은 쪽이 외워 둔 가정에 덜 기대고 있음을 시사한다. 이제 두 모델을 각각 산술 부호화에 끼워 넣는다고 하자. 예측 능력이 같다고 가정하면, 두 모델은 주어진 큰 데이터 집합, 이를테면 위키백과 1기가바이트를 같은 크기로 압축한다. 어쨌든 지금까지 이 영상의 요점은 그 압축률이 예측에만 달려 있다는 것이었다.
31:46 하지만 여기서 최종 압축률을 정직하게 계산하려면 복호화 프로그램의 크기도 넣어야 한다. 이 경우 그 프로그램에는 모델 자체가 들어간다. 어쨌든 위키백과 1기가바이트를 압축 꾸러미로 누군가에게 정말 보내고 싶다면, 복호화할 수단까지 주지 않는 한 그 산술 부호화에서 나온 원시 데이터 스트림은 쓸모가 없다.
32:09 앞에서 언급했듯이 허터 상은 바로 이렇게 결과에 점수를 매긴다. 복호화 프로그램 크기를 여기에 넣지 않으면, 복호화 프로그램의 소스 코드에 위키백과 전체 사본을 그냥 넣어 두는 식으로 사실상 부정행위를 할 수 있다. 그러면 이른바 페이로드는 얼마든지 작아질 수 있다. 앞에서 거대한 모델이 미국 헌법을 거의 외워서 예측에 쓰는 것이 반칙처럼 느껴졌다면, 바로 이것이 그 몫을 계산에 넣는 방법이다.
32:35 이렇게 측정하면, 큰 모델과 예측 능력이 같은 작은 모델이 더 나은 압축으로 쳐진다. 이것은 적어도, 더 명료한 이해는 외운 사실 다수 대신 일반 원리 소수를 쓴다는 생각과 결이 통한다. 그리고 내게는 바로 이 점이 “압축은 지능이다”라는 문구를 “예측은 지능이다”보다 훨씬 더 생각할 거리가 많은 문구로 만든다.
33:00 내가 지능이라는 낱말을 쓸 때 뜻한다고 생각하는 것의 셋째 측면은 새로운 것을 빨리 배우는 능력이다. 내가 아는 가장 똑똑한 사람들은 새 분야에 비교적 쉽게 뛰어든다. 이것도 언뜻 보면 압축률로는 전혀 포착되지 않을 것 같다. 산술 부호화에 끼워 넣은 예측 모델이라는 우리 예에 집중하면, 허터 상처럼 복호화 프로그램의 크기까지 넣어 측정하더라도, 최종 압축 크기는 그 바탕 모델을 애초에 학습시키는 데 시간이 얼마나 걸렸는지와 전혀 상관이 없다.
33:33 다만 학습 속도가 이 최종 점수에 영향을 주는 경우가 실제로 있다. 바탕 예측 모델을 위키백과 같은 특정 데이터 집합으로 학습시킨 상태에서 시작했다고 하자. 그런데 나중에 같은 부호기와 복호기를 다른 종류의 텍스트에 적용하고 싶다. 이를테면 셰익스피어 작품 전체를 부호화하는 것이다. 바탕 모델은 다른 맥락에서 학습했으니, 이 다른 환경에서는 성능이 더 나쁠 것이라고 예상할 수 있다. 셰익스피어 시대의 영어에 맞춰 학습시킨 모델보다는 확실히 더 나쁠 것이다.
34:01 하지만 알고리즘을 손보는 영리한 방법이 있다. 압축 과정 내내 모델을 고정해 두는 대신, 즉석에서 미세조정하면 어떨까? 도중에 보는 특정 토큰들에 모델이 적응하게 하는 것이다. 구체적으로는 새 토큰을 하나 볼 때마다 역전파를 적용해서, 본 것을 바탕으로 가중치 전부를 조금씩 조정한다는 뜻이다. 그러면 압축 과정이 진행되면서 모델이 그 새로운 맥락의 텍스트에 점점 더 잘 맞춰진다.
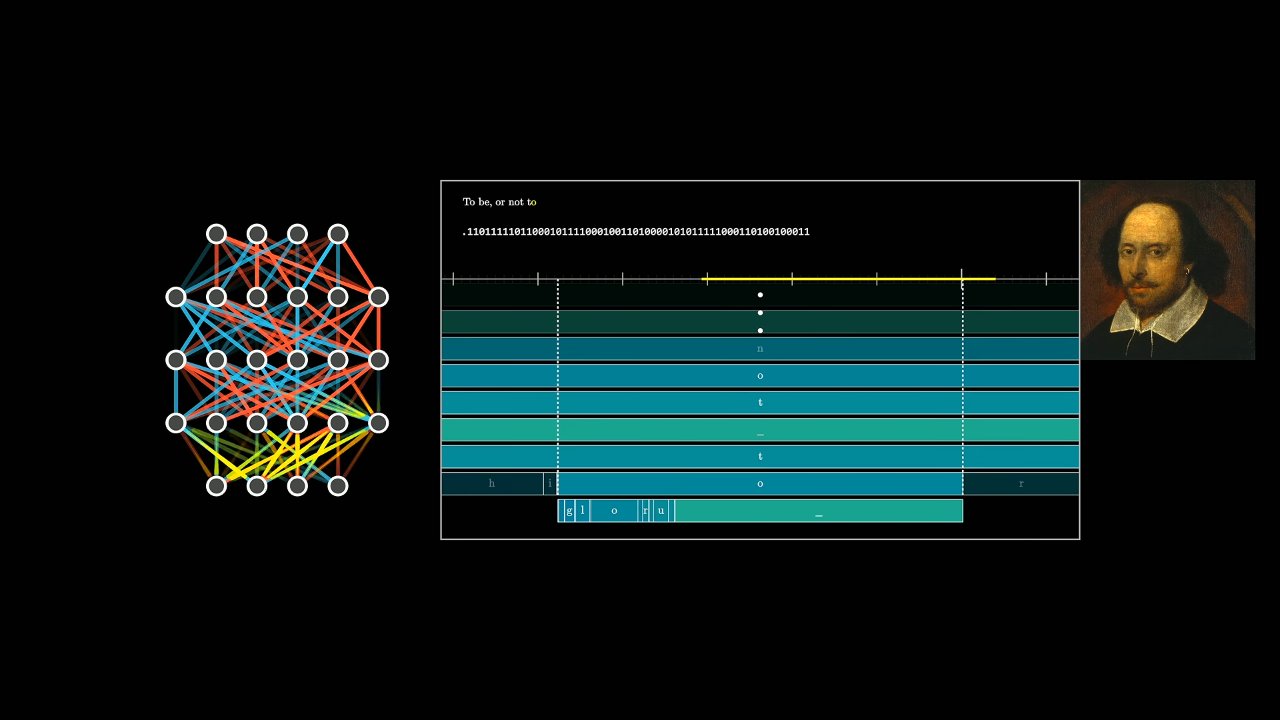
34:28 이것이 작동하려면 복호화 쪽에서도 복호기가 정확히 같은 일을 해야 한다. 업데이트가 모두 결정론적이기만 하면, 수신 쪽에서 모델이 업데이트되는 방식은 부호화 동안 업데이트된 방식을 그대로 재연한 것이 된다. 이 점이 중요한 이유는 각 단계의 예측이 똑같이 유지되어야 하기 때문이다.
34:49 이것은 실제로 쓰이는 아이디어다. 사실 매개변수를 하나도 보내지 않아도 된다. 부호기와 복호기가 처음에 완전히 무작위인 모델을 만들되, 둘에게 똑같이 나오는 의사 난수로 만들게 하면 된다. 어느 경우든 이렇게 하면 최종 압축률은 정적인 예측 능력뿐 아니라 모델이 새 맥락에 얼마나 빨리 적응하는지에도 달려 있다. 학습 속도가 좋을수록 압축이 좋아진다는 것이다.
35:16 한발 물러나 3부작 전체를 보면, 1부의 결론은 섀넌이 압축을 엄밀하게 연구하기 시작했을 때 지능과 씨름할 수밖에 없었다는 것이었다. 순수한 데이터 분석으로는 충분하지 않았다. 그는 사람들의 예측을 조사해서만 영어의 압축 가능성을 추정할 수 있었다. 2부의 결론은 현대 인공지능 공학이 원래 압축을 연구하려고 개발된 수학 도구를 쓴다는 것이었다.
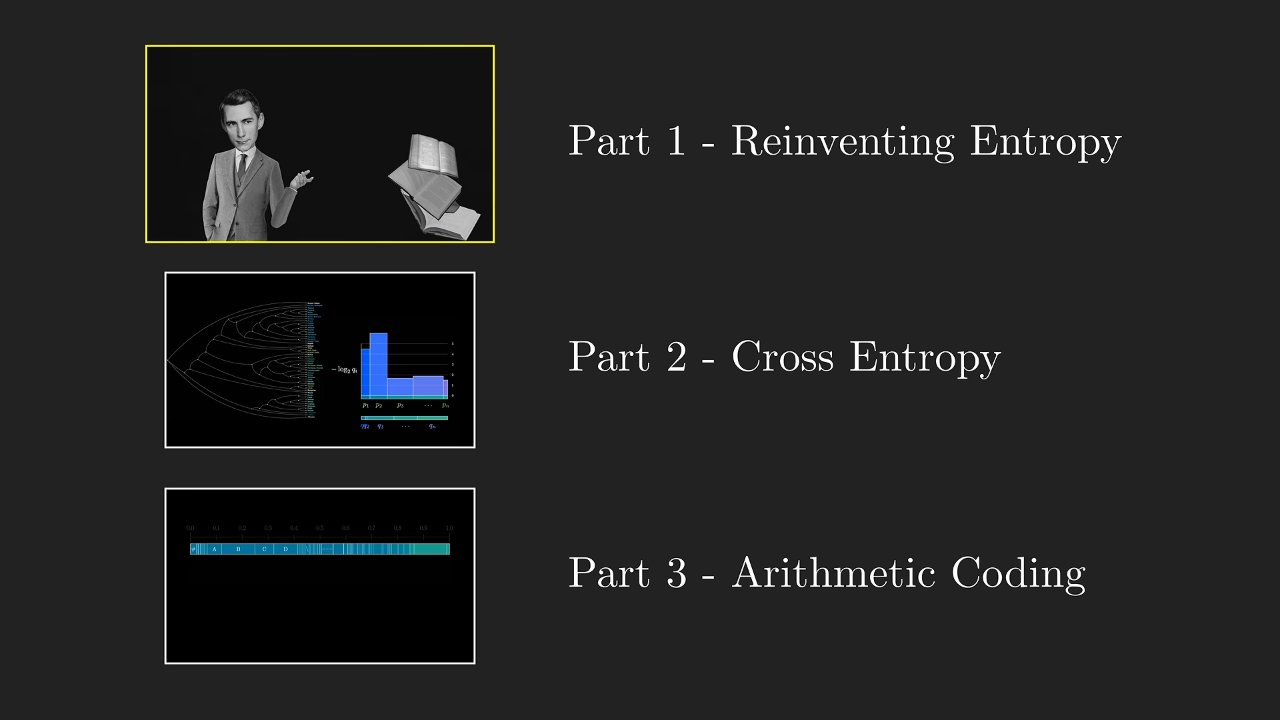
35:42 이 둘만으로도 압축과 지능 사이의 연결이 엿보인다. 하나를 연구하면 다른 하나와 씨름하지 않을 수 없는 것처럼 보인다. 이번 3부의 결론은, 우리가 가진 최고의 압축 알고리즘 하나가, 이를테면 허터 상으로 잰 기준에서, 예측을 잘하면서도 작고 빨리 배우기까지 하는 모델을 써야 한다는 것이다.
36:04 그러면 압축과 지능은 정말 같은 것일까? 안전한 대답은 물론 “아니다”이다. 뉴턴의 에너지 정의가 웹스터 사전의 정의와 같지 않은 것과 마찬가지다. 하지만 지능에 수학적 정의가 꼭 필요하다면, 내가 여기서 얻은 결론은 이렇다. 파일을 더 작게 만든다는, 겉보기에 순진한 과제를 처음 생각했을 때 짐작한 것보다 압축이 훨씬 더 많은 항목을 충족한다는 사실에 나는 정말로 놀랐다.
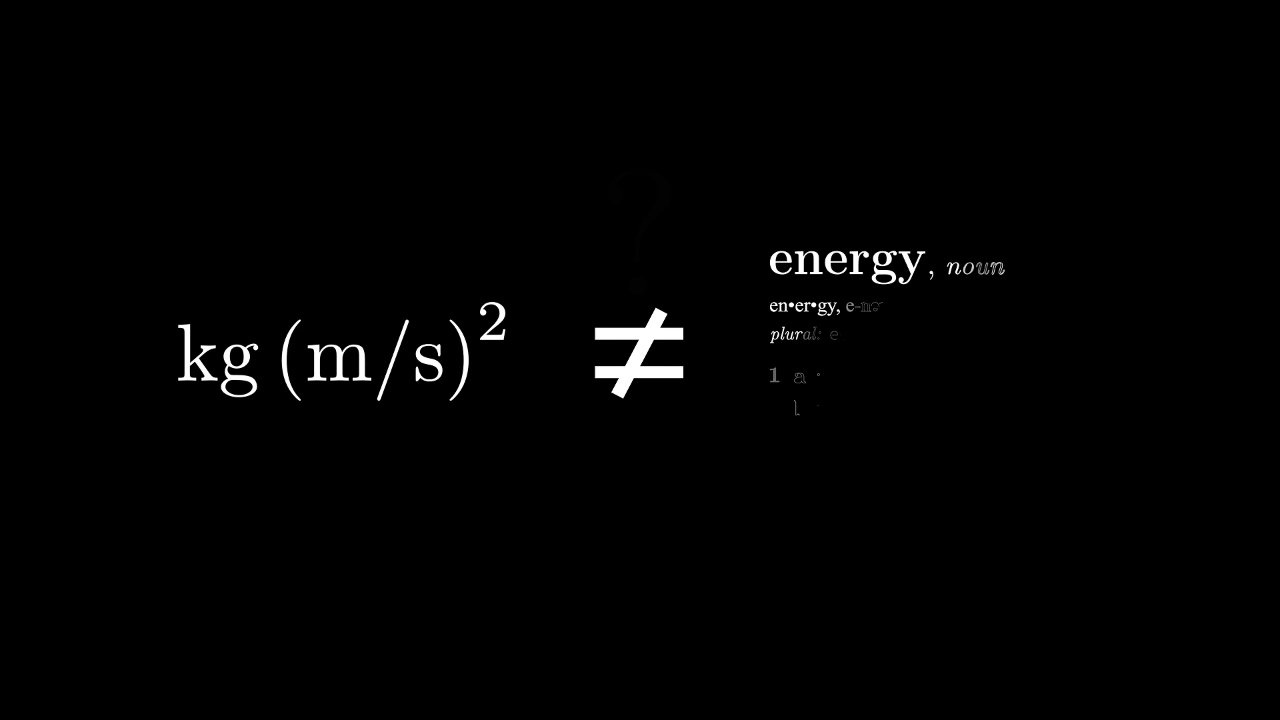
후원하는 세 가지 방법
36:32 이 영상이 마음에 들고 그 뒤에 있는 팀을 후원하고 싶다면, 크게 세 가지 방법이 있다. 일자리를 찾는 사람이 있다면, 지금 적극적으로 채용하면서 여러분 같은 사람을 뽑으려는 협력 조직들이 있다. 3b1b.com/talent에서 둘러볼 수 있다. 그 페이지로 내가 주로 하려는 일은 각 팀의 문화를 조금 엿보게 하고, 각 팀의 어떤 점이 추천할 만큼 내 눈에 띄었는지 보여 주는 것이다.
36:54 물론 Patreon도 있다. 오랫동안 채널을 떠받쳐 온 기둥으로, 채널 후원자는 새 영상을 미리 본다. 이것은 내가 최종 편집을 앞두고 피드백을 얻는 데 늘 도움이 되었다. 마지막으로 상점이 있다. 연휴를 맞아 막 넣은 재미있는 물건이 몇 개 있는데, 바이닐 레코드와 프랙털 머그 같은 것이다. 관심이 있다면 한번 둘러보라.
원본 링크·인용
원문
- 영상: 3Blue1Brown, “This algorithm changed how I think about compression | Information theory, part 3”, YouTube, 2026-11-17 공개, 37:25. 설명란 전문과 링크 23개는 완역 블록의 영상 설명란에 원래 위치 그대로 있다.
- 채널: 3Blue1Brown 채널(그랜트 샌더슨).
설명란이 권하는 자료
산술 부호화
- Dr. Dobb's Journal 1991-02 「Arithmetic Coding and Statistical Modeling」
- Nayuki 「Reference arithmetic coding」
비대칭 수 체계(ANS)
- Jarek Duda 「Asymmetric numeral systems」 arXiv 0902.0271
- Wolfram Demonstrations 「Data Compression Using Asymmetric Numeral Systems」
- Robert Bamler 「Understanding Entropy Coding With Asymmetric Numeral Systems (ANS)」 arXiv 2201.01741v2
- 「An Overview of the JPEG AI Learning-Based Image Coding Standard」 arXiv 2510.13867
압축과 일반화
- Ilya Sutskever 「An Observation on Generalization」 (Simons Institute)
- Yiding Jiang 「A compression perspective on curriculum learning」
설명란의 채널·후원·크레디트 링크
기타
원문 범위
- 영상의 말 전체를 옮겼다. 자막 1,056줄이 00:00부터 37:11까지 이어지고, 37:25까지 남은 14초는 음악이다.
- 기본 자막은 채널이 올린 영어 자막이다. 유튜브가 자동으로 만든 자막이 아니다. 자동 생성 영어 자막은 별도 트랙으로 있다.
- 자막의 인명 표기 3건은 화면 이름표를 따랐다. quen·Gwen은 화면 “QWEN (494M)”에 따라 Qwen으로, Richard Pascoe는 Richard Pasco로, Yarik Duda는 Jarek Duda로 옮겼다.
- 화자가 말을 고쳐 다시 시작한 대목은 자막에 앞말이 남아 있다(“To decode the text.”, “Really nice Really nice” 같은 조각). 완역은 고쳐 말한 문장을 한 번만 싣는다.
- 설명란은 전문과 링크 23개를 원래 줄 위치 그대로 옮겼다.
- 그림 41장은 영상 화면을 1280×720으로 옮긴 정지 화면이다(원본 1920×1080). 각 그림의 캡션 머리에 화면 시각을 적었다.
말과 화면이 다른 곳
- 28:00 에너지의 단위를 말로는 “kilogram meters per second squared”(kg·m/s², 힘의 단위)라고 했다. 같은 장면의 화면은 kg(m/s)²(에너지의 단위)다. 완역은 말을 옮기고 화면 값은 캡션에 적었다. 판정은 팩트체크에 있다.
용어 대역
| 영상의 말 | 이 문서의 한국어 |
|---|---|
| arithmetic coding / arithmetic code | 산술 부호화 / 산술 부호 |
| unit interval · number line | 단위 구간 · 수직선 |
| bits of precision | 정밀도 비트 |
| Shannon information | 섀넌 정보량 |
| cross-entropy | 교차 엔트로피 |
| pre-training | 사전학습 |
| renormalizing | 재정규화 |
| asymmetric numeral systems | 비대칭 수 체계(ANS) |
| predictive processing | 예측 처리 |
| prequential coding | 순차 예측 부호화 |
| Hutter Prize | 허터 상 |